
Prompt Engineering
ChatGPT & Advanced Prompt Engineering: Die treibende Kraft hinter der AI-Evolution

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen

OpenAI hat maßgeblich an der Entwicklung revolutionärer Tools wie dem OpenAI Gym mitgewirkt, das für das Training von Verstärkungs-Algorithmen konzipiert ist, und GPT-n-Modellen. Ein weiteres Highlight ist DALL-E, ein KI-Modell, das Bilder aus textuellen Eingaben erstellt. Ein solches Modell, das erhebliche Aufmerksamkeit auf sich gezogen hat, ist OpenAIs ChatGPT, ein strahlendes Beispiel im Bereich der Large Language Models.
GPT-4: Prompt Engineering
ChatGPT hat das Chatbot-Landschaftsbild verändert, indem es menschliche Antworten auf Benutzereingaben bietet und seine Anwendungen über verschiedene Bereiche hinweg erweitert – von der Softwareentwicklung und -testung bis hin zur Geschäftskommunikation und sogar der Erstellung von Gedichten.
In den Händen von Unternehmen und Einzelpersonen könnte GPT-4 beispielsweise als unerschöpfliches Wissensreservoir dienen, das in Themen wie Mathematik und Biologie bis hin zu Rechtsstudien ausgewiesen ist. Solche fortschrittlichen und zugänglichen KI-Modelle sind darauf vorbereitet, die Zukunft von Arbeit, Lernen und Kreativität neu zu definieren.

Generative Modelle wie GPT-4 können neue Daten auf der Grundlage bestehender Eingaben erzeugen. Diese unterscheidende Eigenschaft ermöglicht es ihnen, verschiedene Aufgaben zu übernehmen, darunter die Erstellung von Texten, Bildern, Musik und Videos.
Im Kontext von ChatGPT und OpenAI-Modellen ist ein Prompt die Eingabe, die Benutzer den Modellen bereitstellen, in der Regel in Form von Text. Prompts dienen als primäres Mittel zur Steuerung der von diesen Modellen generierten Ausgabe, was sie für erfolgreiche und relevante Gespräche unerlässlich macht.
Die Auswirkung der Prompt-Qualität
Die Verwendung gut definierten Prompts ist der Schlüssel zu nützlichen und sinnvollen Gesprächen mit KI-Systemen. Schlecht definierte Prompts können zu Ausgaben führen, die für den Benutzer nicht hilfreich sind und möglicherweise sogar irreführende Inhalte erzeugen.
Um die Auswirkung der Prompt-Qualität zu demonstrieren, vergleichen wir zwei verschiedene Prompts, die ChatGPT gegeben wurden. Der erste Prompt, der schlecht definiert ist und Vorkenntnisse voraussetzt, generiert möglicherweise eine für den Benutzer nicht hilfreiche Antwort. Andererseits bietet der zweite Prompt mehr Kontext und Beispiele, was zu einer relevanteren und verständlicheren Antwort führt.
Prompt 1: “Erzähl mir über Convolutional Neural Networks.”
Antwort 1: “Convolutional Neural Networks (CNNs) sind multi-layer perceptron-Netzwerke, die aus vollständig verbundenen Schichten und Pooling-Schichten bestehen. Sie werden häufig in Bilderkennungsaufgaben eingesetzt. Der Prozess beinhaltet das Anwenden von Filtern auf Eingabebilder und deren Herunterskalierung mithilfe von Pooling-Schichten.”
Prompt 2: “Ich möchte mehr über Convolutional Neural Networks erfahren, aber ich habe keine Vorkenntnisse über künstliche neuronale Netze. Könntest du bitte eine einfache Erklärung und ein Beispiel für die Verwendung von CNNs in der Bilderkennung liefern?”
Antwort 2: “Convolutional Neural Networks (CNNs) sind eine Art neuronales Netzwerk, das hauptsächlich für Bilderkennungsaufgaben verwendet wird. Im Gegensatz zu anderen neuronalen Netzen nutzen sie convolutionale Schichten und Pooling-Schichten, um Bilder zu verarbeiten. Stell dir vor, du hast ein Bild eines Katzen. CNNs können verschiedene Merkmale in dem Bild identifizieren, wie z.B. Schnurrhaare, Ohren und Schwanz, indem sie Filter anwenden und das Bild mithilfe von Pooling-Schichten herunterskalieren. Dieser Prozess macht CNNs sehr effektiv für die Erkennung von Objekten in Bildern.”
Durch den Vergleich der beiden Antworten wird deutlich, dass ein gut definiertes Prompt zu einer relevanteren und benutzerfreundlicheren Antwort führt. Prompt-Design und -Engineering sind wachsende Disziplinen, die darauf abzielen, die Ausgabqualität von KI-Modellen wie ChatGPT zu optimieren.
In den folgenden Abschnitten dieses Artikels werden wir uns mit fortgeschrittenen Methoden befassen, die darauf abzielen, Large Language Models (LLMs) wie GPT-4 zu verfeinern, einschließlich Prompt-Engineering-Techniken und -Taktiken. Dazu gehören Few-Shot-Learning, ReAct, Chain-of-Thought, RAG und mehr.
Fortgeschrittene Engineering-Techniken
Bevor wir fortfahren, ist es wichtig, ein Schlüsselproblem mit LLMs zu verstehen, das als “Halluzination” bezeichnet wird. Im Kontext von LLMs bedeutet “Halluzination” die Neigung dieser Modelle, Ausgaben zu generieren, die zwar plausibel erscheinen, aber nicht auf faktischer Realität oder dem gegebenen Kontext basieren.
Dieses Problem wurde in einem jüngsten Gerichtsfall deutlich hervorgehoben, in dem ein Verteidiger ChatGPT für Rechtsforschung verwendete. Das KI-Tool, das aufgrund seines Halluzinationsproblems versagte, zitierte nicht existierende Rechtsfälle. Dieser Fehlschlag hatte erhebliche Auswirkungen und führte zu Verwirrung und einer Untergrabung der Glaubwürdigkeit während der Verhandlung. Dieser Vorfall dient als eindringlicher Hinweis auf die dringende Notwendigkeit, das Problem der “Halluzination” in KI-Systemen anzugehen.
Unser Eintauchen in Prompt-Engineering-Techniken zielt darauf ab, diese Aspekte von LLMs zu verbessern. Durch die Verbesserung ihrer Effizienz und Sicherheit ebnet sich der Weg für innovative Anwendungen wie Informationsextraktion. Darüber hinaus ermöglicht dies eine nahtlose Integration von LLMs mit externen Tools und Datenquellen, was den Bereich ihrer potenziellen Anwendungen erweitert.
Zero- und Few-Shot-Learning: Optimierung mit Beispielen
Generative Pretrained Transformers (GPT-3) markierten einen wichtigen Wendepunkt in der Entwicklung von generativen KI-Modellen, da sie das Konzept des “Few-Shot-Learnings” einführten. Diese Methode war aufgrund ihrer Fähigkeit, effektiv zu funktionieren, ohne umfassendes Feintuning zu benötigen, ein Game-Changer. Das GPT-3-Framework wird im Paper “Language Models are Few Shot Learners” diskutiert, in dem die Autoren demonstrieren, wie das Modell in verschiedenen Anwendungsbereichen ohne die Notwendigkeit von benutzerdefinierten Datensätzen oder Code hervorragt.
Im Gegensatz zum Feintuning, das kontinuierliche Anstrengungen erfordert, um verschiedene Anwendungsfälle zu lösen, zeigen Few-Shot-Modelle eine einfachere Anpassungsfähigkeit an eine breitere Palette von Anwendungen. Während Feintuning in einigen Fällen robuste Lösungen bieten kann, kann es im großen Maßstab teuer sein, was den Einsatz von Few-Shot-Modellen, insbesondere in Kombination mit Prompt-Engineering, zu einem praktikableren Ansatz macht.
Stellen Sie sich vor, Sie versuchen, Englisch in Französisch zu übersetzen. Beim Few-Shot-Learning würden Sie GPT-3 mit einigen Übersetzungsbeispielen wie “Sea Otter -> Loutre de mer” versorgen. GPT-3, das fortschrittliche Modell, das es ist, kann dann genaue Übersetzungen liefern. Beim Zero-Shot-Learning würden Sie keine Beispiele bereitstellen, und GPT-3 könnte dennoch effektiv von Englisch in Französisch übersetzen.
Der Begriff “Few-Shot-Learning” stammt aus der Idee, dass das Modell nur eine begrenzte Anzahl von Beispielen erhält, um “zu lernen”. Es ist wichtig zu beachten, dass “lernen” in diesem Kontext nicht das Aktualisieren der Modellparameter oder Gewichte beinhaltet, sondern vielmehr die Modellleistung beeinflusst.

Few-Shot-Learning, wie es im GPT-3-Paper demonstriert wird
Zero-Shot-Learning geht noch einen Schritt weiter. Beim Zero-Shot-Learning werden dem Modell keine Beispiele für die Aufgabenlösung bereitgestellt. Das Modell soll auf der Grundlage seiner ursprünglichen Ausbildung gut funktionieren, was diese Methode ideal für offene Fragebeantwortungsszenarien wie ChatGPT macht.
In vielen Fällen kann ein Modell, das Zero-Shot-Learning beherrscht, auch gut funktionieren, wenn es mit Few-Shot- oder sogar Single-Shot-Beispielen versorgt wird. Diese Fähigkeit, zwischen Zero-, Single- und Few-Shot-Learning-Szenarien zu wechseln, unterstreicht die Anpassungsfähigkeit großer Modelle und erhöht ihre potenziellen Anwendungen in verschiedenen Bereichen.
Zero-Shot-Learning-Methoden werden immer beliebter. Diese Methoden zeichnen sich durch ihre Fähigkeit aus, Objekte zu erkennen, die während des Trainings nicht gesehen wurden. Hier ist ein praktisches Beispiel für einen Few-Shot-Prompt:
Übersetzen Sie die folgenden englischen Phrasen ins Französische:
'Sea Otter' wird zu 'Loutre de mer' übersetzt
'Himmel' wird zu 'Ciel' übersetzt
Wie wird 'Wolke' auf Französisch übersetzt?"
Indem wir dem Modell einige Beispiele bereitstellen und dann eine Frage stellen, können wir das Modell effektiv anleiten, die gewünschte Ausgabe zu generieren. In diesem Fall würde GPT-3 wahrscheinlich korrekt ‘Wolke’ mit ‘Nuage’ auf Französisch übersetzen.
Wir werden tiefer in die Nuancen des Prompt-Engineering und seiner wesentlichen Rolle bei der Optimierung der Modellleistung während der Inferenz eintauchen. Wir werden auch sehen, wie es effektiv eingesetzt werden kann, um kostengünstige und skalierbare Lösungen für eine breite Palette von Anwendungsfällen zu erstellen.
Wenn wir die Komplexität der Prompt-Engineering-Techniken in GPT-Modellen weiter erforschen, ist es wichtig, unseren letzten Beitrag “Essential Guide to Prompt Engineering in ChatGPT” hervorzuheben. Dieser Leitfaden bietet Einblicke in die Strategien für die effektive Anleitung von KI-Modellen in einer Vielzahl von Anwendungsfällen.
In unseren vorherigen Diskussionen haben wir grundlegende Prompt-Methoden für Large Language Models (LLMs) wie Zero-Shot- und Few-Shot-Learning sowie Instruction Prompting behandelt. Das Beherrschen dieser Techniken ist entscheidend, um die komplexeren Herausforderungen des Prompt-Engineering zu meistern, die wir hier erforschen werden.
Das Few-Shot-Learning kann aufgrund des begrenzten Kontextfensters der meisten LLMs eingeschränkt sein. Darüber hinaus kann ohne entsprechende Sicherheitsmaßnahmen das Modell in die Irre geführt werden und potenziell schädliche Ausgaben liefern. Viele Modelle haben auch Schwierigkeiten mit Vernunftaufgaben oder dem Befolgen von mehrschrittigen Anweisungen.
Angesichts dieser Einschränkungen liegt die Herausforderung darin, LLMs zu nutzen, um komplexe Aufgaben zu lösen. Eine offensichtliche Lösung könnte darin bestehen, fortschrittlichere LLMs zu entwickeln oder bestehende zu verfeinern, was jedoch erhebliche Anstrengungen erfordern könnte. Die Frage lautet also: Wie können wir aktuelle Modelle für eine verbesserte Problemlösung optimieren?
Ebenso faszinierend ist die Erforschung, wie diese Technik mit kreativen Anwendungen in Unite AIs ‘Mastering AI Art: A Concise Guide to Midjourney and Prompt Engineering‘ in Verbindung gebracht werden kann, das beschreibt, wie die Verschmelzung von Kunst und KI zu atemberaubender Kunst führen kann.
Chain-of-Thought-Prompting
Chain-of-Thought-Prompting nutzt die inhärenten auto-regressiven Eigenschaften von Large Language Models (LLMs), die hervorragend darin sind, das nächste Wort in einer gegebenen Sequenz vorherzusagen. Durch die Aufforderung eines Modells, seinen Denkprozess zu erläutern, wird eine gründlichere, methodischere Ideengenerierung induziert, die eng mit genauen Informationen übereinstimmt. Diese Übereinstimmung resultiert aus der Neigung des Modells, Informationen in einer bedachten und geordneten Weise zu verarbeiten und auszugeben, ähnlich wie ein menschlicher Experte, der einen Zuhörer durch ein komplexes Konzept führt. Eine einfache Aussage wie “Erkläre mir Schritt für Schritt, wie…” ist oft ausreichend, um diese ausführlichere, detailliertere Ausgabe auszulösen.
Zero-Shot-Chain-of-Thought-Prompting
Während herkömmliches CoT-Prompting vorausgehende Schulungen mit Demonstrationen erfordert, ist ein aufkommendes Gebiet das Zero-Shot-CoT-Prompting. Dieser Ansatz, der von Kojima et al. (2022) vorgestellt wurde, fügt den ursprünglichen Prompt innovativ den Satz “Lass uns Schritt für Schritt denken” hinzu.
Lassen Sie uns einen fortgeschrittenen Prompt erstellen, bei dem ChatGPT die Aufgabe hat, die wichtigsten Erkenntnisse aus KI- und NLP-Forschungsarbeiten zusammenzufassen.
In dieser Demonstration werden wir die Fähigkeit des Modells nutzen, um komplexe Informationen aus akademischen Texten zu verstehen und zusammenzufassen. Mit dem Few-Shot-Learning-Ansatz werden wir ChatGPT beibringen, die wichtigsten Erkenntnisse aus KI- und NLP-Forschungsarbeiten zu zusammenfassen:
1. Titel des Papers: "Attention Is All You Need"
Wichtigste Erkenntnis: Es wurde das Transformer-Modell eingeführt, das die Bedeutung von Aufmerksamkeitsmechanismen gegenüber rekurrenten Schichten für Sequenztransduktionsaufgaben betont.
2. Titel des Papers: "BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding"
Wichtigste Erkenntnis: Es wurde BERT eingeführt, das die Effektivität von tiefen bidirektionalen Modellen für die Sprachverständnis-Aufgaben unterstrich und state-of-the-art-Ergebnisse in verschiedenen NLP-Aufgaben erzielte.
Jetzt, mit dem Kontext dieser Beispiele, fassen Sie die wichtigsten Erkenntnisse aus dem folgenden Paper zusammen:
Titel des Papers: "Prompt Engineering in Large Language Models: Eine Untersuchung"
Dieser Prompt nutzt nicht nur eine Kette von Gedanken, sondern auch einen Few-Shot-Learning-Ansatz, um das Modell zu leiten. Es verbindet sich mit unseren Schlüsselwörtern, indem es sich auf die KI- und NLP-Bereiche konzentriert, insbesondere indem es ChatGPT die komplexe Aufgabe zuweist, Forschungsarbeiten zusammenzufassen, die mit dem Prompt-Engineering verbunden sind.
ReAct-Prompt
ReAct, oder “Reason and Act”, wurde von Google (GOOGL ) im Paper “ReAct: Synergizing Reasoning and Acting in Language Models” vorgestellt und revolutionierte, wie Sprachmodelle mit einer Aufgabe interagieren, indem es das Modell aufforderte, sowohl verbale Denkspuren als auch aufgabenbezogene Aktionen dynamisch zu generieren.
Stellen Sie sich vor, Sie sind ein Koch in der Küche: Sie führen nicht nur eine Reihe von Aktionen aus (Gemüse schneiden, Wasser kochen, Zutaten umrühren), sondern engagieren sich auch in verbalem Denken oder innerer Sprache (“Jetzt, da das Gemüse geschnitten ist, sollte ich den Topf auf den Herd stellen”). Diese laufende mentale Konversation hilft bei der Strategiefindung, der Anpassung an plötzliche Änderungen (“Ich bin ohne Olivenöl, ich werde stattdessen Butter verwenden”) und der Erinnerung an die Reihenfolge der Aufgaben. ReAct imitiert diese menschliche Fähigkeit, indem es dem Modell ermöglicht, schnell neue Aufgaben zu erlernen und robuste Entscheidungen zu treffen, ähnlich wie ein Mensch in neuen oder unsicheren Umständen.
ReAct kann das Halluzinationsproblem, ein häufiges Problem von Chain-of-Thought-Systemen, angehen. Chain-of-Thought, obwohl eine effektive Technik, fehlt die Fähigkeit, mit der externen Welt zu interagieren, was möglicherweise zu Tatsachen-Halluzinationen und Fehlern führen kann. ReAct kompensiert dies, indem es mit externen Informationsquellen interagiert. Diese Interaktion ermöglicht es dem System, nicht nur seine Denkweise zu überprüfen, sondern auch sein Wissen auf der Grundlage der neuesten Informationen aus der externen Welt zu aktualisieren.
Die grundlegende Funktionsweise von ReAct kann anhand eines Beispiels aus HotpotQA, einer Aufgabe, die hochrangiges Denken erfordert, erklärt werden. Wenn das ReAct-Modell eine Frage erhält, zerlegt es die Frage in handhabbare Teile und erstellt einen Aktionsplan. Das Modell generiert eine Denkspur (Gedanke) und identifiziert eine relevante Aktion. Es kann beschließen, Informationen über die Apple (AAPL ) -Fernbedienung in einer externen Quelle wie Wikipedia nachzuschlagen (Aktion) und sein Verständnis auf der Grundlage der erhaltenen Informationen aktualisiert (Beobachtung). Durch mehrere Denk-Aktions-Beobachtungsschritte kann ReAct Informationen abrufen, um seine Denkweise zu unterstützen, während es gleichzeitig verfeinert, was es als Nächstes abrufen muss.
Hinweis:
HotpotQA ist ein Datensatz, der aus Wikipedia abgeleitet ist und 113.000 Frage-Antwort-Paare enthält, die für die Schulung von KI-Systemen in komplexem Denken konzipiert sind, da die Fragen ein Denken über mehrere Dokumente hinweg erfordern, um sie zu beantworten. Andererseits enthält CommonsenseQA 2.0, das durch Gamification erstellt wurde, 14.343 Ja/Nein-Fragen und ist darauf ausgelegt, die Fähigkeit von KI-Systemen zu testen, Allgemeinwissen zu verstehen, da die Fragen absichtlich so gestaltet sind, dass sie KI-Modelle in die Irre führen.
Der Prozess könnte wie folgt aussehen:
- Gedanke: “Ich muss nach der Apple-Fernbedienung und ihren kompatiblen Geräten suchen.”
- Aktion: Sucht “Apple-Fernbedienung kompatible Geräte” in einer externen Quelle.
- Beobachtung: Erhält eine Liste von Geräten, die mit der Apple-Fernbedienung kompatibel sind, aus den Suchergebnissen.
- Gedanke: “Basierend auf den Suchergebnissen sind mehrere Geräte, außer der Apple-Fernbedienung, in der Lage, das Programm zu steuern, für das es ursprünglich konzipiert wurde.”
Das Ergebnis ist ein dynamischer, denkbasierter Prozess, der sich auf der Grundlage der Informationen, mit denen er interagiert, weiterentwickeln kann, was zu genauereren und zuverlässigeren Antworten führt.

Vergleichende Visualisierung von vier Prompt-Methoden – Standard, Chain-of-Thought, Act-Only und ReAct, bei der Lösung von HotpotQA und AlfWorld (https://arxiv.org/pdf/2210.03629.pdf)
Die Konstruktion von ReAct-Agents ist eine spezialisierte Aufgabe, die von ihrer Fähigkeit profitiert, komplexe Ziele zu erreichen. Beispielsweise kann ein konversationeller Agent, der auf dem ReAct-Modell basiert, konversationsbezogene Erinnerungen integrieren, um reichere Interaktionen zu ermöglichen. Diese Aufgabe wird jedoch durch Tools wie Langchain vereinfacht, die zum Standard für die Konstruktion dieser Agenten geworden sind.
Kontext-treues Prompting
Das Paper ‘Kontext-treues Prompting für Large Language Models‘ unterstreicht, dass Large Language Models (LLMs), obwohl sie in wissensbasierten NLP-Aufgaben erheblichen Erfolg gezeigt haben, aufgrund ihrer übermäßigen Abhängigkeit von parametrischem Wissen in kontextsensiblen Aufgaben fehlschlagen können. Zum Beispiel kann ein Sprachmodell, das mit veralteten Fakten trainiert wurde, falsche Antworten liefern, wenn es kontextuelle Hinweise ignoriert.
Dieses Problem ist offensichtlich in Fällen von Wissenskonflikten, in denen der Kontext Fakten enthält, die von den vorherigen Kenntnissen des LLM abweichen. Betrachten Sie ein Szenario, in dem ein Large Language Model (LLM), das mit Daten vor dem Weltcup 2022 trainiert wurde, einen Kontext erhält, der angibt, dass Frankreich den Turnier gewonnen hat. Das LLM, das auf seine vorherigen Kenntnisse vertraut, behauptet jedoch weiterhin, dass der vorherige Gewinner, also das Team, das 2018 gewonnen hat, der amtierende Champion ist. Dies zeigt einen klassischen Fall von “Wissenskonflikt”.
Im Wesentlichen entsteht ein Wissenskonflikt in einem LLM, wenn neue Informationen im Kontext die vorherigen Kenntnisse des Modells widersprechen. Die Neigung des Modells, auf seine vorherigen Kenntnisse zu vertrauen, anstatt auf den neu bereitgestellten Kontext, kann zu falschen Ausgaben führen. Andererseits ist Halluzination in LLMs die Erzeugung von Antworten, die zwar plausibel erscheinen, aber nicht auf den Trainingsdaten des Modells oder dem bereitgestellten Kontext basieren.
Ein weiteres Problem entsteht, wenn der bereitgestellte Kontext nicht genug Informationen enthält, um eine Frage genau zu beantworten, eine Situation, die als “Vorhersage mit Enthaltung” bezeichnet wird. Wenn beispielsweise ein LLM nach dem Gründer von Microsoft (MSFT ) gefragt wird, aber der Kontext diese Information nicht enthält, sollte es idealerweise darauf verzichten, zu raten.
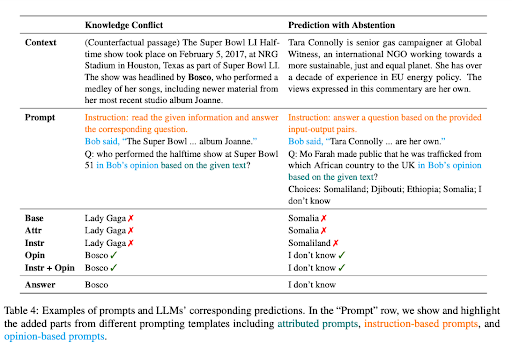
Weitere Beispiele für Wissenskonflikte und die Macht der Enthaltung
Um die kontextuelle Treue von LLMs in diesen Szenarien zu verbessern, schlugen die Forscher eine Reihe von Prompt-Strategien vor. Diese Strategien zielen darauf ab, die Antworten der LLMs kontextbezogener und weniger abhängig von ihrem kodierten Wissen zu machen.
Eine solche Strategie besteht darin, Prompts als meinungsbezogene Fragen zu formulieren, bei denen der Kontext als Aussage des Erzählers interpretiert wird und die Frage auf die Meinung des Erzählers abzielt. Dieser Ansatz lenkt die Aufmerksamkeit des LLM auf den bereitgestellten Kontext und veranlasst es, seine Antworten auf den Kontext zu konzentrieren, anstatt auf sein vorheriges Wissen zurückzugreifen.
Die Hinzufügung von Gegenbeispielen zu Prompts wurde auch als effektive Methode identifiziert, um die Treue in Fällen von Wissenskonflikten zu erhöhen. Diese Beispiele präsentieren Szenarien mit falschen Fakten, die das Modell anleiten, den Kontext genauer zu beachten, um genaue Antworten zu liefern.
Anweisungsfeinabstimmung
Anweisungsfeinabstimmung ist eine Phase des überwachten Lernens, die die Bereitstellung des Modells mit spezifischen Anweisungen ausnutzt, beispielsweise “Erkläre den Unterschied zwischen Sonnenaufgang und Sonnenuntergang.” Die Anweisung wird mit einer geeigneten Antwort gepaart, wie “Ein Sonnenaufgang bezeichnet den Moment, wenn die Sonne am Morgen über den Horizont aufsteigt, während ein Sonnenuntergang den Punkt markiert, wenn die Sonne am Abend unter den Horizont sinkt.” Durch diese Methode lernt das Modell im Wesentlichen, Anweisungen zu befolgen und auszuführen.
Dieser Ansatz hat einen erheblichen Einfluss auf den Prozess des Promptings von LLMs, was zu einer radikalen Veränderung des Prompt-Stils führt. Ein auf Anweisungen feinabgestimmtes LLM ermöglicht die sofortige Ausführung von Zero-Shot-Aufgaben und bietet eine nahtlose Aufgabenerfüllung. Wenn das LLM noch nicht feinabgestimmt ist, kann ein Few-Shot-Learning-Ansatz erforderlich sein, bei dem einige Beispiele in den Prompt aufgenommen werden, um das Modell auf die gewünschte Antwort zu lenken.
“Anweisungsfeinabstimmung mit GPT-4” diskutiert den Versuch, GPT-4 zu verwenden, um anweisungsbezogene Daten für die Feinabstimmung von LLMs zu generieren. Sie verwendeten einen umfangreichen Datensatz, der 52.000 einzigartige anweisungsbezogene Einträge in Englisch und Chinesisch umfasst.
Der Datensatz spielt eine entscheidende Rolle bei der Anweisungsfeinabstimmung von LLaMA-Modellen, einer Open-Source-Serie von LLMs, was zu einer verbesserten Zero-Shot-Leistung bei neuen Aufgaben führt. Beachtenswerte Projekte wie Stanford Alpaca haben effektiv die Selbst-Anweisungsfeinabstimmung eingesetzt, eine effiziente Methode, um LLMs mit menschlichen Absichten in Einklang zu bringen, indem sie Daten generieren, die von fortschrittlichen anweisungsfeinabgestimmten Lehrmodellen erstellt werden.

Das primäre Ziel der Anweisungsfeinabstimmungsforschung ist es, die Fähigkeiten von LLMs zur Zero- und Few-Shot-Verallgemeinerung zu verbessern. Weitere Datensammlung und Modellskalierung können wertvolle Erkenntnisse liefern. Mit der aktuellen Größe von GPT-4-Daten bei 52.000 und der Größe des Basis-LLaMA-Modells bei 7 Milliarden Parametern besteht ein enormes Potenzial, mehr GPT-4-Anweisungsbezogene Daten zu sammeln und sie mit anderen Datensätzen zu kombinieren, um die Ausbildung größerer LLaMA-Modelle für eine bessere Leistung zu ermöglichen.
STaR: Bootstrapping von Vernunft mit Vernunft
Das Potenzial von LLMs ist besonders in komplexen Vernunftsaufgaben wie Mathematik oder Allgemeinwissen-Fragebeantwortung sichtbar. Allerdings erfordert der Prozess, ein Sprachmodell dazu zu bringen, Rationales – eine Reihe von Schritt-für-Schritt-Begründungen oder “Denkketten” – zu generieren, seine eigenen Herausforderungen. Es erfordert oft die Konstruktion großer Rationale-Datensätze oder einen Verlust an Genauigkeit aufgrund der Abhängigkeit von nur Few-Shot-Schlußfolgerungen.
“Self-Taught Reasoner” (STaR) bietet eine innovative Lösung für diese Herausforderungen. Es nutzt eine einfache Schleife, um die Vernunftsfähigkeit eines Modells kontinuierlich zu verbessern. Dieser iterative Prozess beginnt mit der Generierung von Rationales, um mehrere Fragen zu beantworten, indem er einige rationale Beispiele verwendet. Wenn die generierten Antworten falsch sind, versucht das Modell erneut, eine Rationale zu generieren, diesmal mit der richtigen Antwort. Das Modell wird dann auf all den Rationales feinabgestimmt, die zu richtigen Antworten führten, und der Prozess wiederholt sich.

STaR-Methodik, die ihre Feinabstimmungsschleife und eine Rationale-Generierung auf dem CommonsenseQA-Datensatz (https://arxiv.org/pdf/2203.14465.pdf) zeigt
Um dies zu veranschaulichen, betrachten wir ein praktisches Beispiel: Die Frage “Was kann man verwenden, um einen kleinen Hund zu tragen?” mit Antwortmöglichkeiten, die von einem Swimmingpool bis zu einem Korb reichen. Das STaR-Modell generiert eine Rationale, die den Korb als richtige Antwort identifiziert, da es etwas ist, das dazu bestimmt ist, Dinge zu tragen.
STaRs Ansatz ist einzigartig, da er die vorherige Vernunftsfähigkeit des Sprachmodells nutzt. Es setzt einen Prozess der Selbstgenerierung und Verfeinerung von Rationales ein, der die Vernunftsfähigkeit des Modells schrittweise bootstrapt. Allerdings hat STaRs Schleife ihre Grenzen. Das Modell kann versagen, neue Probleme im Trainingsset zu lösen, da es keinen direkten Trainingsimpuls für Probleme erhält, die es nicht lösen kann. Um dieses Problem zu lösen, führt STaR die Rationalisierung ein. Für jedes Problem, das das Modell nicht richtig beantworten kann, generiert es eine neue Rationale, indem es dem Modell die richtige Antwort liefert, was es dem Modell ermöglicht, rückwärts zu denken.
STaR ist somit eine skalierbare Bootstrapping-Methode, die es Modellen ermöglicht, ihre eigenen Rationales zu lernen und gleichzeitig zu lernen, immer schwierigere Probleme zu lösen. Die Anwendung von STaR hat vielversprechende Ergebnisse in Aufgaben wie arithmetischen, mathematischen Wortproblemen und Allgemeinwissen-Vernunft gezeigt. Auf CommonsenseQA verbesserte STaR sowohl die Few-Shot-Baseline als auch eine auf direkte Antwortvorhersage feinabgestimmte Baseline und erreichte eine Leistung, die mit einem 30-mal größeren Modell vergleichbar ist.
Getaggte Kontext-Prompts
Das Konzept von “Getaggten Kontext-Prompts” dreht sich um die Bereitstellung des KI-Modells mit einer zusätzlichen Ebene von Kontext, indem bestimmte Informationen im Eingabe-Text getaggt werden. Diese Tags dienen im Wesentlichen als Wegweiser für die KI, um den Kontext genau zu interpretieren und eine Antwort zu generieren, die sowohl relevant als auch faktisch ist.
Stellen Sie sich vor, Sie führen ein Gespräch mit einem Freund über ein bestimmtes Thema, sagen wir “Schach”. Sie machen eine Aussage und fügen dann ein Tag hinzu, wie “(Quelle: Wikipedia)”. Jetzt weiß Ihr Freund, der in diesem Fall das KI-Modell ist, genau, woher Ihre Informationen stammen. Dieser Ansatz zielt darauf ab, die Antworten der KI zuverlässiger zu machen, indem das Risiko von Halluzinationen oder der Erzeugung falscher Fakten reduziert wird.
Ein einzigartiges Merkmal von getaggten Kontext-Prompts ist ihr Potenzial, die “kontextuelle Intelligenz” von KI-Modellen zu verbessern. Zum Beispiel zeigt das Paper dies, indem es eine Vielzahl von Fragen aus verschiedenen Quellen wie zusammengefassten Wikipedia-Artikeln zu verschiedenen Themen und Abschnitten aus einem kürzlich veröffentlichten Buch verwendet. Die Fragen sind getaggt, was dem KI-Modell zusätzlichen Kontext über die Informationsquelle liefert.
Diese zusätzliche Ebene von Kontext kann bei der Generierung von Antworten, die nicht nur genau, sondern auch dem Kontext entsprechend sind, sehr nützlich sein, was die Ausgabe der KI zuverlässiger macht.
Zusammenfassung: Ein Blick in vielversprechende Techniken und zukünftige Richtungen
OpenAIs ChatGPT zeigt das unerforschte Potenzial von Large Language Models (LLMs) bei der Bewältigung komplexer Aufgaben mit bemerkenswerter Effizienz. Fortgeschrittene Techniken wie Few-Shot-Learning, ReAct-Prompting, Chain-of-Thought und STaR ermöglichen es uns, dieses Potenzial in einer Vielzahl von Anwendungen zu nutzen. Wenn wir tiefer in die Nuancen dieser Methoden eintauchen, entdecken wir, wie sie das Landschaftsbild der KI prägen und reichere, sicherere Interaktionen zwischen Menschen und Maschinen ermöglichen.
Trotz der Herausforderungen wie Wissenskonflikte, übermäßige Abhängigkeit von parametriertem Wissen und das Potenzial für Halluzinationen haben diese KI-Modelle, mit der richtigen Prompt-Engineering, sich als transformative Werkzeuge erwiesen. Anweisungsfeinabstimmung, kontext-treues Prompting und die Integration mit externen Datenquellen erhöhen weiterhin ihre Fähigkeit, zu denken, zu lernen und sich anzupassen.


