
Grundlæggende AI
Hvordan fungerer billedklassificering?

 Føj Unite.AI til dine foretrukne kilder på Google
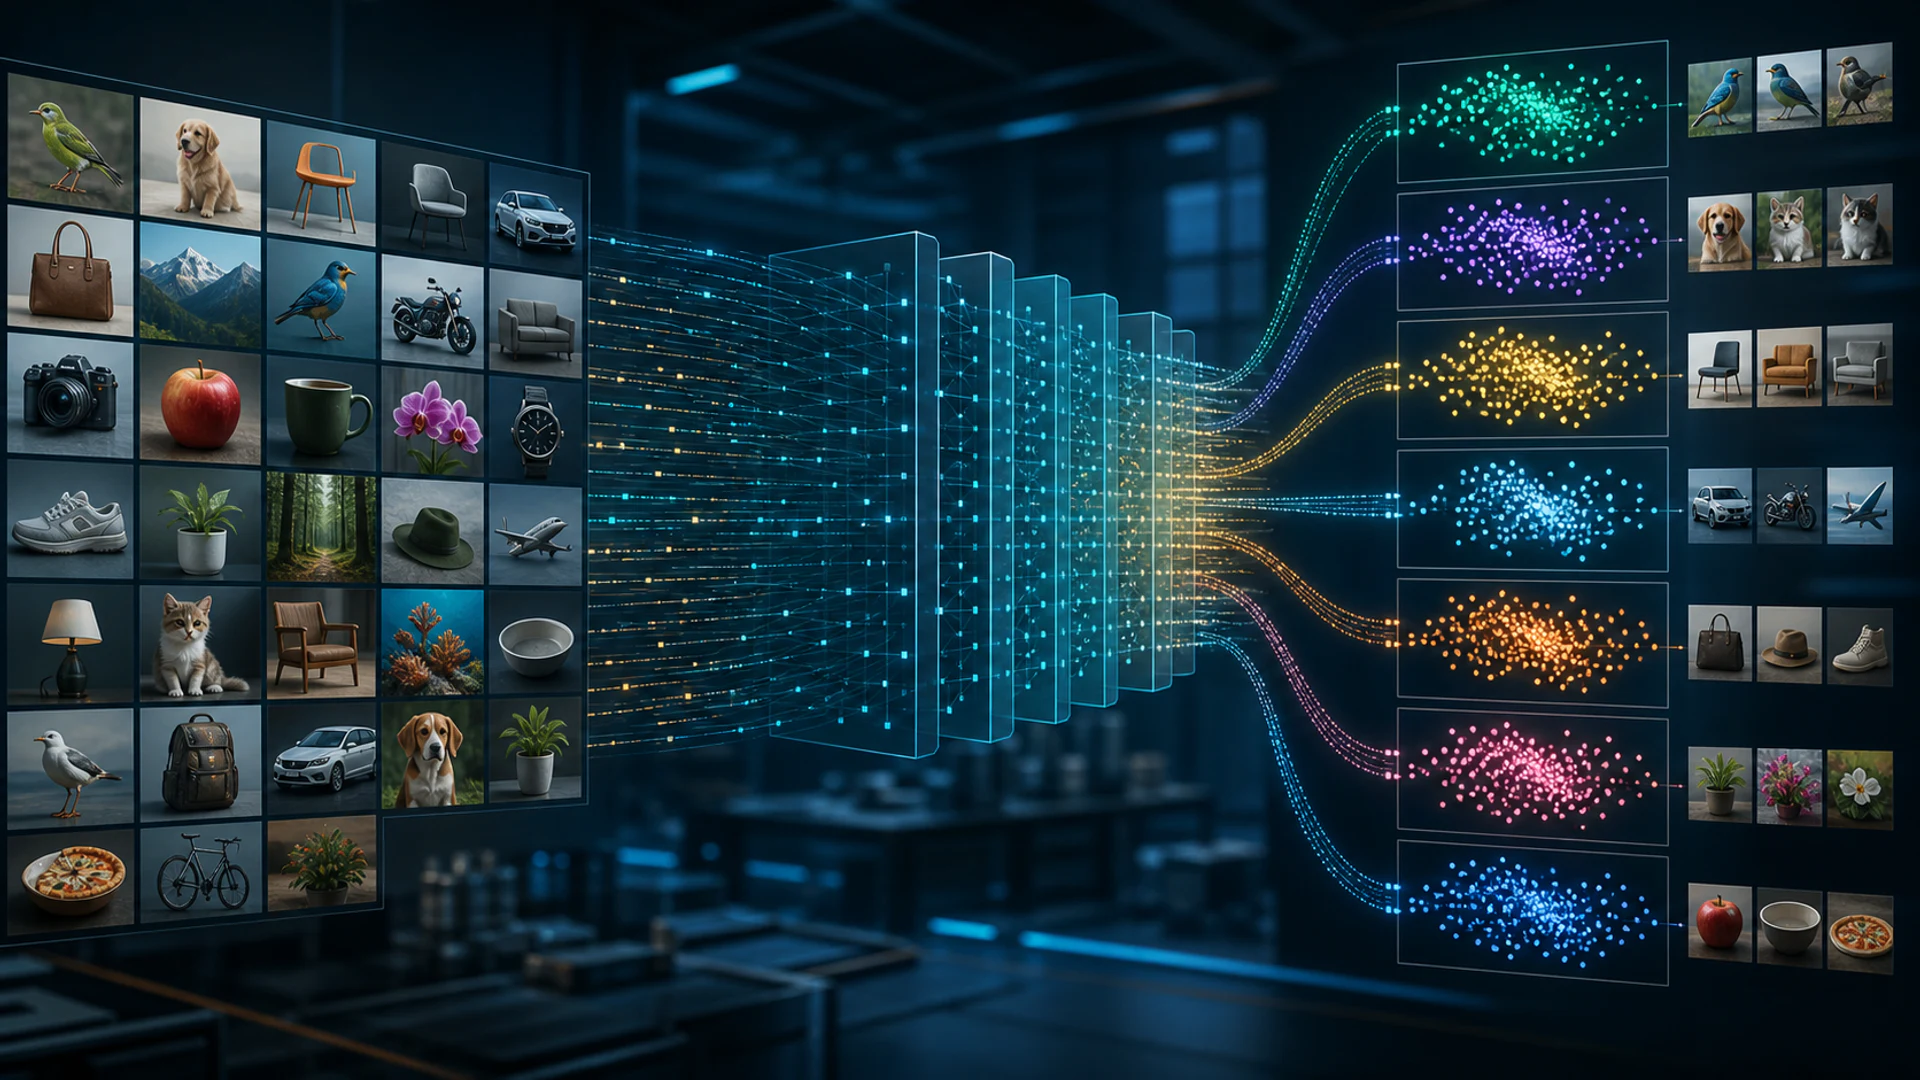
Image classification forudsiger en etiket for et helt billede. Den besvarer spørgsmål som “Hvilken produktkategori vises?” eller “Indeholder dette scan et målfund?” Den lokaliserer ikke selv hvert objekt eller markerer dets pixels.
Moderne systemer bruger typisk konvolutionelle neurale netværk eller vision‑transformere, ofte initialiseret med fortrænede vægte. Pålidelig ydeevne afhænger stadig af etiketter, sampling, augmentation, kalibrering og test under reelle implementeringsforhold.
Vigtige pointer
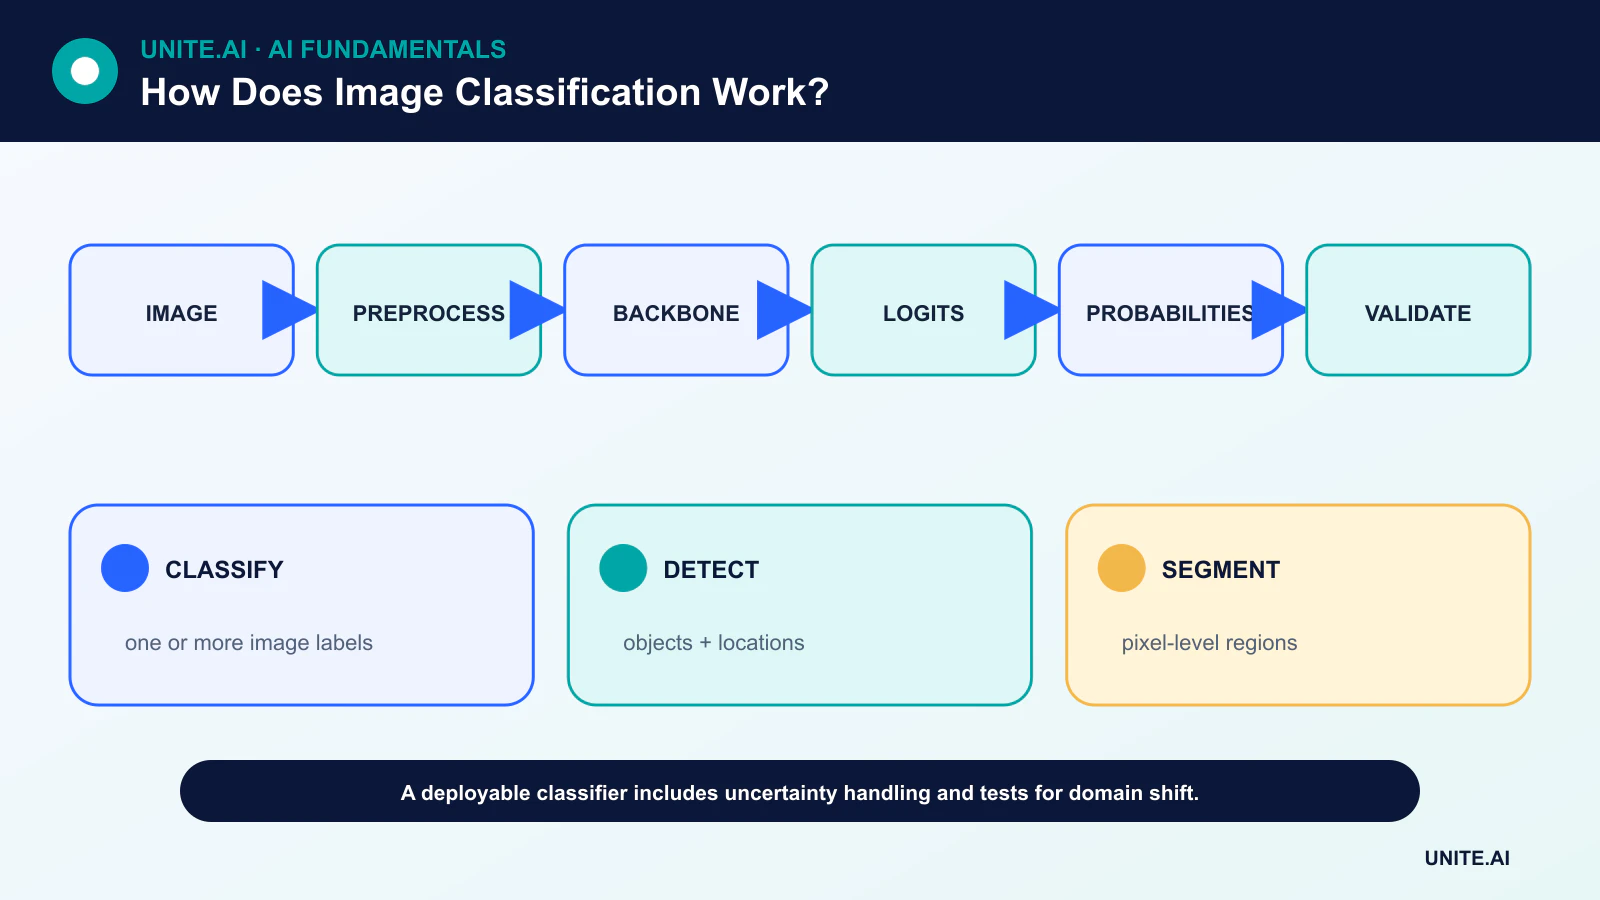
- Klassificering mærker hele billedet; detektion tegner objektbokse, og segmentering tildeler pixel‑niveau regioner.
- Fortræning og transfer‑learning kan reducere datakrav, men domænemismatch kan fjerne fordelen.
- Den samlede nøjagtighed kan skjule klasseubalancer, falske genveje og dårlig kalibrering.
- Billedkvalitet, optageudstyr, geografi og ændringer i arbejdsflow kan alle skabe distributionsskift.
Fra pixels til scorer
Billeder ændres i størrelse eller beskæres, normaliseres og konverteres til tensorer. Data‑augmentation kan anvende label‑bevarende transformationer såsom spejling, beskæring eller farveændringer. En backbone kortlægger pixels til funktioner; et klassifikations‑hoved producerer logits, som konverteres til relative klassescores.
Den valgte forbehandling skal matche implementeringen. En centrering, der fjerner det relevante objekt, eller en normaliserings‑mismatch kan skade ydeevnen, selvom de trænede vægte forbliver uændrede.
CNN’er og vision‑transformere
Convolutional neural networks bruger lokale filtre og delte vægte til at opbygge rumlige funktioner. Residual‑forbindelser gjorde meget dybe CNN’er lettere at optimere. Vision‑transformere opdeler et billede i lapper og bruger attention til at modellere relationerne mellem dem.
Sammenligninger af arkitekturer bør kontrollere for træningsdata, augmentation, beregningsressourcer og opløsning. Den bedste model på et offentligt benchmark er måske ikke den bedste til en edge‑enhed, et lille datasæt eller et krav om forklarlighed.
Transfer‑learning og datadesign
Transfer learning starter fra vægte trænet på et større kilde‑datasæt. Et team kan fryse backbone, finjustere senere lag eller opdatere hele modellen. Finjustering kræver typisk en lavere læringsrate og et valideringssæt, der er sikkert mod lækage.
Etiketter bør beskrive, hvad der er synligt udledeligt. Hvis en diagnose afhænger af patienthistorik, der ikke er tilgængelig i billedet, kan klassifikatoren ikke lære den fulde kliniske beslutning. Duplikater, rammer fra samme video og billeder fra den samme person skal forblive i samme split.
Målinger, usikkerhed og genveje
Top‑1‑nøjagtighed kræver, at den højest scorerede klasse er korrekt; top‑k‑nøjagtighed accepterer den korrekte klasse blandt de k højeste scorer. Præcision, recall per klasse og en forvirringsmatrix afslører ujævne fejl.
Modeller kan udnytte baggrunde, vandmærker, indfangningsudstyr eller indramning i stedet for det tilsigtede objekt. Kontrafaktiske tests, undergruppeanalyse og salienciværktøjer kan hjælpe med at opdage genveje, men et forklarings‑heatmap er ikke bevis på kausal ræsonnement.
Overvågning af implementering
Produktionskontroller bør dække korrupte filer, uventede dimensioner, sløring, belysning, kameramodeller og nye klasser. Tillid bør kalibreres på data, der ligner implementeringen, og input uden for omfanget bør afvises eller gennemgås.
Overvågning af forsinkede etiketter og ændringer i fejlomkostninger er afgørende. En model, der ser stabil ud ud fra input‑statistik, kan stadig fejle, hvis forholdet mellem pixels og etiketter ændres.
Opbygning af et billedklassificerings‑datasæt
Billedklassificering tildeler én eller flere etiketter til et helt billede. Det adskiller sig fra detektion, som lokaliserer objekter, og segmentering, som mærker pixels. Definér klassens omfang, hierarki, multi‑label‑regler, baggrunds‑ eller ukendte kategorier, og hvilket bevis der skal være synligt. Indsaml kameraer, lokationer, belysning, synsvinkler, afstande og motiver, der repræsenterer implementeringen. Del op efter motiv, scene, session eller kilde inden augmentation; tilstødende videorammer eller duplikerede produktbilleder på tværs af partitioner forårsager alvorlig lækage.
Annoteringsinstruktioner bør dække okklusion, tvetydige objekter, flere klasser, lav kvalitet og afholdenhed. Mål enighed og gennemgå systematisk uenighed. Klassebalance alene sikrer ikke dækning: en sygdomsklasse kan indeholde én enhed, eller en vilde‑dyrelivsklasse kun én baggrund. Inspicer metadata og næsten‑duplikater, og hold et beskyttet test‑sæt fra uafhængig indsamling. Syntetiske data og web‑scraping kan udvide variationen, men introducerer licens‑, oprindelses‑, stil‑ og label‑problemer, som skal måles på rigtige billeder.
Modeller, træning og evaluering
Klassiske metoder kombinerer konstruerede beskrivelser med en klassifikator; moderne systemer bruger konvolutionelle netværk eller vision‑transformere, ofte via transfer‑learning. Valg af størrelse og beskæring bestemmer, hvilken information der overlever. Augmentation bør afspejle gyldig variation og bevare etiketter. Optimér et opgave‑passende tab, håndtér ubalance gennem vægtning eller sampling omhyggeligt, og vælg checkpoints på valideringsdata. Sammenlign med en simpel baseline og fjern (ablate) augmentation, opløsning og fortrænet initialisering for at forstå, hvor gevinsterne kommer fra.
Rapporter præcision, recall, F1, forvirring, top‑k‑nøjagtighed (når relevant), kalibrering og ydeevne pr. betingelse. Test sløring, komprimering, belysning, beskæring, okklusion, enhed og input uden understøttet klasse. Tillidsterskler kan dirigere usikre tilfælde til gennemgang; softmax‑sandsynlighed garanterer ikke tillid, især under skift. Kontrafaktiske baggrunde og okklusionstests afslører genvejslæring. For sikkerhedsrelateret brug, evaluer værst tænkelige fejl og konsekvenserne af falske positiver og negativer.
Implementering og overvågning
Pak decode, farvekonvertering, orientering, normalisering, model og label‑kort sammen. Valider den eksporterede eller kvantiserede artefakt på mål‑enheder og mål end‑to‑end‑latens, hukommelse, strømforbrug og gennemløb. Overvåg billedkvalitet, input‑ og output‑distributioner, kalibrering, bekræftede etiketter og sensorsundhed. Minimér og sikr opbevaring af billeder, især ansigter, lokationer og tilskuere. Giv en fallback for korrupte eller uden for omfanget‑input og rul model‑versioner tilbage. Klassificering besvarer det definerede billed‑niveau spørgsmål; den bør ikke udvides til at dække uunderstøttet lokalisering, identitet eller intention.
Praktisk eksempel: klassificering af genanvendelige materialer
En facilitet fotograferer genstande på en transportbånd og mærker materialeklasse, forurening og ukendt. Billederne opdeles efter indsamlingstag og objektbatch, og dækker belysning, våde overflader, krølning, overlapning og tomme bånd. En lille CNN og en fortrænet model sammenlignes med farve‑ og formregler. Per‑klasse recall, fejlsortering, kalibrering, gennemløb og resultater efter kamera og materialebetingelse driver udvælgelsen.
Produktions‑pipeline verificerer kamera‑eksponering og bånd‑timing, og sender derefter usikre genstande til en generel strøm i stedet for at tvinge en klasse. Kvantiseret inferens valideres på præcis hardware. Overvågning sporer input‑kvalitet, klassesatser, afvisninger og udvalgte manuelle revisioner; ny emballage udløser en gennemgået dataopdatering. Modellen styrer en begrænset sorter med fysiske afskærmninger, og sensor‑ eller model‑fejl bringer mekanismen i en sikker tilstand i stedet for stiltiende at omdirigere materialet forkert.
Implementeringsbeviser og operationel beredskab
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tilsigtede brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før finjustering. Test almindelige tilfælde, grænsebetingelser, fejl‑ eller manglende input, distributionsskift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der sandsynligvis er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latens, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering, tildel myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst injicerede fejl. Operativ telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, og gennemgå real‑world‑beviser efter implementering i stedet for at antage, at offline‑ydelsen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system har også brug for dokumenteret genoprettelse, hændelseslæring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Kan en billedklassifikator identificere flere objekter?
En multilabel‑klassifikator kan angive, hvilke kategorier der er til stede, men den lokaliserer ikke individuelle forekomster. Objekt‑detektion er nødvendig for bokse eller optællinger.
Hvorfor kan en model fejle på fotos, der ser normale ud for en person?
Den kan basere sig på optage‑artefakter, teksturer eller korrelationer, der er ændret. Små forskelle i forbehandling og domæneskift kan også påvirke de indlærte funktioner.
Primære referencer












