
Grundlæggende AI
Hvad er Computer Vision?

 Føj Unite.AI til dine foretrukne kilder på Google
Computer vision er området, der bygger systemer, som udtrækker nyttig information fra billeder og video. En vision-model kan klassificere et helt billede, lokalisere objekter, mærke hver pixel, læse tekst, estimere pose, spore bevægelse eller forbinde visuelt indhold med sprog.
Moderne visionsystemer gengiver ikke blot den tidlige kantdetekteringsproces i den menneskelige perception. De lærer opgavespecifikke repræsentationer fra data, ofte ved brug af convolutional neural networks, vision transformers eller multimodale foundation-modeller.
Vigtige pointer
- Klassificering, detektion, segmentering, OCR, sporing og generering er forskellige visionsopgaver.
- CNN’er indbygger lokalitet og vægtdeling; vision transformers bruger attention på tværs af billedfliser.
- Etiketter kan komme fra mennesker, svag supervision, syntetiske data eller selv-superviserede mål.
- Nøjagtighed alene er utilstrækkelig: robusthed, latenstid, privatliv, bias og omkostninger ved fejl er vigtige.
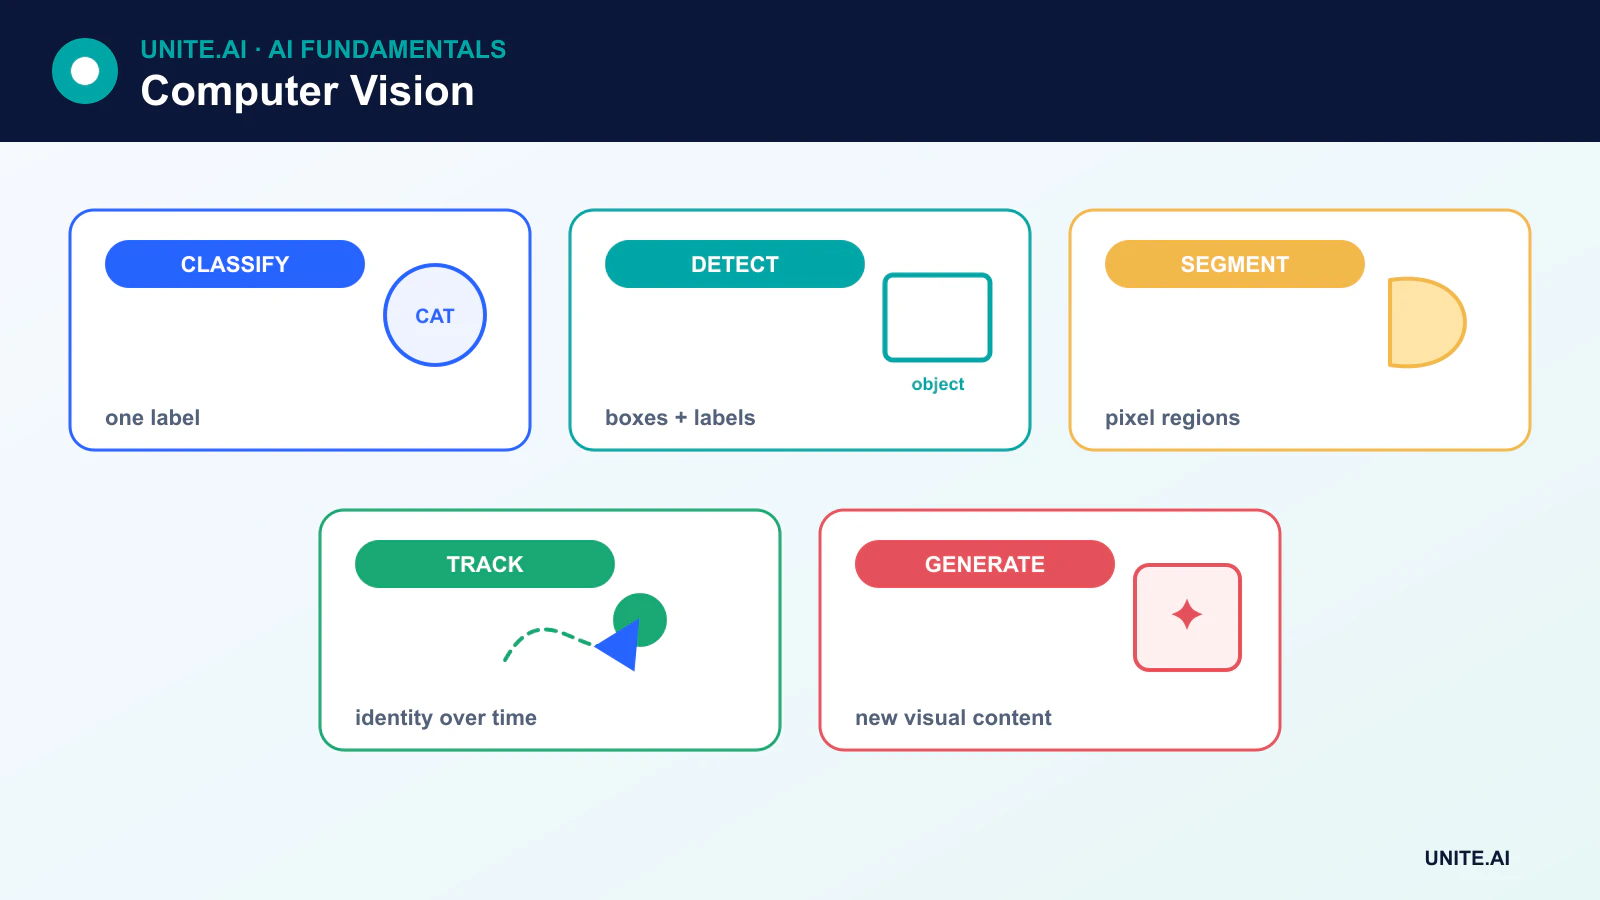
De vigtigste computer-vision-opgaver
- Image classification tildeler én eller flere etiketter til et billede. Se hvordan billedklassificering fungerer.
- Object detection forudsiger kategorier og afgrænsningsbokse for flere objekter.
- Semantic segmentation mærker hver pixel efter klasse, mens instance segmentation adskiller individuelle objekter.
- Optical character recognition (OCR) opdager og transskriberer tekst.
- Pose estimation forudsiger krops- eller objekt-landemærker.
- Tracking forbinder detektioner på tværs af videoframes.
- Image generation and editing producerer eller transformer visuel indhold, ofte ved brug af diffusion models.
Hvordan billeder bliver modelinput
Et digitalt billede er allerede numeriske data: en tensor, der indeholder pixelværdier på tværs af rumlige dimensioner og kanaler. Forbehandling kan ændre størrelse, normalisere, beskære eller augmentere billedet. Video tilføjer en tidsdimension, mens medicinsk og videnskabelig billeddannelse kan tilføje dybde, bølgelængde eller andre modaliteter.
Klassisk computer vision brugte hånddesignede kant-, hjørne- og teksturfunktioner. Moderne dybe modeller lærer typisk funktioner i fællesskab med opgaven, selvom klassiske metoder stadig er nyttige, når data er begrænsede, regler er velkendte, eller beregning skal holdes minimal.
CNN’er og lærte lokale funktioner
En CNN anvender lærte kerner over lokale nabolag. Tidlige lag kan reagere på lokale mønstre, mens senere blokke kombinerer dem til opgave-relevante repræsentationer. Pooling eller strided operationer reducerer den rumlige opløsning, og residualforbindelser gør dybe netværk lettere at optimere.
En moderne CNN-klassifikator bruger ofte global pooling i stedet for en stor stak af fuldt forbundne lag. Detektorer og segmenteringsnetværk tilføjer specialiserede hoveder eller dekoderstier, der bevarer rumlig information.
Vision transformers og foundation-modeller
En vision transformer deler et billede op i fliser, indlejrer dem og bruger attention til at modellere deres relationer. Transformers kan skaleres effektivt med store datasæt og fortræning, mens CNN’er ofte giver stærkere indbyggede antagelser og effektivitet i mindre skalaer.
Multimodale modeller justerer billeder med tekst, så brugere kan søge, tilføje billedtekster, besvare spørgsmål eller guide segmentering ved hjælp af sprog. Disse modeller udvider kapaciteten, men arver også svagheder fra brede web-skala data, herunder stereotyper, ophavsretligt beskyttet materiale og ujævn dækning af befolkninger og miljøer.
Etiketter, selv-supervision og syntetiske data
Afgrænsningsbokse, masker, landemærker og billedtekster kan være dyre at skabe. Selv-superviserende læring udleder mål fra billederne selv, mens svag supervision bruger støjende eller indirekte etiketter. Syntetiske data kan tilføje sjældne scenarier, men simuleringshuller kan forhindre, at syntetisk ydeevne overføres til den virkelige verden.
Annotationskvalitet skal måles. Tvetydige etiketter, inkonsistente grænser og manglende objekter sætter en loft på ydeevnen og kan skjule fejl i undergrupper.
Hvordan visionsystemer evalueres
Klassificering bruger målinger såsom nøjagtighed, præcision, recall, F1 og kalibrering. Detektion anvender typisk intersection over union og mean average precision. Segmentering bruger intersection over union eller Dice-lignende mål. Sporing tilføjer identitets- og trajektormålinger.
Målingen skal matche implementeringen. En model kan klare sig godt på et kurateret benchmark og alligevel fejle i regn, svagt lys, usædvanlige kameravinkler, nye enheder eller ukendte befolkninger. Evaluering bør inkludere fordelingens skift, modstandskraft mod angreb og operationel latenstid.
Privatliv, bias og implementering
Ansigter, nummerplader, boliger, medicinske scanninger og video fra arbejdspladser kan afsløre følsomme oplysninger. Indsamling og opbevaring bør følge en defineret juridisk og etisk grundlag, med adgangskontrol og dataminimering. Ansigtsanalyse og biometrisk identifikation kræver særlig opmærksomhed, da fejl og overvågning kan påføre ulige skader.
Edge-implementering kan reducere latenstid og dataoverførsel. Edge AI, kvantisering, beskæring og specialiserede acceleratorer kan gøre visionsystemer praktiske på kameraer, køretøjer, robotter og mobile enheder, men kompression skal revurderes med hensyn til nøjagtighed og bias.
Fra pixels til visuelle opgaver
Computer vision omdanner billeder eller video til opgaveoutput såsom klassificering, detektion, segmentering, sporing, pose, dybde, optisk flow eller tekstgenkendelse. Opgavedefinitionen bestemmer annotation: en billedetiket kan ikke træne præcis lokalisering, og en afgrænsningsboks kan ikke fuldt beskrive en segmenteringsmaske. Kameraets geometri, linser, eksponering, belysning, bevægelse, kompression og synsvinkel former datafordelingen. Definér driftsmiljøet og fejlkonsekvensen, før du vælger en model, fordi en benchmark-billedsamling måske ikke repræsenterer den implementerede sensor eller scene.
En pipeline dekoder og orienterer medier, ændrer størrelse eller fliser dem, normaliserer værdier, anvender label-bevarende augmentation, kører en model og efterbehandler logits, bokse, masker eller spor. Objektdetektorer bruger tillidsgrænser og undertrykkelse; trackere forbinder detektioner over tid; segmentering kan kræve morfologisk oprydning. Bevar koordinattransformationer, så outputtet stemmer overens med det originale billede. Del data efter person, kamera, lokation eller optagelsessession for at undgå næsten identiske frames i både trænings- og testdatasæt.
Evaluering, bias, privatliv og drift
Målinger skal matche opgaven og brugen. Klassificering kræver klasse-specifik præcision og recall; detektion bruger intersection-over-union og gennemsnitlig præcision på tværs af tærskler; segmentering bruger IoU eller Dice; sporing tilføjer identitets-skift; latenstid og varighed af missede hændelser er vigtige for video. Rapporter resultater efter belysning, afstand, enhed, tilstopning, hudtone, alder og andre relevante forhold. Undersøg kalibrering og fejl med høj tillid. Syntetiske eller augmenterede data kan udfylde huller, men kræver sammenligning med reelle implementeringsdata og må ikke lække testscener.
Vision kan indsamle tilskuere, lokationer, biometrik og følsom adfærd. Minimér optagelse og opbevaring, sikr strømme, begræns sekundær brug og giv meddelelse eller samtykke, hvor påkrævet. Test modstand mod adversarielle patches, genafspilning, tilstopning, kamerafejl og domæneskift. Overvåg sensorens sundhed, inputstatistik, outputhastighed og bekræftede resultater; bevar menneskelig gennemgang for væsentlige beslutninger. Sløring eller beskæring kan reducere eksponering, men kan også fjerne beviser. En høj laboratoriescore retfærdiggør ikke påstande om identitet, følelser eller intentioner ud over den validerede opgave.
Eksempel: fodgængerdetektion ved en lagerkrydsning
Kameraer overvåger en begrænset køretøjskrydsning, og modellen detekterer personer i stedet for at identificere dem. Data dækker dag og nat, vejr, påklædning, tilstopning, kørestolsbrugere, kamerapositioner og tomme scener, opdelt efter optagelsessession. Detektoren evalueres for hændelses-recall, falske alarmer, lokalisering, advarselsforsinkelse og ydeevne på afstand. Sikkerhedsingeniørarbejde definerer den maksimale tolererede latenstid og uafhængige fysiske kontroller.
Vision-advarslen kan bremse et køretøj, men nødstoppere og barrierer afhænger ikke af den lærte model. Kameraobstruktion, frosne frames, netværkstab og model-timeout forårsager eksplicitte fejl. Rå videoopbevaring minimeres, og adgang logges. Overvågning sporer sensorens sundhed, alarmrater, gennemgåede hændelser og næsten-misforståelser efter forhold. Enhver flytning af kamera eller layoutændring udløser genvalidering, fordi tilsyneladende billedlighed ikke garanterer samme geometri eller risiko.
Implementeringsbeviser og driftsparathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før tuning. Test almindelige tilfælde, grænsebetingelser, fejlformet eller manglende input, fordelingens skift, afhængighedsnedbrud, misbrug og de grupper eller miljøer, der sandsynligvis er underbetjent. Mål opgavekvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering, tildel myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operativ telemetri bør afsløre inputkvalitet, outputadfærd, model- eller regelversion, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarmtærskler og en ansvarlig for respons, gennemgå derefter beviser fra den virkelige verden efter implementering i stedet for at antage, at offline‑ydeevne vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system har også brug for dokumenteret genopretning, hændelseslæring, sletnings‑ og opbevaringsprocedurer samt et klart punkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Er computer vision det samme som billedgenkendelse?
Nej. Billedgenkendelse refererer typisk til klassificering eller identifikation. Computer vision omfatter også lokalisering, segmentering, måling, sporing, rekonstruktion, generering og ræsonnement over visuel information.
Ser et visionsystem som et menneske?
Nej. En model behandler numeriske input i henhold til sin arkitektur og træningsmål. Den kan overgå mennesker på et snævert benchmark, men fejle ved små ændringer, som en person let kan håndtere.
Primære referencer












