
Andersons vinkel
Indførelse af visuelle analogier i kunstig intelligens

 Føj Unite.AI til dine foretrukne kilder på Google
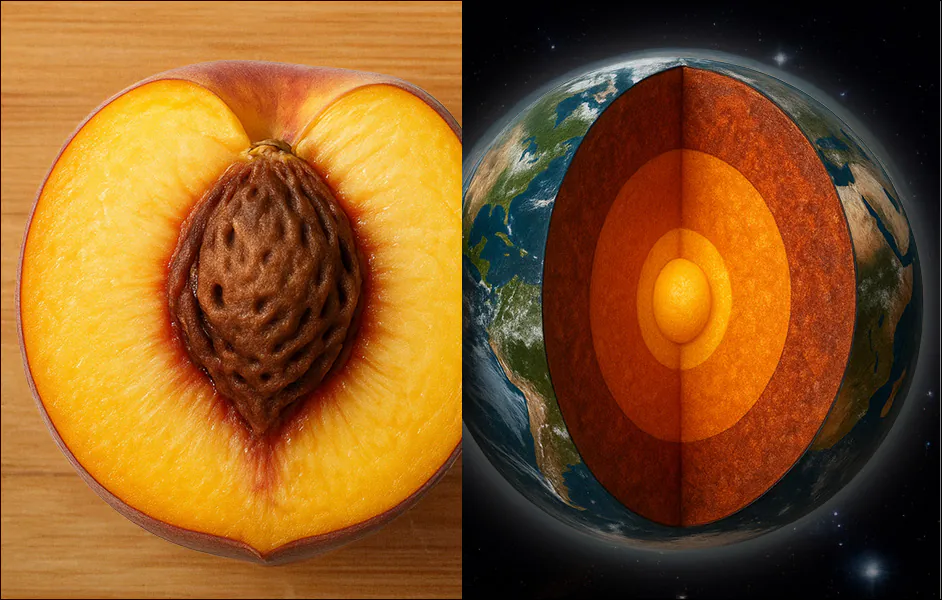
Nuværende AI-modeller kan ikke genkende ‘relationelle’ lignende billeder, såsom hvordan jordens lag er lignende en fersken, og mangler derfor en væsentlig del af, hvordan mennesker opfatter billeder.
Selv om der findes mange computer vision-modeller, der kan sammenligne billeder og finde lignende billeder, har den nuværende generation af sammenligningsystemer kun lidt eller ingen fantasifuld kapacitet. Overvej nogle af teksten i den klassiske 1960’er-sang, Windmills of Your Mind:
Like a carousel that’s turning, running rings around the moon
Like a clock whose hands are sweeping past the minutes of its face
And the world is like an apple whirling silently in space
Sammenligninger af denne type repræsenterer et domæne af poetisk henvisning, der er meningsfuld for mennesker på en måde, der går langt ud over kunstnerisk udtryk; det er snarere forbundet med, hvordan vi udvikler vores percipiente systemer; da vi skaber vores ‘objekt’-domæne, udvikler vi en kapacitet for visuel lignelse, sådan at – for eksempel – tværsnitsbilleder af en fersken og jorden, eller fraktale rekursioner såsom kaffekræmmerspiraler og galaksegrene, registrerer som analoge med os.
På denne måde kan vi slutte forbindelser mellem åbenbart uforbindelige objekter og typer af objekter, og slutte systemer (såsom tyngdekraft, impuls og overfladekohæsion) som kan anvendes på en række domæner på forskellige niveauer.
At se ting
Selv de nyeste generationer af billed-sammenlignings-AI-systemer, såsom Learned Perceptual Image Patch Similarity (LPIPS) og DINO, som er informeret af menneskelig feedback, udfører kun litterale overflade-sammenligninger.
Deres kapacitet til at finde ansigter, hvor der ikke er nogen – dvs. pareidolia – repræsenterer ikke den type visuelle lignelse-mekanismer, som mennesker udvikler, men skyldes snarere, at ansigts-søgende algoritmer anvender lav-niveau ansigts-struktur funktioner, der nogle gange er i overensstemmelse med tilfældige objekter:

Eksempler på falske positiver for ansigts-genkendelse i ‘Faces with Things’-datasettet. Kilde
For at bestemme, om maskiner kan udvikle vores fantasifulde kapacitet til at genkende visuel lignelse på tværs af domæner, har forskere i USA gennemført en undersøgelse omkring relationel visuel lignelse, og har kurateret og trænet en ny dataset, der er designet til at tvinge abstrakte relationer til at danne mellem forskellige objekter, der er forbundet med en abstrakt relation:

De fleste AI-modeller genkender kun lignelse, når billeder deler overflade-træk såsom form eller farve, hvilket er hvorfor de kun linker Gruppe B (ovenfor) til referencebilledet. Mennesker ser dog også Gruppe A som lignende – ikke fordi billederne ligner hinanden, men fordi de følger den samme underliggende logik, såsom at vise en transformation over tid. Det nye arbejde forsøger at reproducere denne type strukturel eller relationel lignelse og bringe maskin-perception nærmere menneskelig resonnering. Kilde: https://arxiv.org/pdf/2512.07833
Kapitel-systemet, der er udviklet til datasettet, muliggør usædvanligt abstrakte annoteringer, designet til at tvinge AI-systemer til at fokusere på grundlæggende karakteristika snarere end specifikke lokale detaljer:

De forudsagte ‘anonyme’ undertekster, der bidrager til forfatternes ‘relsim’-måling.
Den kuraterede samling og dens usædvanlige undertekststil fremmer forfatternes nye foreslåede måling relsim, som forfatterne har fine-tuned til en vision-sprog-model (VLM).

En sammenligning mellem undertekststilen i typiske dataset, der fokuserer på attribut-lignelse, hvorimod relsim-tilgangen (nederste række) fremhæver relationel lignelse.
Den nye tilgang bygger på metoder fra kognitiv videnskab, især Dedre Gentners Structure-Mapping-teori (en studie af analogi) og Amos Tverskys definition af relationel lignelse og attribut-lignelse.

Fra det tilhørende projekt-website, et eksempel på relationel lignelse. Kilde
Forfatterne skriver:
‘[Mennesker] behandler attribut-lignelse perceptuelt, men relationel lignelse kræver konceptuel abstraktion, ofte understøttet af sprog eller forhåndsviden. Dette antyder, at genkendelse af relationel lignelse først kræver forståelse af billedet, udnyttelse af viden og abstraktion af dets underliggende struktur.’
Den nye artikel har titlen Relationel visuel lignelse og følges med en projekt-website (se video indlejret i slutningen af denne artikel).
Metode
Forskerne anvendte en af de bedst kendte hyperskale-dataset som udgangspunkt for deres egen samling – LAION-2B:

Metadata for en indgang i LAION-2B-samlingen. Kilde
114.000 billeder, der sandsynligvis indeholder elastiske relationelle strukturer, blev udtrukket fra LAION-2B, hvilket involverede filtrering af de mange lavkvalitetsbilleder, der er til stede i det minimalt-kuraterede dataset.
For at oprette en pipeline til dette udvælgelsesprocess, anvendte forfatterne Qwen2.5-VL-7B, der udnyttede 1.300 positive og 11.000 negative menneske-labelede eksempler:

RelSim-systemet trænes i tre faser: filtrering af billeder fra LAION-2B for relationel indhold; tildeling af hver gruppe en fælles anonym undertekst, der fanger deres underliggende logik; og læring af at matche billeder til disse undertekster ved hjælp af en kontrastiv tab.
Artiklen skriver:
‘Annotatorerne blev instrueret: “Kan du se nogen relationel mønster, logik eller struktur i dette billede, der kunne være nyttigt til at oprette eller linke til et andet billede?”. Den fine-tuned model opnår 93% overensstemmelse med menneskelige vurderinger, og når den anvendes på LAION-2B, giver den N = 114k billeder, der er identificeret som relationelt interessante.’
For at generere relationelle mærker fik forfatterne Qwen-modellen til at beskrive den fælles logik bag billeder uden at nævne specifikke objekter. Denne abstraktion var svær at opnå, når modellen kun så ét billede, men blev mulig, når flere eksempler demonstrerede den underliggende struktur.
De resulterende gruppe-niveau-undertekster erstattede specifikke termer med pladsholdere såsom ‘{Emne}’ eller ‘{Type af bevægelse}’, hvilket gjorde dem bredt anvendelige.
Efter menneskelig verificering blev hver undertekst parret med alle billeder i dens gruppe. Over 500 sådanne grupper blev anvendt til at træne modellen, der derefter blev anvendt på de 114.000 filtrerede billeder for at producere en stor samling af abstrakte, relationelt annoterede eksempler.
Data og tests
Efter udtrækning af relationelle funktioner med Qwen2.5-VL-7B blev en model fine-tuned på data ved hjælp af LoRA, i 15.000 trin, via otte A100-GPU’er*. For tekst-siden blev relationelle undertekster indlejret ved hjælp af all-MiniLM-L6-v2 fra Sentence-Transformers-biblioteket.
Datasettet på 114.000 undertekstede billeder blev delt i 100.000 til træning og 14.000 til evaluering. For at teste systemet blev en retrieval-opstilling anvendt: givet et forespørgselsbillede, skulle modellen finde et andet billede fra en 28.000-genstandspool, der udtrykte den samme relationelle idé. Retrieval-poolen indeholdt 14.000 evalueringsbilleder og 14.000 yderligere eksempler fra LAION-2B, med 1.000 forespørgsler valgt tilfældigt fra evalueringssættet til benchmarking.
For at evaluere retrieval-kvalitet blev GPT-4o anvendt til at score den relationelle lignelse mellem hver forespørgsel og hentet billede på en skala fra 0 til 10. En separat menneskelig studie blev også gennemført for at måle brugerpræference (se nedenfor).
Hver deltager blev vist et anonymt forespørgselsbillede med to kandidater, en hentet af den foreslåede metode og en af en baseline. Deltagerne blev bedt om at afgøre, hvilket billede der var mere relationelt lignende med forespørgselsbilledet, eller hvis begge var lige nær.
RelSim-tilgangen blev sammenlignet med flere etablerede billed-til-billede-lignelse-metoder, herunder den ovenfor nævnte LPIPS og DINO, såvel som dreamsim og CLIP-I. Ud over baselines, der direkte beregner lignelse-scores mellem billedpar, såsom LPIPS, DINO, dreamsim og CLIP-I, testede forfatterne også tekst-baserede metoder, hvor Qwen blev anvendt til at generere en anonym eller abstrakt undertekst for hvert billede.; dette fungerede derefter som retrieval-forespørgslen.
To retrieval-variationer blev evaluaret, med CLIP-baseret tekst-til-billede-retrieval (CLIP-T) anvendt til tekst-til-billede-retrieval, og Qwen-T anvendt til tekst-til-tekst-retrieval. Begge tekst-baserede baselines anvendte den oprindelige præ-trænede Qwen-model i stedet for den version, der var fine-tuned på relationel logik. Dette tillod forfatterne at isolere effekten af gruppe-baseret træning, da den fine-tuned model havde været udsat for billed-sæt i stedet for isolerede eksempler.
Eksisterende målinger og relationel lignelse
Forfatterne testede oprindeligt, om eksisterende målinger kunne fange relationel lignelse:

Sammenligning af retrieval-præstationer vurderet af GPT-4o, visende den gennemsnitlige relationelle lignelse-score for hver metode. Konventionelle lignelse-målinger såsom LPIPS, DINO og CLIP-I opnåede lavere scores. Tekst-baserede baselines Qwen-T og CLIP-T opnåede også lavere scores. Den højeste score blev opnået af relsim (6,77, højre mest blå kolonne), hvilket indikerer, at tilpasning på gruppe-baserede relationelle mønstre forbedrede alignment med GPT-4o’s vurderinger.
Med hensyn til disse resultater skriver forfatterne**:
‘[LPIPS], der fokuserer ren på perceptuel lignelse, opnår den laveste score (4,56). [DINO] opfører sig kun lidt bedre (5,14), sandsynligvis fordi den er trænet udelukkende på en selv-suppleret måde på billed-data. [CLIP-I] giver den stærkeste resultater blandt baselines (5,91), sandsynligvis fordi nogen abstraktion nogen gange er til stede i billed-undertekster.
‘Men CLIP-I opfører sig stadig dårligere i forhold til vores metode, da opnåelse af en bedre score måske kræver evnen til at nå endnu højere abstraktioner, såsom dem i anonyme undertekster.’
I den menneskelige studie foretrækker mennesker konsekvent relsim-metoden over alle baselines:

Relationelle lignelse-scores tildelt af GPT-4o for hver metode. Standard lignelse-målinger såsom LPIPS, DINO og CLIP-I opnåede lavere scores, og tekst-baserede variationer Qwen-T og CLIP-T opførte sig kun lidt bedre. Selv tilpassede versioner af DINO og CLIP lukkede ikke gapet. Den højeste score, 6,77, blev opnået af relsim-modellen, trænet med gruppe-baseret supervision.
Forfatterne bemærker:
‘Dette er yderst opmuntrende, da det ikke kun viser, at vores model, relsim, kan med succes hente relationelt lignende billeder, men også, igen, bekræfter, at mennesker faktisk opfatter relationel lignelse – ikke kun attribut-lignelse!’
For at udforske, hvordan relationel og attribut-lignelse kan supplere hinanden, anvendte forskerne en kombineret visualiseringsmetode. Et enkelt forespørgselsbillede (‘En hund, der holder et kamera’) blev sammenlignet med 3.000 tilfældige billeder, og lignelse blev beregnet ved hjælp af både relationelle og attribut-baserede modeller:

Fælles visualisering af visuel lignelse-rum ved hjælp af relationelle og attribut-akser. Et enkelt forespørgselsbillede, der viser en hund, der bruger et kamera, blev sammenlignet med 3.000 andre. Resultaterne blev organiseret efter relationel lignelse (vertikal) og attribut-lignelse (horisontal). Det øverste højre område indeholder billeder, der ligner forespørgselsbilledet i både logik og udseende, såsom andre hunde, der bruger værktøj. Det øverste venstre område indeholder semantisk relaterede, men visuelt forskellige tilfælde, såsom andre dyr, der udfører kamera-relaterede handlinger. De fleste resterende eksempler grupperer lavere i rummet, hvilket afspejler svagere lignelse. Layoutet viser, hvordan relationelle og attribut-modeller fremhæver komplementære aspekter af visuel data. Se venligst kilde-artiklen for bedre opløsning.
Resultaterne afslørede kluster, der svarer til forskellige typer lignelse: nogle billeder var både relationelt og visuelt lignende, såsom andre hunde i menneske-lignende stillinger; andre delte relationel logik, men ikke udseende, såsom andre dyr, der efterligner menneskelige handlinger; resten viste hverken.
Denne analyse antyder, at de to lignelse-typer spiller forskellige roller og giver rigere struktur, når de kombineres.
Brugsområder
Artiklen udforsker også nogle mulige slutbrugsområder for relationel lignelse, herunder relationel billed-retrieval, der tillader billed-søgning mere i overensstemmelse med menneskers egen kreative måde at se verden på:

Relationel retrieval returnerer billeder, der deler en dybere konceptuel struktur med forespørgselsbilledet, snarere end at matche overflade-træk. For eksempel returnerer en madvare, der er designet til at ligne et ansigt, andre antropomorfe måltider; et skåret objekt giver andre skårne former; og scener med voksen-afkom-interaktion returnerer billeder med lignende relationelle roller, selv når arter og sammensætning adskiller sig.
Et andet muligt brugsområde er analogisk billed-generering, der tillader syntese af forespørgsler, der anvender relationelle strukturer snarere end direkte beskrivelser. I en sammenligning af resultater, der er opnået med den nuværende generation af state-of-the-art tekst-til-billede-modeller, kan vi se, at resultaterne af en sådan tilgang sandsynligvis vil være mere diverse:

Givet et input-billede og en relationel prompt, blev modellerne bedt om at generere et nyt billede, der udtrykker den samme underliggende idé. Proprietære modeller producerede mere trofaste analogier, der bevarede strukturel logik på tværs af store ændringer i form, og open-sourced-modeller havde tendens til at gå tilbage til litterale eller stilistiske matches, og ikke lykkedes med at overføre den dybere idé. Output blev sammenlignet med menneske-kuraterede analogier, der exemplificerede den ønskede transformation.
Konklusion
Generative AI-systemer ville, det ser ud til, være bemærkelsesværdigt forbedret ved en evne til at inkorporere abstrakt repræsentation i deres konceptualiseringer. Som det er nu, vil en anmodning om koncept-baserede billeder såsom ‘vrede’ eller ‘lykke’ sandsynligvis returnere billeder, der er stiliseret fra de mest populære eller talrige billeder, der havde disse associationer i datasettet; hvilket er memorering snarere end abstraktion.
Det ser sandsynligt ud, at dette princip kunne være endnu mere nyttigt, hvis det kunne anvendes på generativ skrivning – især analytisk, spekulativ eller fiktiv output.
Tryk på afspil. Kilde
* En A100 kan have 40Gb eller 80GB af VRAM; dette er ikke specificeret i artiklen.
** Forfatternes citater er redundant og udeladt.
Først publiceret tirsdag, den 16. december 2025


