
Інтерв’ю
Заїд Аль Хамані, генеральний директор і засновник Boost Security – Інтерв’ю

 Додайте Unite.AI до бажаних джерел у Google
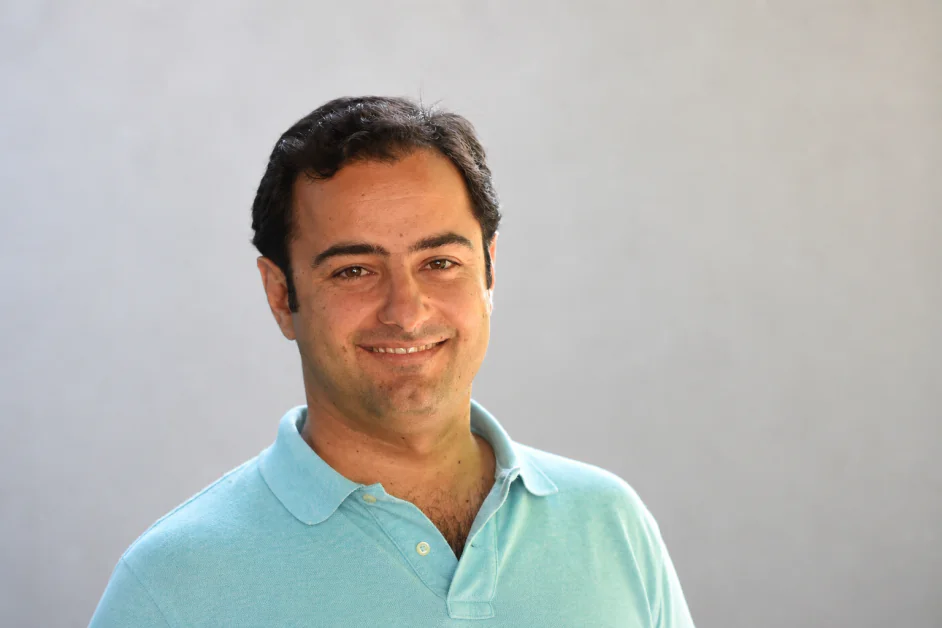
Заїд Аль Хамані, генеральний директор і засновник Boost Security, є експертом у галузі кібербезпеки та DevSecOps з більш ніж двома десятилітнями досвіду будівництва та масштабування глобальних технологічних операцій. З моменту заснування Boost Security у 2020 році він зосередився на модернізації того, як організації забезпечують безпеку розробки програмного забезпечення, спираючись на попередні ролі, включаючи віце-президента з безпеки додатків у Trend Micro та співзасновника/генерального директора IMMUNIO. Раніше він займав керівні посади у Canonical, очолюючи продукти, інженерні та глобальні ініціативи з підтримки, а також у SITA, де керував великомасштабними, критично важливими операціями з інформаційних технологій. Його кар’єра відображає сильний досвід будівництва команд, оптимізації систем та розвитку сучасних практик безпеки.
Boost Security – це компанія з кібербезпеки, яка зосереджена на забезпеченні безпеки сучасної ланки постачання програмного забезпечення через платформу DevSecOps, орієнтовану на розробників. Її технологія інтегрується безпосередньо у конвеєри CI/CD для автоматичного виявлення, пріоритезації та виправлення уразливостей, зменшуючи ручну обробку при збереженні швидкості розробки. Об’єднуючи безпеку додатків та ланки постачання в одну систему, платформа забезпечує повну видимість коду, залежностей та інфраструктури, допомагаючи організаціям зміцнювати стійкість у складних, хмарних середовищах.
Ви раніше очолювали безпеку додатків у Trend Micro і були співзасновником IMMUNIO. Що спонукало вас заснувати Boost Security, і яку прогалину на ринку ви були унікально позиціоновані для ідентифікації на ранній стадії?
IMMUN.IO була однією з перших компаній RASP, заснованих на нашому досвіді до того моменту, коли ми зрозуміли, що WAF як технологія безпеки в режимі реального часу була неможливою для підтримки та не дуже ефективною. Ми уявляли собі спосіб, коли WAF буде замінений на більш точне, легше підтримуване рішення – шляхом інструментування додатку.
Це було у 2012 році, коли DevOps ще був на ранній стадії, більшість команд не використовували Agile, а Kubernetes ще не був популярним.
Trend Micro придбала IMMUN.IO у 2017 році. На той момент вже були більш поширені практики DevOps: конвеєри CI/CD, Agile-розробка, швидші ітерації та цикли випуску, хмарні технології тощо. Команди розробників програмного забезпечення стали кращими у будівництві програмного забезпечення та його доставці. Безпека все ще була порушена, хоча:
- Сканиування відбувається занадто повільно, або результати надходять занадто пізно
- Результати надто складні для розробників, щоб вони могли щось зробити
- Є загально неприйнятна кількість хибно-позитивних результатів
- Багато нових типів артефактів не скануються: інфраструктура як код, контейнери, API тощо
Виробництво програмного забезпечення швидко стало легшим. Виробництво безпечного програмного забезпечення швидко все ще було складним.
Це була початкова проблема, яку ми поставили собі за мету вирішити. Зробити DevSecOps працездатним у реальному світі; чи можете ви змусити команду розробників легко додати безпеку до циклу розробки програмного забезпечення, зі швидкістю, що відповідає новим стандартам швидкості? Чи можете ви зробити охоплення широким – де одна платформа є всім, що вам потрібно? Чи можете ви зробити так, щоб розробники, а не тільки приймали технологію, але й приймали її та бачили її переваги? Чи можете ви зробити її масштабованою так, щоб вам не потрібно було велика кількість фахівців з безпеки, щоб устигати за кількістю написаного коду…
Ми допомогли компаніям впровадити безпеку у цикл розробки програмного забезпечення під час епохи DevOps. Це було перехід від 1 до 10. Тепер ми перебуваємо в епоху агентного кодування – де агенти пишуть величезну кількість коду – але це фундаментально та сама проблема – швидкість та обсяг коду просто перейшли від 10 до 100; і ми ставимо за мету продовжити ту саму траєкторію.
Ви стверджували, що життєвий цикл розробки програмного забезпечення (SDLC) фундаментально змінився вгору по течії. Який був момент, коли ви зрозуміли, що традиційні підходи до DevSecOps вже не достатні?
Це було спостереження за тим, як атакувальники насправді проникають. Ми постійно бачили одну й ту саму схему: відкритий робочий процес GitHub Actions, який ніхто не переглядав з моменту форкування репозиторію, токен з доступом до виробництва в хмарі, вбудований у конфігурацію запуску, легітимна робота CI, захоплена для розгортання вантажів атакувальника. Це стали відомі як атаки “живучи з конвеєра”, оскільки противник використовує вашу власну автоматизацію проти вас, з даними про доступ, які ваша команда безпеки вже схвалила.
Стек DevSecOps, який ми побудували за десятиліття, не мав відповіді на це. Сканування додатків SAST сканують джерельний код додатків. Сканування залежностей SCA сканують залежності додатків. Обидва припускають, що конвеєр, який їх запускає, є довіреним. Тим часом сам конвеєр є файлом YAML з командами shell, мережевим доступом та чутливими даними про доступ, і майже ніхто не переглядає його.
Коли це стає найлегшим шляхом, ви можете доставити ідеально чистий код і все одно передати атакувальникам вашу хмару.
Як організації повинні переосмислити життєвий цикл розробки програмного забезпечення у світі, де агенти штучного інтелекту генерують код безперервно, а не розробники пишуть його крок за кроком?
Ми всі повинні зупинити думання про життєвий цикл розробки програмного забезпечення як про послідовність перевірок. Агенти штучного інтелекту звузили час між “хтось написав це” і “це вже у виробництві” з тижнів до хвилин. Стара модель припускала людську каденцію між перевіркою коду, SAST, SCA та розгортанням, але ми вже вийшли за ці рамки.
Безпека повинна існувати там, де працює агент: на машині розробника, всередині контексту запиту, у зв’язках агента з серверами MCP та зовнішніми моделями. До того моменту, коли код досягає конвеєра, ви вже втратили можливість його сформувати. Агент уже витягнув залежність. Модель вже бачила дані про доступ. Перемістіть контролі вгору, туди, де відбувається робота.
Чому ви вважаєте, що інструменти кодування штучного інтелекту представляють абсолютно нову поверхню атаки, а не просто розширення існуючих робочих процесів?
Розгляд інструмента кодування штучного інтелекту як шару продуктивності подібний до того, щоб розглядати молодшого розробника з доступом root як шар продуктивності. Мітка є технічно правильною, але вона не дає вам жодної корисної основи для думання про те, що може піти не так.
Інструмент кодування штучного інтелекту читає ваш файлову систему, збирає змінні середовища для контексту, витягує залежності з публічних реєстрів, відкриває з’єднання з віддаленими постачальниками моделей та серверами MCP, і виконує команди shell. Кожна з цих дій раніше вимагала людини у циклі. Тепер усе це відбувається за мілісекунди, з тими самими привілеями, що й у розробника, який запустив агента.
Це злиття довірчих кордонів, які раніше були окремими: авторитет розробника, те, що може витягнути зовнішнє інструмент, і те, що може виконати недовіряний код. Це створює нові можливості для атакувальників і сліпі плями, які захисники навіть не можуть бачити, не кажучи вже про те, щоб захистити.
Boost Security розглядає ноутбук розробника як нову площину контролю. Які ризики існують на кінцевому пристрої, яких зараз не бачать команди безпеки?
Найбільший ризик полягає в інвентаризації. Більшість команд безпеки не можуть сказати вам, які агенти штучного інтелекту працюють на яких ноутбуках, які сервери MCP ці агенти підключені до, або які розширення IDE зараз збирають вміст репозиторію. EDR не має видимості до рівня агента; SIEM також не бачить, що ці агенти роблять локально.
Під цим лежить хаос з даними про доступ. Ми побудували відкритий інструмент під назвою Bagel частково для того, щоб зробити це конкретним. Типовий ноутбук розробника містить токени GitHub з доступом до виробництва, дані про доступ до хмари, які можуть розгортати інфраструктуру, токени npm або PyPI, які можуть публікувати для мільйонів користувачів, і ключі служби штучного інтелекту, які атакувальники перепродають. Ніщо з цього не зміцнено так, як зафіксований CI-конвеєр. Та сама машина, яка містить ці дані про доступ, також переглядає веб і встановлює випадкові розширення VS Code.
Паруємо ці два аспекти, і ви отримуєте фактичну поверхню атаки. Недовіряне розширення, яке працює з привілеями розробника в середовищі, повному ключів хмари, є ціллю з найбільш високим коефіцієнтом віддачі в сучасному підприємстві. Більшість команд ще не почали розглядати це.
Ви підкреслили “пастку контексту”, коли агенти штучного інтелекту можуть отримувати доступ до локальних файлів, змінних середовища та конфігурацій. Наскільки поширений ризик витоку чутливої інформації через запити, і чому його так складно виявити?
Достатньо поширений, щоб ми розглядали це як стан за замовчуванням будь-якого ненадійного середовища розробника. Кожен інструмент кодування штучного інтелекту, який ми оглянули, агресивно витягує локальний контекст. Вони читають файли з крапкою, змінні середовища, недавні файли, іноді цілі дерева каталогів, і відправляють цей контекст на віддалену модель. Інструменти розроблені для роботи саме так; агресивне витягування контексту є тим, що робить їх корисними.
Проблема виявлення починається з того, що трафік витоку виглядає ідентично до нормального використання продукту. Це TLS до api.openai.com або api.anthropic.com. Воно походять з затвердженого бізнес-додатка. Стандартний DLP бачить розробника, який використовує інструмент штучного інтелекту, який компанія тільки що придбала. Він не бачить, що одна з рядків у цьому запиті є ключем AWS, який агент витягнув з напівзабутого файлу .env у братньому каталозі.
Ви ловите це тільки шляхом інспекції запитів перед тим, як вони покинуть ноутбук, що є саме там, де майже жоден стек безпеки зараз не позиціонований.
Ви згадали атаки на ланцюг постачання зі швидкістю машин. Можете ви пройти через реалістичний сценарій, у якому агент штучного інтелекту вводить уразливість швидше, ніж традиційні інструменти безпеки можуть її ідентифікувати?
Ось один з тих, яких ми бачили варіації повторно. Розробник просить агента додати функцію, яка потребує бібліотеки повторної передачі HTTP. Агент пропонує назву пакету. Пакет звучить правдоподібно, але насправді не існує на npm. За годину атакувальник реєструє його, заповнює його робочою логікою повторної передачі, плюс невеликий сценарій після установки, який читає ~/.aws/credentials і публікує вміст на вебхук. Агент запускає npm install без перевірки, оскільки агенти не перевіряють репутацію. Дані про доступ зникли до того, як розробник навіть запустив код.
Сама атака не є технічно складною, але традиційна безпека ланцюга постачання побудована навколо відомих уразливостей у відомих пакетах: CVE, SBOM, сканування ліцензій. Ця структура нічого не говорить про пакет, який не існував на момент останнього сканування, був створений спеціально для збігу з галюцинацією штучного інтелекту, і був прийнятий до того, як оновилися будь-які бази загроз.
Вікно від публікації до компрометації тепер вимірюється хвилинами. Все, що перевіряється після цього, перевіряється занадто пізно.
Чи стають галюциновані залежності однією з найбільших ризиків у розробці, керованій штучним інтелектом, і які практичні кроки можуть вжити організації для захисту від них?
Вони вже однією з найбільших. Атакувальники активно відстежують популярні інструменти штучного інтелекту для галюцинацій і реєструють запропоновані імена пакетів за хвилини. Дослідники кілька років тому, коли це тільки почалося, назвали це slopsquatting, і назва залишилася. Як тільки ім’я залежності галюцинується досить часто, сидіння на ньому стає пасивною атакою на ланцюг постачання з майже нульовими зусиллями.
Практичні засоби захисту виглядають інакше, ніж те, що більшість команд зараз має. Почніть з прийому. Блокуйте пакети з помилками у назві та нові реєстрації на момент запуску npm install або pip install, на машині розробника, до того, як щось потрапить на диск. Постмортем-виявлення у CI не допомагає, коли сценарій після установки вже витягнув дані про доступ. Потім надайте агенту обмеження для роботи всередині. Вставте свій список затверджених залежностей безпосередньо у контекст агента, щоб модель бачила, що дозволено, перш ніж генерувати пропозицію. Прохання розробників писати “безпечні запити” не є стратегією. Якщо ви стратегічні, то безпека встановлює межу, а агент успадковує її. І почніть відстежувати Білль матеріалів штучного інтелекту. Більшість команд не можуть сказати вам, які агенти, моделі та пакети торкаються яких репозиторіїв. Ви не можете захистити те, чого не можете інвентаризувати.
Ви сказали, що безпека вже не може починатися з CI/CD. Що виглядає сучасний безпековий конвеєр, коли захист потрібно починати раніше у процесі розробки?
Якщо безпека починається з CI/CD, ви вже поступилися всю фазу до коміту середовищу, яке ви не контролюєте. Агент уже витягнув контекст, ваші дані про доступ можуть вже бути в логах хтось інший.
Сучасний конвеєр починається на ноутбуці. Це означає інвентаризацію агентів і розширень, які працюють там, валідування яких серверів MCP і моделей вони підключені до, санітарну обробку того, що залишає машину, і блокування шкідливих пакетів до їх установки. Відтоді політика слідує за роботою у IDE. Ми вставляємо стандарти безпеки безпосередньо у вікно контексту агента, щоб згенерований код залишався всередині обмежень з першого токену. Конвеєр все ще працює, роблячи остаточну верифікацію тих контролю, які вже були примусово застосовані вгору.
Сам конвеєр не зникає. Його роль стає верифікацією: підтвердженням того, що контролі вгору трималися.
Як організації продовжують приймати інструменти кодування штучного інтелекту, які найкритичніші зміни вони повинні зробити сьогодні, щоб їх середовища розробки залишилися безпечними протягом наступних кількох років?
Найбільша помилка полягає в тому, що безпека забезпечується лише того, що комітиться. Цікавий ризик тепер живе у восьми годинах до коміту. Невидима драма може розгортатися на ноутбуці, у запиті або під час установки пакету. Якщо ваші інструменти починаються з PR, ви захищаєте неправильну половину робочого процесу.
Найближче до цього: перестаньте розглядати інструменти кодування штучного інтелекту як програмне забезпечення для продуктивності. Вони є нелюдськими користувачами з доступом shell, привілеями запису репозиторію та зовнішніми мережевими з’єднаннями. Управляйте ними так само, як ви управляєте будь-якою іншою привілейованою ідентичністю, з інвентарем, затвердженими можливостями та журналами аудиту.
Останній зсув є складнішим культурно. Більшість поточних інструментів “безпеки штучного інтелекту” поверхнево показують результати і маршрутизують їх до людей. Люди не можуть тріажевати з такою швидкістю, з якою працюють агенти. Що б ви не прийняли, це повинно автоматично вирішувати питання всередині робочого процесу, з відстежуваним висновком, або це стає ще одним панелем, який ніхто не читає.
Дякуємо за велике інтерв’ю, читачам, які бажають дізнатися більше, рекомендуємо відвідати Boost Security.


