
Інтерв’ю
Доктор Матільд Певіс, керівник юридичного відділу OpenOrigins – Інтерв’ю

 Додайте Unite.AI до бажаних джерел у Google
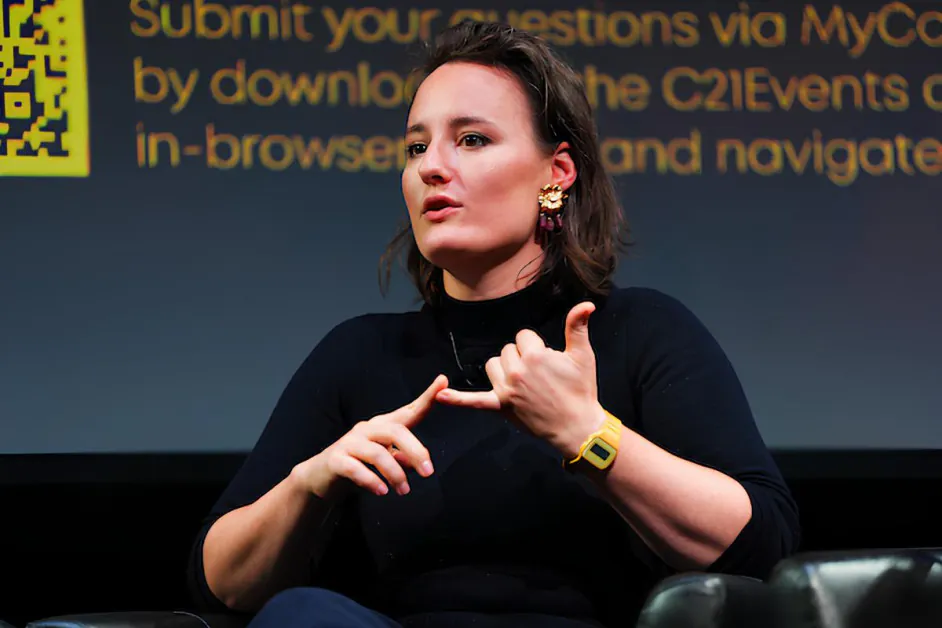
Доктор Матільд Певіс, керівник юридичного відділу OpenOrigins, є провідним експертом у сфері регулювання штучного інтелекту та цифрових медіа, спеціалізується на глибоких підробках, синтетичних медіа та походженні контенту. Вона консультує компанії, уряди та профспілки щодо дотримання законодавства, ліцензування та ризиків у сфері генеративного штучного інтелекту, а також працювала з Microsoft (MSFT ) та ElevenLabs над політикою та стратегією штучного інтелекту. Вона також консультувала ЮНЕСКО щодо штучного інтелекту та інтелектуальної власності, а також регулярно надає експертні свідчення британським законодавцям.
OpenOrigins розробляє технології для боротьби з дезінформацією та глибокими підробками шляхом створення верифікованих, незмінних записів цифрового контенту. Її платформа зосереджена на встановленні чіткого походження, що дозволяє ЗМІ, творцям та платформам довести, коли та як контент був створений, відредагований та поширений – це все більш критична можливість, оскільки синтетичні медіа стають більш просунутими та важче виявляються.
Ви консультували уряди, глобальні інституції, такі як ЮНЕСКО, та компанії, такі як Microsoft та ElevenLabs, щодо регулювання штучного інтелекту. Що спонукало вас зосередитися конкретно на глибоких підробках, цифрових копіях та синтетичних медіа, і як ця подорож сформувала ваше рішення заснувати Replique?
Моя робота над глибокими підробками не почалася з технології – вона почалася з набагато старішої юридичної загадки. Коли я почала досліджувати інтелектуальну власність для своєї дисертації в 2013 році, я була вражена тим, як мало захисту отримують виконавці порівняно з авторами, композиторами чи кінематографістами. На практиці це означає, що ваші слова або ваша музика краще захищені законом, ніж ваш голос, обличчя та тіло. Ця диспропорція здавалася дивною, і це спонукало мене поставити глибше питання: як ми культурно та юридично оцінюємо роботу людини, чиїм внеском є її обличчя, голос та тіло на екрані?
Це питання привело мене до прав виконавців та даних. На той час це вважалося вузькою областю з малою комерційною значимістю. Мене активно радили перейти до більш “прибуткових” галузей, таких як патенти чи традиційні авторські права. Припущення полягало в тому, що питання щодо подоби чи голосу людини в основному регулюються неформально – через галузеві норми або “джентльменські угоди в Голлівуді”. Але для мене відсутність формального захисту означала прогалину, а не тупик для моїх досліджень, тому я продовжила роботу.
Що змінилося, так це те, що сьогодні майже кожна людина є виконавцем. Наше життя опосередковується через камери – на телефонах, ноутбуках, відеозв’язках та соціальних платформах. Чи для роботи, чи для особистого використання, люди постійно записують та ділиться версіями себе. Юридичні питання, які раніше застосовувалися в основному до акторів чи музикантів, тепер застосовуються до будь-якої людини з смартфоном.
Глибокі підробки не створили ці питання – вони викрили та прискорили їх. Дослідження, яке я проводила з 2013 року, раптом стало терміновим. Близько 2017 та 2018 років розробки в галузі нейронних мереж – особливо з місць, таких як MIT та UC Berkeley – почали демонструвати, наскільки переконливо можна маніпулювати обличчям, голосом та тілом людини в цифровому вигляді. Усього за рік ця здатність стала широко відомою як “глибокі підробки”, і спочатку вона набула популярності в глибоко шкідливих способах, особливо через неконсensualний сексуальний контент, спрямований проти жінок та дітей.
Тільки пізніше з’явилися комерційні наслідки, оскільки творчі галузі почали采用 синтетичних медіа. Тоді юридичні та економічні питання, над якими я працювала, вийшли на перший план. Майже за одну ніч те, що вважалося в основному теоретичною або доктринальною областю права, стало високопрактичною, комерційно значимою та соціально терміновою галуззю.
У своєму основі юридичний виклик не змінився: люди хочуть ділитися аспектами себе, але все ще зберігають значний контроль. Існуючі рамки боротьби з цим нюансом. Вони схильні розглядати людей як повністю приватних або повністю публічних – або захищених, або легкої здобичі. Але більшість людей існує десь між цими двома крайностями. Ця напруженість тепер центральна не лише для професійних виконавців, а й для будь-якої людини, яка бере участь у цифровому житті.
Я стала відомою як той, хто досліджував і працював у цій сфері, що привело мене до роботи з урядами, які цікавляться захистом людей від глибоких підробок, та компаніями, які хочуть зробити цифрові клони безпечними для використання, наприклад, ElevenLabs. У Replique я привнесла все, що я дізналася, до людей та компаній, які хочуть використовувати технологію цифрового клонування або цифрових реплік відповідально та безпечно. Я фактично перетворила свої “блакитні небеса” дослідження на консультативний бізнес, який надає спеціалізовані юридичні поради творчим галузям.
Як керівник юридичного відділу OpenOrigins, компанії, яка зосереджена на встановленні незмінного запису походження контенту для боротьби з глибокими підробками, як ви бачите конкуренцію систем, заснованих на походженні, з традиційними підходами до виявлення глибоких підробок?
Порівняння інструментів виявлення глибоких підробок може швидко стати порівнянням яблук та апельсинів, оскільки їх ефективність залежить від контексту та мети. З точки зору політики нам потрібен ряд комплементарних інструментів – немає єдиної “кращої” рішення, і Open Origins є лише однією частиною цієї ширшої екосистеми. Там, де технологія OpenOrigins виділяється як рішення для виявлення глибоких підробок, це ситуації, коли творець контенту або інформаційна організація需要 довести автентичність контенту, який вони діляться з партнерами, аудиторією чи громадськістю.
Від надаючи верифіковане походження та “квитки” на момент створення, вона пропонує сильну форму профілактики, демонструючи, що контент не є глибокою підробкою. Однак цей підхід менш корисний для звичайних користувачів інтернету, які хочуть швидко оцінити контент, який вони зустрічають в Інтернеті. У таких випадках виявлення залежить більше від ймовірнісних та аналізу контенту методів, а не від верифікації походження. Нам потрібні різні інструменти для різних потреб, і нам потрібно визнати, що немає срібної кулі проти глибоких підробок.
З юридичної точки зору, яка зараз найбільша прогалина в тому, як юрисдикції обробляють згоду та володіння штучно створеним або штучно реплікованим контентом?
Ох, скільки у вас часу? Відповіді залежать від того, що ми розуміємо під штучно створеним або штучно реплікованим контентом. Проблеми варіюються, залежно від того, чи дивимося ми на штучно створене зображення будинку чи кота. Чи цифрову реконструкцію обличчя чи голосу людини. Давайте обмежимося темою глибоких підробок та цифрових реплік, і відповімо на ваше питання в контексті “цифрового клонування”.
Відносно згоди, основна проблема полягає в тому, що більшість контрактів – чи то трудові угоди, чи умови платформи – містять широкі, нечіткі пункти, які надають широкі права щодо контенту користувача. Ці пункти можуть бути інтерпретовані як forma “задніх дверей” згоди, де погодження з умовами може бути розцінено як згода на використання, подібне до клонування, хоча більшість людей рішуче заперечують таку інтерпретацію. Це створює значну прогалину між юридичною інтерпретацією та очікуваннями користувача, одна з яких зараз на користь компаній, тоді як регулювання відстає.
Відносно володіння, немає чіткої юридичної відповіді на питання, хто володіє цифровим клоном, оскільки існуючі рамки, такі як захист даних, авторське право та права особистості, не були розроблені для цієї технології. Сьогодні більшість людей скануються та клонуються на роботі, за запитом та за фінансуванням роботодавця чи клієнта. І ці особи зазвичай очікують високого рівня контролю над цим активом, що є зрозумілим, але часто проблематичним, оскільки цей актив є цифровою імітацією вашого обличчя чи голосу, і може змусити вас говорити речі, яких ви ніколи не говорили, або робити речі, яких ви ніколи не робили.
Питання про те, “хто володіє вашим клоном?” є дуже важливим, але залишається без відповіді в законодавстві сьогодні.
Ви працювали близько з технологіями клонування голосу. Які найбільш недооцінені юридичні ризики щодо синтетичних голосів, як для компаній, так і для окремих осіб?
Найбільш недооцінена проблема юридичної відповідності полягає в балансі між комерційними інтересами компанії у фінансуванні та експлуатації цифрового клону та правом особи на приватність та цифрову гідність. Ця напруженість існує через кілька юридичних режимів (в основному інтелектуальної власності, захисту даних та приватності), які ніколи не були розроблені для спільної роботи та інтерпретації клонування фундаментально різними способами. Як результат, переклад цього у робочі, дружні до бізнесу практики є складним і часто нечітким. Компанії, таким чином, або ігнорують ключові ризики, або несуть значні витрати для їх належного подолання. Це створює перверсивний результат, при якому відповідна відповідність стає більш складним та дорогим шляхом, а не стандартним.
Як підприємства повинні думати про архітектуру згоди в системах штучного інтелекту, особливо при роботі з подібністю, ідентичністю та навчальними даними?
Компанії повинні проектувати свої системи навколо трьох основних можливостей. По-перше, їм потрібно забезпечити інформовану, контекстну згоду на етапі налаштування. По-друге, їм потрібно зробити легко для користувачів відкликання цієї згоди та видалення деяких або всіх своїх даних, що технічно складно та часто забуто, але необхідне для дотримання законів, таких як GDPR Великої Британії та ЄС та подібних режимів у США. Підтримання згоди з часом означає побудову систем, де відкликання є операційно гладким та узгодженим з бізнес-моделлю.
Згода повинна бути гранульованою. І третє, користувачам потрібно дати можливість керувати дозволами на рівні окремих файлів, оновлювати свої дані про подібність та розуміти, як вони використовуються. Це вимагає прозорості та контролю – інструментів, які дозволяють користувачам моніторити, переглядати та модерувати, як їхні цифрові клони розгортаються. Цей рівень гнучкості все ще рідкісний, але це місце, де все частіше лежить конкурентна перевага.
За вашим досвідом консультування як стартапів, так і урядів, де найбільша роз’єднаність між тим, як будується штучний інтелект, та тим, як він регулюється?
Роз’єднаність між тим, як будується штучний інтелект, та тим, як він регулюється, зводиться до фундаментально різних місій. Уряди регулюють у громадських інтересах, тоді як компанії штучного інтелекту (часто підтримувані风险овим капіталом) в основному рухаються зростанням, доходом та прибутком. ці пріоритети не завжди конфліктують, але вони часто тягнуть у різні боки, з регулюванням, яке розглядається як обмеження, а не підтримка.
Це створює структуровану напруженість: регулятори та інноватори діють з різними стимулами, цінностями та навіть мовами. Це робить практичну узгодження складним, навіть якщо це не неможливо. Ми починаємо бачити нову хвилю технологічних компаній, які все більше узгоджуються з громадськими інтересами, але вони залишаються винятком, а не правилом – особливо серед тих, хто успішно масштабується.
OpenOrigins зосереджується на верифікації контенту на момент його створення за допомогою криптографічного походження. Наскільки критично це походження-першої підходу порівняно з заходами безпеки після розповсюдження?
Це повертається до моєї попередньої відповіді. Аутентифікація контенту на етапі його створення, тобто “вгору по течії”, значно більш ефективна, ніж спроба верифікувати його на етапі розповсюдження або навіть споживання, тобто “вниз по течії”. Аутентифікація контенту на етапі його створення схожа на відстежування походження продуктів харчування з моменту його вирощування на фермі, а не спробу визначити це з того, що на вашій тарілці. Якщо ви знаєте, де було вирощено курча, як з ним поводилися та як воно рухалося через ланцюжок постачання, ви можете довіряти тому, що ви їсте. Якщо ви натомість намагаєтеся здогадатися все це, просто дивлячись на готову страву, ви покладаєтеся на здогадки. Те саме стосується розрізнення між людьми, створеними контентом, та штучно створеним контентом в Інтернеті: походження на джерелі дає вам верифіковану гарантія, тоді як виявлення після розповсюдження є внутрішньо більш невизначеним та реактивним.
Яка роль, на вашу думку, відіграють стандарти, такі як C2PA, у майбутньому медіа, і чи достатньо вони самі по собі для відновлення довіри в Інтернеті?
C2PA – це бажана ініціатива, і по багатьом аспектам вона підтримує той самий рух за автентичність контенту, що й OpenOrigins. Вони є важливою частиною екосистеми безпеки контенту та автентичності контенту. Як і з кожним інструментом кібербезпеки, немає срібної кулі.
Для творців та талантів у галузях, таких як кіно, музика та ігри, які практичні кроки вони повинні зробити сьогодні, щоб захистити себе від незаконної цифрової реплікації?
Художники сьогодні стикаються з двома окремими ризиками: реплікацією своєї роботи (такої як музика, зображення чи письмо) та реплікацією своєї подоби, включаючи обличчя, голос та тіло. З мінімальними вхідними даними штучні інтелектні системи тепер можуть відтворити обидва з високим рівнем вірогідності. На практиці захист починається з того, що ви свідомо обираєте, що ви ділитесь в Інтернеті, визнаючи, що будь-який контент, опублікований в Інтернеті, може бути скопійований та використаний у навчальних наборах даних, часто без явної згоди чи видимості.
Цей ризик зараз є базовою реальністю роботи в Інтернеті. Але більш негайний та контрольований ризик часто лежить у контрактах. Угоди, які художники укладають зі своїми колегами, дистриб’юторами чи платформами, можуть містити пункти, які дозволяють використання штучного інтелекту, повторне використання або перепродаж контенту для навчальних цілей – часто без значимої участі у подальших доходах.
Для художників це робить аналіз контрактів критично важливим. Знання того, як ваша робота та подоба можуть бути використані, ліцензовані чи перепродані, зараз є так само важливим, як і сам творчий процес. Більша частина поточної дискусії (у профспілках, галузевих органах та платформах) зосереджена на виправленні цього дисбалансу та забезпеченні того, щоб творці зберегли як контроль, так і справедливу компенсацію.
Отже, два ключових поради: будьте обережні з тим, що ви ділитесь в Інтернеті, і читайте свої контракти та шукайте пункти про штучний інтелект, перш ніж підписувати.
Оглядаючись вперед на три-п’ять років, ви вважаєте, що ми досягнемо точки, коли кожна частина цифрового контенту повинна мати верифіковане походження, чи довіра залишається фрагментованою по платформах та юрисдикціям?
Я хотіла б сказати так, але реалістично, ні – не протягом п’яти років. У сфері технологій п’ять років здаються довгими; у сфері зміни поведінки та звичок людей п’ять років – це дуже короткий термін. Більшість споживачів навряд чи будуть приймати рішення на основі того, чи несе контент верифіковане походження. Платформи зазвичай слідують за попитом користувачів, оптимізуючи для участі, а не походження.
Це могло б змінитися, якщо регулювання втрутилося. Ми вже бачимо перші кроки в місцях, таких як Каліфорнія, де з’являються вимоги до маркування та модерації, але глобальне масштабування цього займе час – ймовірно, ближче до десяти років, ніж до п’яти.
Інша область змін – галузева специфіка: галузі, такі як журналістика, фінанси, страхування та охорона здоров’я, можуть почати вимагати походження та автентифікацію, оскільки довіра є фундаментальною для їхньої діяльності.
Останнє, але не менш важливе, споживачі можуть не турбуватися про інформацію про походження в короткій перспективі, але вони, ймовірно, будуть цінувати якість контенту та якість інформації. Якщо штучно створений контент стане надто однорідним або “блідим”, аудиторія може почати цінувати людство створений контент більш явно. Це могло б привести до сегментації ринку, з деякими платформами, які віддають пріоритет масштабу та штучно створеному контенту, а інші – для автентичності, походження та високої довіри, людсько-керованих матеріалів – але цей зсув залишається невідомим.
Дякую за ваші великі відповіді, читачам, які бажають дізнатися більше, рекомендуємо відвідати OpenOrigins.


