
Погляд Anderson
UniTune: альтернативна техніка нейронного редагування зображень від Google

 Додайте Unite.AI до бажаних джерел у Google
Ключові моментиUniTune доналаштовує дифузійну модель на одному зображенні для забезпечення точних…
Показати більше
- UniTune доналаштовує дифузійну модель на одному зображенні для забезпечення точних текстових редагувань.
- На відміну від DreamBooth або Textual Inversion, UniTune відкидає обидва підходи для кращого збереження деталей.
- Метод досягає високої семантичної розділеності, зберігаючи обличчя недоторканими під час радикальних трансформацій фону.
Дослідники з Google Research, схоже, атакують текстове редагування зображень з кількох сторін, і, ймовірно, чекають, щоб побачити, що “пристосується”. Незабаром після виходу цього тижня їхньої статті про Imagic, компанія-гігант запропонувала додатковий метод на основі латентної дифузії для інакше неможливого редагування зображень за допомогою ШІ та текстових команд, цього разу під назвою UniTune.
На основі прикладів, наведених у новій статті про проєкт, UniTune досягла надзвичайного рівня розрізнення семантичної пози та ідеї від фактичного вмісту зображення:

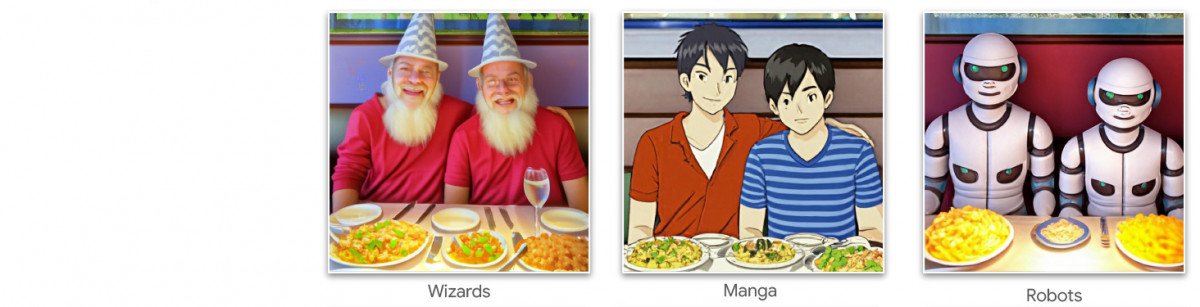

UniTune демонструє видатне володіння семантичною композицією. Помітно, як у верхньому ряду зображень обличчя двох людей не були спотворені під час надзвичайної трансформації решти джерельного зображення (праворуч). Джерело: https://arxiv.org/pdf/2210.09477.pdf
Для шанувальників Stable Diffusion це відомо, що застосування редагувань до окремих секцій зображення без негативного впливу на решту зображення може бути складною, іноді неможливою операцією. Хоча популярні розподіли, такі як AUTOMATIC1111, можуть створювати маски для локальних та обмежених редагувань, процес часто болісний і непередбачуваний.
Очевидна відповідь, принаймні для фахівця з комп’ютерного бачення, полягає в тому, щоб розмістити шар семантичної сегментації, який здатний розпізнавати та ізолювати об’єкти на зображенні без втручання користувача, і, дійсно, останнім часом з’явилися кілька нових ініціатив у цьому напрямку.
Інша можливість для блокування заплутаних та заплутаних операцій редагування зображень на основі нейронних мереж полягає у використанні модуля Contrastive Language–Image Pre-training (CLIP) від OpenAI, який є серцем моделей латентного розсіювання, таких як DALL-E 2 та Stable Diffusion, для дії як фільтра на етапі, коли модель текст-ізображення готова надіслати інтерпретований рендер користувачеві. У цьому контексті CLIP повинен діяти як сторож і модуль контролю якості, що відхиляє неправильно сформовані або інакше непридатні рендери. Це має бути впроваджено (посилання на Discord) на API-порталі DreamStudio від Stability.ai. Однак CLIP у цьому сценарії, ймовірно, є і причиною, і рішенням, адже також вплинув на формування зображення. Апаратні вимоги можуть перевищувати ресурси, доступні локально кінцевому користувачеві, тож цей підхід може бути неідеальним.
Стиснута мова
Запропонована UniTune замість цього “тонко налаштовує” існуючу модель розсіювання – у цьому випадку, власну модель Imagen від Google, хоча дослідники заявляють, що метод сумісний з іншими архітектурами латентного розсіювання – так, що унікальний токен вводиться в неї, який можна викликати, включивши його в текстовий промпт.
На перший погляд, це здається подібним до DreamBooth від Google, який зараз є об’єктом уваги серед шанувальників та розробників Stable Diffusion, який може вводити нові персонажі або об’єкти в існуючу точку, часто менш ніж за годину, на основі декількох джерельних зображень; або подібним до Textual Inversion, який створює “бокові” файли для точки, які потім обробляються як якщо б вони були спочатку навчені в моделі, і можуть скористатися власними величезними ресурсами моделі, змінивши її текстовий класифікатор, в результаті чого отримується малий файл (у порівнянні з мінімумом 2 ГБ обрізаних точок DreamBooth).
Фактично дослідники стверджують, що UniTune відхилила ці підходи. Вони виявили, що Textual Inversion пропускала занадто багато важливих деталей, тоді як DreamBooth “виконувала гірше і займала більше часу”, ніж рішення, яке вони нарешті прийняли.
Проте UniTune використовує той самий підхід інкапсульованого семантичного «метапромпту», що й DreamBooth: навчені зміни викликаються унікальними словами, обраними тренером, які не конфліктують із термінами, що вже є у старанно навченій публічній моделі. QUOTEOPEN«Щоб виконати редагування, ми семплуємо тонко налаштовані моделі з промптом “[rare_tokens] edit_prompt” (наприклад, “beikkpic два собаки в ресторані” або “beikkpic міньйон”).»QUOTECLOSE
Процес
Хоча дві майже ідентичні статті, за своїми кінцевими функціями, можуть вийти від Google у той самий тиждень, існує, попри велику кількість подібностей між двома ініціативами, принаймні одна чітка відмінність між UniTune та Imagic – остання використовує “нестиснуті” природні мовні промпти для керування операціями редагування зображень, тоді як UniTune тренується унікальними токенами у стилі DreamBooth.
Отже, якщо ви редагували з Imagic і хотіли здійснити таку трансформацію…

З статті про UniTune – UniTune протиставляє себе улюбленому суперницькому нейронному редакторському кадру Google, SDEdit. Результати UniTune знаходяться праворуч, тоді як оцінена маска видно на другому зображенні зліва.
.. у Imagic ви ввели б ‘третю особу, що сидить на задньому плані, як милу пухнасту істоту’.
Еквівалентна команда UniTune була б ‘Чоловік позаду як [x]’, де x – це той дивне й унікальне слово, який був зв’язаний з тонко налаштованою концепцією, пов’язаною з персонажем пухнастої істоти.
DreamBooth і Textual Inversion отримують кілька зображень для створення абстракції у стилі deepfake, яку можна показувати в багатьох позах. Натомість UniTune та Imagic отримують одне зображення — незмінений оригінал. Це схоже на роботу GAN-редакторів останніх років: вхідне зображення перетворюють на коди в латентному просторі GAN, а потім спрямовують їх до інших ділянок простору для змін, наприклад проєктують молоду темноволосу людину через коди «старий» чи «білявий». Але в дифузійній моделі результати цього методу порівняно надзвичайно точні й набагато менш неоднозначні. 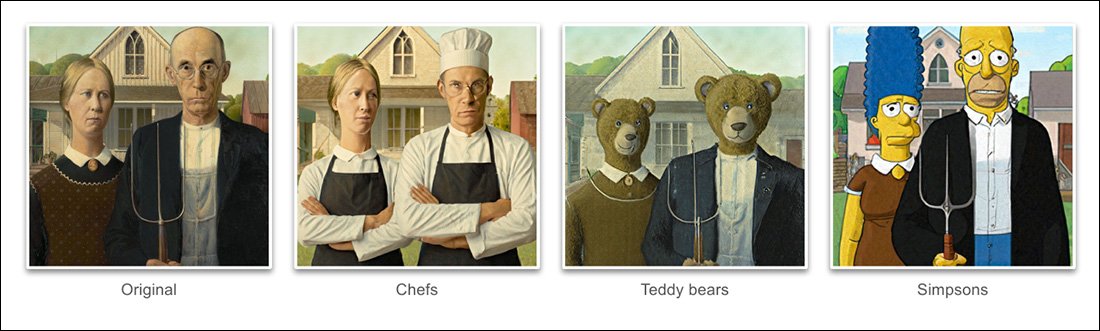
Процес тонкого налаштування
Метод UniTune фактично надсилає джерельне зображення через модель розсіювання з набором інструкцій щодо того, як його слід змінити, використовуючи величезні репозиторії доступних даних, навчених у моделі. По суті, ви можете зробити це прямо зараз за допомогою функції img2img Stable Diffusion – але не без викривлення або зміни тих частин зображення, які ви хотіли б зберегти.
Під час процесу UniTune система тонко налаштовується, тобто UniTune змушує модель відновити навчання, з більшістю її шарів, які не заморожені (див. нижче). У більшості випадків тонка налаштовка знижує загальні узагальнені значення втрат високопродуктивної моделі на користь введення або вдосконалення якогось іншого аспекту, який бажано створити або поліпшити.
У UniTune копія моделі, хоча й може займати кілька гігабайтів або більше, схоже, слугує одноразовою допоміжною «оболонкою» і відкидається після виконання одного завдання. Такі обсяги тимчасових даних стають щоденною кризою зберігання для користувачів DreamBooth, чиї моделі навіть після обрізання займають не менше 2 ГБ на об’єкт. Як і в Imagic, основне налаштування відбувається на двох нижчих із трьох рівнів Imagen (база 64px, 64px>256px і 256px>1024px). На відміну від Imagic, дослідники бачать можливу користь у налаштуванні останнього й найбільшого рівня надроздільності, хоча ще цього не пробували. На найнижчому рівні 64px модель під час навчання орієнтують на базове зображення, подаючи повторювані пари зображення/тексту протягом 128 ітерацій із розміром пакета 4 та Adafactor як функцією втрат зі швидкістю навчання 0,0001. Лише кодувальник T5 заморожений під час цього налаштування, як і під час первинного навчання Imagen. Потім операцію повторюють для рівня 64>256px з тією самою процедурою аугментації шуму, що й у початковому навчанні Imagen.
Семплювання
Є багато можливих методів зразкування, за допомогою яких можна отримати зміни, внесені до тонко налаштованої моделі, включаючи Classifier Free Guidance (CFG), основу Stable Diffusion. CFG визначає ступінь, у якій модель вільна “слідувати своїй уяві” та досліджувати можливості рендерингу – або ж, при нижчих налаштуваннях, ступінь, у якій вона повинна дотримуватися вхідних даних джерела та робити менше широких або драматичних змін.

Як і Textual Inversion (трохи менше з DreamBooth), UniTune підходить для застосування різних графічних стилів до оригінальних зображень, а також для більш фотореалістичних редагувань.
Дослідники також експериментували з технікою “пізнього початку” SDEdit, де система заохочується зберегти оригінальні деталі, будучи лише частково “шумом” з самого початку, водночас зберігаючи свої основні характеристики. Хоча дослідники використовували це лише на нижньому рівні (64px), вони вважають, що це може бути корисним додатковим методом зразкування в майбутньому.
Дослідники також використали prompt-to-prompt як додаткову текстову техніку для задання умов моделі: QUOTEOPEN«У режимі “prompt to prompt” техніка, яку ми називаємо Prompt Guidance, особливо корисна для регулювання точності відтворення та виразності.»QUOTECLOSEQUOTEOPEN«Prompt Guidance схожа на Classifier Free Guidance, але за основу береться інший промпт замість моделі без умов. Це спрямовує модель до різниці між двома промптами.»QUOTECLOSE

Prompt-to-prompt в UniTune ефективно відокремлює ділянки для змін.
Автори зазначають, що керування промптом було потрібне лише інколи, коли CFG не давала бажаного результату. Іншим новим підходом, виявленим під час розробки UniTune, була інтерполяція: ділянки зображення достатньо відокремлені, а композиція оригіналу й зміненої версії достатньо подібна, щоб застосувати більш «наївну» інтерполяцію.

Інтерполяція може зробити складніші процеси UniTune зайвими, коли ділянки для перетворення відокремлені й чітко обмежені.
Автори припускають, що для багатьох вихідних зображень інтерполяція може працювати настільки добре, що її можна зробити типовим налаштуванням. Вона також здатна створювати значні зміни, якщо складні перекриття не потрібно опрацьовувати інтенсивнішими методами. UniTune може редагувати локально з масками чи без них і самостійно вирішувати, де розташувати зміни, поєднуючи силу інтерпретації з надійним збереженням суттєвих рис вихідних даних:

На верхньому зображенні другого стовпця UniTune розташувала замовлений «червоний потяг на тлі» у відповідному й правдоподібному місці. Інші приклади показують збереження семантичної цілісності джерела навіть за значних змін піксельного вмісту та основного стилю.
Затримка
Хоча перший варіант будь-якої нової системи буде повільним, і хоча можливо, що або спільна участь, або відданість компанії (зазвичай не обидва) в кінцевому підсумку прискорять і оптимізують ресурсоємкий процес, обидві UniTune та Imagic виконують деякі досить серйозні дії машинного навчання, щоб створити ці неймовірні редагування, і питання про те, якою мірою такий ресурсоємкий процес може бути зменшений до домашнього використання, а не доступу через API (хоча останнє може бути більш бажаним для Google).
Наразі повний цикл від вхідних даних до результату займає близько 3 хвилин на GPU T4, з додатковими 30 секундами на інференцію (як і будь-який інший інференційний рутин). Автори погоджуються, що це висока затримка, і майже не відповідає поняттю “інтерактивності”, але вони також зазначають, що модель залишається доступною для подальших редагувань після першої настройки, доки користувач не закінчить процес, що скорочує час на редагування.
Перша публікація 21 жовтня 2022 року.


