
Погляд Anderson
До реального часу: AI‑люди за допомогою нейронного луміграфічного рендерингу

 Додайте Unite.AI до бажаних джерел у Google
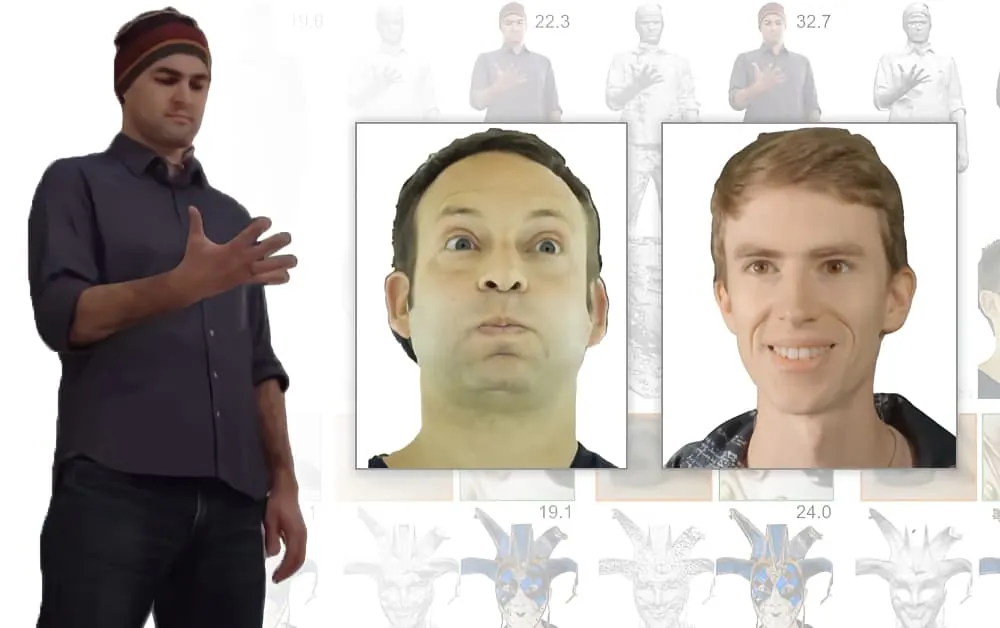
Незважаючи на поточну хвилю інтересу до нейронних полів випромінювання (NeRF), технології, здатної створювати AI‑згенеровані 3D‑середовища та об’єкти, цей новий підхід до технології синтезу зображень все ще вимагає значного часу навчання і не має реалізації, що забезпечує інтерфейси в режимі реального часу з високою чутливістю.
Однак співпраця між деякими вражаючими іменами в індустрії та академічному середовищі пропонує новий підхід до цього виклику (загально відомого як синтез нових поглядів, або NVS).
Дослідницька стаття, під назвою Neural Lumigraph Rendering, стверджує покращення сучасного стану технології приблизно на два порядки величини, що представляє кілька кроків до рендерингу комп’ютерної графіки в режимі реального часу за допомогою конвеєрів машинного навчання.

Neural Lumigraph Rendering (праворуч) забезпечує кращу роздільну здатність артефактів злиття та покращене управління оклюзією порівняно з попередніми методами. Source: https://www.youtube.com/watch?v=maVF-7×9644 Source.
Хоча в подяках за статтю згадуються лише Стенфордський університет та компанія з технологією голографічних дисплеїв Raxium (на даний момент працює у режимі під прикриттям), до учасників належать головний архітектор машинного навчання в Google, комп’ютерний вчений в Adobe (ADBE ), та технічний директор у StoryFile (яка нещодавно потрапила в заголовки зі створенням AI‑версії Вільяма Шатнера).
Щодо недавньої PR‑кампанії Шатнера, StoryFile, здається, використовує NLR у своєму новому процесі створення інтерактивних AI‑згенерованих сутностей, заснованих на характеристиках та історіях окремих людей.
StoryFile передбачає використання цієї технології у музейних експозиціях, онлайн‑інтерактивних нараціях, голографічних дисплеях, доповненій реальності (AR) та документуванні спадщини — а також, схоже, розглядає потенційні нові застосування NLR у рекрутингових інтерв’ю та віртуальних додатках для знайомств:

Пропоновані варіанти використання з онлайн‑відео StoryFile.
Волюметричне захоплення для інтерфейсів синтезу нових поглядів і відео
Принцип волюметричного захоплення, згідно з численними публікаціями на цю тему, полягає у зйомці статичних зображень або відео об’єкта та використанні машинного навчання для заповнення точок зору, які не були охоплені початковим набором камер.
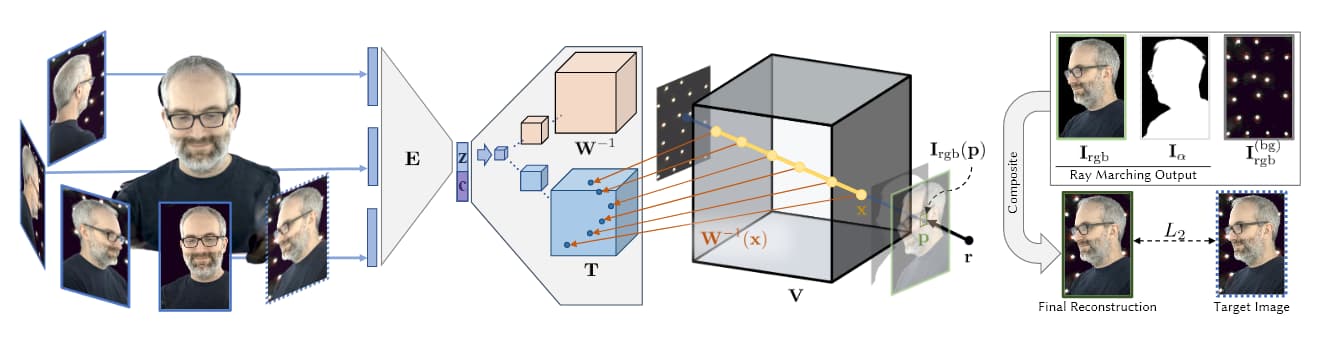
Джерело: https://research.fb.com/wp-content/uploads/2019/06/Neural-Volumes-Learning-Dynamic-Renderable-Volumes-from-Images.pdf
На зображенні вище, взятому з дослідження AI Facebook 2019 (див. нижче), ми бачимо чотири етапи волюметричного захоплення: кілька камер отримують зображення/відео; архітектура кодувальник‑декодувальник (або інші архітектури) обчислює та об’єднує взаємозв’язок поглядів; алгоритми ray‑marching обчислюють вокселі (або інші просторові одиниці XYZ) кожної точки у волюметричному просторі; і (у більшості останніх статей) проводиться навчання для синтезу повної сутності, яку можна маніпулювати в режимі реального часу.
Саме ця часто обширна та даними важка фаза навчання до сьогодні залишала синтез нових поглядів поза межами реального часу чи високочутливого захоплення.
Той факт, що синтез нових поглядів створює повну 3D‑карту волюметричного простору, означає, що доволі просто зшити ці точки у традиційну комп’ютерно‑згенеровану сітку, ефективно захоплюючи та артикуляючи CGI‑людину (або будь‑який інший відносно обмежений об’єкт) в режимі реального часу.
Підходи, що використовують NeRF, покладаються на хмари точок та карти глибини для створення інтерполяцій між розрідженими точками зору захисних пристроїв:
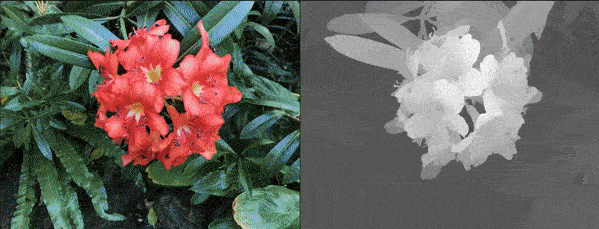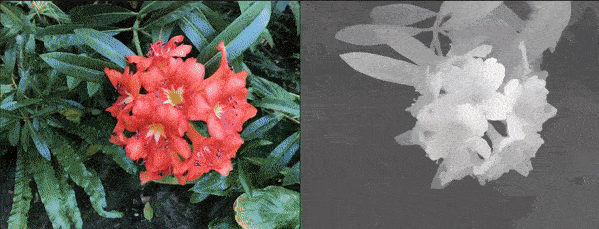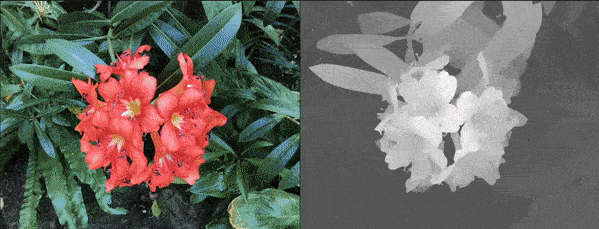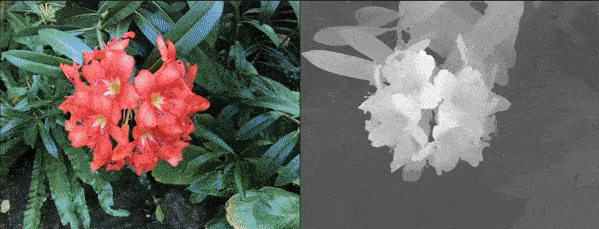
NeRF може генерувати волюметричну глибину шляхом обчислення карт глибини, а не створенням CG‑сіток. Джерело: https://www.youtube.com/watch?v=JuH79E8rdKc
Хоча NeRF може обчислювати сітки, більшість реалізацій не використовують це для створення волюметричних сцен.
Навпаки, підхід Implicit Differentiable Renderer (IDR), опублікований Вейцманським інститутом наук у жовтні 2020 року, базується на використанні 3D‑інформації сітки, автоматично згенерованої з масивів захоплення:
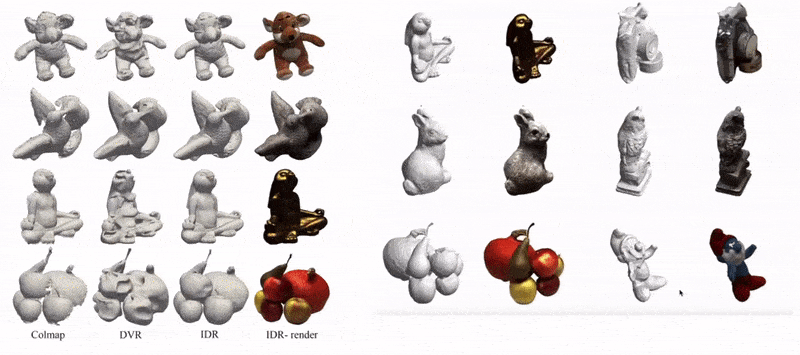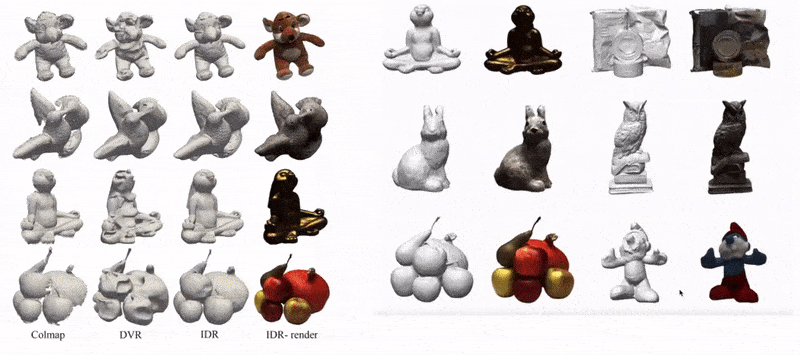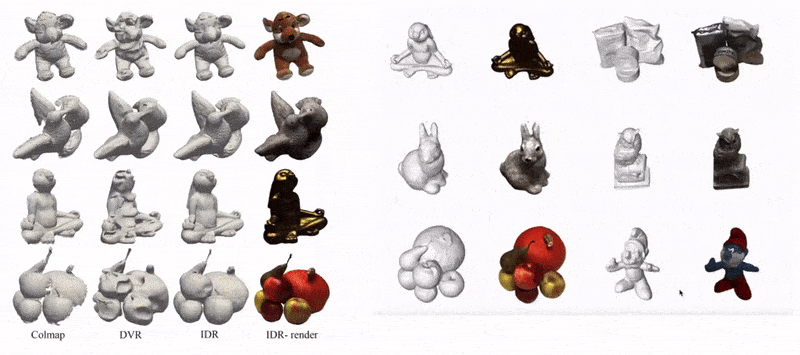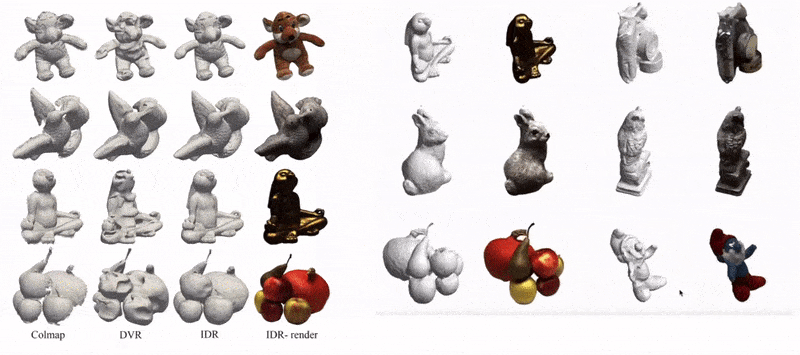
Приклади захоплень IDR, перетворених у інтерактивні CGI‑сітки. Джерело: https://www.youtube.com/watch?v=C55y7RhJ1fE
Хоча NeRF не має можливості IDR щодо оцінки форми, IDR не може зрівнятися з якістю зображень NeRF, і обидва вимагають значних ресурсів для навчання та обробки (хоча останні інновації в NeRF починають вирішувати це).

Кастомна камера система NLR з 16 GoPro HERO7 та 6 центральними камерами Back‑Bone H7PRO. Для рендерингу в режимі реального часу вони працюють мінімум 60 кадр/сек. Джерело: https://arxiv.org/pdf/2103.11571.pdf Джерело: https://arxiv.org/pdf/2103.11571.pdf
Натомість Neural Lumigraph Rendering використовує SIREN (Sinusoidal Representation Networks), щоб інтегрувати переваги кожного підходу у власну структуру, яка призначена генерувати вихід, безпосередньо придатний до існуючих конвеєрів графіки в режимі реального часу.
SIREN використовувався у подібних реалізаціях протягом минулого року і тепер являє собою популярний API‑виклик для аматорських Colab‑ів у спільнотах синтезу зображень; проте інновація NLR полягає у застосуванні SIREN до двовимірного багатокутового контролю зображень, що є проблематичним через схильність SIREN до надфітингу замість узагальненого виходу.
Після того, як CG‑сітка витягнута з масиву зображень, вона растеризується за допомогою OpenGL, а позиції вершин сітки відображаються на відповідні пікселі, після чого обчислюється злиття різних внесених карт.
Отримана сітка більш узагальнена та репрезентативна, ніж у NeRF (див. зображення нижче), вимагає менше обчислень і не накладає надмірних деталей на ділянки (наприклад, гладку шкіру обличчя), які не можуть отримати вигоду від цього:

Джерело: https://arxiv.org/pdf/2103.11571.pdf
З негативного боку, NLR ще не має можливості динамічного освітлення чи пересвітлення, і вихід обмежений картами тіней та іншими параметрами освітлення, отриманими під час захоплення. Дослідники планують вирішити це у майбутніх роботах.
Крім того, у статті визнається, що форми, згенеровані NLR, не такі точні, як у деяких альтернативних підходів, таких як Pixelwise View Selection for Unstructured Multi-View Stereo, або дослідження Вейцманського інституту, згадані раніше.
Підйом волюметричного синтезу зображень
Ідея створення 3D‑сутностей з обмеженої серії фотографій за допомогою нейронних мереж передує NeRF, з візіонерськими роботами, що сягають 2007 року чи раніше. У 2019 році відділ досліджень AI Facebook випустив фундаментальну статтю Neural Volumes: Learning Dynamic Renderable Volumes from Images, яка вперше забезпечила реагуючі інтерфейси для синтетичних людей, згенерованих за допомогою машинного навчання у волюметричному захопленні.
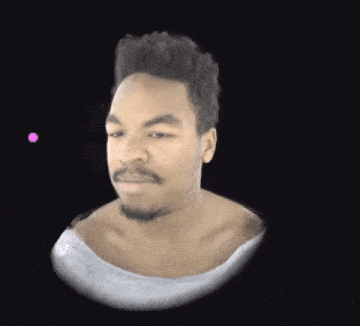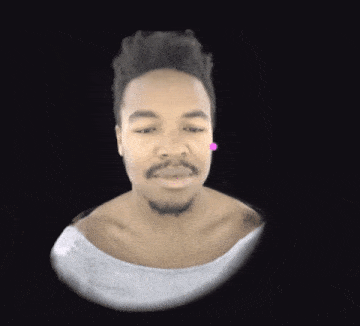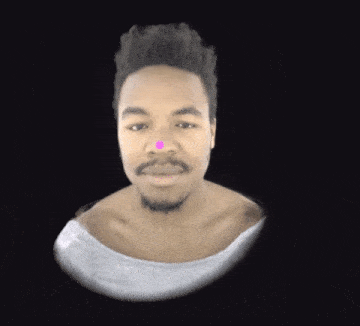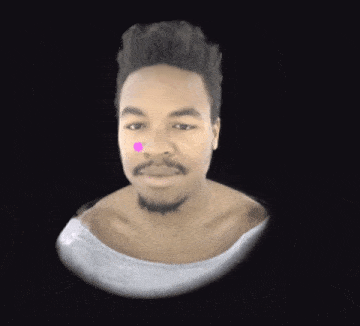
Дослідження Facebook 2019 року дозволило створити реагуючий інтерфейс користувача для волюметричної особи. Джерело: https://research.fb.com/publications/neural-volumes-learning-dynamic-renderable-volumes-from-images/
на українську. Перекласти на українську.


