
AGI та майбутній ШІ
Потужність Реранкерів та Дворівневого Відбору для Відбору Генерації

 Додайте Unite.AI до бажаних джерел у Google

Ключові моментиДвоетапний пошук з реранкерами значно покращує точність RAG, спочатку отримуючи багато…
Показати більше
- Двоетапний пошук з реранкерами значно покращує точність RAG, спочатку отримуючи багато документів, а потім переупорядковуючи їх за допомогою розумнішої моделі.
- Механізм пізньої взаємодії ColBERT забезпечує ефективний семантичний пошук, обробляючи запити та документи окремо до фінального порівняння.
- Моделі реранкінгу можна навчати на даних конкретної галузі, щоб вирішувати проблеми поза доменом, характерні для загальних моделей вбудовування.

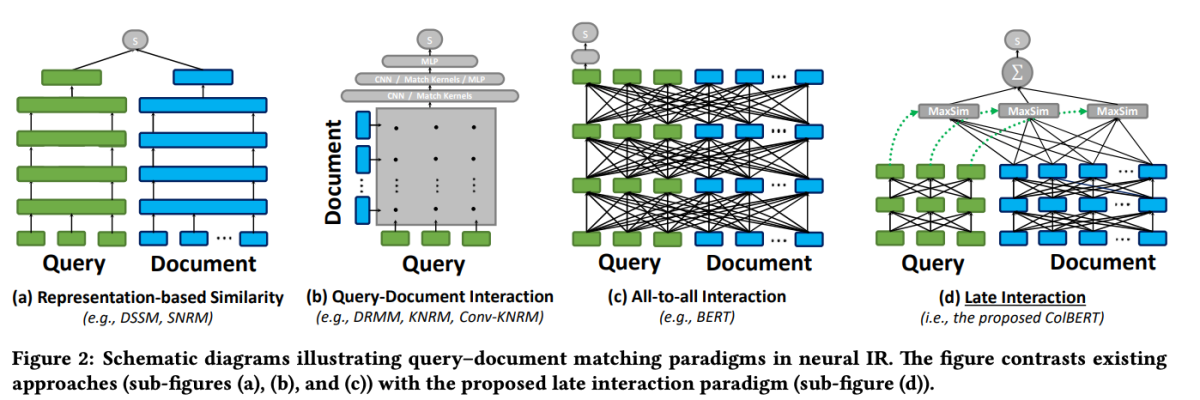
Цей фрагмент коду демонструє, як налаштувати та використовувати модель jina-colbert-v1-en для індексування колекції документів, використовуючи її здатність обробляти довгі контексти ефективно.
Реалізація Дворівневого Пошuku з Реранкерами
Тепер, коли ми маємо розуміння принципів дворівневого пошuku та реранкерів, давайте дослідимо їхню практичну реалізацію у контексті системи RAG. Ми будемо використовувати популярні бібліотеки та фреймворки для демонстрації інтеграції цих технік.
Налаштування Середовища
Перед тим, як зануритися в код, давайте налаштуємо наше середовище розробки. Ми будемо використовувати Python та кілька популярних бібліотек NLP, включаючи Hugging Face Transformers, Sentence Transformers та LanceDB.
# Встановіть необхідні бібліотеки
!pip install datasets huggingface_hub sentence_transformers lancedb
Підготовка Даних
Для демонстраційних цілей ми будемо використовувати набір даних “ai-arxiv-chunked” з Hugging Face Datasets, який містить понад 400 документів ArXiv з машинного навчання, обробки природної мови та великих мовних моделей.
from datasets import load_dataset <p>dataset = load_dataset("jamescalam/ai-arxiv-chunked", split="train")</p> &lt;pre&gt;
Далі ми підготуємо дані та розділимо їх на менші частини для ефективного пошuku та обробки.
from transformers import AutoTokenizer <p>tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")</p> <p>def chunk_text(text, chunk_size=512, overlap=64): tokens = tokenizer.encode(text, return_tensors="pt", truncation=True) chunks = tokens.split(chunk_size - overlap) texts = [tokenizer.decode(chunk) for chunk in chunks] return texts</p> <p>chunked_data = [] for doc in dataset: text = doc["chunk"] chunked_texts = chunk_text(text) chunked_data.extend(chunked_texts)</p>
Для початкової стадії пошuku ми будемо використовувати модель Sentence Transformer для кодування документів та запитів у густі векторні представлення, а потім здійснимо приблизний пошук найближчих сусідів за допомогою векторної бази даних, chẳng hạn як LanceDB.
from sentence_transformers import SentenceTransformer from lancedb import lancedb <p># Завантажте модель Sentence Transformer model = SentenceTransformer('all-MiniLM-L6-v2')</p> <p># Створіть векторну базу даних LanceDB db = lancedb.lancedb('/path/to/store') db.create_collection('docs', vector_dimension=model.get_sentence_embedding_dimension())</p> <p># Індексуйте документи for text in chunked_data: vector = model.encode(text).tolist() db.insert_document('docs', vector, text)</p> <p>from sentence_transformers import SentenceTransformer from lancedb import lancedb</p> <p># Завантажте модель Sentence Transformer model = SentenceTransformer('all-MiniLM-L6-v2')</p> <p># Створіть векторну базу даних LanceDB db = lancedb.lancedb('/path/to/store') db.create_collection('docs', vector_dimension=model.get_sentence_embedding_dimension())</p> <p># Індексуйте документи for text in chunked_data: vector = model.encode(text).tolist() db.insert_document('docs', vector, text)
З індексованими документами ми можемо здійснити початковий пошук, знайшовши найближчих сусідів до заданого запиту.
from transformers import AutoTokenizer <p>tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")</p> <p>def chunk_text(text, chunk_size=512, overlap=64): tokens = tokenizer.encode(text, return_tensors="pt", truncation=True) chunks = tokens.split(chunk_size - overlap) texts = [tokenizer.decode(chunk) for chunk in chunks] return texts</p> <p>chunked_data = [] for doc in dataset: text = doc["chunk"] chunked_texts = chunk_text(text) chunked_data.extend(chunked_texts)
Реранкінг
Після початкового пошuku ми застосуємо модель реранкеру для перепорядкування витягнутих документів на основі їхньої відповідності запиту. У цьому прикладі ми будемо використовувати реранкер ColBERT, швидку та точну трансформерну модель, спеціально розроблену для ранжування документів.
from lancedb.rerankers import ColbertReranker

reranker = ColbertReranker()

<p># Реранкуйте початкові документи
reranked_docs = reranker.rerank(query, initial_docs)
Тепер список reranked_docs містить документи, перепорядковані згідно з їхньою відповідністю запиту, визначеною реранкером ColBERT.
Доповнення та Генерація
З реранкованими та відповідними документами ми можемо перейти до стадій доповнення та генерації трубопроводу RAG. Ми будемо використовувати мовну модель з бібліотеки Hugging Face Transformers для генерації кінцевої відповіді.
from transformers import AutoTokenizer, AutoModelForSeq2SeqLM <p>tokenizer = AutoTokenizer.from_pretrained("t5-base") model = AutoModelForSeq2SeqLM.from_pretrained("t5-base")</p> <p># Доповніть початковий запит реранкованими документами augmented_query = query + " " + " ".join(reranked_docs[:3])</p> <p># Генеруйте відповідь мовної моделі input_ids = tokenizer.encode(augmented_query, return_tensors="pt") output_ids = model.generate(input_ids, max_length=500) response = tokenizer.decode(output_ids[0], skip_special_tokens=True)</p> print(response)


