
Моделі та платформи ШІ
Всередині OpenAI’s o3 і o4-mini: Розблокування нових можливостей через багатомодальну логіку та інтегровані інструменти

 Додайте Unite.AI до бажаних джерел у Google
16 квітня 2025 року OpenAI опублікувала оновлені версії своїх моделей розширеної логіки. Ці нові моделі, названі o3 і o4-mini, пропонують покращення порівняно з їхніми попередниками, o1 і o3-mini, відповідно. Останні моделі забезпечують підвищену продуктивність, нові функції та більшу доступність. Ця стаття досліджує основні переваги o3 і o4-mini, описує їхні основні можливості та обговорює, як вони можуть вплинути на майбутнє застосувань штучного інтелекту. Але перед тим, як ми зануримося в те, що робить o3 і o4-mini особливими, важливо зрозуміти, як моделі OpenAI еволюціонували з часом. Почнімо з короткого огляду шляху OpenAI у розробці все потужніших мовних та логічних систем.
Еволюція великих мовних моделей OpenAI
Розробка великих мовних моделей OpenAI почалася з GPT-2 та GPT-3, які привели ChatGPT до широкого вжитку завдяки їхній здатності генерувати тексти, що є як плавними, так і контекстно точними. Ці моделі широко застосовувалися для завдань, таких як підсумовування, переклад та відповіді на питання. Однак, коли користувачі застосовували їх до більш складних сценаріїв, їхні обмеження стали очевидними. Ці моделі часто мали труднощі з завданнями, які вимагали глибокого розуміння, логічної послідовності та багаторівневого вирішення проблем. Щоб подолати ці виклики, OpenAI представила GPT-4 та зосередила свою увагу на покращенні логічних можливостей своїх моделей. Цей зсув призвів до розробки o1 та o3-mini. Обидві моделі використовували метод, званий ланцюговим підходом до логіки, який дозволяв їм генерувати більш логічні та точні відповіді шляхом логічного мислення. Хоча o1 призначена для задоволення потреб у розширених можливостях вирішення проблем, o3-mini створена для надання подібних можливостей більш ефективним та економічним способом. Будучи заснованими на цьому фундаменті, OpenAI тепер представила o3 та o4-mini, які ще більше покращують логічні можливості своїх великих мовних моделей. Ці моделі розроблені для генерації більш точних та ретельно продуманих відповідей, особливо в технічних галузях, таких як програмування, математика та науковий аналіз — сфери, де логічна точність критична. У наступному розділі ми розглянемо, як o3 та o4-mini покращують свої попередні версії.
Ключові вдосконалення в o3 та o4-mini
Покращені логічні можливості
Одним з ключових покращень в o3 та o4-mini є їхня покращена логічна здатність для складних завдань. На відміну від попередніх моделей, які забезпечували швидкі відповіді, o3 та o4-mini моделі витрачають більше часу на обробку кожного запиту. Ця додаткова обробка дозволяє їм мислити більш ретельно та генерувати більш точні відповіді, що призводить до покращення результатів на бенчмарках. Наприклад, o3 перевершує o1 на 9% на LiveBench.ai, бенчмарці, який оцінює продуктивність по декількох складних завданнях, таких як логіка, математика та код. На SWE-bench, який тестує логічні можливості в завданнях програмної інженерії, o3 досягла результату 69.1%, перевершивши навіть конкурентоспроможні моделі, такі як Gemini 2.5 Pro, які набрали 63.8%. Тим часом o4-mini набрала 68.1% на тому ж бенчмарці, забезпечуючи майже таку ж логічну глибину при значно нижчій вартості.
Багатомодальна інтеграція: мислення зображеннями
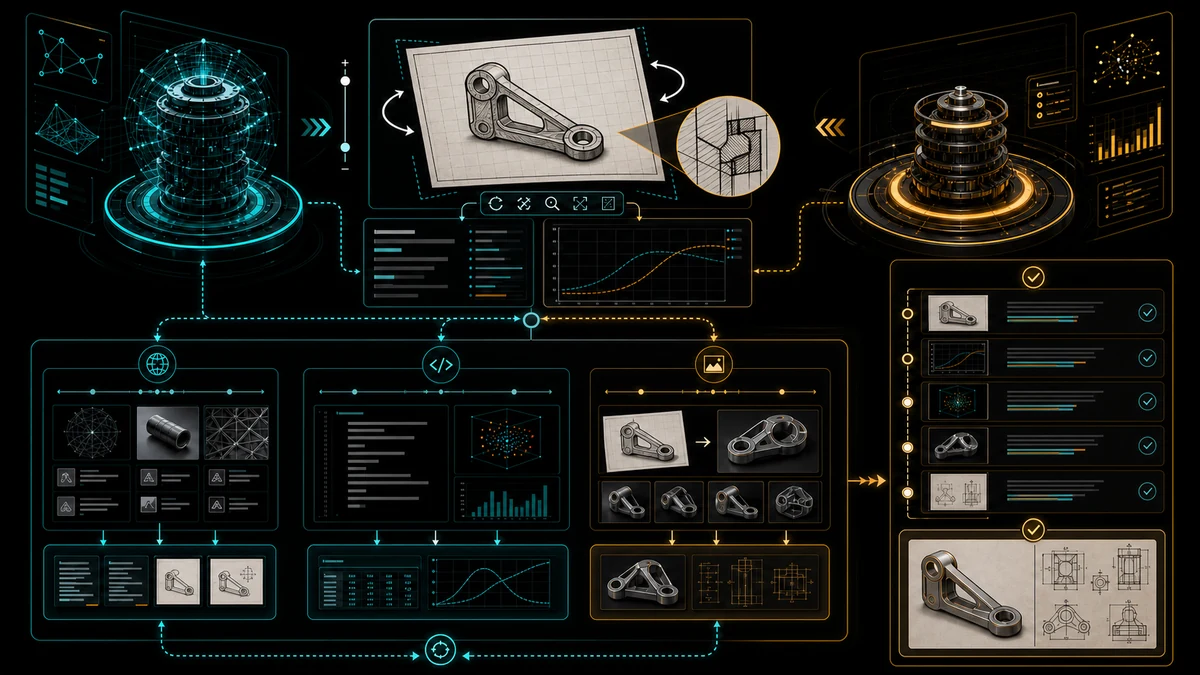
Однією з найбільш інноваційних функцій o3 та o4-mini є їхня здатність “мислити зображеннями”. Це означає, що вони можуть не тільки обробляти текстову інформацію, але й інтегрувати візуальні дані безпосередньо в свій логічний процес. Вони можуть розуміти та аналізувати зображення, навіть якщо вони низької якості — таких як рукописні нотатки, ескізи чи діаграми. Наприклад, користувач міг би завантажити діаграму складної системи, і модель могла б проаналізувати її, визначити потенційні проблеми чи навіть запропонувати покращення. Ця здатність мостить розрив між текстовими та візуальними даними, забезпечуючи більш інтуїтивний та комплексний взаємодію з штучним інтелектом. Обидві моделі можуть виконувати дії, такі як масштабування деталей чи обертання зображень для кращого розуміння. Ця багатомодальна логіка є суттєвим вдосконаленням попередників, таких як o1, які були в основному текстовими. Це відкриває нові можливості для застосувань у галузях, таких як освіта, де візуальні посібники є важливими, та дослідження, де діаграми та графіки часто центральні для розуміння.
Розширений інструментарій
o3 та o4-mini є першими моделями OpenAI, які одночасно використовують усі інструменти, доступні в ChatGPT. Ці інструменти включають:
- Просмотр веб-сторінок: дозволяє моделям отримувати найновішу інформацію для часочутливих запитів.
- Виконання коду Python: дозволяє їм виконувати складні обчислення чи аналіз даних.
- Обробка та генерація зображень: підвищує їхню здатність працювати з візуальними даними.
Використовуючи ці інструменти, o3 та o4-mini можуть розв’язувати складні багаторівневі проблеми більш ефективно. Наприклад, якщо користувач задає питання, яке вимагає актуальних даних, модель може виконати веб-пошук для отримання найновішої інформації. Аналогічно, для завдань, що включають аналіз даних, вона може виконати код Python для обробки даних. Ця інтеграція є суттєвим кроком до більш автономних агентів штучного інтелекту, які можуть обробляти широкий спектр завдань без втручання людини. Введення Codex CLI, легкого, відкритого кодового агента, який працює з o3 та o4-mini, ще більше підвищує їхню корисність для розробників.
Вплив та нові можливості
Випуск o3 та o4-mini має широкі наслідки в різних галузях:
- Освіта: ці моделі можуть допомогти студентам та викладачам, забезпечуючи детальні пояснення та візуальні посібники, роблячи навчання більш інтерактивним та ефективним. Наприклад, студент міг би завантажити ескіз математичної задачі, і модель могла б надати розв’язок крок за кроком.
- Дослідження: вони можуть прискорити відкриття, аналізуючи складні набори даних, генеруючи гіпотези та інтерпретуючи візуальні дані, такі як графіки та діаграми, що є цінним для галузей, таких як фізика чи біологія.
- Промисловість: вони можуть оптимізувати процеси, покращити прийняття рішень та підвищити взаємодію з клієнтами, обробляючи як текстові, так і візуальні запити, такі як аналіз конструкцій продуктів чи технічних проблем.
- Креативність та ЗМІ: автори можуть використовувати ці моделі для перетворення планів розділів у прості сторіборди. Музиканти можуть поєднувати візуальні ефекти з мелодією. Редактори фільмів отримують пропозиції щодо темпу. Архітектори можуть перетворити рукописні плани поверхів у детальні 3D-чертежі, які включають конструктивні та екологічні нотатки.
- Доступність та Інклюзивність: для сліпих користувачів моделі описують зображення докладно. Для глухих користувачів вони перетворюють діаграми у візуальні послідовності чи підписані тексти. Їхній переклад як слів, так і візуальних даних допомагає мостити мовні та культурні розриви.
- До автономних агентів: оскільки моделі можуть просматривати веб, виконувати код та обробляти зображення в одному робочому процесі, вони становлять основу для автономних агентів. Розробники описують функцію; модель пише, тестує та розгортає код. Працівники з знаннями можуть делегувати збір даних, аналіз, візуалізацію та написання звітів одному агенту штучного інтелекту.
Обмеження та Що далі
Незважаючи на ці вдосконалення, o3 та o4-mini все ще мають обмеження знань до серпня 2023 року, що обмежує їхню здатність реагувати на найсвіжіші події чи технології, якщо вони не доповнюються просмотром веб-сторінок. Майбутні ітерації, ймовірно, подолають цей розрив, покращуючи реальний прийом даних.
Ми також можемо очікувати подальшого прогресу в автономних агентах штучного інтелекту — системах, які можуть планувати, мислити, діяти та навчатися безперервно з мінімальним наглядом. Інтеграція інструментів, моделей логіки та доступу до реального часу OpenAI сигналізує про те, що ми рухаємося ближче до таких систем.
Висновок
Нові моделі OpenAI, o3 та o4-mini, пропонують вдосконалення в логіці, багатомодальному розумінні та інтегрованих інструментаріях. Вони є більш точними, універсальними та корисними для широкого спектра завдань — від аналізу складних даних та генерації коду до інтерпретації зображень. Ці вдосконалення мають потенціал суттєво підвищити продуктивність та прискорити інновації в різних галузях.





