Моделі та платформи ШІ
Gemini Робототехніка: AI Розуміння Зустрічає Фізичний Світ

 Додайте Unite.AI до бажаних джерел у Google
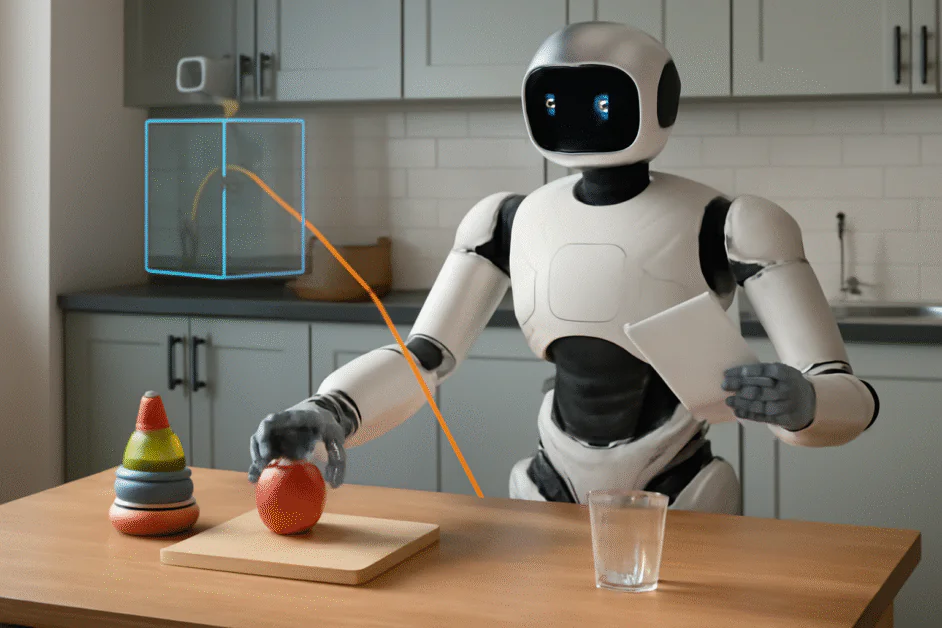
За останні роки штучний інтелект (AI) суттєво просунувся в різних галузях, таких як обробка природної мови (NLP) та комп’ютерне зору. Однак однією з основних проблем для AI була її інтеграція у фізичний світ. Хоча AI досягла успіхів у розумінні та вирішенні складних проблем, ці досягнення в основному були обмежені цифровими середовищами. Щоб дозволити AI виконувати фізичні завдання через робототехніку, їй необхідно мати глибоке розуміння просторового розуміння, маніпуляції об’єктами та прийняття рішень. Щоб подолати цю проблему, Google (GOOGL ) представила Gemini Робототехніку, набір моделей, спеціально розроблених для робототехніки та втіленого AI. Будучи заснованою на Gemini 2.0, ці моделі AI поєднують передові можливості розуміння AI з фізичним світом, щоб дозволити роботам виконувати широкий спектр складних завдань.
Додаткові подробиці про втілене міркування та керування
Gemini Robotics складається з двох моделей на основі Gemini 2.0. Візуально-мовна модель розширюється до архітектури Vision-Language-Action: вона не лише обробляє текст, зображення, аудіо й відео, а й перетворює інструкції та спостереження на фізичні дії. Це дає роботу змогу побачити оточення, зрозуміти його в контексті людської мови та виконати послідовність рухів.
Важливою властивістю є узагальнення без тривалого перенавчання. Система виконує інструкції з відкритим словником, пристосовується до змін у розташуванні предметів і може спробувати завдання, якого не було у навчальних даних. Це необхідно для будинків і виробництв, де умови постійно змінюються.
Сприйняття предметів і тривимірного простору
Втілене міркування поєднує виявлення предметів, прогнозування траєкторій і точок захоплення та розуміння 3D-простору. Робот може розпізнати незнайомий предмет, визначити, де його взяти, оцінити його стан і виконати такі дії, як відкрити шухляду, налити рідину або скласти папір. Прогнозування шляху дає змогу обрати ефективний рух, а багаторакурсна відповідність і тривимірні обмежувальні рамки підтримують точні маніпуляції.
Спритність і перенесення навичок
Модель розрахована на завдання з тонкою моторикою: складання одягу й орігамі, укладання предметів або карткові ігри. Після додаткового налаштування вона координує кілька ступенів свободи, зокрема обидві руки. Навчання з малої кількості прикладів дозволяє опанувати нову дію приблизно зі ста демонстрацій замість великого спеціалізованого набору даних.
Ті самі знання можна переносити між різними фізичними платформами. Gemini Robotics здатна керувати дворуким маніпулятором або гуманоїдом із більшою кількістю суглобів, що зменшує залежність програмного забезпечення від однієї конструкції робота.
Керування без прикладів і генерація коду
Zero-shot control означає виконання дії без окремого навчання саме для неї. Отримавши високорівневий опис, Gemini може згенерувати код керування, використовуючи міркування про фізику й оточення. Для складніших рухів система переходить до few-shot learning: переглядає невелику кількість демонстрацій і одразу застосовує навичку в роботі.
Поєднання цих підходів особливо цінне в непередбачуваному середовищі, де неможливо заздалегідь зібрати приклади для кожної ситуації. Водночас реальне розгортання потребуватиме перевірки безпеки, надійного контролю помилок та обмежень, які не дозволять моделі виконувати небезпечні дії.
Можливі сфери застосування
У промисловості такі моделі можуть підтримувати складне складання, інспекцію й технічне обслуговування. У побуті — допомагати з домашніми справами, доглядом і персональними послугами. Універсальність однієї системи для багатьох тіл і завдань може зменшити витрати на програмування роботів, але якість залежатиме від здатності працювати безпечно поруч із людьми та справлятися з рідкісними подіями.
Розуміння Gemini Робототехніки
Gemini Робототехніка – це пара моделей AI, побудованих на основі Gemini 2.0, сучасної моделі бачення-мови (VLM), здатної обробляти текст, зображення, аудіо та відео. Gemini Робототехніка є по суті розширенням VLM у модель бачення-мови-дії (VLA), яка дозволяє моделі Gemini не тільки розуміти та інтерпретувати візуальні входи та обробляти природну мову, але також виконувати фізичні дії у реальному світі. Це поєднання є критичним для робототехніки, оскільки дозволяє машинам не тільки “бачити” своє середовище, але також розуміти його у контексті людської мови та виконувати складні завдання реального світу, від простої маніпуляції об’єктами до більш складних завдань, що вимагають високої точності.
Втілене Розуміння
Однією з основних проблем у робототехніці завжди була розрив між цифровим розумінням та фізичною взаємодією. Хоча люди можуть легко розуміти складні просторові відносини та безшовно взаємодіяти зі своїм оточенням, роботам було складно повторити ці можливості. Наприклад, роботам обмежено розуміння просторової динаміки, адаптація до нових ситуацій та обробка непередбачуваних взаємодій у реальному світі. Щоб подолати ці проблеми, Gemini Робототехніка включає “втілене розуміння”, процес, який дозволяє системі розуміти та взаємодіяти з фізичним світом чином, подібним до людського.
Гнучкість та Адаптація: Ключ до Завдань Реального Світу
Хоча виявлення об’єктів та розуміння їх є критичними, справжня проблема робототехніки полягає у виконанні завдань, що вимагають високої точності та координації. Наприклад, складання оригамі чи гра у карти – завдання, які перевищують можливості більшості систем AI. Однак Gemini Робототехніка була спеціально розроблена для виконання таких завдань.
Контроль Без Навчання та Швидка Адаптація
Однією з видатних особливостей Gemini Робототехніки є її здатність контролювати роботів у режимі навчання без попереднього досвіду або з мінімальним навчанням. Контроль без навчання означає можливість виконання завдань без потреби спеціального навчання для кожного окремого завдання, тоді як навчання з мінімальним досвідом включає навчання з малих прикладів.
Майбутні Наслідки
Gemini Робототехніка є важливим кроком у напрямку загальної робототехніки. Об’єднуючи можливості розуміння AI з гнучкістю та адаптивністю роботів, вона наближає нас до мети створення роботів, які можуть бути легко інтегровані у повсякденне життя та виконувати різноманітні завдання, що вимагають людської взаємодії.
Висновок
Gemini Робототехніка – це набір моделей, побудованих на основі Gemini 2.0, призначених для надання роботам можливості розуміння та взаємодії з фізичним світом. Ці моделі можуть допомогти інженерам та розробникам у створенні роботів, що можуть розуміти та взаємодіяти з фізичним світом чином, подібним до людського. З можливістю виконання складних завдань з високою точністю та гнучкістю, Gemini Робототехніка включає особливості, такі як втілене розуміння, контроль без навчання та навчання з мінімальним досвідом. Ці можливості дозволяють роботам адаптуватися до свого середовища без потреби великого навчання. Gemini Робототехніка має потенціал трансформувати галузі, від виробництва до домашньої допомоги, роблячи роботів більш здатними та безпечними у реальному світі. Коли ці моделі продовжать розвиватися, вони мають потенціал переозначити майбутнє робототехніки.
Джерела та довідкові посилання