
Погляд Anderson
GAN як рендерер обличчя для традиційної CGI

 Додайте Unite.AI до бажаних джерел у Google

Ключові моментиВідокремлення ідентичності від вираження в латентному просторі GAN залишається…
Показати більше
- Відокремлення ідентичності від вираження в латентному просторі GAN залишається центральною невирішеною проблемою для синтезу відео облич.
- Параметричні CGI-моделі, такі як SMPL та 3DMM, все частіше використовуються для впорядкування некерованих латентних кодів GAN.
- Гібридний підхід Disney «Rendering with Style» дав моторошні результати, поєднавши традиційні карти текстур із зображеннями, згенерованими GAN.
Думка Коли генеративні змагальні мережі (GAN) уперше продемонстрували здатність створювати разюче реалістичні тривимірні обличчя, це спричинило золоту лихоманку навколо їхнього нерозкритого потенціалу для часово узгодженого відео людських облич.
Здавалося, десь у латентному просторі GAN мусить існувати прихований порядок і раціональність: зародкова семантична логіка, закладена в латентних кодах, яка дозволить генерувати узгоджені ракурси та різні відтворення, наприклад зміни виразу, того самого обличчя. Це дало б часово переконливу технологію відеодипфейків, яка значно перевершила б автокодувальники.
Висока роздільна здатність результату була б нескладним завданням порівняно з низькими роздільностями, за яких обмеження GPU змушують працювати DeepFaceLab і FaceSwap. Зона заміни обличчя в автокодувальнику стала б зоною створення GAN на основі кількох вхідних зображень або навіть одного.
Між заміненим обличчям і обличчям-основою більше не було б невідповідності, адже усе зображення створювалося б із нуля, включно з волоссям, контуром щелепи та зовнішніми межами рис обличчя, які часто становлять проблему для традиційних дипфейків з автокодувальниками.
Зима відео облич із GAN
Утім, усе виявилося складнішим. Центральною проблемою стало розділення чинників, яке й досі є головним викликом. Як зберегти впізнавану ідентичність обличчя та змінити його позу чи вираз, не збираючи тисячі еталонних знімків, які навчать мережу наслідків таких змін, як це старанно роблять системи з автокодувальниками?
Подальші дослідження анімації та синтезу облич із GAN натомість припускали, що до вхідної ідентичності можна застосовувати цілеспрямовані, загальні, шаблонні перетворення, не специфічні для конкретної особи. Наприклад, надати обличчю GAN вираз, якого немає на жодному відомому мережі знімку цієї людини.

У праці 2022 року Tensor-based Emotion Editing in the StyleGAN Latent Space шаблонні вирази застосовано до вхідного обличчя з набору FFHQ. Джерело: https://arxiv.org/pdf/2205.06102.pdf
Універсальний підхід очевидно не охоплює різноманіття виразів, притаманних конкретній людині. Виникає питання, чи можна коли-небудь точно відтворити таку особливу усмішку, як у Джека Ніколсона або Віллема Дефо, під дією кодів усередненого виразу.

Хто цей чарівний латиноамериканський незнайомець? Хоча GAN створює реалістичніше обличчя вищої роздільності, перетворення не спирається на численні справжні знімки актора, як DeepFaceLab, який довго навчається на тисячах таких зображень. Тому портретна схожість страждає. На тлі модель DeepFaceLab імпортовано в DeepFaceLive — потокову реалізацію цього популярного й суперечливого програмного забезпечення. Приклади: https://www.youtube.com/watch?v=9tr35y-yQRY (2022) та https://arxiv.org/pdf/2205.06102.pdf.
Останніми роками запропоновано чимало редакторів виразів облич із GAN. Більшість працює з незнайомими особами, тому пересічний читач не може оцінити точність перетворення, адже не знає цих облич.

Перетворення незнайомих осіб у методі Cascade-EF-GAN 2020 року. Джерело: https://arxiv.org/pdf/2003.05905.pdf
Мабуть, найбільше уваги й цитувань за останні три роки здобув редактор InterFaceGAN. Він переміщується латентним простором за кодами, пов’язаними з позою, тобто кутом камери чи обличчя, виразом, віком, расою, статтю та іншими важливими властивостями.
Можливості морфінгу в дусі 1980-х у InterFaceGAN та подібних системах переважно ілюструють шлях перетворення під час зворотного проєктування зображення через відповідний латентний код, наприклад віку. Але у виробництві часово неперервного відео такі схеми досі виявляються вражаючими катастрофами.
Якщо додати складність створення часово узгодженого волосся та відсутність вбудованих часових орієнтирів у дослідженні й маніпулюванні латентними кодами, логічно припустити, що GAN — не все, що потрібно™ для синтезу відео облич. Незрозуміло навіть, як додати такі орієнтири до системи, створеної для статичних зображень, без власної підтримки відеовиходу.
Подальша робота принесла поступові вдосконалення розділення чинників. Інші дослідження додали методи комп’ютерного зору як шар керування, зокрема семантичну сегментацію як контрольний механізм у праці SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing кінця 2021 року.
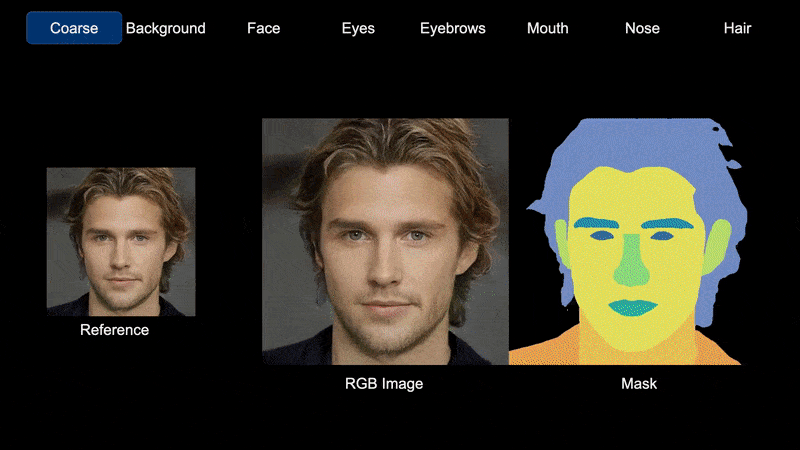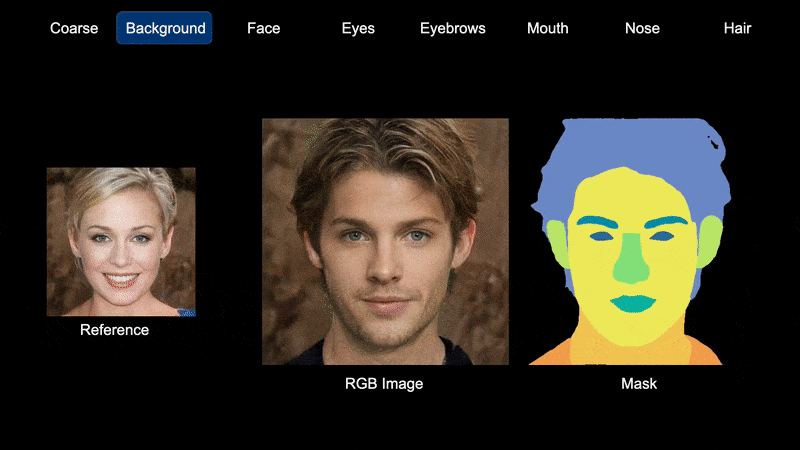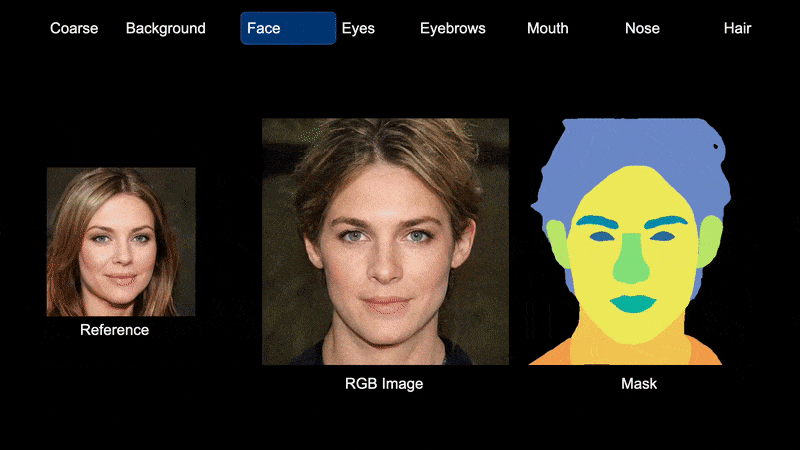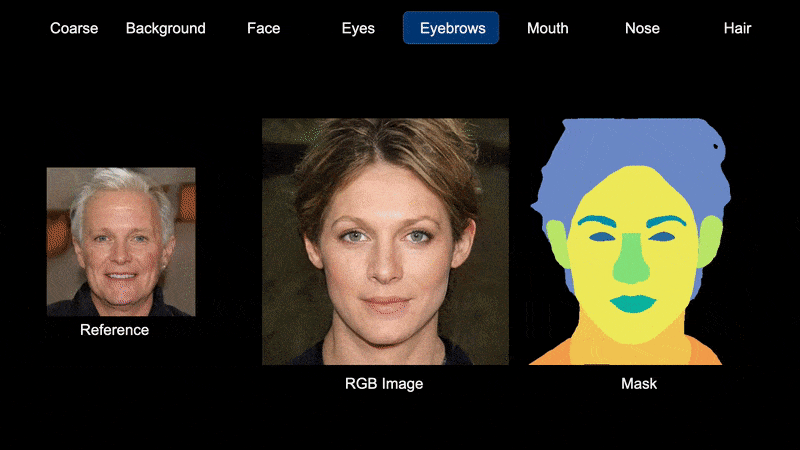
Семантична сегментація як засіб керування латентним простором у SemanticStyleGAN. Джерело: https://semanticstylegan.github.io/
Параметричне керування
Дослідники синтезу облич із GAN дедалі частіше використовують традиційні параметричні обличчя CGI для спрямування й упорядкування потужних, але погано керованих латентних кодів.
Хоча параметричні елементи облич є складовою досліджень комп’ютерного зору вже понад двадцять років, останнім часом інтерес зріс разом із поширенням елементів CGI Skinned Multi-Person Linear Model (SMPL). Цей підхід започаткували Інститут Макса Планка та ILM, а потім удосконалили за допомогою системи Sparse Trained Articulated Human Body Regressor (STAR).

SMPL, тут у варіанті SMPL-X, може накладати параметричну сітку CGI відповідно до оціненої пози всього людського тіла на зображенні, за потреби включно з виразами. Це дозволяє виконувати нові операції, використовуючи сітку як об’ємний або перцептивний орієнтир. Джерело: https://arxiv.org/pdf/1904.05866.pdf
Найвідомішим розвитком цього напряму стала ініціатива Disney 2019 року Rendering with Style. Вона поєднала традиційні карти текстур із зображеннями GAN для створення якіснішої анімації в стилі дипфейків.

Старе зустрічається з новим у гібридному підході Disney до дипфейків із GAN. Джерело: https://www.youtube.com/watch?v=TwpLqTmvqVk
Disney вводить традиційно відрендерені елементи CGI в мережу StyleGAN2, щоб домальовувати людські обличчя в проблемних зонах, як-от текстура шкіри, де під час генерації відео складно зберегти часову узгодженість.

Робочий процес Rendering with Style.
Параметричну голову CGI, яка керує процесом, можна налаштувати під користувача. Обличчя GAN відображатиме ці зміни, включно зі змінами положення голови та виразу.
Метод має поєднувати керованість CGI із природною реалістичністю облич GAN, але результати показують недоліки обох підходів. Вони досі не зберігають узгодженість текстури волосся й навіть розміщення основних рис:
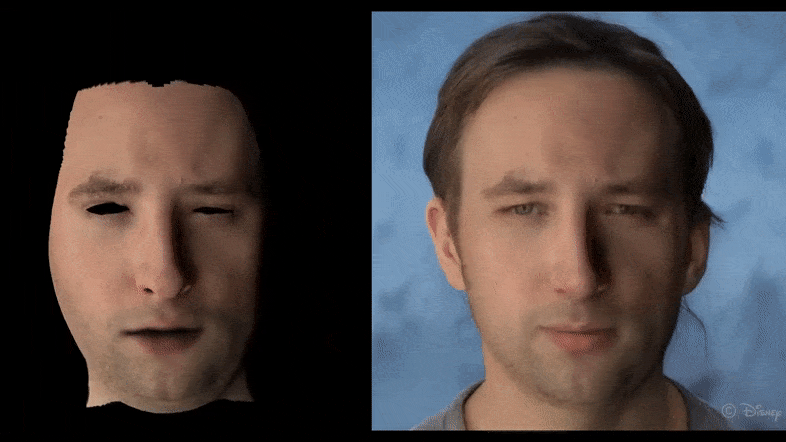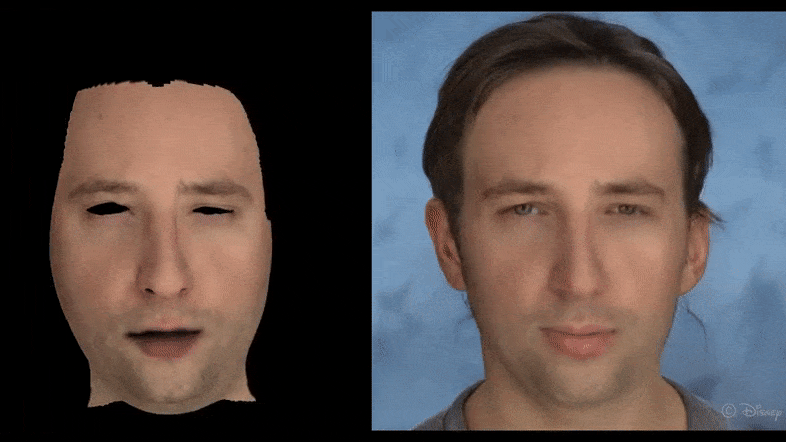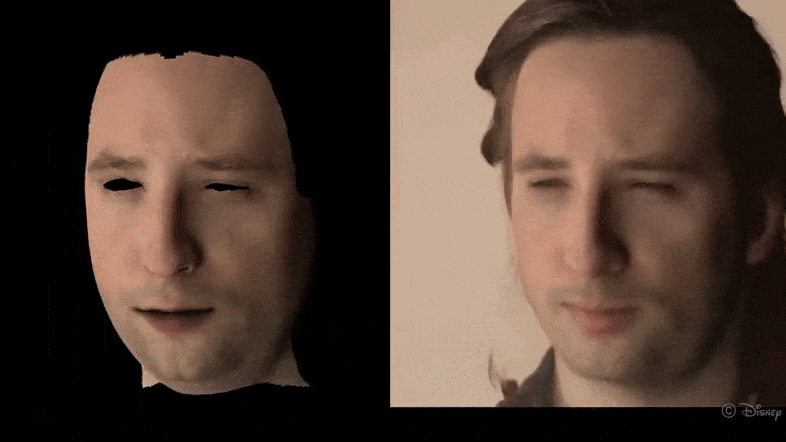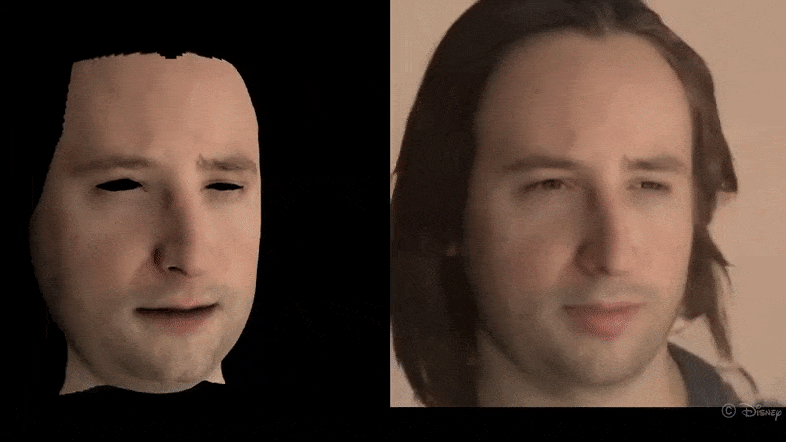
Rendering with Style породжує нову форму моторошної долини, хоча сам принцип має певний потенціал.
Дослідницька праця StyleRig: Rigging StyleGAN for 3D Control over Portrait Images 2020 року використовує дедалі популярніший підхід: тривимірні деформівні моделі облич (3DMM) як посередників для зміни властивостей у StyleGAN. Тут ними керує нова мережа RigNet:

3DMM слугують посередниками для інтерпретації латентного простору в StyleRig. Джерело: https://arxiv.org/pdf/2004.00121.pdf
Проте, як зазвичай у таких проєктах, результати поки обмежені малими змінами пози та змінами виразу чи емоційного стану без належного врахування особливостей людини.

StyleRig покращує керованість, але часово узгоджене волосся залишається нерозв’язаною проблемою. Джерело: https://www.youtube.com/watch?v=eaW_P85wQ9k
Подібні результати має MOST-GAN від Mitsubishi Research — праця 2021 року з нелінійними 3DMM як архітектурою розділення чинників, яка також має труднощі з отриманням динамічного й узгодженого руху.
Найновіше дослідження, що прагне поєднати керованість і розділення чинників, — One-Shot Face Reenactment on Megapixels. Воно знову використовує параметричні голови 3DMM як зручний інтерфейс для StyleGAN.

У процесі MegaFR системи One-Shot Face Reenactment мережа синтезує обличчя, поєднуючи реальний знімок, інвертований у латентне представлення, з параметрами відрендереної моделі 3DMM. Джерело: https://arxiv.org/pdf/2205.13368.pdf
OSFR належить до дедалі ширшого класу редакторів облич GAN, що прагнуть створити лінійні процеси редагування на кшталт Photoshop чи After Effects. Користувач вводить потрібне зображення й застосовує перетворення, замість пошуку латентних кодів ідентичності в латентному просторі.
Параметричні вирази знову є загальним, неперсоналізованим способом додавання виразу. Отримані зміни можуть здаватися моторошними у власний, не завжди позитивний спосіб.

Вирази, додані в OSFR.
Подібно до попередніх методів, OSFR може вивести близькі до початкових пози з одного зображення, а також виконати фронталізацію: перетворити обличчя, зняте під кутом, на фронтальний портрет.

Початковий знімок угорі та виведені фронтальні портрети з однієї з реалізацій OSFR, описаних у новій праці.
На практиці така інференція нагадує деякі принципи фотограмметрії, на яких ґрунтуються нейронні поля випромінювання (NeRF). Але тут геометрію слід визначити з одного знімка, а не з 3–4 ракурсів, які дозволяють NeRF вивести відсутні проміжні пози й створити доступні для дослідження нейронні 3D-сцени з людьми.
(Утім, NeRF також не є всім, що потрібно™: у синтезі відео облич воно стикається з майже цілком іншим набором перешкод, ніж GAN.)
Чи є місце для GAN у синтезі відео облич?
Отримання динамічних виразів і поз поза розподілом навчальних даних з одного вихідного зображення наразі видається алхімічною одержимістю дослідників GAN. Адже GAN — єдиний метод, здатний нині створювати нейронні обличчя досить високої роздільності й відносно високої точності. Автокодувальники можуть навчатися на численних реальних позах і виразах, але їхні вхідні та вихідні роздільності обмежує VRAM, і вони потребують зображення-основи. NeRF має подібні обмеження і, на відміну від обох інших підходів, поки не має усталених методів зміни виразів та загалом допускає лише обмежене редагування.
Єдиним шляхом до точного синтезу CGI/GAN видається новий спосіб об’єднати ідентичність із кількох фотографій у латентному просторі. Тоді код людини не мусив би проходити весь простір заради непов’язаних параметрів пози, а міг би посилатися на власні реальні знімки як еталони для перетворень.
Навіть тоді або при навчанні всієї StyleGAN на обличчях однієї особи, як у наборах автокодувальників, відсутню семантичну логіку, ймовірно, усе ще мали б забезпечувати допоміжні технології: семантична сегментація чи параметричні обличчя 3DMM. У такому разі вони принаймні мали б більше матеріалу.


