
Інтерв’ю
Доктор Джеймі Бленд, співзасновник і генеральний директор компанії Aquila Health – Інтерв’ю серія

 Додайте Unite.AI до бажаних джерел у Google
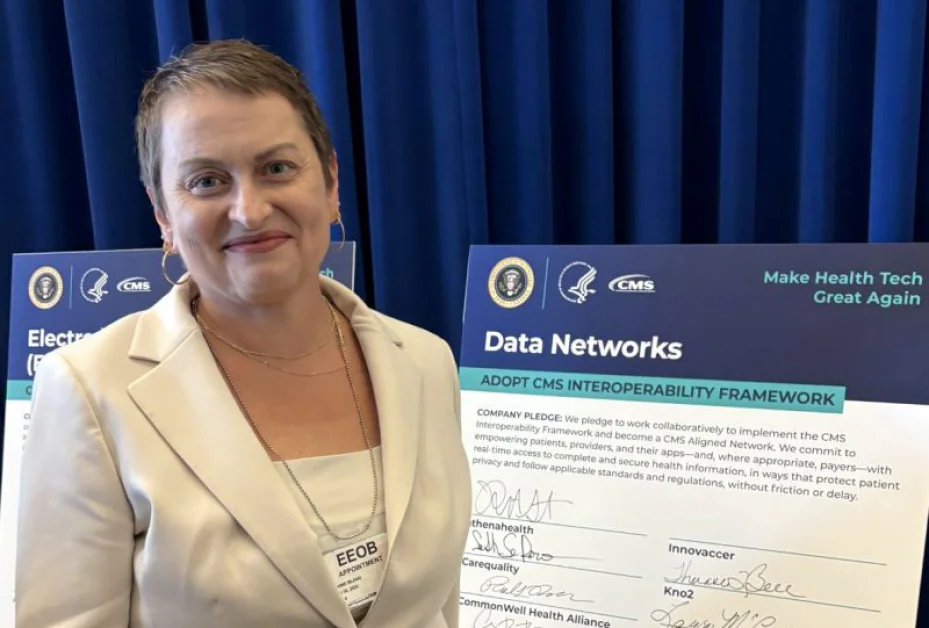
Доктор Джеймі Бленд, співзасновник і генеральний директор компанії Aquila Health, є лідером у сфері охорони здоров’я, який зосереджується на вирішенні однієї з найбільш постійних проблем галузі: фрагментованої та недоступної інформації. Вона заснувала компанію Aquila Health, щоб створити єдину інфраструктуру даних, яка дозволить організаціям охорони здоров’я вийти за рамки ізольованих систем, використовуючи машинне навчання та структурований аналіз для генерації дієвих висновків, зберігаючи при цьому клінічний нагляд. Її робота зосереджена на поліпшенні взаємодії, забезпеченні здоров’я населення, підтримці раннього виявлення нових загроз здоров’ю шляхом інтеграції клінічних, страхових та геномних даних.
Aquila Health – це платформа охорони здоров’я, що використовує штучний інтелект для об’єднання розрізнених джерел даних у єдину, взаємодіючу систему, яка підтримує як операційну ефективність, так і розширений аналіз. Платформа приймає високовольтні формати даних охорони здоров’я, такі як HL7 і FHIR, забезпечуючи безшовну інтеграцію між лікарнями, системами охорони здоров’я та іншими учасниками. Об’єднуючи структуровані підходи машинного навчання з моделлю валідації з людиною, компанія Aquila зосереджується на забезпеченні надійних висновків для управління здоров’ям населення, виявленні аномалій та прийнятті рішень в режимі реального часу, а не лише на основі не прозорих систем штучного інтелекту. Це позиціонує компанію на перетині інфраструктури даних та прикладного штучного інтелекту, де поліпшення якості та доступності даних є фундаментальними для розблокування повного потенціалу інтелекту охорони здоров’я.
Ви керували компанією CyncHealth через масовий рост, розширюючи взаємодію між мільйонами медичних записів та декількома штатами, перш ніж заснувати компанію Aquila Health. Які ключові обмеження або системні збої ви зустріли під час цього шляху, що в кінцевому підсумку спонукало вас створити Aquila з нуля?
У компанії CyncHealth ми витратили роки на будівництво інфраструктури для підключення організацій охорони здоров’я по всьому Небрасці та Айові. Ми підключили понад 1 100 медичних закладів і мільйони медичних записів, охоплюючи населення понад п’яти мільйонів осіб.
Що ми постійно зустрічали, проте, було те, що підключення систем і зроблення даних корисними – це дві різні проблеми. Наприклад, ми працювали над створенням панелі контролю над випадками передозування опіоїдами, яка координувала дані, отримані з декількох джерел. Це зайняло місяці з сотнями годин роботи та координації між багатьма учасниками, щоб зробити цю одну точку даних зрозумілою в контексті охорони здоров’я та громадської охорони здоров’я. І після всього цього картина все одно була неповною.
Цей досвід став зерном для компанії Aquila. Традиційний спосіб підключення інтерфейсів без розуміння повноти та якості даних не задовольнить потреби з урахуванням досягнень у сфері штучного інтелекту за останні роки. Коли штучний інтелект може виконувати за години те, що раніше займало місяці роботи команди, і робити це з вищою якістю при меншій вартості, вам потрібно використовувати ці знання для побудови нового фундаменту. Саме це ми зробили з компанією Aquila, зосередившись на сучасних інструментах, які знижують вартість підключення, щоб ми могли зосередитися на завершенні повної картини здоров’я, а не лише даних, отриманих з традиційних джерел ЕХІ.
Компанія Aquila нещодавно вийшла з режиму секретності з платформою, зосередженою на об’єднанні фрагментованої інформації охорони здоров’я у єдиний, готовий до штучного інтелекту шар. Які були основні технічні прориви, які зробили це можливим зараз, а не декілька років тому?
Спроможності штучного інтелекту майже повністю спонукали цей зсув.
Я провела роки, спостерігаючи, як кваліфіковані інженери вручну узгоджували стандарти даних, одне джерело за іншим. Це працювало, але така модель ніколи не зможе масштабуватися. Ви не можете найняти достатньо інженерів, щоб вийти з цього швидше, ніж обсяг і різноманітність даних, які генерує охорона здоров’я.
Що зараз відрізняється, так це те, що штучний інтелект може виконувати нормалізацію даних безперервно на рівні даних, коли інформація рухається через систему. Це не пакетний процес, який запускається вночі. Це відбувається майже в режимі реального часу. Це змінює те, що можливо для клініцистів та команд громадської охорони здоров’я, оскільки дані, які їм потрібні, структуровані та валідовані (зроблені корисними) до того, як вони до них доходять.
Клініцисти звикли приймати рішення без повної картини пацієнта. Громадська охорона здоров’я звикла керувати програмами без недавніх даних, які їх підтримують. Компанія Aquila змінює ландшафт і забезпечує швидкість, яка робить ефективне прийняття рішень на основі даних можливим у всій сфері охорони здоров’я.
Ми створили TREUE™ як структура, який організовує клінічні дані, отримані з ЕХР, лабораторні, громадські дані охорони здоров’я, дані страхування, фармацевтичні дані та соціальні дані в єдину структуру. Штучний інтелект не замінює хорошу управління даними; він робить хороше управління даними масштабованим вперше.
Ви підкреслили, що справжня проблема в штучному інтелекті охорони здоров’я полягає не в моделях, а в самих даних. Які найбільш критичні пробіли в сучасній інфраструктурі даних охорони здоров’я, які перешкоджають штучному інтелекту забезпечувати значимі результати?
Галузь говорить про модель штучного інтелекту, але модель не є складною частиною.
Складна частина полягає в тому, що пацієнт може увійти в три різні установи за один день і з’явитися як три різні люди в трьох різних системах. Лабораторні дані не збігаються з клінічними нотатками. Запис страховика має інший ідентифікатор, ніж госпітальний запис, а громадська охорона здоров’я використовує зовсім інший ідентифікатор. До того часу, як ви все це вирішите вручну, клінічне вікно вже закриється.
Сильні технічні з’єднання не можуть виправити записи, які надходять неповними або поза чергою. Штучний інтелект не може виявити закономірність, якої немає в даних, і не може надати надійну рекомендацію з запису, якому бракує половини історичної або поточної інформації, яку він повинен містити.
Пробіл полягає не в потужності обробки, а в довірі до основних даних. Саме це потрібно вирішити спочатку, а вирішення цього питання в масштабі – це місце, де штучний інтелект може справді зайняти своє місце.
Компанія Aquila позиціонує себе як “шар підготовки даних” перед споживанням штучним інтелектом. Можете роз’яснити, що цей шар робить на практиці, особливо при роботі з високогетерогенними входами, такими як клінічні записи, дані страхування та потокові дані?
Розглянемо приклад з попереднього разу. Коли пацієнтський контакт генерує дані, ви отримуєте повідомлення HL7 від госпіталю, запис страховика від страховика, лабораторний результат від лабораторії з використанням іншого ідентифікатора, і звіт громадської охорони здоров’я, поданий на зовсім іншій часової шкалі. Жодна з цих даних не була розроблена для узгодження одна з одною.
Наш шар підготовки даних, TREUE™, знаходиться між цими входами та будь-якими подальшими аналітичними або застосунками штучного інтелекту. Його завдання – оцінити кожен запис при надходженні, узгодити ідентифікатори між джерелами, нормалізувати формати та позначити, що відсутнє або нестійке, перш ніж дані рухатимуться далі.
На практиці це означає, що клініцист, який дивиться на пацієнта, працює з записом, який був валідований і узгоджений між джерелами, а не вручну узгоджує чотири різні системні погляди під час клінічного контакту. Для команд громадської охорони здоров’я це означає, що сигнали про спалахи не будуть затримані через дані, які надходять у різних форматах з різних юрисдикцій.
Це робота з інфраструктурою. Це не гламурно, але нічого подальшого не працює без цього.
Стандарти взаємодії, такі як Fast Healthcare Interoperability Resources (FHIR) і United States Core Data for Interoperability (USCDI), існують уже кілька років, проте фрагментація зберігається. Що все ще відсутнє з точки зору стандартів, і як компанія Aquila звертається до цих пробілів інакше?
FHIR і USCDI дали галузі спільну мову для обміну даними. Це був важливий прогрес.
Однак спільна мова для передачі даних не те саме, що дані, які поводяться послідовно після надходження. Ось пробіл: дані охорони здоров’я не походять з однієї галузі. Клінічні системи, реєстри громадської охорони здоров’я, лабораторії та джерела соціальних даних мають свої власні вимоги до управління даними, графіки та визначення того, що означає поле. FHIR не каже, як узгодити набір соціальних даних з клінічним записом з іншої юрисдикції.
Що TREUE™ додає, так це єдиний каркас для того, як дані з усіх цих галузей можуть бути організовані та валідовані разом, зберігаючи при цьому правила управління даними, які застосовуються до кожного джерела. Результатом є дані, які можна фактично аналізувати між галузями, а не лише дані, які були успішно передані.
Компанія Aquila працює в середовищах високих наслідків, де невдача не є варіантом. Як ви проектуєте системи штучного інтелекту, які балансують виконання в режимі реального часу з суворими вимогами щодо управління, аудитності та довіри?
Ви повинні будувати управління в архітектуру до того, як написати перший рядок коду застосунку. Воно не повинно бути шаром, який ви додаєте пізніше.
У середовищах охорони здоров’я та уряду рішення, які приймаються на основі цих даних, впливають на догляд за пацієнтами, реакцію на спалахи та те, як публічні ресурси розподіляються. Кожна дія, виконана з цими даними, повинна бути відстежуваною, а доступ повинен бути суворо контрольованим. Система повинна відповідати вимогам сумісності середовищ, у яких вона працює.
Для компанії Aquila це означає роботу в інфраструктурі урядового класу хмарних обчислень, контролі доступу з нульовим довірою та практиками безпеки, які відповідають стандартам HIPAA та федеральним стандартам. У нас є діючі контракти з державним урядом, федеральними агентствами та організаціями охорони здоров’я, і ці середовища мають різні вимоги сумісності, яким платформа повинна відповідати одночасно.
Компонент з людиною в циклі є právě так само важливим. Штучний інтелект може виявити сигнали, але клініцисти валідують аномалії перед тим, як вони інформують операційні рішення. Технологія робить пошук цих сигналів швидшим. Вона не замінює судження людей, які повинні діяти на основі цих сигналів.
Ваша платформа підтримує безпечне розгортання штучного інтелекту на пристрої та суверенітет даних. Наскільки важливим стає децентралізація в штучному інтелекті охорони здоров’я, особливо враховуючи зростаючі проблеми навколо конфіденційності даних та нормативної сумісності?
Це стає суттєвим, і я думаю, що галузь тільки починає розуміти, чому.
Організації охорони здоров’я працюють під суворими зобов’язаннями щодо конфіденційності. Чутливі дані пацієнтів не можуть бути просто централізовані та оброблені в спільному середовищі. Різні штати мають різні правила. Федеральні агентства мають різні правила. Міжнародні дані охорони здоров’я мають ще один набір обмежень. Будь-яка архітектура, яка вимагає переміщення чутливих даних у центральне місце, буде зіштовхуватися з цими бар’єрами повторно.
Напрям, який справді працює, полягає в генерації висновків ближче до місця, де дані вже живуть. Організації можуть вносити свій внесок у спільний аналіз без втрати контролю над своїми основними даними. Це саме те, що дозволяють федеративні моделі.
Наша платформа побудована для роботи в такому регульованому, децентралізованому середовищі – управління, яке рухається з даними, а не застосовується в одному місці. Це складніша архітектура для побудови, але це та, яка насправді сумісна з тим, як управління даними охорони здоров’я працює на практиці.
Багато стартапів штучного інтелекту сильно залежать від чорних скриньок моделей, проте компанія Aquila включає людську валідацию в цикл. Де ви бачите межу між автоматизацією та людським наглядом у клінічних системах штучного інтелекту?
Я почала свою кар’єру як медсестра. Це досвід формує моє розуміння того, де штучний інтелект належить у клінічному середовищі, і де він не належить.
Штучний інтелект дуже добре знаходить закономірності в великих наборах даних. Він не знає, що означає закономірність для конкретного пацієнта з конкретною історією в конкретному контексті спільноти. Це все ще людське судження.
Правильна роль штучного інтелекту в клінічних системах полягає в тому, щоб виявити сигнали, яких людина могла б пропустити в обсязі, а не замінити клінічне судження, яке слідує. У компанії Aquila аномалії та висновки, підкреслені системою, надсилаються клініцистам та експертам для огляду перед тим, як вони інформуватимуть операційні рішення. Технологія каже вам, де шукати, а професіонал каже вам, що це означає.
Де я думаю, що межа належить: автоматизувати виявлення, зберігати інтерпретацію з людьми, які відповідають за результат.
Компанія Aquila працює в громадській охороні здоров’я, урядових системах та регульованих галузях. Як відрізняються вимоги до інфраструктури штучного інтелекту між цими середовищами порівняно з традиційними корпоративними розгортаннями штучного інтелекту?
У типовому корпоративному розгортанні штучного інтелекту ви зазвичай працюєте в межах однієї організації, одного набору правил управління даними, одного каркаса сумісності.
Середовища громадської охорони здоров’я та уряду структуровані інакше. Ви координуєте між декількома юрисдикціями, декількома агентствами, клінічними середовищами, кожне з яких працює на різних часових шкалах звітності та під різними законодавчими рамками. Госпіталь в одному штаті, агентство громадської охорони здоров’я в іншому, федеральна програма зі своїми власними вимогами до даних. Всі ці учасники повинні обмінюватися даними та генерувати висновки без того, щоб одна з цих сутностей мала необмежений доступ до записів іншої.
Інфраструктура повинна підтримувати обробку великих обсягів даних, зберігаючи при цьому сувору аудитність через всі ці кордони. Вона повинна інтегруватися з форматами легасі охорони здоров’я, оскільки ці системи не зникнуть. І вона повинна працювати надійно в середовищах, де простій не лише бізнес-проблема, а проблема безпеки пацієнтів.
Ця складність є причиною, чому ми почали компанію Aquila з цих середовищ, а не традиційного корпоративного ринку. Якщо ви можете побудувати інфраструктуру, яка працює тут, вона працюватиме всюди.
Спроможності штучного інтелекту продовжують розвиватися швидше, ніж каркаси управління. Які обов’язки мають засновники та будівельники платформ щодо забезпечення того, щоб ці системи розгорталися етично та безпечно з дня один?
Я думаю, що обов’язок є простим, навіть якщо виконання його не є простим.
Якщо ви будуєте штучний інтелект, який впливає на клінічні рішення або результати громадської охорони здоров’я, ви не можете вважати управління тим, що ви будете робити в майбутньому. Воно повинно бути спроектовано з самого початку.
Що це означає на практиці, так це те, що кожна дія з цими даними повинна бути аудитною. Моделі повинні бути інтерпретованими достатньо, щоб клініцист міг зрозуміти, чому сигнал був підкреслений. Клініцисти повинні бути частиною процесу огляду, а не післяthought. І організація повинна бути чесною щодо того, що система може і не може надійно зробити.
Я провела свою кар’єру в середовищах, де невдачі даних мають реальні наслідки для реальних людей. Це формує моє розуміння цього. Спроможності розвиваються швидко, і відповідальність за те, як вони розгортаються, не повинна відставати. Засновники, які будують ці системи, повинні дотримуватися цього стандарту для себе, а не чекати, коли регулювання його впровадить.
Дякую за цікаву розмову. Читачам, які цікавляться дослідженням платформи та її підходом до інфраструктури даних охорони здоров’я, можна дізнатися більше, відвідавши Aquila Health.






