
Погляд Anderson
Редагування об’єктів за допомогою ШІ: Imagic від Google та Erase and Replace від Runway

 Додайте Unite.AI до бажаних джерел у Google

Ключові моментиImagic дообучує дифузійні моделі для дрібних редагувань об'єктів, на відміну від Erase…
Показати більше
- Imagic дообучує дифузійні моделі для дрібних редагувань об'єктів, на відміну від Erase and Replace від Runway, який лише замінює об'єкти.
- Erase and Replace від Runway швидко замінює об'єкти, але не може редагувати наявний вміст, лише замінювати його.
- Оптимізація Imagic для кожного зображення триває вісім хвилин на двох чіпах TPUV4, що обмежує її використанням через API.
Цього тижня з’явилися два нові, але протилежні за підходом алгоритми графіки на основі ШІ, що пропонують користувачам нові способи точно й ефективно змінювати окремі об’єкти на фотографіях.
Перший — Imagic від Google Research, розроблений спільно з Ізраїльським технологічним інститутом та Науковим інститутом Вейцмана. Imagic дає змогу редагувати об’єкти за текстовим описом із високою точністю за допомогою донавчання дифузійних моделей.

Змінюйте що забажаєте, а решту залишайте без змін — Imagic обіцяє точне редагування лише тих частин зображення, які потрібно змінити. Джерело: https://arxiv.org/pdf/2210.09276.pdf
Кожен, хто бодай раз намагався змінити лише один елемент у повторно згенерованому зображенні Stable Diffusion, добре знає: на кожне вдале редагування система змінює ще п’ять речей, які й так цілком влаштовували. Через цей недолік багато найталановитіших ентузіастів SD постійно перемикаються між Stable Diffusion і Photoshop, щоб виправляти такі «побічні пошкодження». Уже з цього погляду досягнення Imagic видаються вагомими.
На момент написання статті Imagic ще не має навіть рекламного відео, а з огляду на обережне ставлення Google до випуску необмежених інструментів синтезу зображень невідомо, чи матимемо ми взагалі нагоду протестувати цю систему і якою мірою.
Друга пропозиція — значно доступніша функція Erase and Replace від Runway ML, нова функція в розділі «AI Magic Tools» її суто онлайн-платформи інструментів візуальних ефектів на основі машинного навчання.
Функція Erase and Replace від Runway ML, яку вже демонстрували в попередній версії системи редагування відео за текстовим описом.
Спершу розгляньмо розробку Runway.
Erase and Replace
Як і Imagic, Erase and Replace працює лише зі статичними зображеннями, хоча Runway демонструвала ті самі можливості в рішенні для редагування відео за текстовим описом, яке ще не випущено:
Хоча спробувати нову функцію Erase and Replace на зображеннях може кожен, версія для відео поки що недоступна широкому загалу. Джерело: https://twitter.com/runwayml/status/1568220303808991232
Хоча Runway ML не розкрила подробиць про технології, що лежать в основі Erase and Replace, швидкість, із якою можна замінити кімнатну рослину на доволі переконливе погруддя Рональда Рейгана, свідчить, що об’єкт, вибраний користувачем у Erase and Replace, створює дифузійна модель на кшталт Stable Diffusion (або, що набагато менш імовірно, ліцензована версія DALL-E 2).

Замінити кімнатну рослину на погруддя Гіппера виходить не так миттєво, як тут, але все одно досить швидко. Джерело: https://app.runwayml.com/
У системі є обмеження, подібні до DALL-E 2: якщо зображення або текст активують фільтри Erase and Replace, з’являється попередження про можливе призупинення облікового запису в разі подальших порушень. Фактично це майже дослівна копія чинних правил OpenAI щодо DALL-E 2.
Багатьом результатам бракує характерних для Stable Diffusion грубих артефактів. Runway ML є інвестором і дослідницьким партнером SD, тож, можливо, компанія навчила власну модель, яка перевершує відкриті ваги контрольної версії 1.4, з якими нині працюємо ми (як і багато інших команд розробників — аматорських і професійних, — які зараз навчають або донавчають моделі Stable Diffusion).
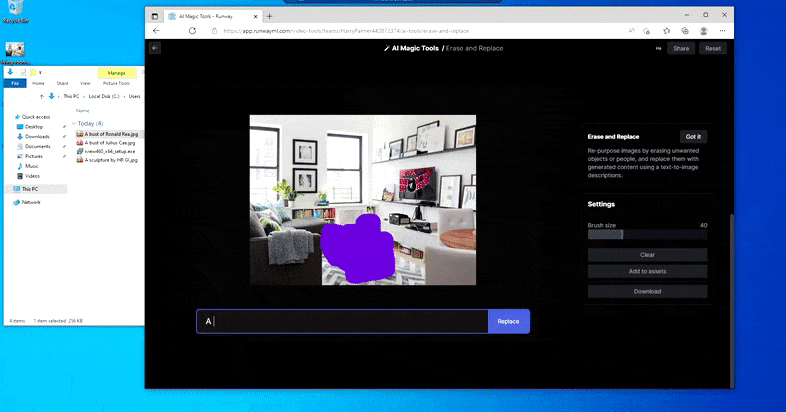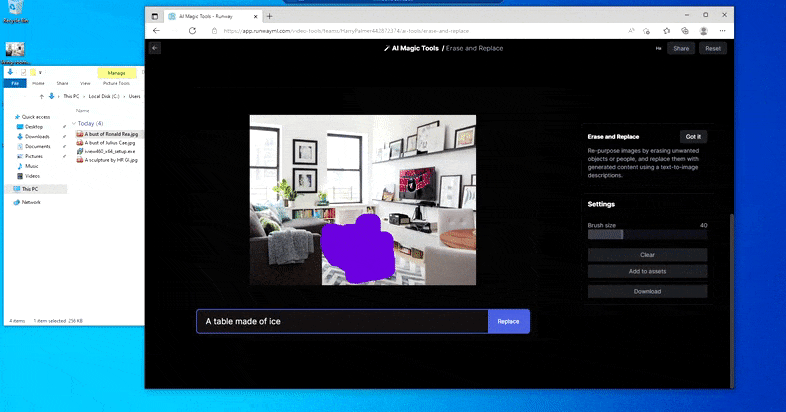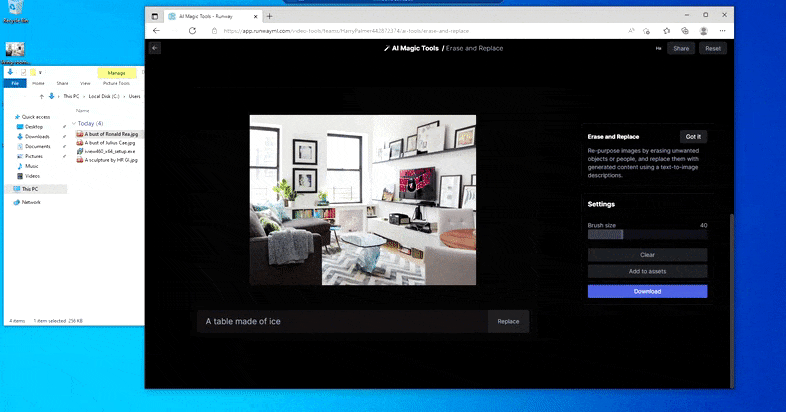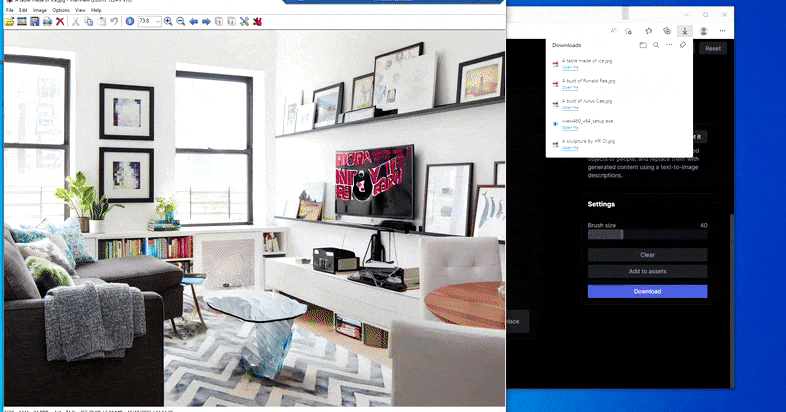
Заміна звичайного столу на «стіл із льоду» за допомогою Erase and Replace від Runway ML.
Як і Imagic (див. нижче), Erase and Replace працює, так би мовити, «з орієнтацією на об’єкти»: не можна просто стерти «порожню» ділянку зображення й заповнити її результатом текстового запиту. У такому разі система просто визначить найближчий видимий об’єкт уздовж напрямку погляду крізь маску (наприклад, стіну чи телевізор) і застосує перетворення до нього.
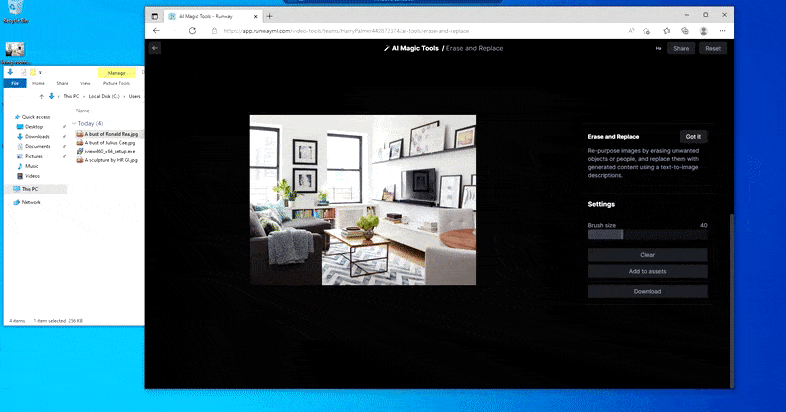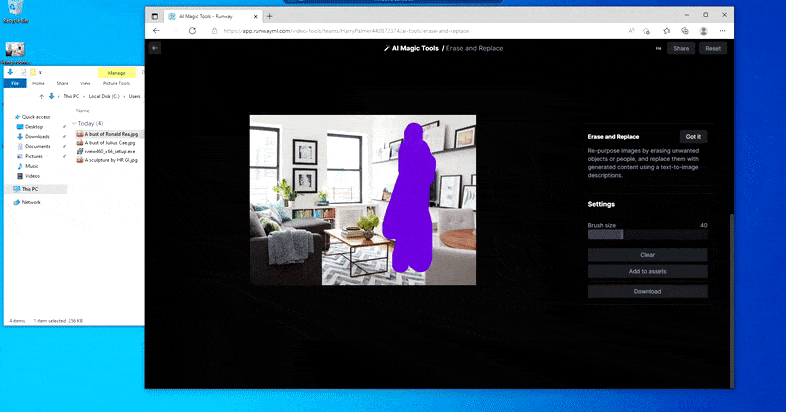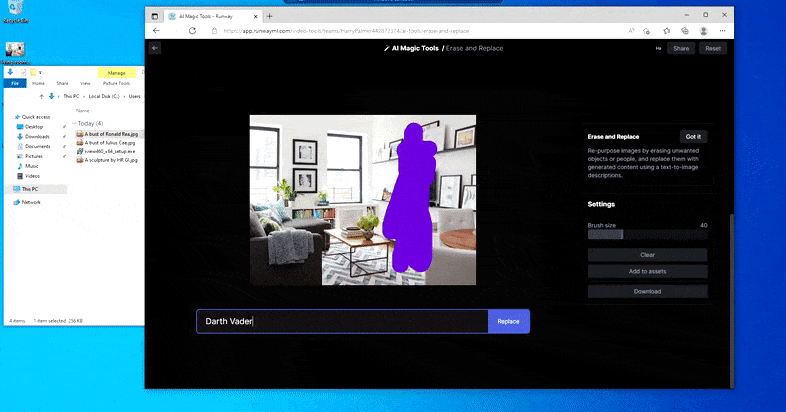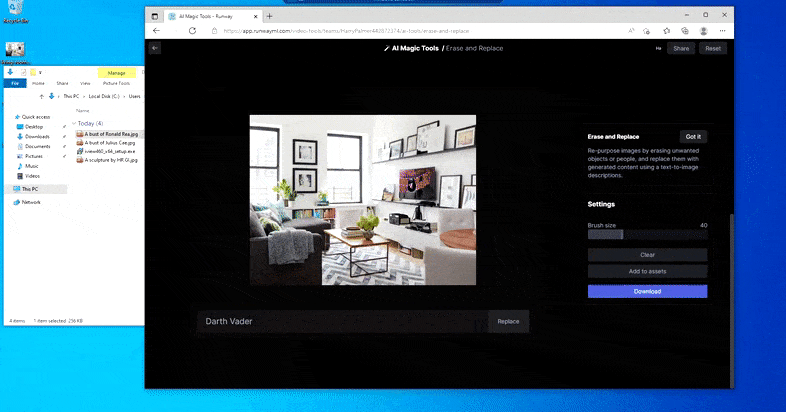
Як випливає з назви, у Erase and Replace не можна додавати об’єкти в порожній простір. Тут спроба викликати найвідомішого з лордів ситхів призводить до появи на телевізорі дивного муралу з Вейдером — приблизно там, де було позначено область для заміни.
Важко сказати, чи Erase and Replace ухиляється від використання зображень, захищених авторським правом (які в DALL-E 2 досі здебільшого блокуються, хоч і з різним успіхом), чи модель, що працює у фоновому рушії рендерингу, просто не оптимізована для таких завдань.

Дещо непристойний «мурал із Ніколь Кідман» свідчить, що ця (імовірно) дифузійна модель, на відміну від DALL-E 2 у минулому, систематично не відмовляється зображати реалістичні обличчя чи відвертий контент. Результати спроб відтворити захищені авторським правом твори варіюються від неоднозначних («ксеноморф») до безглуздих («Залізний трон»). Унизу праворуч вставлено вихідне зображення.
Було б цікаво дізнатися, які методи Erase and Replace використовує для виокремлення об’єктів, які може замінювати. Імовірно, зображення обробляється за допомогою певної похідної від CLIP, а окремі елементи розпізнаються за допомогою розпізнавання об’єктів і подальшої семантичної сегментації. У звичайній інсталяції Stable Diffusion жодна з цих операцій не працює й близько так само добре.
Та ніщо не ідеальне: іноді система, схоже, стирає об’єкт, але не замінює його, навіть коли (як ми бачили на зображенні вище) механізм рендерингу точно розуміє значення текстового запиту. У цьому випадку перетворити журнальний столик на ксеноморфа виявляється неможливо: стіл просто зникає.
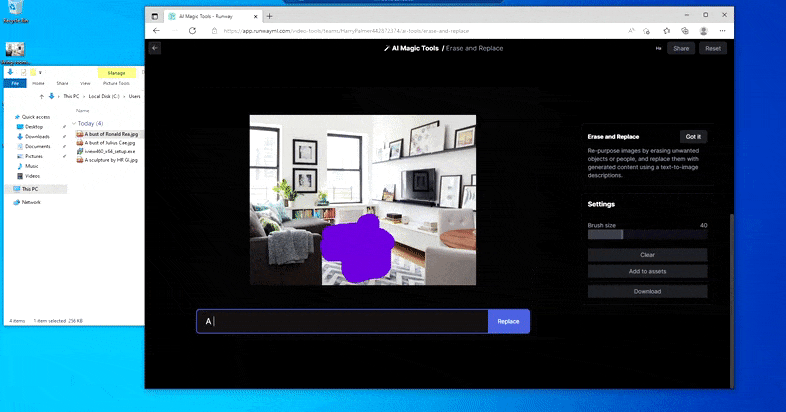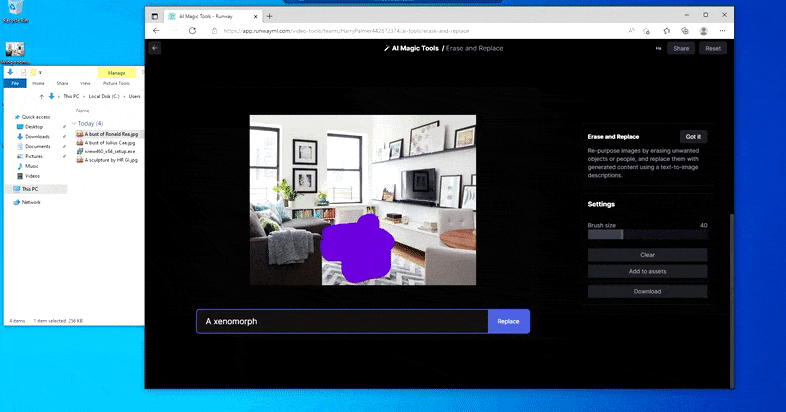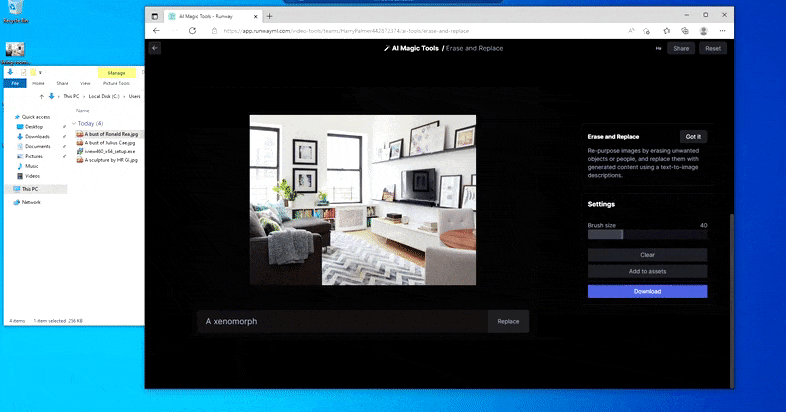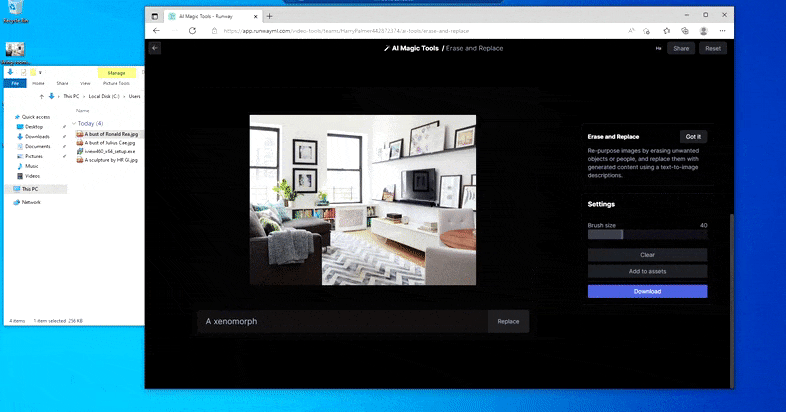
Страшніша версія гри «Де Волдо?»: Erase and Replace не може створити прибульця.
Erase and Replace видається ефективною системою заміни об’єктів із чудовим заповненням ділянок зображення. Однак вона не може редагувати вже розпізнані об’єкти, а лише замінювати їх. Змінити наявний вміст зображення, не порушивши цілісності навколишніх елементів, — імовірно, значно складніше завдання, пов’язане з тривалими зусиллями дослідників комп’ютерного зору, спрямованими на розділення латентних факторів у різних латентних просторах популярних фреймворків.
Imagic
Саме це завдання розв’язує Imagic. У новій статті наведено численні приклади редагування, за якого успішно змінюються окремі елементи фотографії, а решта зображення залишається недоторканою.

В Imagic відредаговані зображення не мають характерних для дипфейкової анімації розтягувань, спотворень і «домислювання перекритих ділянок», адже така анімація спирається на обмежену кількість апріорних даних, отриманих з одного зображення.
Система працює у три етапи: оптимізація текстового вбудовування, донавчання моделі й, нарешті, створення відредагованого зображення.

Imagic кодує цільовий текстовий запит, щоб отримати початкове текстове вбудовування, а потім оптимізує результат, аби відтворити вхідне зображення. Після цього генеративну модель донавчають на вихідному зображенні, додаючи низку параметрів, а тоді застосовують до неї запитану інтерполяцію.
Не дивно, що фреймворк побудовано на основі архітектури перетворення тексту на відео Imagen від Google, хоча дослідники зазначають, що принципи роботи системи можна широко застосовувати до моделей латентної дифузії.
Imagen використовує трирівневу архітектуру, а не семирівневу схему, застосовану в новішій версії програмного забезпечення для перетворення тексту на відео від компанії. Три окремі модулі складаються з генеративної дифузійної моделі, що працює з роздільною здатністю 64x64px; моделі надвисокої роздільної здатності, яка масштабує результат до 256x256px; і ще однієї такої моделі, що збільшує роздільну здатність результату аж до 1024×1024.
Imagic втручається на найпершому етапі цього процесу: оптимізує потрібне текстове вбудовування на етапі 64px за допомогою оптимізатора Adam із фіксованою швидкістю навчання 0.0001.

Майстер-клас із розділення латентних факторів: кінцеві користувачі, які намагалися змінити в дифузійній моделі, GAN або NeRF бодай такий простий параметр, як колір зображеного об’єкта, знають, наскільки важливо, що Imagic дає змогу виконувати такі перетворення, не «руйнуючи» цілісність решти зображення.
Потім базову модель Imagen донавчають протягом 1500 кроків для кожного вхідного зображення, використовуючи скориговане вбудовування як умову. Водночас паралельно оптимізують другий шар 64px>256px на зображенні, заданому як умова. Дослідники зазначають, що подібна оптимізація останнього шару 256px>1024px «майже не впливає або зовсім не впливає» на кінцеві результати, тому її не реалізували.
У статті зазначено, що процес оптимізації займає приблизно вісім хвилин на кожне зображення на двох чипах TPUV4. Фінальне зображення генерується в основній моделі Imagen за схемою вибірки DDIM.
Як і в подібних процесах донавчання для DreamBooth від Google, отримані вбудовування можна також використовувати для стилізації та фотореалістичного редагування із залученням інформації з ширшої бази даних, на якій працює Imagen (адже, як видно з першого стовпця нижче, у вихідних зображеннях немає потрібного вмісту для таких перетворень).

За допомогою Imagic можна створювати фотореалістичні рухи й редагувати зображення з великою гнучкістю, а похідні розділені коди, отримані в процесі, так само легко використовувати для створення стилізованих зображень.
Дослідники порівняли Imagic із попередніми роботами: SDEdit — підходом на основі GAN, представленим у 2021 році в межах співпраці Стенфордського університету та Університету Карнегі-Меллона; і Text2Live — спільною розробкою Наукового інституту Вейцмана та NVIDIA, представленою у квітні 2022 року.

Візуальне порівняння Imagic, SDEdit і Text2Live.
Очевидно, що попередні підходи дають збій, але в нижньому рядку, де потрібно суттєво змінити позу, наявні методи взагалі не можуть переосмислити вихідне зображення, тоді як Imagic демонструє помітний успіх.
Хоча вимоги Imagic до ресурсів і час навчання для кожного зображення невеликі за мірками подібних завдань, навряд чи цю систему інтегрують у локальні програми для редагування зображень на персональних комп’ютерах. Крім того, незрозуміло, наскільки можна скоротити процес донавчання, щоб він відповідав можливостям споживчих пристроїв.
У нинішньому вигляді Imagic — вражаюче рішення, яке краще підходить для API. Це середовище Google Research, можливо, і так найбільше до вподоби, адже компанія остерігається критики за сприяння створенню діпфейків.
Уперше опубліковано 18 жовтня 2022 року.


