Yapay zeka temelleri
Aşırı Uyum Nedir?

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
Aşırı Uyum bir modelin eğitim verisindeki desenleri ya da gürültüyü çok iyi yakalayıp yeni örneklerde genelleme yapamaması durumudur. Aşırı uyumlu bir model çok düşük eğitim hatasına sahip olabilir, ancak doğrulama ya da gerçek dünya performansı önemli ölçüde daha kötü olur.
Karşıt sorun az uyum: model ya da eğitim süreci, eğitim kümesinde bile sinyalin yeterince yakalanamamasıdır. İyi modelleme, mükemmel eğitim performansını hedeflemek yerine uyum ile genelleme arasında denge kurar.
Anahtar Çıkarımlar
- Eğitim performansı tek başına genelleme durumunu teşhis edemez.
- Erken durdurma, doğrulama davranışına dayanmalı, kesin test seti üzerinde tekrarlanan kararlar alınmamalıdır.
- Daha fazla veri yardımcı olabilir, ancak daha fazla özellik ya da kapasite aşırı uyumu da artırabilir.
- Düzenleme, artırma, çapraz doğrulama, sızıntı önleme ve uygun değerlendirme farklı nedenleri ele alır.
Uyum, az uyum ve aşırı uyum
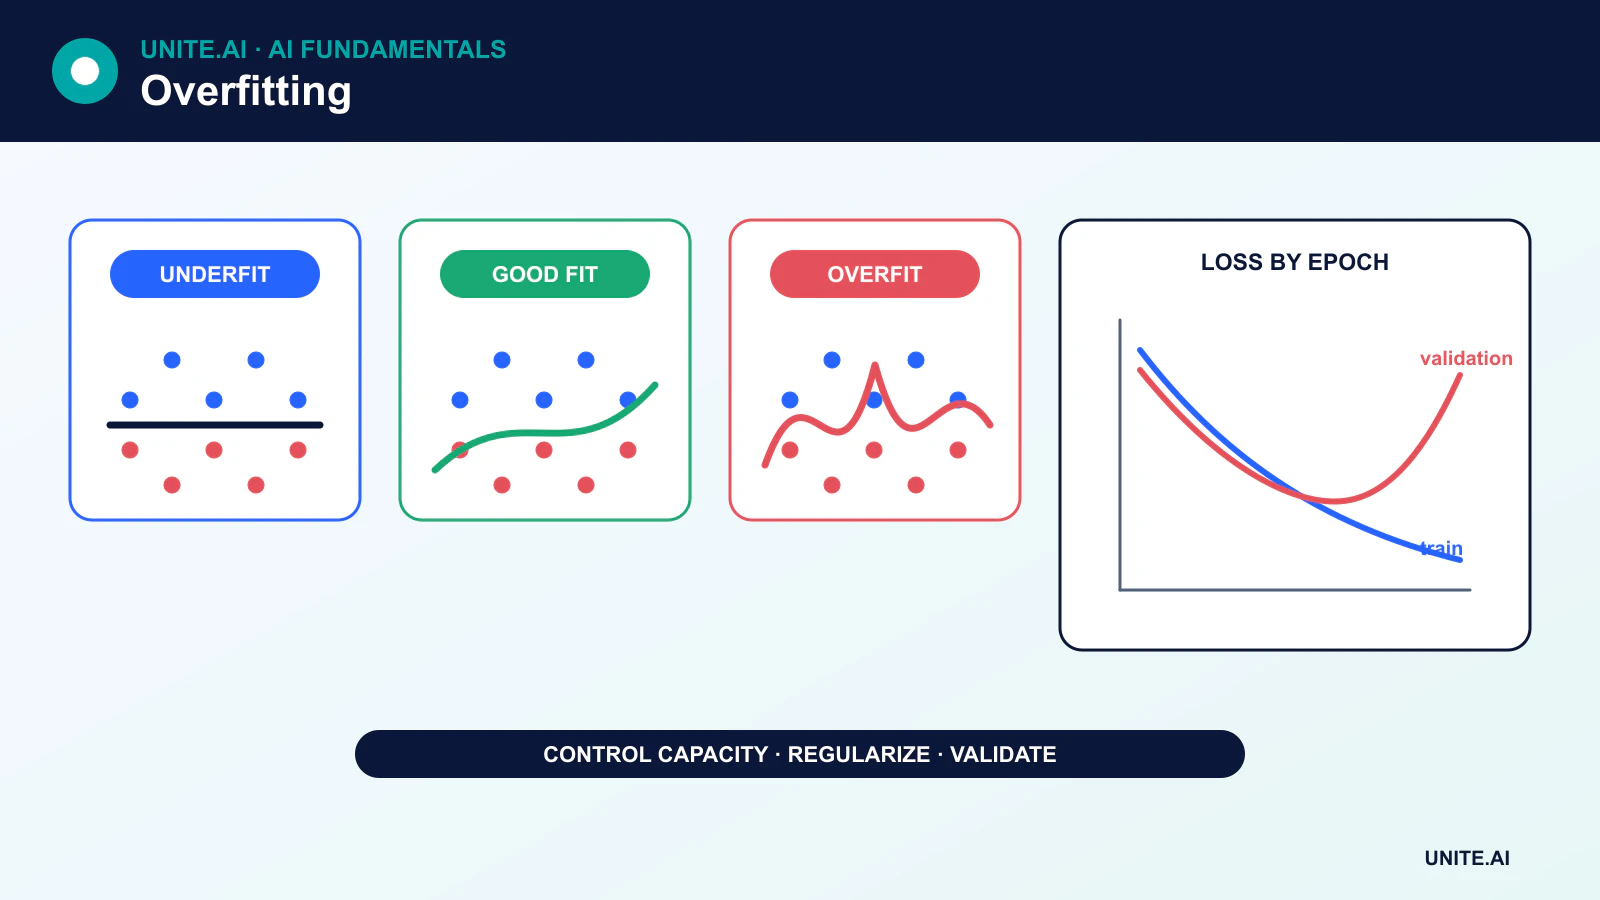
Bir model, varsayımları çok kısıtlayıcı olduğunda, özellikleri önemli sinyali atladığında, optimizasyon yetersiz olduğunda ya da eğitim yetersiz olduğunda az uyum gösterir. İlgili özellikler ya da kapasite eklemek yardımcı olabilir, fakat rastgele özellik eklemek gürültüyü ve aşırı uyumu artırabilir.
Bir model, etkili kapasitesi eğitim verisindeki bilgiye göre çok yüksek olduğunda aşırı uyum gösterir. Örnekler arasında çok derin karar ağacı (küçük yapraklar oluşturan), rastgele dalgalanmaları takip eden bir polinom veya örnekleri ezberleyen bir sinir ağı bulunur.
Eğitim, doğrulama ve test verilerinin rolü
- Eğitim verileri model parametrelerini uyarlar.
- Doğrulama verileri mimari, hiperparametreler, eşikler ve durdurma zamanını seçer.
- Test verileri bu seçimler tamamlandıktan sonra son bir tahmin sağlar.
Eğer test seti tekrarlı olarak kararları yönlendirirse, geliştirme sürecinin bir parçası hâline gelir ve artık tarafsız bir son tahmin sağlamaz. Çapraz doğrulama, sınırlı veriyi daha verimli kullanabilir, ancak tüm ön işleme ve özellik seçimi her bir eğitim katlaması içinde gerçekleşmelidir.
Erken Durdurma
Eğitim sırasında, eğitim kaybı genellikle düşmeye devam eder. Doğrulama kaybı başlangıçta düşebilir, ancak model eğitim gürültüsüne özelleştikçe sonradan artabilir. Erken durdurma, en iyi doğrulama hedefiyle checkpoint’i kaydeder ya da doğrulama belirli bir sabır süresi boyunca iyileşme göstermediğinde durur.
Doğru checkpoint, en düşük eğitim kaybına sahip olanı değildir. Erken durdurma ve ayarlama kararları tamamlandıktan sonra ayrı bir son test seti değerlendirilir.
Düzenleme Yöntemleri
Ağırlık Cezaları
L2 düzenleme ya da ağırlık çürümesi, büyük parametre değerlerini caydırır. L1 düzenleme, seyrek katsayıları teşvik edebilir. Etkileri model ve optimizöre bağlıdır; örneğin AdamW, ağırlık çürümesini uyarlanabilir güncellemelerden ayırır.
Dropout ve Stokastik Düzenleme
Dropout, eğitim sırasında aktivasyonları rastgele maskeleyerek çalışır. Diğer yöntemler yolları düşürür, özellikleri pertürbe eder ya da etiketleri yumuşatır. Bu teknikler eğitim hedefini değiştirir ve çıkarım sırasında devre dışı bırakılmalı ya da uygun şekilde ele alınmalıdır.
Veri Artırma
Artırma, hedefi koruması gereken, kırpma, döndürme, gürültü ya da eş‑anlamlı ifadeler gibi gerçekçi varyasyonlar oluşturur. Geçersiz dönüşümler etiketi değiştirebilir ve modeli zarar görebilir. Görüntü için Albumentations gibi araçlar, kontrollü akışlar oluşturmayı kolaylaştırır.
Kapasite Kontrolü
Daha sığ ağaçlar, daha az parametre, özellik seçimi, budama ve daha basit hipotez sınıfları varyansı azaltabilir. Ağaç budaması, ölçüte dayalıdır; öğrenilen detayların rastgele kaldırılması değildir.
Veri Sızıntısı Olağanüstü Performans Gibi Görünebilir
Sızıntı, tahmin zamanında mevcut olmayan bilginin eğitim ya da değerlendirmeye girmesiyle ortaya çıkar. Yaygın örnekler arasında tüm veri kümesi üzerinde normalizasyonun uygulanması, tekrarlanan kayıtların katlamalar arasında bölünmesi, gelecekteki verinin geçmişi tahmin etmesi ya da hedeften türetilen bir özelliğin dahil edilmesi yer alır.
Sızıntı, sıradan aşırı uyum değildir, ancak çevrim dışı sonuçlar ile üretim arasındaki aynı yanıltıcı boşluğu yaratır. Bölme stratejisi zaman, kimlik, konum ve veri üretim süreçlerine saygı göstermelidir.
Dağıtım Kayması Ayrı Bir Sorundur
Bir model, test dağılımına genelleyebilir, ancak üretim verileri değiştiğinde yine başarısız olabilir. Yeni cihazlar, politikalar, nüfuslar, mevsimler veya adversarial davranışlar giriş‑hedef ilişkisini kaydırabilir. İzleme ve periyodik yeniden değerlendirme, orijinal model aşırı uyumlu olmasa bile gereklidir.
Aşırı Uyum Tanılama
Öğrenme eğrileri, çapraz doğrulama varyansı, alt grup metrikleri, kalibrasyon ve hata incelemesi kullanın. Eğitim ve doğrulama performansı ikisi de düşükse, az uyuma, özelliklere, etiketlere ya da optimizasyona odaklanın. Eğitim güçlü, doğrulama zayıfsa, daha fazla veri toplamadan önce kapasite, sızıntı, düzenleme ve temsiliyet üzerinde araştırma yapın.
Aşırı Uyumun Nedenleri ve Nasıl Tespit Edilir
Aşırı uyum, bir modelin eğitim hatasını azaltan fakat hedef popülasyona genellenemeyen desenler öğrenmesi durumunda ortaya çıkar. Nedenler arasında, etkili veri miktarına göre aşırı kapasite, etiket gürültüsü, tekrarlanan varlıklar, esnek özellik seçimi, sızıntı ve aynı doğrulama setine karşı ayarlama bulunur. Eğitim ve doğrulama performansı arasındaki genişleyen boşluk yaygın bir kanıttır, ancak iki set de kontamine olmuş ya da dağıtımda farklıysa, küçük bir boşluk aşırı uyumu dışlamaz. Veri miktarı ve kapasiteye göre öğrenme eğrileri varyans ile önyargıyı ayırt etmeye yardımcı olur.
Sızıntı özellikle aldatıcıdır: gelecek bilgiler, kopyalar, konu çakışması, tüm veriye uygulanmış ön işleme veya meta veride kodlanmış etiketler mükemmel tutulan puanlar üretebilir. Dağıtıma yeni gelecek birim (hasta, müşteri, makine, konum veya zaman) baz alınarak bölünmeli; dönüşümler ya da artırmalar uygulanmadan önce. Özellikleri, mimariyi ve eşikleri seçerken son test seti mühürlü tutulmalı. Ekipler test sonuçlarını tekrarlı olarak incelerse, test seti başka bir doğrulama seti hâline gelir ve değiştirme ya da resmi düzeltme gerekir.
Düzenleme, Model Seçimi ve Üretim Kayması
Daha temsili veri, daha düşük kapasite, ağırlık çürümesi, dropout, erken durdurma, artırma, topluluk oluşturma veya alan yapısını yansıtan kısıtlamalarla aşırı uyumu azaltın. Her yöntemin artıları ve eksileri vardır: artırma etiketleri bozabilir, dropout optimizasyonu değiştirir ve topluluklar hizmet maliyetini artırır. Çapraz doğrulama seçim değişkenliğini tahmin eder, ancak gruplanmış ya da zaman‑farklı katlamalar dağıtım sınırını korumalıdır. Basit bir model ile karşılaştırın ve en uygun çalıştırmayı seçmek yerine katlamalar ya da tohumlar arasındaki belirsizliği raporlayın.
Üretim, girişler, kullanıcılar, teşvikler veya ölçüm değiştiğinde farklı bir genelleme hatasını ortaya çıkarabilir. Özellik ve tahmin dağılımlarını, kalibrasyonu, alt grup sonuçlarını ve gecikmiş gerçek sonuçları izleyin. Gözden geçirilmemiş geri bildirim üzerine otomatik yeniden eğitim yapmayın; modelin kendi kararları daha sonra gördüğü etiketleri şekillendirebilir. Hatanın kayma, veri boru hatları, politika değişiklikleri ya da geçersiz bir hedeften kaynaklanıp kaynaklanmadığını tanılayın. Aşırı uyum, tek bir düzenleme ayarından değil, deney tasarımı ve yaşam döngüsü disiplininden kontrol edilir.
Uygulamalı Örnek: Dolandırıcılık Modelinde Sızıntıyı Ortadan Kaldırma
İlk dolandırıcılık sınıflandırıcısı, tekrarlanan kart ve satıcı olayları rastgele eğitim ve test satırlarında göründüğü ve haftalar sonra kaydedilen chargeback bilgilerinin özellik olarak dahil edildiği için çok yüksek puan alır. Ekip, her bir özelliğin kullanılabilirlik zamanını yeniden oluşturur, karar sonrası alanları kaldırır, hesabı temel alarak gruplar ve ileri zaman bölmesi kullanır. Performans keskin bir düşüş gösterir, ancak artık gerçek kararı tahmin eder. Basit bir kural temel çizgisi ve öğrenme eğrileri, gereken model karmaşıklığını yönlendirir.
Düzenleme ve erken durdurma yalnızca tarihsel katlamalar içinde ayarlanır. Son değerlendirme, inceleme kapasitesindeki kesinliği, geri çağırma, kalibrasyon ve dolandırıcılık türü ile müşteri segmentine göre maliyeti raporlar. Üretimde, onaylı etiketler geç gelir ve hangi işlemlerin incelendiğine göre yanlıdır; bu yüzden izleme, skor kaymasını sonuç tahminlerinden ayırır. Yeniden eğitim, karar verilen vakaları ve mevcut politika karşısında tekrarlamayı kullanır. Proje, dağıtımda ayakta kalamayan yüksek sızdırılmış bir skordan ziyade daha düşük, dürüst bir skoru tercih eder.
Uygulama Kanıtları ve Operasyonel Hazırlık
Üretim kararı, yalnızca başarılı bir gösterimden fazlasını gerektirir. Hedef kullanıcıları, çalışma ortamını, girişleri, çıktıları, bağımlılıkları, sorumluyu ve her önemli hatanın sonucunu tanımlayın. Ayarlamadan önce tekrarlanabilir bir temel çizgi ve sürümlenmiş bir değerlendirme seti oluşturun. Normal vakaları, sınır koşullarını, hatalı ya da eksik girdileri, dağıtım kaymasını, bağımlılık arızalarını, yanlış kullanımı ve hizmet dışı kalma olasılığı yüksek grup ya da ortamları test edin. Görev kalitesini kalibrasyon ya da belirsizlik, gecikme, verim, kaynak maliyeti, erişilebilirlik, gizlilik ve güvenlikle birlikte ölçün. Bağımsız bir gözden geçiricinin sonucu yeniden üretebilmesi ve kanıtı çekici bir prototipten ayırabilmesi için her dönüşümü ve eşiği kaydedin.
Yayına almadan önce, sürüm, istisnalar, değişiklikler, geri dönüş ve emeklilik için sorumluluk atayın. Aşamalı bir dağıtım kullanın, güvenli bir geri dönüş mekanizması koruyun ve kasıtlı olarak eklenen hatalarla izlemeyi doğrulayın. Operasyonel telemetri, giriş kalitesini, çıkış davranışını, model ya da kural sürümünü, bağımlılık sağlığını, insan müdahalelerini ve gereksiz hassas veri toplamadan onaylı sonuçları göstermelidir. Uyarı eşiklerini ve bir yanıt sorumlusunu tanımlayın, ardından çevrim dışı performansın süreceğini varsaymak yerine dağıtımdan sonraki gerçek dünya kanıtlarını inceleyin. Veri kaynakları, kullanıcılar, modeller, satıcılar, politikalar, donanım ya da hedefler değiştiğinde yeniden değerlendirin. Bakımlı bir sistem ayrıca belgelenmiş bir kurtarma prosedürü, olay öğrenimi, silme ve saklama süreçleri ve sistemin devre dışı bırakılması ya da değiştirilmesi gerektiği net bir noktaya da ihtiyaç duyar.
Sıkça Sorulan Sorular
Basit bir model aşırı uyum gösterebilir mi?
Evet. Tekrarlanan özellik seçimi, eşik ayarı veya aynı tutma seti üzerinde değerlendirme, nihai model basit olsa bile geliştirme sürecini aşırı uyumlu hâle getirebilir.
Daha fazla eğitim verisi her zaman aşırı uyumu çözer mi?
Hayır. Daha temsili, doğru etiketlenmiş veri yardımcı olabilir, fakat çoğaltılmış, yanlı, sızdırılmış ya da alandışı veri yardımcı olmayabilir. Öğrenme hedefi ve değerlendirme tasarımı hâlâ önemlidir.
Temel Referanslar