
Yapay zeka temelleri
Makine Öğrenmesi Nedir?

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
Makine öğrenmesi (ML), bir sistemin veriden desenler öğrenerek tahminler, sınıflandırmalar, öneriler veya kararlar verebildiği, geliştiricinin her olası durum için ayrı bir kural yazmasına gerek kalmayan bir yapay zeka dalıdır. Sonuç, bir insan gibi “düşünen” bir makine değildir. Girişleri yararlı çıktılara eşleyen ve eğitim sırasında görmediği veriler üzerinde değerlendirilebilen istatistiksel bir modeldir.
Makine öğrenmesi, daha geniş AI alanının içinde yer alırken, derin öğrenme, çok katmanlı sinir ağları etrafında inşa edilen bir makine‑öğrenmesi yöntemleri ailesidir. Bu ayrım önemlidir: her AI sistemi ML kullanmaz ve her ML problemi bir sinir ağı gerektirmez.
Temel Çıkarımlar
- ML, yalnızca el ile yazılmış kurallara dayanmak yerine örneklerden bir ilişki öğrenir.
- Kullanışlı bir model, yalnızca eğitim kümesini ezberlemek yerine yeni verilere genelleme yapabilmelidir.
- Denetimli, denetimsiz, yarı‑denetimli, kendi‑kendine denetimli ve pekiştirmeli öğrenme farklı türde problemleri çözer.
- Veri kalitesi, değerlendirme tasarımı ve izleme, algoritma kadar önemlidir.
Makine Öğrenmesi Nasıl Çalışır
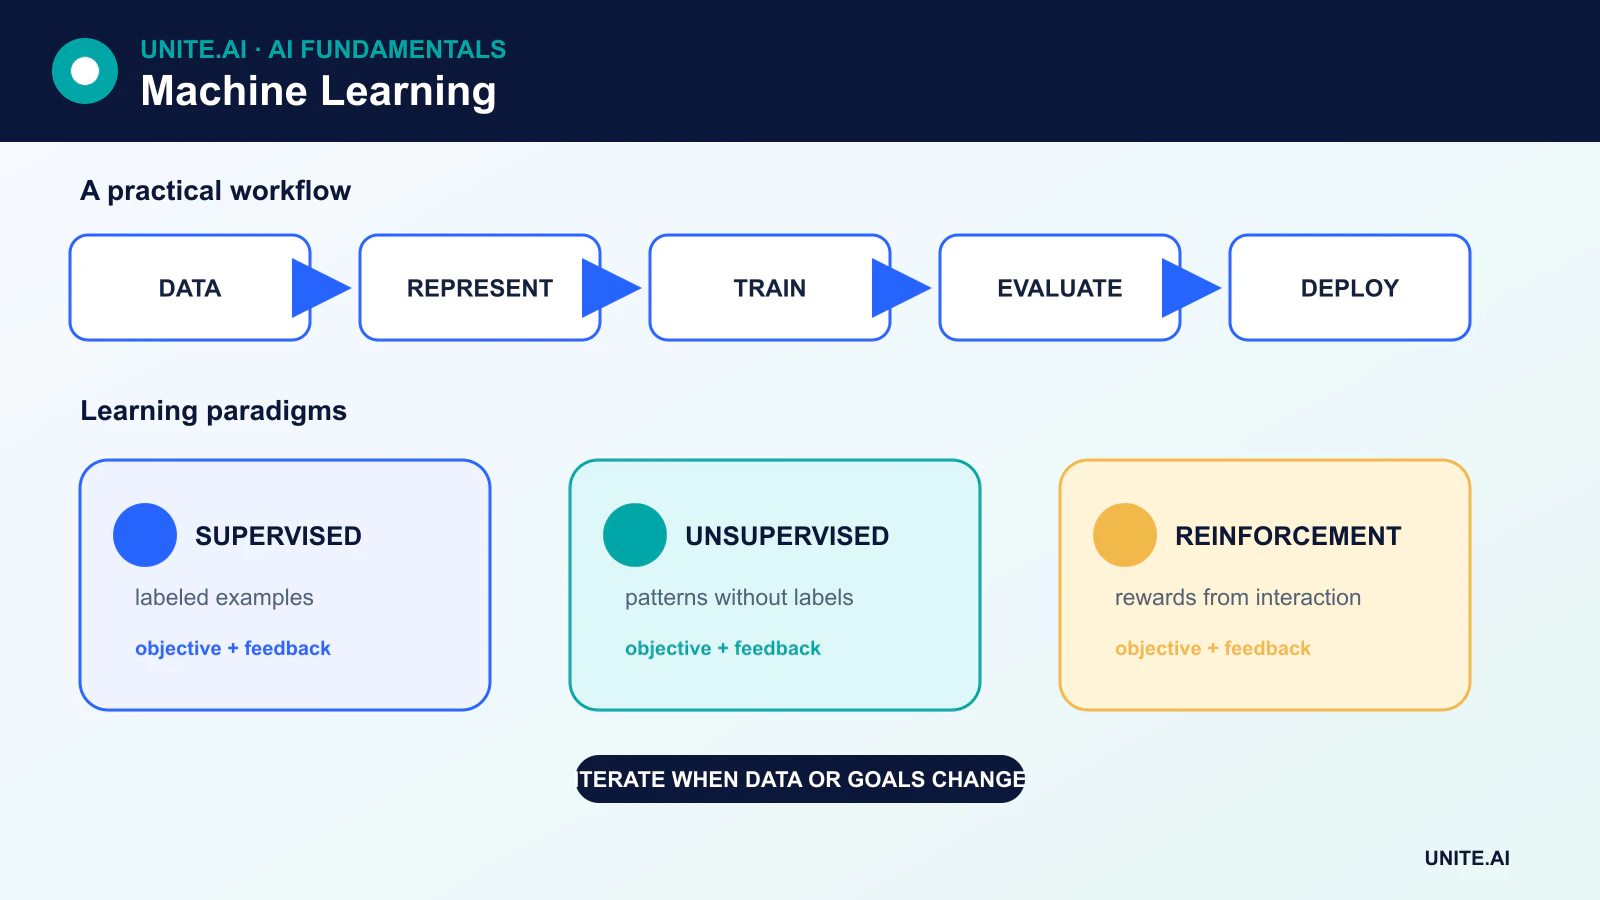
Çoğu ML projesi altı aşamadan oluşan bir sıralama olarak anlaşılabilir:
- Görevi Tanımla. Sisteminin neyi tahmin etmesi veya keşfetmesi gerektiğini ve gerçek uygulamada başarının ne anlama geldiğini belirleyin.
- Verileri Topla ve Hazırla. Kayıtları temizleyin, eksik değerleri yönetin, faydalı özellikler oluşturun ve verinin kaynağını belgeleyin.
- Veriyi Böl. Bir eğitim seti modeli uyarlamak için, bir doğrulama seti ayarları seçmeye yardımcı olmak için ve bir test seti dokunulmamış veri üzerindeki son tahmini sağlamak için kullanılır.
- Modeli Eğit. Bir algoritma, kayıp fonksiyonunu azaltmak veya başka bir öğrenme hedefini karşılamak için model parametrelerini ayarlar.
- Genelleşmeyi Değerlendir. Metrikler, görevi, sınıf dengesini, hata maliyetlerini ve modelin çalışacağı popülasyonu yansıtmalıdır.
- Dağıt ve İzle. Gerçek dünyadaki veriler değişebilir, bu yüzden ekipler kayma, performans düşüşü, önyargı ve operasyonel hataları izler.
Bir modele sağlanan değişkenlere genellikle özellikler denir. Denetimli öğrenmede, istenen yanıt etiket ya da hedef olarak adlandırılır. Modelin öğrenmiş parametreleri, özellikler ile çıktılar arasındaki ilişkiyi kodlar; bunlar açık kuralların bir veri tabanı değildir.
Ana Öğrenme Paradigmaları
Denetimli Öğrenme
Denetimli öğrenmede, örnekler hem girdileri hem de bilinen hedefleri içerir. Bir sınıflandırma modeli, bir işlemin sahte olup olmadığı gibi kategorileri tahmin eder. Bir regresyon modeli, beklenen enerji talebi gibi sürekli bir değeri tahmin eder.
Yaygın denetimli algoritmalar arasında karar ağaçları, destek vektör makineleri, K‑en yakın komşu, doğrusal ve lojistik regresyon, gradyan artırmalı ağaçlar ve sinir ağları bulunur. 0.5 gibi bir sınıflandırma eşiği, model bir skor ya da olasılık ürettikten sonra seçilen bir karardır; bu, lojistik regresyonun değişmez bir özelliği değildir.
Denetimsiz Öğrenme
Denetimsiz öğrenme, hedef etiketleri içermeyen verilerle çalışır. Amaç, kümeler bulmak, olağandışı gözlemleri tespit etmek, bir dağılımı tahmin etmek veya daha düşük boyutlu bir temsil yaratmak olabilir. Bir küme, benzerlik kuralı tarafından önerilen bir grupdur; otomatik olarak anlamlı bir gerçek‑dünya sınıfı değildir.
Örnekler arasında K‑ortalama kümeleme, temel bileşen analizi, yoğunluk tahmini ve bazı otomatik kodlayıcı biçimleri bulunur. Bir otomatik kodlayıcı, sıkıştırılmış bir temsil aracılığıyla girdisini yeniden oluşturmayı öğrenir. Bu, otomatik olarak gerçek etiketler oluşturmaz.
Yarı‑Denetimli ve Kendi‑Kendine Denetimli Öğrenme
Yarı‑denetimli öğrenme, küçük bir etiketli veri kümesini daha büyük bir etiketsiz veri kümesiyle birleştirir. Kendi‑kendine denetimli öğrenme verinin kendisinden bir eğitim sinyali üretir; örneğin, maskelenmiş kelimeleri tahmin etmek ya da aynı görüntünün iki dönüştürülmüş görünümünü eşleştirmek gibi. Kendi‑kendine denetim, büyük metin, görüntü, ses veya video koleksiyonlarını her bir örnek insan tarafından etiketlenmeden kullanabildiği için modern transformer ve temel‑model boru hatlarının merkezindedir.
Pekiştirmeli Öğrenme
Pekiştirmeli öğrenmede, bir ajan bir ortamda eylemler gerçekleştirir ve ödül ya da maliyet alır. Amaç, beklenen toplam ödülü maksimize eden bir politika öğrenmektir. Bu, her durum için doğru eylemin sağlanmadığı ve bir eylemin ajanın bir sonraki karşılaştığı veriyi etkileyebileceği için denetimli öğrenmeden farklıdır.
Eğitim, Doğrulama ve Genelleşme
Eğitim örneklerinde iyi performans gösteren bir model, yeni verilerde yine başarısız olabilir. Bu başarısızlık, aşırı uyum (overfitting) olarak adlandırılır. Ekipler, uygun model kapasitesi, düzenleme, çapraz doğrulama, veri artırma, veri sızıntısını önleme ve gerçekten bağımsız bir test seti kullanarak bunu azaltır.
Her ML görevi için tek bir metrik yoktur. Sınıflandırma, ham doğruluk yerine kesinlik, duyarlılık, F1, kalibrasyon ya da maliyet‑ağırlıklı bir ölçüt gerektirebilir. Regresyon, ortalama mutlak hata, kök ortalama kare hatası veya alan‑spesifik bir kayıp kullanabilir. Kümeleme, içsel ya da dışsal doğrulamalı farklı değerlendirme biçimlerine ihtiyaç duyar. Metriğin, hatanın kullanıcı ya da organizasyon için ne anlama geldiğini yansıtması gerekir.
Makine Öğrenmesi Algoritmaları Araçtır, Garanti Değildir
Bir algoritma varsayımları taşır. Doğrusal modeller, belirli bir ilişki biçimini varsayar. K‑en yakın komşu, seçilen mesafenin anlamlı bir benzerliği temsil ettiğini varsayar. Naïve Bayes, özelliklerin sınıf verildiğinde koşullu bağımsız olduğunu varsayar. Karar ağaçları, öğrenilen bölme kurallarıyla özellik uzayını bölerek, yapraklarında her bir gözlem yerine eğitim gözlemlerinin gruplarına dayalı tahminler bulundurur.
Bu nedenle model seçimi, veri büyüklüğü, özellik tipleri, gecikme gereksinimleri, yorumlanabilirlik ihtiyacı ve hata maliyetine bağlıdır. Veri sınırlı olduğunda ya da operasyonel kısıtlamalar hız ve şeffaflığı tercih ettiğinde, daha basit bir model daha büyük bir modeli geride bırakabilir.
Makine Öğrenmesinin Kullanıldığı Yerler
ML, arama sıralaması, öneriler, tahmin, anomali tespiti, çeviri, konuşma tanıma, bilgisayarlı görme, öngörücü bakım, sahtecilik tespiti ve bilimsel analiz gibi alanları destekler. Aynı teknikler, tarihsel önyargıyı artırabilir, hassas bilgileri ortaya çıkarabilir veya dağılım kayması altında öngörülemez davranabilir. Sorumlu dağıtım, belgelemeyi, gerektiğinde insan denetimini, güvenlik testlerini ve sürekli izlemeyi gerektirir.
Problem Tanımından Geçerli Bir Makine‑Öğrenmesi Deneyine
Bir makine‑öğrenmesi projesi, bir algoritma yerine bir karar ve ölçülebilir bir sonuçla başlamalıdır. Tahmin birimini, hedefi, gözlem süresini, karar süresini, kullanılabilir özellikleri ve her hatanın maliyetini tanımlayın. Örneğin bir churn (müşteri kaybı) modeli için, iptaldan sonra kaydedilen olayları kullanmak cevabı sızdırır. Basit bir kural ya da istatistiksel bir temel oluşturun, ardından veriyi zaman, müşteri, konum ya da dağıtımı yansıtan başka bir sınırla bölün. Rastgele satır bölmeleri, neredeyse aynı gözlemleri eğitim ve test setlerine yerleştirerek yanıltıcı bir skor üretebilir.
Özellik mühendisliği, ham kayıtları modelin kullanabileceği temsillere dönüştürür, ancak her özelliğin kaynağı ve kullanılabilirlik garantisi olmalıdır. Normalizasyon, kelime dağarcığı, eksik değer doldurma ve boyut indirgeme işlemlerini yalnızca eğitim verisinde uygulayın, ardından öğrenilen dönüşümü doğrulama ve test verilerine uygulayın. Çapraz‑doğrulama, örnekler arasındaki değişkenliği tahmin eder; son dokunulmamış test seti sürüm kararını destekler. Metrikleri sonuçlardan seçin: dengesiz sınıflandırma hataları için kesinlik ve duyarlılık, olasılıkların eylemi yönlendirdiği durumlarda kalibrasyon ve hataların farklı operasyonel etkileri olduğunda maliyet‑veya fayda‑ağırlıklı ölçütler.
Dağıtım, İzleme ve Sorumlu İşletim
Üretim tahmini, eğitim sırasında yapılan tam dönüşümü tekrar eder ve gecikme, iş hacmi ve kullanılabilirlik kısıtlamaları altında bir tahmin döndürür. Ön işleme adımını modelle paketleyin, giriş şemalarını doğrulayın, artefaktları sürümleyin ve çevrim dışı ile hizmetteki uygulamalar arasındaki sonuçları karşılaştırın. Varsayılan 0.5 yerine, işletme kapasitesi ve hata takası dikkate alınarak bir eşik seçin. Gölgeli değerlendirme, sınırlı bir kohort ya da koruyucu metrikli bir deney üzerinden dağıtım yapın. Bağımlılık hatası ya da kabul edilemez davranış durumunda deterministik bir geri dönüş ve geri alma yolu tutun.
Giriş kalitesini, özellik kaymasını, tahmin dağılımını, kalibrasyonu, alt grup sonuçlarını, gecikmeyi, maliyeti ve nihayet geldiğinde doğrulanmış etiketleri izleyin. Kayma, araştırılması gereken bir işarettir; yeniden eğitimin otomatik olarak faydalı olduğunu göstermez. Yeniden eğitim, incelenmiş veri, tekrarlanabilir testler, onay ve mevcut en iyi model ile karşılaştırma gerektirir. Amacıyla ve geçersiz kullanımları, veri haklarını, gizliliği, güvenliği, insan müdahalesini ve etkilenen kişiler için itiraz sürecini belgeleyin. Makine öğrenmesi, sürdürülen bir karar sistemidir; model dosyası yalnızca değiştirilebilir bir bileşendir.
Uygulamalı Örnek: Ekipman Arızasını Tahmin Etmek
Bir üretici, makine‑gün başına bir tahmin tanımlar: yalnızca o günün başında mevcut telemetriden yola çıkarak, yedi gün içinde doğrulanmış bir arızanın gerçekleşip gerçekleşmeyeceği. Veriyi makine ve zamana göre böler, yaş ve eşik‑tabanlı kurallarla karşılaştırır, ön işleme adımını eğitim verisine uyarlar ve olay hatırlama, yanlış uyarılar, uyarı süresi, kalibrasyon ve bakım kapasitesini değerlendirir. Sensör değişimi ve planlı duruşlar, sıradan gözlem olarak değil, işletme bağlamı olarak modellenir.
Model önce gölge modda çalıştırılır. Uyarılar, katkıda bulunan telemetrileri ve belirsizliği gösterir, ancak bakım ekipleri inceleme yapıp yapmayacağına karar verir. Bulgular ve doğrulanmış nedenler, yönetilen etiketler haline gelir; bir iş emrinin olmaması, arıza olmadığı anlamına gelmez. Aşamalı dağıtım, uyarı limitleri ve manuel geri dönüş kullanırken, izleme sensör sağlığını, giriş kaymasını, incelenmiş kesinliği, kesinti süresini ve gereksiz bakımı takip eder. Yeniden eğitim, veri ve eşik incelemesinin mevcut dağıtılmış sistemden muhtemel bir iyileşme gösterdiği durumlarda gerçekleşir.
Uygulama Kanıtları ve Operasyonel Hazırlık
Bir üretim kararı, yalnızca başarılı bir gösterimden daha fazlasını gerektirir. Hedef kullanıcıları, işletim ortamını, girdileri, çıktıları, bağımlılıkları, sorumluyu ve her önemli hatanın sonucunu tanımlayın. Ayarlamadan önce yeniden üretilebilir bir temel ve sürümlenmiş bir değerlendirme seti oluşturun. Normal durumları, sınır koşullarını, hatalı ya da eksik girdileri, dağılım kaymasını, bağımlılık kesintisini, yanlış kullanımı ve hizmet dışı kalma olasılığı yüksek grup ya da ortamları test edin. Görev kalitesini kalibrasyon veya belirsizlik, gecikme, iş hacmi, kaynak maliyeti, erişilebilirlik, gizlilik ve güvenlik ile birlikte ölçün. Bağımsız bir inceleyicinin sonucu yeniden üretebilmesi ve kanıtı çekici bir prototipten ayırabilmesi için her dönüşümü ve eşiği kaydedin.
Başlatmadan önce, sürüm, istisna, değişiklik, geri alma ve emeklilik yetkilerini atayın. Aşamalı bir dağıtım kullanın, güvenli bir geri dönüşü koruyun ve izlemeyi kasıtlı olarak eklenmiş hatalarla doğrulayın. Operasyonel telemetri, gereksiz hassas veri toplamayarak giriş kalitesini, çıktı davranışını, model ya da kural sürümünü, bağımlılık sağlığını, insan müdahalelerini ve doğrulanmış sonuçları ortaya koymalıdır. Uyarı eşiklerini ve bir yanıt sorumlusunu tanımlayın, ardından dağıtımdan sonra gerçek‑dünya kanıtlarını gözden geçirin; çevrim dışı performansın devam edeceğini varsaymayın. Veri kaynakları, kullanıcılar, modeller, satıcılar, politikalar, donanım ya da hedefler değiştiğinde yeniden değerlendirin. Sürdürülen bir sistem, belgelenmiş bir kurtarma, olay öğrenimi, silme ve saklama prosedürleri ve devre dışı bırakılması ya da değiştirilmesi gereken net bir noktayı da gerektirir.
Birincil Referanslar












