Yapay zeka temelleri
Bayes Teoremi Nedir?

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
Bayes teoremi bir hipotezin olasılığını kanıt gözlemlendikten sonra nasıl güncelleyeceğimizi açıklar. Bir hipotez verildiğinde kanıtın olasılığı ile kanıt verildiğinde hipotezin olasılığını birbirine bağlar.
Bu ayrım istatistiksel akıl yürütme ve makine öğrenimi için temeldir. Bir test, bir durum mevcut olduğunda çok yüksek doğruluk gösterebilir, ancak durum nadir olduğunda pozitif bir sonuç hâlâ koşulu işaret etme olasılığı açısından mütevazı bir olasılığa sahiptir.
Temel Çıkarımlar
- Posterior, öncül inancı gözlemlenen kanıtın olasılığı ile birleştirir.
- Kanıt terimi, olası hipotezleri normalleştirir.
- Temel oranlar, görünüşte güçlü kanıtları bile hâkim kılabilir.
- Naif Bayes, özelliklerin sınıf verildiğinde koşullu bağımsız olduğunu varsayar; her durumda bağımsız değildir.
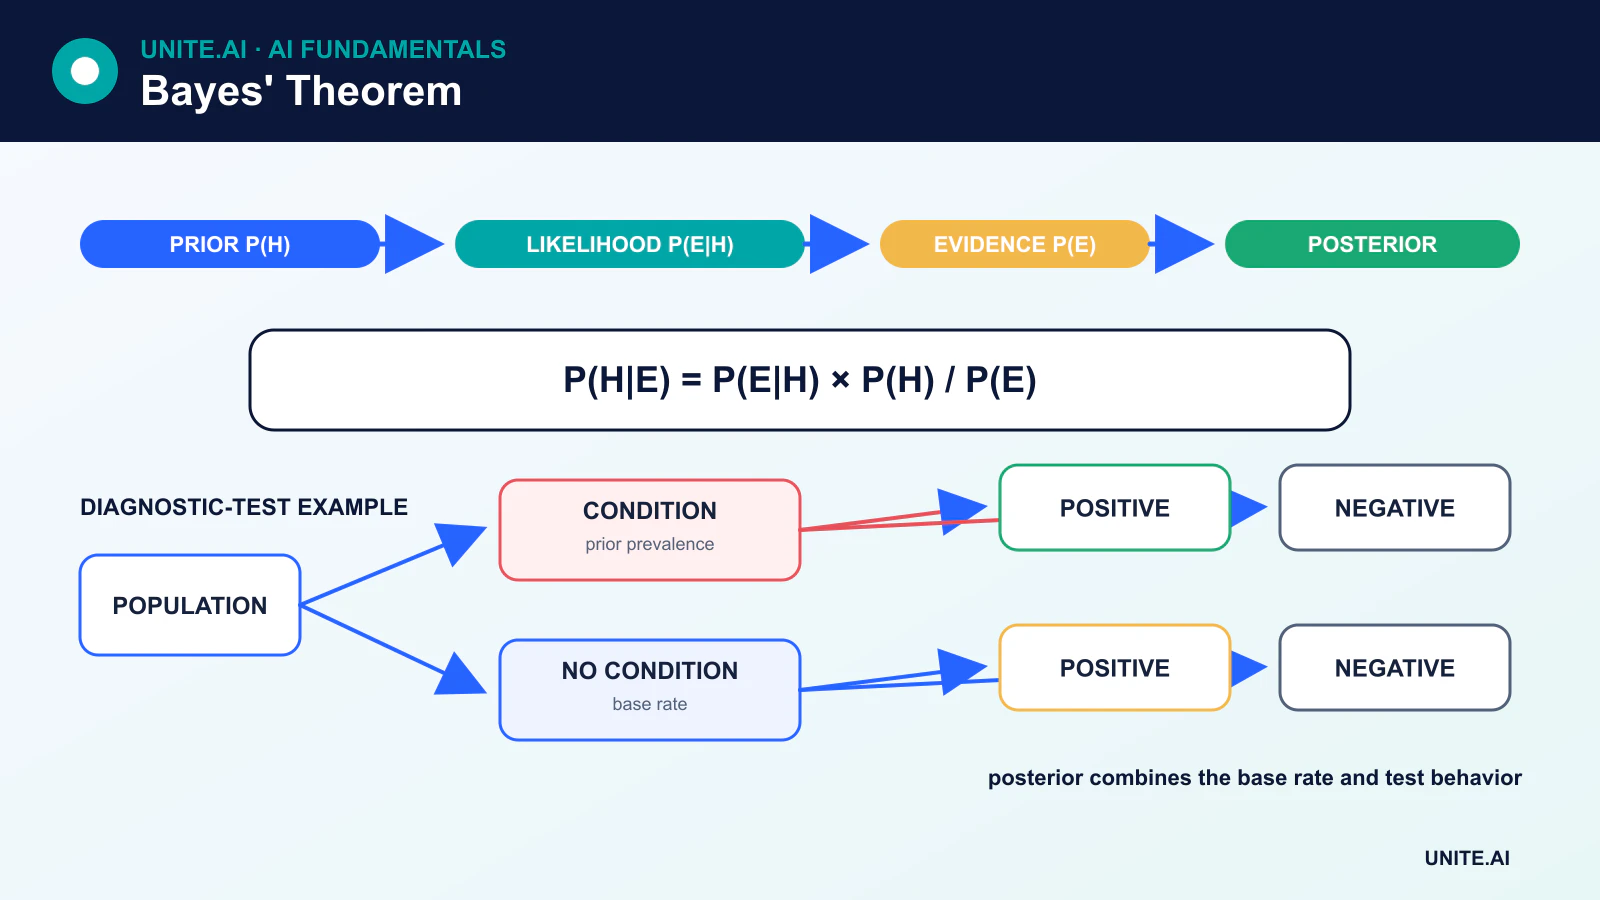
Formül
P(A|B) = P(B|A)P(A) / P(B)
- P(A) hipotez A’nın öncül olasılığıdır.
- P(B|A) A doğruysa kanıt B’nin gözlemlenme olasılığıdır.
- P(B) kanıtın genel olasılığıdır.
- P(A|B) B gözlemlendikten sonra A’nın posterior olasılığıdır.
Teorem, ortak olasılık için iki eşdeğer ifadeden türetilir: P(A ∩ B) = P(B|A)P(A) ve P(A ∩ B) = P(A|B)P(B).
Sayısal Temel Oran Örneği
Bir durumun nüfusun %1’ini etkilediğini varsayalım. Bir testin %90 duyarlılığı ve %5 yanlış pozitif oranı vardır. 1.000 kişiyi ele alalım:
- Yaklaşık 10 kişi duruma sahiptir; test doğru şekilde 9’unu işaretler.
- Yaklaşık 990 kişi durumu yoktur; %5 yanlış pozitif oranı yaklaşık 50 kişiyi işaretler.
- Dolayısıyla yaklaşık 59 pozitif sonuç vardır ve bunların 9’u gerçek pozitiftir.
Pozitif bir sonuçtan sonra durumun olasılığı yaklaşık 9 / 59 ≈ %15’dir, %90 değil. Testin duyarlılığı P(pozitif | durum) sorusuna yanıt verir; kullanıcı genellikle P(durum | pozitif) ister. Bayes teoremi, bunları temel oranı kullanarak bağlar.
Bayes Güncellemesi
Yeni kanıt geldikçe, posterior bir sonraki güncelleme için öncül haline gelebilir. Tam bir Bayes modeli, olası hipotezleri, öncül dağılımları, bir olasılık fonksiyonunu ve çıkarılacak niceliği tanımlar. Belirsizlik, yalnızca tek bir tahmin yerine posterior dağılımla temsil edilir.
Öncül, belgelenmeli ve duyarlılık açısından test edilmelidir. Zayıf bilgi veren bir öncül, mantıksız değerleri düzenleyebilir; kötü seçilmiş güçlü bir öncül ise sınırlı veriyi hâkim kılabilir.
Naif Bayes sınıflandırıcıları
Naif Bayes, Bayes teoremi ve aşağıdaki varsayımı kullanarak özellikler x₁ … xₙ üzerinden bir y sınıfını tahmin eder:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
Özelliklerin, sınıf bilindiğinde koşullu bağımsız olduğu varsayılır. Bu genellikle gerçekçi değildir, ancak sınıf puanları hâlâ yararlı olduğunda sınıflandırıcı iyi çalışabilir.
Yaygın varyantlar
- Multinomial Naif Bayes sayım benzeri özellikleri modeller ve belge sınıflandırmasında yaygındır.
- Bernoulli Naif Bayes ikili özellik varlığını modeller.
- Gaussian Naif Bayes her sürekli özelliği sınıf-şartlı Gauss dağılımı ile modeller.
- Kategorik Naif Bayes ayrık kategorileri modeller.
Düzleştirme ve Sayısal Kararlılık
Eğer bir özellik değeri eğitimde bir sınıfla hiç görülmezse, düzeltilmemiş olasılık tahmini sıfır olur ve tüm çarpımı ortadan kaldırır. Toplamalı ya da Laplace tarzı düzleştirme bunu önler. Uygulamalar, birçok küçük değeri çarpmak yerine log olasılıklarını hesaplayarak stabil log değerleri toplar.
Olasılıklar, Puanlar ve Kalibrasyon
Naif Bayes olasılık çıktıları, ilişkili özellikler birden fazla kez sayıldığı için kötü kalibre olabilir. Bir sınıflandırıcı sınıfları iyi sıralayabilir ancak güveni aşırı tahmin edebilir. Olasılıklar kararları yönlendirdiğinde kalibrasyon, ayırma verileri üzerinde değerlendirilmelidir.
Naif Bayes’in Ötesinde Bayes
Bayes çıkarımı, hiyerarşik modelleri, A/B testlerini, bilimsel parametre tahminlerini, öngörüleri, belirsizlik farkındalıklı karar almayı ve olasılıksal grafiksel modelleri destekler. Posterior kapalı formda hesaplanamadığında Markov zinciri Monte Carlo ve varyasyonel çıkarım gibi yaklaşık yöntemler kullanılır.
Yaygın Akıl Yürütme Hataları
P(A|B)ileP(B|A)’yi karıştırmak.- Nadir ya da yaygın bir temel oranı göz ardı etmek.
- Öncülü nesnel kabul etmek ya da belgelendirmemek.
- Yüksek bir olasılığın otomatik olarak yüksek bir posterior anlamına geldiğini varsaymak.
- Öngörü ilişkisini nedensellik olarak yorumlamak.
Koşullu Olasılık, Oranlar ve Kanıt
Bayes teoremi, bir hipotezin kanıttan sonraki olasılığını öncül olasılığı, hipotez altında kanıtın gözlemlenme olasılığı ve kanıtın toplam olasılığı ile ilişkilendirir. Oran formunda, posterior oranlar öncül oranların olasılık oranı ile çarpılmasıyla elde edilir. Bu, bir testten önce neye inanıldığını ve testin hipotezleri ne kadar ayırdığını ayırır. Çok yüksek doğrulukta görünen bir test, durum nadir olduğunda hâlâ çok sayıda yanlış pozitif üretebilir çünkü temel oran posteriora girer.
Olasılık, sabit gözlemlenen veri için hipotezin bir fonksiyonudur ve hipotezin olasılığı ile karıştırılmamalıdır. Kanıt normalleştirmesi, rekabet eden hipotezler arasında toplam ya da entegrasyon yapar. Koşullu bağımsızlık varsayımları, naive Bayes gibi, hesaplamayı basitleştirir ancak sonuçlarla kontrol edilmelidir. Birden fazla kanıt, ortak nedenleri ya da tekrarlanan bilgiyi paylaştığında bağımsız olarak çarpılamaz. Nedensel yön de önemlidir: P(kanıt|hipotez) genellikle P(hipotez|kanıt) değildir; bu klasik ters olasılık hatasıdır.
Modelleme Seçimleri, Hesaplama ve Karar Kullanımı
Bayes analizi, bir öncül, olasılık fonksiyonu ve posterior öngörü dağılımı tanımlar. Öncüller, yerleşik bilgiyi kodlayabilir, küçük örnekleri düzenleyebilir ya da zayıf bilgi verici olabilir; bunlar gerekçelendirilip duyarlılık analiziyle test edilmelidir. Eşlenik modeller analitik güncellemeler sağlar, Markov zinciri Monte Carlo, varyasyonel çıkarım ve sıralı yöntemler karmaşık posteriorları yaklaşık olarak hesaplar. Yakınsama, etkili örnek büyüklüğü, yaklaşık hata ve öncül öngörülebilirliği teşhis edilmeli; sadece bir posterior sayısı rapor edilmemelidir.
Posterior olasılık bilgi verir ancak tek başına bir eylemi seçmez. Kararlar kayıplar, faydalar, kısıtlamalar ve mevcut alternatifleri gerektirir. Olasılık modelleri kalibrasyon, doğru puanlama kuralları ve yeni veriler üzerindeki posterior öngörü kontrolleriyle değerlendirilmelidir. Kanıt, modellenen bir süreç altında toplanmalı; seçim yanlılığı ve veri kayması olasılık fonksiyonunu geçersiz kılabilir. Güven aralıkları ve varsayımlar, garantili frekans aralıkları gibi yorumlanmamalıdır. Bayes teoremi kesin olasılık cebiridir; bir Bayes sonucunun kalitesi, kullanılan model ve sağlanan kanıta bağlıdır.
Uygulamalı örnek: tanısal testi yorumlamak
Bir testin %95 duyarlılığı ve %90 özgüllüğü vardır, ancak durum sadece %1 oranında taranan nüfusta görülür. 10.000 kişi için yaklaşık 95 gerçek pozitif ve 990 yanlış pozitif beklenir; bu da pozitif öngörü değeri %9’un altında kalır. Bayes teoremi, temel oran etkisini açıkça gösterir. Hesaplama, nüfus, test eşiği ve belirsizliği belirtir; duyarlılığı pozitif sonucun doğru olma ihtimali olarak reklam etmez. Bu ayrım, dikkatli bir veri bilimi için de temeldir.
Klinisyenler, testler arasındaki bağımlılık modellendiğinde ek kanıtla olasılığı günceller. Karar eşiği, kaçırılan hastalığın zararı, doğrulayıcı test riski, maliyet ve hasta tercihlerini içerir. Kalibrasyon yerel nüfusta kontrol edilir ve prevalans değişiklikleri gözden geçirilir. Posterior, tartışma ve sonraki adımları destekler; doğrulayıcı tanıyı yerine geçmez. Raporlama, doğal frekanslar ve duyarlılık analizi kullanır; böylece hastalar ve uygulayıcılar sonucun makul varsayımlara göre nasıl değiştiğini görebilir.
Uygulama Kanıtı ve Operasyonel Hazırlık
Üretim kararı, başarılı bir gösterimden daha fazlasını gerektirir. Hedef kullanıcılar, çalışma ortamı, girdiler, çıktılar, bağımlılıklar, sorumlu kişi ve her önemli hatanın sonucunu tanımlayın. Ayarlamadan önce tekrarlanabilir bir temel ve sürümlenmiş bir değerlendirme seti oluşturun. Normal durumları, sınır koşullarını, bozuk ya da eksik girdileri, dağılım kaymasını, bağımlılık kesintilerini, yanlış kullanımı ve en çok hizmet alamayan grupları ya da ortamları test edin. Görev kalitesini kalibrasyon veya belirsizlik, gecikme, iş hacmi, kaynak maliyeti, erişilebilirlik, gizlilik ve güvenlikle birlikte ölçün. Her dönüşüm ve eşik kaydedilsin ki bağımsız bir gözden geçiren sonuçları yeniden üretebilsin ve kanıtı çekici bir prototipten ayırabilsin.
Başlamadan önce, sürüm, istisna, değişiklik, geri alma ve emeklilik sorumluluğunu atayın. Aşamalı bir dağıtım kullanın, güvenli bir geri dönüş sağlayın ve kasıtlı olarak eklenen hatalarla izlemeyi doğrulayın. Operasyonel telemetri, giriş kalitesini, çıktı davranışını, model ya da kural sürümünü, bağımlılık sağlığını, insan müdahalelerini ve gereksiz hassas veri toplamadan doğrulanmış sonuçları göstermelidir. Uyarı eşikleri ve bir yanıt sorumlusu tanımlayın, ardından dağıtım sonrası gerçek dünya kanıtını gözden geçirin; çevrim dışı performansın devam edeceğini varsaymayın. Veri kaynakları, kullanıcılar, modeller, satıcılar, politikalar, donanım veya hedefler değiştiğinde yeniden değerlendirin. Bakımı yapılan bir sistem, ayrıca belgelenmiş kurtarma, olay öğrenimi, silme ve saklama prosedürleri ve devre dışı bırakılması ya da değiştirilmesi gereken net bir noktaya da ihtiyaç duyar.
Sıkça Sorulan Sorular
Olasılık (likelihood) ve olasılık (probability) arasındaki fark nedir?
Parametreler sabit olduğunda, bir model olası verilere olasılık atar. Gözlemlenen veri sabit olduğunda, aynı ifade olası parametre değerleri üzerine bir likelihood fonksiyonu olarak görülebilir. Sayısal formül aynı olabilir ancak yorum farklıdır.
Naif Bayes tam olarak Bayes çıkarımı mıdır?
Naif Bayes, güçlü bir koşullu bağımsızlık modeline dayalı sınıflandırma için Bayes teoremini kullanır. Daha geniş Bayes çıkarımı, bilinmeyen nicelikler üzerine dağılımlar koyar ve bir posterior dağılımı ile akıl yürütür.
Temel Referanslar
ns bir posterior dağılımı ile. Temel referanslar scikit-learn: Naive Bayes NIST/SEMATECH: Olasılık dağılımları ve koşullu olasılık