
สัมภาษณ์
Xavier Conort, ผู้ร่วมก่อตั้งและ CPO ของ FeatureByte – สัมภาษณ์ซีรีส์

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
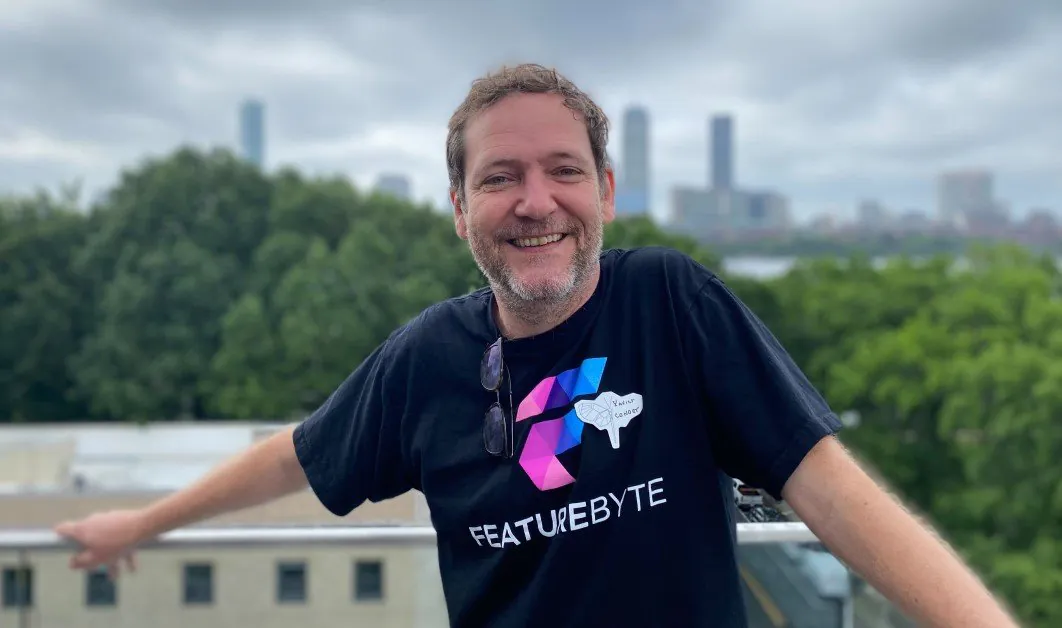
Xavier Conort เป็นนักวิทยาศาสตร์ข้อมูลที่มีวิสัยทัศน์และประสบการณ์ด้านข้อมูลมากกว่า 25 ปี เขาเริ่มอาชีพเป็นนักคณิตศาสตร์ประกันภัยก่อนเปลี่ยนสู่วิทยาศาสตร์ข้อมูล เป็นผู้เข้าแข่งขันอันดับสูงใน Kaggle และเคยเป็นหัวหน้านักวิทยาศาสตร์ข้อมูลของ DataRobot ก่อนร่วมก่อตั้ง FeatureByte
FeatureByte มุ่งขยายการใช้ AI ระดับองค์กร โดยทำให้ข้อมูลสำหรับ AI จัดการได้ง่ายขึ้นอย่างมากและพร้อมใช้ในระดับอุตสาหกรรม แพลตฟอร์มวิศวกรรมและจัดการฟีเจอร์ช่วยให้นักวิทยาศาสตร์ข้อมูลสร้างและแบ่งปันฟีเจอร์ล้ำสมัยและสายงานข้อมูลที่พร้อมใช้งานจริงได้ภายในไม่กี่นาที แทนที่จะใช้หลายสัปดาห์หรือหลายเดือน
คุณเริ่มเป็นนักคณิตศาสตร์ประกันภัยก่อนเปลี่ยนสู่วิทยาศาสตร์ข้อมูล อะไรทำให้เกิดการเปลี่ยนแปลงนี้?
จุดเปลี่ยนสำคัญคือการชนะ GE Flight Quest การแข่งขันที่ GE จัดขึ้นพร้อมเงินรางวัลรวม 250,000 ดอลลาร์ โดยผู้แข่งขันต้องทำนายความล่าช้าของเที่ยวบินภายในสหรัฐฯ ความสำเร็จส่วนหนึ่งมาจากแนวปฏิบัติที่มีคุณค่าในงานประกันภัย คือการสร้างแบบจำลองสองขั้นตอน ซึ่งช่วยควบคุมอคติของฟีเจอร์ที่มีตัวอย่างไม่เพียงพอในข้อมูลฝึก ผลงานนี้และชัยชนะอื่น ๆ บน Kaggle ทำให้ผมมั่นใจว่าพื้นฐานคณิตศาสตร์ประกันภัยเป็นข้อได้เปรียบในการแข่งขันด้านวิทยาศาสตร์ข้อมูล
ระหว่างแข่งขันบน Kaggle ผมได้พบกับนักวิทยาศาสตร์ข้อมูลที่กระตือรือร้น เช่น Jeremy Achin และ Tom De Godoy ซึ่งต่อมาก่อตั้ง DataRobot เรามีพื้นฐานประกันภัยเหมือนกันและประสบความสำเร็จบน Kaggle เมื่อพวกเขาเปิดตัว DataRobotบริษัทที่เชี่ยวชาญ AutoML พวกเขาเชิญผมเป็นหัวหน้านักวิทยาศาสตร์ข้อมูล วิสัยทัศน์ในการผสานแนวปฏิบัติที่ดีที่สุดของอุตสาหกรรมประกันภัยกับพลังการเรียนรู้ของเครื่องทำให้ผมตื่นเต้น เพราะเป็นโอกาสสร้างสิ่งใหม่ที่มีผลกระทบสำคัญ
คุณมีบทบาทสำคัญในการวางแผนงานวิทยาศาสตร์ข้อมูลที่ DataRobot คุณเผชิญปัญหาข้อมูลแบบใดบ้าง?
ความท้าทายสำคัญที่สุดคือคุณภาพที่แตกต่างกันของข้อมูลป้อนเข้าให้ AutoML หากจัดการไม่เหมาะสม ปัญหานี้อาจทำให้ทีมกับลูกค้าต้องทำงานร่วมกันอย่างยาวนาน หรือได้ผลลัพธ์น่าผิดหวังเมื่อใช้งานจริง ปัญหาคุณภาพมีหลายที่มา
ปัญหาหลักอย่างหนึ่งคือการใช้เครื่องมือข่าวกรองธุรกิจ (BI) เตรียมและจัดการข้อมูล แม้เครื่องมือเหล่านี้ช่วยสร้างข้อมูลเชิงลึก แต่ขาดความสามารถรับรองว่าข้อมูลถูกต้องตามเวลาที่เกิดเหตุการณ์ (point-in-time correctness) สำหรับการเตรียมข้อมูลเรียนรู้ของเครื่อง จึงอาจเกิดข้อมูลรั่วไหลเข้าสู่ชุดฝึก ทำให้โมเดลฟิตกับข้อมูลฝึกมากเกินไปและมีผลการทำงานคลาดเคลื่อน
การสื่อสารไม่ตรงกันระหว่างนักวิทยาศาสตร์ข้อมูลกับวิศวกรข้อมูลก็ส่งผลต่อความแม่นยำของโมเดลในการใช้งานจริง ความไม่สอดคล้องระหว่างขั้นตอนฝึกกับขั้นตอนใช้งานที่เกิดจากทั้งสองทีมทำงานไม่ตรงกันอาจลดประสิทธิภาพในสภาพแวดล้อมจริง
คุณได้ข้อคิดสำคัญอะไรจากประสบการณ์นี้?
ประสบการณ์ที่ DataRobot ย้ำความสำคัญของการเตรียมข้อมูลเรียนรู้ของเครื่อง การจัดการปัญหาข้อมูลฝึก เช่น ความถูกต้องตามเวลา ช่องว่างความเชี่ยวชาญ ความรู้เฉพาะด้าน ข้อจำกัดเครื่องมือ และการขยายระบบ ช่วยเพิ่มความแม่นยำและความน่าเชื่อถือของโมเดล ผมสรุปว่าการทำกระบวนการเตรียมข้อมูลให้คล่องตัวและใช้เทคโนโลยีใหม่มีบทบาทสำคัญในการปลดล็อกศักยภาพ AI และทำให้ประโยชน์ที่คาดหวังเกิดขึ้นจริง
เราเคยฟัง Razi Raziuddin ผู้ร่วมก่อตั้งของคุณ เล่าเรื่องกำเนิด FeatureByte แล้ว คุณช่วยเล่าจากมุมของคุณได้ไหม?
เมื่อผมคุยข้อสังเกตและข้อมูลเชิงลึกกับ Razi Raziuddin เราพบว่ามองปัญหาการเตรียมข้อมูลเรียนรู้ของเครื่องตรงกัน ผมเล่าความก้าวหน้าในชุมชน MLOps และการเกิดขึ้นของ feature store กับแพลตฟอร์มฟีเจอร์ที่บริษัทเทคโนโลยีซึ่งให้ AI เป็นแกนหลักใช้ลดความหน่วงในการให้บริการฟีเจอร์ ส่งเสริมการนำฟีเจอร์กลับมาใช้ หรือทำให้การสร้างข้อมูลฟีเจอร์สำหรับชุดฝึกง่ายขึ้น พร้อมรักษาความสอดคล้องระหว่างการฝึกกับการให้บริการ แต่ยังมีช่องว่างในการตอบโจทย์นักวิทยาศาสตร์ข้อมูล Razi เล่าว่าชุดเทคโนโลยีข้อมูลสมัยใหม่ปฏิวัติ BI และการวิเคราะห์อย่างไร แต่ยังไม่ได้ใช้ประโยชน์อย่างเต็มที่กับ AI
เราทั้งคู่เห็นโอกาสสร้างผลกระทบสำคัญด้วยการลดความซับซ้อนของวิศวกรรมฟีเจอร์อย่างมาก และมอบเครื่องมือกับประสบการณ์ผู้ใช้ที่เหมาะสมให้นักวิทยาศาสตร์ข้อมูลและวิศวกร ML ทดลองและให้บริการฟีเจอร์ได้อย่างราบรื่น
ความท้าทายใหญ่ที่สุดในการเปลี่ยนจากนักวิทยาศาสตร์ข้อมูลเป็นผู้ประกอบการมีอะไรบ้าง?
ผมต้องเปลี่ยนจากมุมมองเทคนิคสู่แนวคิดธุรกิจที่กว้างขึ้น แม้มีพื้นฐานดีในการเข้าใจปัญหาลูกค้า วางแผนงาน ลงมือทำ สร้างทีม และบริหารงบประมาณ แต่การสื่อสารข้อความให้ตรงใจกลุ่มเป้าหมายเป็นอุปสรรคใหญ่ที่สุดอย่างหนึ่ง
ในฐานะนักวิทยาศาสตร์ข้อมูล ผมเน้นวิเคราะห์และตีความข้อมูลเพื่อสร้างข้อมูลเชิงลึก แต่ในฐานะผู้ประกอบการต้องหันมาคิดถึงตลาด ลูกค้า และธุรกิจโดยรวม
โชคดีที่ประสบการณ์ของ Razi ผู้ร่วมก่อตั้งช่วยให้ผมผ่านความท้าทายนี้ได้
เราเคยฟัง Razi อธิบายว่าทำไมวิศวกรรมฟีเจอร์จึงยาก ในมุมของคุณอะไรทำให้ท้าทาย?
วิศวกรรมฟีเจอร์มีความท้าทายหลักสองประการ:
- การแปลงคอลัมน์ที่มีอยู่: แปลงข้อมูลให้เหมาะกับอัลกอริทึมเรียนรู้ของเครื่อง ด้วยเทคนิคอย่าง one-hot encoding การปรับสเกลฟีเจอร์ และวิธีขั้นสูง เช่น การแปลงข้อความและภาพ การสร้างฟีเจอร์ใหม่จากของเดิม เช่น ฟีเจอร์ปฏิสัมพันธ์ ช่วยเพิ่มประสิทธิภาพโมเดลได้มาก ไลบรารีอย่าง scikit-learn และ Hugging Face รองรับงานนี้อย่างกว้างขวาง และ AutoML ก็พยายามทำให้กระบวนการง่ายขึ้น
- การสกัดคอลัมน์ใหม่จากข้อมูลย้อนหลัง: ข้อมูลย้อนหลังสำคัญต่อระบบแนะนำ การตลาด การตรวจจับทุจริต การกำหนดเบี้ยประกัน การให้คะแนนเครดิต การพยากรณ์อุปสงค์ และการประมวลผลข้อมูลเซ็นเซอร์ การสกัดคอลัมน์ที่ให้สารสนเทศมีความท้าทาย เช่น เวลาตั้งแต่เหตุการณ์ล่าสุด การรวมข้อมูลเหตุการณ์ช่วงหลัง และเวกเตอร์ฝังตัวจากลำดับเหตุการณ์ งานนี้ต้องใช้ความรู้เฉพาะด้าน การทดลอง ทักษะเขียนโค้ดและวิศวกรรมข้อมูลที่แข็งแกร่ง และความรู้วิทยาศาสตร์ข้อมูลเชิงลึก พร้อมคำนึงถึงข้อมูลรั่วไหลข้ามเวลา การจัดการข้อมูลขนาดใหญ่ และการรันโค้ดอย่างมีประสิทธิภาพ
โดยรวม วิศวกรรมฟีเจอร์ต้องอาศัยความเชี่ยวชาญ การทดลอง และการสร้างสายงานข้อมูลเฉพาะกิจที่ซับซ้อน หากไม่มีเครื่องมือที่ออกแบบมาสำหรับงานนี้โดยเฉพาะ
FeatureByte ช่วยผู้เชี่ยวชาญวิทยาศาสตร์ข้อมูลพร้อมลดความซับซ้อนของสายงานฟีเจอร์อย่างไร?
FeatureByte ทำให้กระบวนการวิศวกรรมฟีเจอร์ทั้งหมดง่ายขึ้น Python SDK ที่ใช้งานง่ายช่วยสร้างและสกัดฟีเจอร์จากตารางเหตุการณ์และรายการขนาดใหญ่มากได้รวดเร็ว การคำนวณใช้ความสามารถขยายระบบของแพลตฟอร์มอย่าง Snowflake, DataBricks และ Spark อย่างมีประสิทธิภาพ โน้ตบุ๊กช่วยทดลอง การแบ่งปันและใช้ฟีเจอร์ซ้ำช่วยประหยัดเวลา การตรวจประเมินรับรองความถูกต้อง และการนำไปใช้ได้ทันทีช่วยลดภาระจัดการสายงานข้อมูล
นอกจากความสามารถในไลบรารีโอเพนซอร์สแล้ว โซลูชันองค์กรของเรายังมีกรอบจัดการและจัดระเบียบการดำเนินงาน AI ในวงกว้าง รวมถึงขั้นตอนกำกับดูแลและส่วนติดต่อผู้ใช้สำหรับแค็ตตาล็อกฟีเจอร์
วิสัยทัศน์ในอนาคตของ FeatureByte คืออะไร?
เราต้องการปฏิวัติวิทยาศาสตร์ข้อมูลและการเรียนรู้ของเครื่อง โดยให้ผู้ใช้ปลดปล่อยศักยภาพสร้างสรรค์อย่างเต็มที่และดึงคุณค่าจากสินทรัพย์ข้อมูลได้อย่างไม่เคยมีมาก่อน
เราตื่นเต้นกับความก้าวหน้ารวดเร็วของ AI เชิงกำเนิดและทรานส์ฟอร์เมอร์ที่เปิดโอกาสให้ผู้ใช้ และมุ่งทำให้วิศวกรรมฟีเจอร์เข้าถึงได้สำหรับทุกคน AI เชิงกำเนิดอาจลดอุปสรรคในการสร้างฟีเจอร์อย่างสร้างสรรค์และเปิดให้คนวงกว้างเข้าถึงได้
วิสัยทัศน์ของเราจึงเน้นนวัตกรรมต่อเนื่อง ใช้พลัง AI เชิงกำเนิด และขยายการเข้าถึงวิศวกรรมฟีเจอร์ เราต้องการเป็นแพลตฟอร์มหลักที่ช่วยผู้เชี่ยวชาญแปลงข้อมูลดิบเป็นข้อมูลป้อนเข้าที่ใช้ประโยชน์ได้สำหรับการเรียนรู้ของเครื่อง และขับเคลื่อนความก้าวหน้าในทุกอุตสาหกรรม
คุณมีคำแนะนำสำหรับผู้ที่อยากเป็นผู้ประกอบการ AI ไหม?
กำหนดขอบเขตของคุณ มุ่งมั่นกับสิ่งนั้น และเปิดรับสิ่งใหม่
การกำหนดขอบเขตที่ต้องการเป็นผู้นำช่วยสร้างความแตกต่างและจุดยืนที่แข็งแกร่ง ศึกษาตลาด เข้าใจความต้องการและปัญหาของลูกค้าที่อาจใช้บริการ และพยายามสร้างโซลูชันเฉพาะที่แก้ปัญหาได้อย่างมีประสิทธิภาพ
กำหนดวิสัยทัศน์ระยะยาวและเป้าหมายระยะสั้นที่ชัดเจนสอดคล้องกัน มุ่งสร้างรากฐานที่แข็งแรงและส่งมอบคุณค่าในขอบเขตที่เลือก
แม้การมุ่งมั่นสำคัญ ก็อย่ากลัวเปิดรับสิ่งใหม่และสำรวจแนวคิดใหม่ภายในขอบเขตของคุณ AI เปลี่ยนแปลงตลอดเวลา และแนวทางใหม่อาจเปิดโอกาสใหม่ได้
ขอบคุณสำหรับบทสัมภาษณ์ ผู้อ่านที่สนใจสามารถเรียนรู้เพิ่มเติมได้ที่ FeatureByte.








