
พื้นฐาน AI
การดำเนินงานด้านไอที (ITOps) คืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
IT operations (ITOps) คือการดำเนินการเพื่อให้บริการเทคโนโลยีที่องค์กรพึ่งพา ทำงานครอบคลุมการประมวลผล, เครือข่าย, การระบุตัวตน, จุดเชื่อมต่อ, แพลตฟอร์มคลาวด์, ฐานข้อมูล, การจัดเก็บ, การสำรองข้อมูล และกระบวนการปฏิบัติการที่ทำให้ส่วนประกอบเหล่านั้นพร้อมใช้งาน, ปลอดภัยและสามารถสนับสนุนได้
ITOps สมัยใหม่ไม่ได้จำกัดอยู่แค่ศูนย์ปฏิบัติการเครือข่ายที่เฝ้าดูแดชบอร์ด ทีมงานกำลังจัดการโครงสร้างพื้นฐานที่กำหนดด้วยซอฟต์แวร์, บริการแพลตฟอร์ม, การอัตโนมัติและการเป็นเจ้าของแบบกระจาย พร้อมยังคงรับผิดชอบต่อเหตุการณ์, ความจุ, ความต่อเนื่องและระดับการให้บริการ
ประเด็นสำคัญ
- ITOps จัดการบริการและการพึ่งพาต่าง ๆ ของมันในสภาพแวดล้อมแบบในศูนย์ข้อมูล, คลาวด์และขอบเครือข่าย
- การมองเห็น, การกำหนดค่าและการสำรวจสินทรัพย์ให้บริบทที่จำเป็นสำหรับการตีความความล้มเหลว
- การจัดการเหตุการณ์ช่วยฟื้นฟูบริการ; การจัดการปัญหาตอบสนองต่อสาเหตุที่เกิดซ้ำหรือเป็นระบบ
- ITOps มีการทับซ้อนกับ ITSM, SRE, DevOps, SecOps และ AIOps แต่ไม่เหมือนกับใด ๆ อย่างใดอย่างหนึ่ง
บริการ, สินทรัพย์และการกำหนดค่า
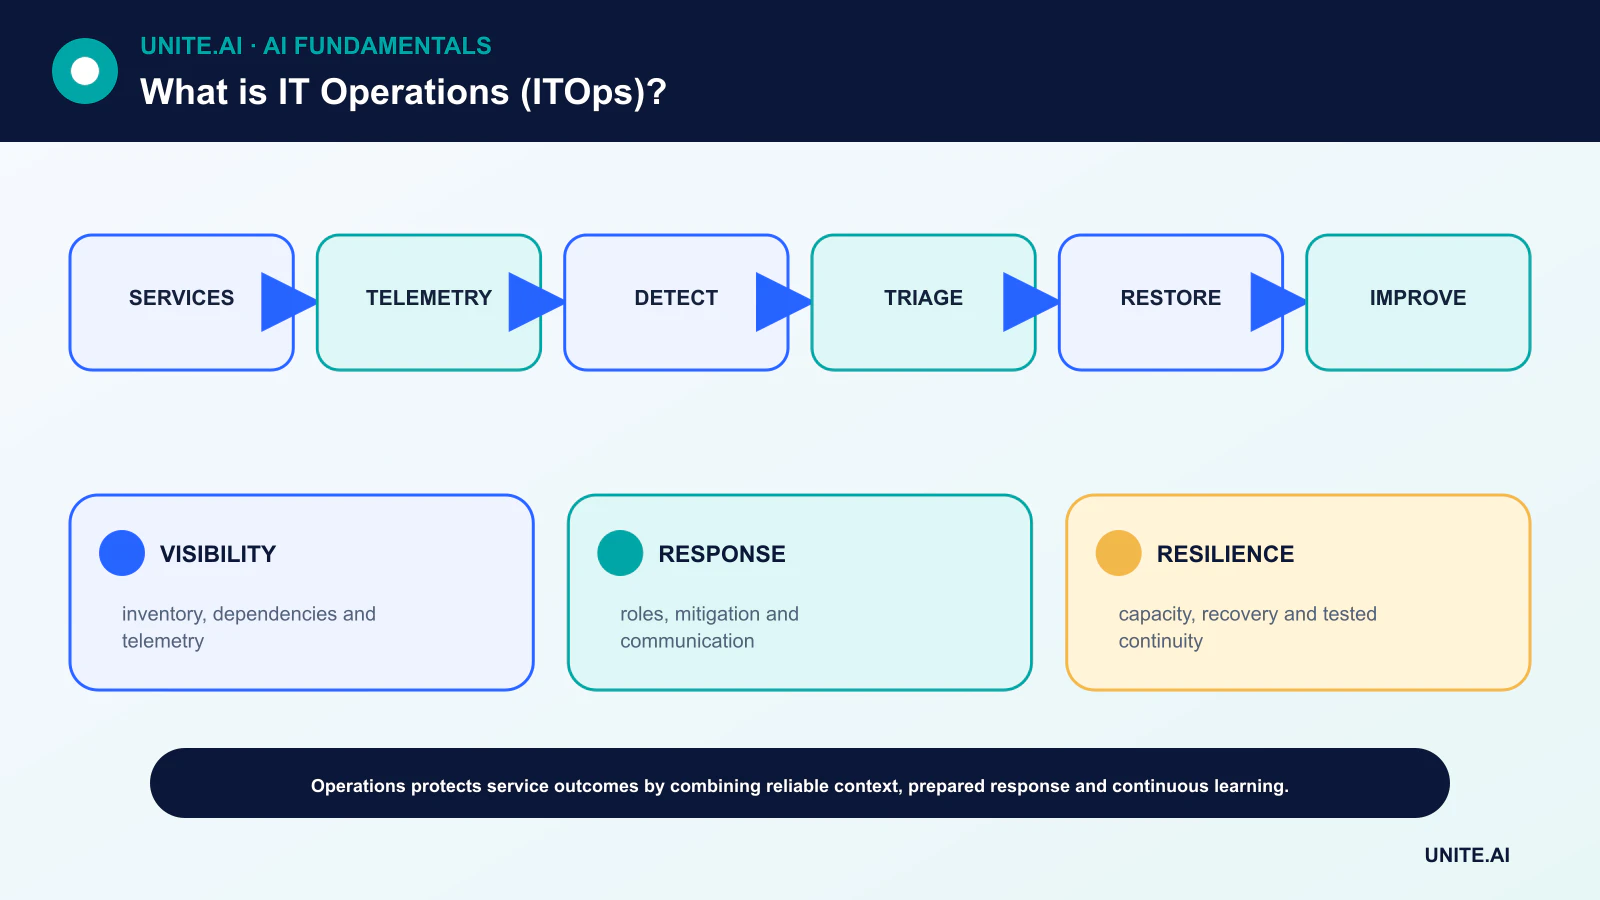
การดำเนินงานเริ่มต้นด้วยการรู้ว่ามีบริการอะไรบ้าง, ใครเป็นเจ้าของ, ผู้ใช้ใดพึ่งพาและโครงสร้างพื้นฐานใดสนับสนุนบริการเหล่านั้น รายการสินทรัพย์บันทึกส่วนประกอบ; การจัดการการกำหนดค่าบันทึกความสัมพันธ์ที่เกี่ยวข้องและสถานะที่ควบคุม
รายการสินทรัพย์ที่ไม่เคยทำการปรับให้ตรงกันจะทำให้เกิดความเข้าใจผิด ให้ทำการค้นหาอัตโนมัติเมื่อเป็นประโยชน์, ระบุแหล่งข้อมูลที่เป็นอ้างอิงและบันทึกระดับความเชื่อมั่นหรือความสดใหม่ แทนการทำให้ดูเหมือนแผนที่การพึ่งพาทั้งหมดสมบูรณ์
การมองเห็นและวัตถุประสงค์ของบริการ
เมตริกส์วัดพฤติกรรม, บันทึกเหตุการณ์และการติดตามทำตามงานข้ามบริการ การตรวจสอบเชิงสังเคราะห์สามารถทดสอบการเดินทางของผู้ใช้ การมองเห็นที่มีประโยชน์เริ่มจากคำถามและวัตถุประสงค์ของบริการ แล้วเก็บสัญญาณที่จำเป็นเพื่อตอบคำถามเหล่านั้น
การแจ้งเตือนควรระบุสภาวะที่ต้องการการดำเนินการอย่างทันท่วงที ค่าเกณฑ์ที่ไม่มีผลต่อผู้ใช้จะทำให้เกิดเสียงรบกวน, ในขณะที่การขาดบริบทการพึ่งพาชะลอการวินิจฉัย AIOps สามารถช่วยในการเชื่อมโยง, แต่ต้องอาศัยข้อมูลการสังเกตที่เชื่อถือได้และข้อเสนอแนะจากการปฏิบัติการ
การจัดการเหตุการณ์, ปัญหาและการเปลี่ยนแปลง
การจัดการเหตุการณ์ประสานการตรวจจับ, การคัดกรอง, การบรรเทา, การสื่อสารและการฟื้นฟู บทบาทที่ชัดเจนช่วยลดความสับสนในสภาวะกดดัน วิธีแก้ชั่วคราวสามารถฟื้นฟูบริการได้ในขณะที่การสืบสวนปัญหาต่อมาจะจัดการกับสาเหตุที่ลึกซึ้งกว่า
การจัดการการเปลี่ยนแปลงประเมินและบันทึกความเสี่ยงโดยไม่ทำให้การเปลี่ยนแปลงทุกอย่างกลายเป็นคิว การเปลี่ยนแปลงมาตรฐาน, อัตโนมัติและความเสี่ยงต่ำสามารถดำเนินตามเส้นทางที่ได้รับการอนุมัติล่วงหน้า; การเปลี่ยนแปลงที่มีผลกระทบสูงต้องการหลักฐานที่แข็งแกร่ง, การกำหนดเวลาและการเตรียมการย้อนกลับ
ความจุ, ความยืดหยุ่นและความต่อเนื่อง
ทีมงานคาดการณ์ความต้องการทรัพยากร, กำจัดคอขวดและทดสอบพฤติกรรมภายใต้ภาระงาน การสำรองข้อมูลมีประโยชน์เฉพาะเมื่อการกู้คืนได้รับการทดสอบ การทำซ้ำช่วยได้เฉพาะเมื่อโหมดความล้มเหลวเป็นอิสระและการสลับทำงานจริง
ความต่อเนื่องของธุรกิจกำหนดลำดับความสำคัญ, เวลาในการฟื้นฟูและการสูญเสียข้อมูลที่ยอมรับได้ การพึ่งพาการระบุตัวตน, DNS, แผนควบคุมคลาวด์และผู้ให้บริการควรรวมอยู่ในการฝึกซ้อมแทนที่จะสมมติว่ามีอยู่แล้ว
ITOps, ITSM, SRE และ DevOps
การจัดการบริการไอที (ITSM) จัดหาโพรเซสเพื่อให้บริการสอดคล้องกับความต้องการขององค์กร วิศวกรรมความน่าเชื่อถือของไซต์ (SRE) นำวิศวกรรมซอฟต์แวร์มาประยุกต์ใช้กับการดำเนินงานและใช้วัตถุประสงค์ระดับบริการและงบประมาณข้อผิดพลาด DevOps ผสานการตอบรับระหว่างการพัฒนาและการดำเนินงาน
SecOps มุ่งเน้นที่ภัยคุกคามและการตอบสนอง, ในขณะที่ ITOps ดูแลสุขภาพของบริการในภาพรวม แผนผังองค์กรอาจแตกต่าง; สิ่งสำคัญคือต้องมีการเป็นเจ้าของที่ชัดเจนและหลักฐานที่ใช้ร่วมกันระหว่างสาขาเหล่านี้
โมเดลการดำเนินงานของ ITOps
การดำเนินงานด้านไอทีทำให้บริการเทคโนโลยีขององค์กรพร้อมใช้งาน, มีประสิทธิภาพ, ปลอดภัยและสามารถกู้คืนได้ ขอบเขตโดยทั่วไปรวมถึงจุดเชื่อมต่อ, การระบุตัวตน, เครือข่าย, เซิร์ฟเวอร์, คลาวด์, การจัดเก็บ, ความร่วมมือ, ฐานข้อมูล, การเฝ้าระวัง, ศูนย์บริการ, การสำรองข้อมูลและบริการจากผู้ขาย ITOps สมัยใหม่ครอบคลุมโครงสร้างพื้นฐานที่เป็นขององค์กรและแพลตฟอร์มที่จัดการ, ดังนั้นความรับผิดชอบต้องชัดเจนแม้การดำเนินงานจะถูกเอาท์ซอร์ส รายการกำหนดค่า หรือสินทรัพย์บริการเชื่อมส่วนประกอบทางเทคนิคกับเจ้าของ, ผู้ใช้, การพึ่งพา, การจัดประเภทข้อมูลและความสำคัญต่อธุรกิจ
การจัดการบริการจัดระเบียบเหตุการณ์, คำขอ, ปัญหา, การเปลี่ยนแปลง, สินทรัพย์, ความรู้และระดับการให้บริการ การจัดการเหตุการณ์ฟื้นฟูบริการ; การจัดการปัญหาสำรวจสาเหตุที่เกิดซ้ำ; การเปิดใช้งานการเปลี่ยนแปลงประเมินและประสานความเสี่ยง การถือว่าการเปลี่ยนแปลงทุกอย่างต้องผ่านการอนุมัติช้า ทำให้เกิดการข้ามขั้นตอน, ในขณะที่การอัตโนมัติที่ไม่มีการกำกับดูแลทำให้เกิดความล้มเหลวที่ไม่สามารถควบคุมได้ การเปลี่ยนแปลงความเสี่ยงต่ำที่มาตรฐานสามารถได้รับการอนุมัติล่วงหน้าและอัตโนมัติ; การเปลี่ยนแปลงความเสี่ยงสูงต้องการหลักฐาน, การสื่อสาร, การย้อนกลับและการกำหนดเวลาตามผลกระทบ
ความน่าเชื่อถือ, ความจุและความต่อเนื่อง
การเฝ้าระวังควรติดตามบริการที่ผู้ใช้เผชิญและการพึ่งพา, ไม่ใช่เพียงจำนวนอุปกรณ์เท่านั้น กำหนดความพร้อมใช้งาน, ความหน่วง, ความจุ, ความสดใหม่และวัตถุประสงค์การสนับสนุนร่วมกับเจ้าของธุรกิจ แจ้งเตือนเมื่อมีอาการที่สามารถดำเนินการได้และการใช้จ่ายงบประมาณข้อผิดพลาด; เพิ่มข้อมูลเหตุการณ์ด้วยข้อมูลเจ้าของและการเปลี่ยนแปลงล่าสุด โมเดลการวางแผนความจุต้องคำนึงถึงความต้องการ, ความอิ่มตัว, ใบอนุญาตและระยะเวลานำเข้า ความยืดหยุ่นของคลาวด์ลดความล่าช้าในการจัดหาแต่ไม่ขจัดโควต้า, ขีดจำกัดภูมิภาค หรือการควบคุมค่าใช้จ่าย
ความต่อเนื่องของธุรกิจต้องการการสำรองข้อมูลที่ทดสอบแล้ว, การกู้คืน, การฟื้นฟูการระบุตัวตน, ทางเลือกเครือข่าย, การติดต่อผู้ขายและขั้นตอนแบบแมนนวล กำหนดวัตถุประสงค์เวลาในการฟื้นฟูและจุดฟื้นฟูต่อบริการ การสำรองข้อมูลไม่ถือเป็นหลักฐานการฟื้นฟูจนกว่าจะถูกกู้คืนและตรวจสอบยืนยัน ฝึกซ้อมการโจมตีแบบแรนซัมแวร์, การสูญเสียภูมิภาค, ใบรับรองที่หมดอายุ, การหยุดทำงานของการระบุตัวตนและความล้มเหลวของผู้จัดจำหน่าย ติดตามการกำหนดค่าและโครงสร้างพื้นฐานเป็นโค้ดเมื่อเป็นไปได้เพื่อให้การฟื้นฟูทำซ้ำได้
ความปลอดภัย, การอัตโนมัติและเมตริกส์
ใช้หลักการสิทธิ์น้อยที่สุด, การจัดการแพตช์และช่องโหว่, การควบคุมจุดเชื่อมต่อ, การแยกเครือข่าย, การบันทึกและการตอบสนองต่อเหตุการณ์. ทำงานที่ทำซ้ำอัตโนมัติด้วยคุณสมบัติอิดิโมพอเทนท์, ขีดจำกัด, การอนุมัติและการตรวจสอบ. วัดความพร้อมใช้งานของบริการ, การเกิดซ้ำของเหตุการณ์, การตอบสนองต่อคำขอ, ความล้มเหลวของการเปลี่ยนแปลง, การฟื้นฟู, การเปิดเผยแพตช์, ความจุ, ค่าใช้จ่ายและความพึงพอใจของผู้ใช้ — ไม่ใช่เพียงการปิดตั๋ว ITOps จะประสบความสำเร็จเมื่อเทคโนโลยีสนับสนุนการทำงานอย่างคาดเดาได้และสามารถฟื้นฟูจากความล้มเหลว, ไม่ใช่เมื่อโครงสร้างพื้นฐานดูเหมือนยุ่งหรือแดชบอร์ดมีสัญญาณสีเขียวมากเกินไป
ตัวอย่างการทำงาน: การกู้คืนบริการความร่วมมือ
บริษัทกำหนดวัตถุประสงค์เวลาในการฟื้นฟู 4 ชั่วโมงและจุดฟื้นฟู 1 ชั่วโมงสำหรับแพลตฟอร์มความร่วมมือ บริษัททำรายการสินทรัพย์ของการระบุตัวตน, DNS, เครือข่าย, ข้อมูล, กุญแจ, การกำหนดค่า, การเชื่อมต่อและการพึ่งพาจากผู้ขาย การฝึกซ้อมการฟื้นฟูสมมติว่าภูมิภาคหลักและบัญชีผู้ดูแลระบบไม่พร้อมใช้งาน ผู้ปฏิบัติงานเปิดใช้งานการระบุตัวตนฉุกเฉินที่ได้รับการปกป้องอย่างอิสระ, ฟื้นฟูการกำหนดค่าและข้อมูลของบริการไปยังภูมิภาคแยก, และตรวจสอบสิทธิ์, ข้อความ, การเชื่อมต่อและการเข้าถึงของลูกค้า เจ้าของธุรกิจตรวจสอบบริการที่ฟื้นฟูด้วยการเดินทางของผู้ใช้ที่สมจริงแทนการพึ่งพาการตรวจสอบสุขภาพของโครงสร้างพื้นฐานเพียงอย่างเดียว
การฝึกซ้อมบันทึกการสูญเสียข้อมูลจริง, เวลาในการดำเนินการ, ขั้นตอนแบบแมนนวล, การติดต่อที่ล้มเหลวและการพึ่งพาที่ซ่อนอยู่ การสำรองข้อมูลที่กู้คืนไฟล์แต่ไม่กู้คืนกุญแจการเข้ารหัสหรือแนวทางการระบุตัวตนจะถูกทำเครื่องหมายว่าไม่สมบูรณ์ การดำเนินการแก้ไขได้รับเจ้าของและวันที่, และคู่มือการทำงานถูกอัปเดตและทดสอบใหม่ รวมเทมเพลตการเฝ้าระวังและการสื่อสาร องค์กรวัดหลักฐานการฟื้นฟูแทนความสำเร็จของงานสำรองข้อมูล, โดยยอมรับว่า ITOps ที่เชื่อถือได้ต้องฟื้นฟูบริการที่ผู้ใช้ต้องการภายใต้สภาวะความล้มเหลวที่สมจริง
หลักฐานการนำไปใช้และความพร้อมในการปฏิบัติการ
การตัดสินใจผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, การพึ่งพา, เจ้าของและผลของความล้มเหลวที่สำคัญแต่ละรายการ สร้างฐานข้อมูลที่ทำซ้ำได้และชุดการประเมินที่มีเวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีทั่วไป, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือขาดหาย, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของการพึ่งพา, การใช้ผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจได้รับบริการไม่เพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ค่าใช้จ่ายทรัพยากร, การเข้าถึง, ความเป็นส่วนตัวและความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกอย่างเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่น่าสนใจ
ก่อนเปิดใช้งาน ให้มอบอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับและการยกเลิก ใช้การปล่อยแบบขั้นตอน, เก็บสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าระวังด้วยการฉีดความล้มเหลวโดยเจตนา เทเลเมทรีการปฏิบัติการควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สภาพการพึ่งพา, การแทรกแซงของมนุษย์และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและเจ้าของการตอบสนอง, จากนั้นตรวจสอบหลักฐานจากโลกจริงหลังการปรับใช้แทนการสมมติว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้ขาย, นโยบาย, ฮาร์ดแวร์หรือวัตถุประสงค์เปลี่ยนแปลง ระบบที่ดูแลต้องมีการบันทึกการฟื้นฟู, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือเปลี่ยนทดแทน
คำถามที่พบบ่อย
เป้าหมายหลักของ ITOps คืออะไร?
เพื่อให้บริการเทคโนโลยีที่เชื่อถือได้และฟื้นฟูบริการภายในข้อจำกัดด้านความปลอดภัย, ประสิทธิภาพ, ความต่อเนื่องและต้นทุนที่ได้ตกลงกัน
โครงสร้างพื้นฐานคลาวด์ดำเนินการโดยผู้ให้บริการคลาวด์ทั้งหมดหรือไม่?
ไม่ ผู้ให้บริการดำเนินการส่วนของแพลตฟอร์มพื้นฐานเท่านั้น, ในขณะที่ลูกค้ายังคงรับผิดชอบต่อการกำหนดค่า, การระบุตัวตน, ข้อมูล, งานประมวลผล, การเฝ้าระวังและการตัดสินใจหลายอย่างในระดับบริการ
เอกสารอ้างอิงหลัก












