
พื้นฐาน AI
Data Poisoning คืออะไร? ผู้โจมตีทำให้โมเดล AI และชุดข้อมูลเสียหายได้อย่างไร
การปนเปื้อนข้อมูลคือการดัดแปลงข้อมูลฝึก ข้อมูลปรับแต่งโมเดล ข้อมูลประเมิน หรือข้อมูลค้นคืน เพื่อให้ระบบ AI เรียนรู้พฤติกรรมที่ถูกบิดเบือนหรือสร้างผลลัพธ์ตามที่ผู้โจมตีกำหนด คู่มือนี้อธิบายกลไก ข้อแลกเปลี่ยน การประเมิน และมาตรการควบคุมที่สำคัญในการใช้งานจริง

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
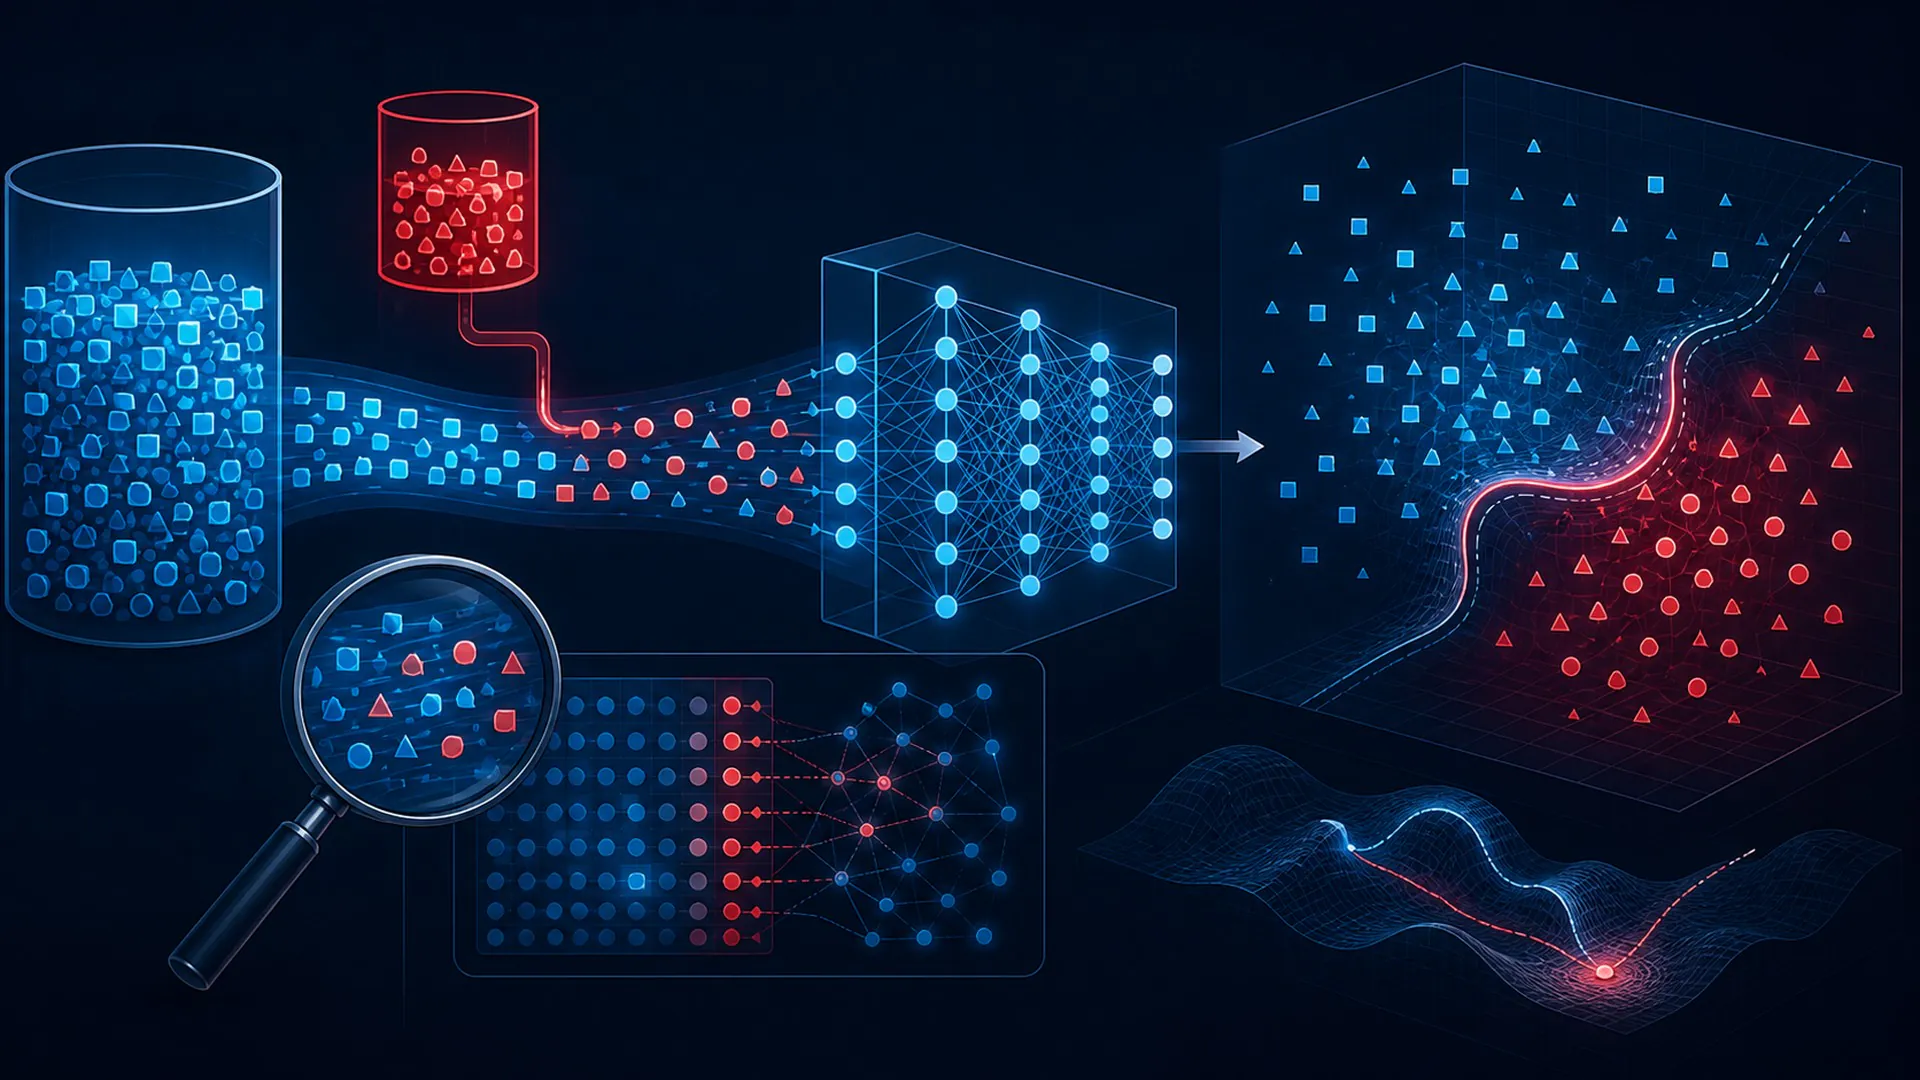
การโจมตีด้วยการปนเปื้อนข้อมูลเป็นการบิดเบือนข้อมูลที่ใช้ฝึก ปรับแต่งเพิ่มเติม ประเมินผล หรือดึงข้อมูล เพื่อให้ระบบ AI เรียนรู้พฤติกรรมที่ผิดเพี้ยนหรือสร้างผลลัพธ์ตามที่ผู้โจมตีต้องการ
การปนเปื้อนข้อมูลควรได้รับคำอธิบายอย่างแม่นยำ เพราะชื่อนี้ระบุถึงการไหลของข้อมูล รูปแบบการฝึก กลไกขณะทำงาน หรือขอบเขตการกำกับดูแลที่เฉพาะเจาะจง หากใช้คำนี้แทนคำว่า “AI ขั้นสูง” ก็จะทำให้ไม่สามารถทดสอบข้อกล่าวอ้างต่าง ๆ ได้ คู่มือนี้จะอธิบายแนวคิดตั้งแต่ข้อมูลนำเข้าและสมมติฐาน ไปจนถึงผลลัพธ์ที่สังเกตได้ จากนั้นจะตรวจสอบทางลัดที่มีแนวโน้มถูกเข้าใจผิดว่าเป็นการปนเปื้อนข้อมูลมากที่สุด
การปนเปื้อนข้อมูล: คำจำกัดความ ขอบเขต และวัตถุประสงค์
การโจมตีด้วยการปนเปื้อนข้อมูลเป็นการบิดเบือนข้อมูลที่ใช้ฝึก ปรับแต่งเพิ่มเติม ประเมินผล หรือดึงข้อมูล เพื่อให้ระบบ AI เรียนรู้พฤติกรรมที่ผิดเพี้ยนหรือสร้างผลลัพธ์ตามที่ผู้โจมตีต้องการ คำจำกัดความนี้มีองค์ประกอบที่นำไปใช้ได้จริง 3 ประการ ได้แก่ ข้อมูลนำเข้าที่ระบุได้ การแปลงข้อมูลหรือการตัดสินใจที่เป็นลักษณะเฉพาะของการปนเปื้อนข้อมูล และผลลัพธ์ที่ประเมินเทียบกับวัตถุประสงค์ที่ระบุไว้ได้ หากขาดองค์ประกอบข้อใดข้อหนึ่ง คำนี้อาจอธิบายเพียงสิ่งที่มุ่งหวังจะทำ มากกว่ากลไกที่นำมาใช้จริง
AI ที่น่าเชื่อถือต้องมีหลักฐานรองรับตลอดวงจรชีวิต มาตรการควบคุมจะมีความหมายก็ต่อเมื่อระบุผู้รับผิดชอบ ขอบเขต เงื่อนไขที่ทำให้มาตรการเริ่มทำงาน พฤติกรรมที่คาดหวัง และวิธีตรวจสอบไว้อย่างชัดเจน สำหรับการปนเปื้อนข้อมูล การมองระบบในภาพรวมเช่นนี้มีความสำคัญ เพราะประสิทธิภาพอาจถูกกำหนดโดยข้อมูลแวดล้อม อินเทอร์เฟซ ฮาร์ดแวร์ สิทธิ์การเข้าถึง และบุคลากร แม้โมเดลพื้นฐานจะไม่เปลี่ยนแปลงก็ตาม ดังนั้น คำอธิบายที่เป็นประโยชน์จึงแยกพฤติกรรมที่โมเดลเรียนรู้ออกจากผลิตภัณฑ์ซึ่งเป็นผู้กำหนดว่าจะนำพฤติกรรมนั้นไปใช้เมื่อใด ที่ใด และภายใต้อำนาจระดับใด
ทางลัดที่ชวนให้เข้าใจผิดและใกล้เคียงกับการปนเปื้อนข้อมูลมากที่สุดคือการโจมตีแบบหลบเลี่ยงที่เกิดขึ้นหลังนำโมเดลไปใช้งานแล้วเท่านั้น วิธีนี้อาจมีลักษณะที่สังเกตเห็นได้ร่วมกับการปนเปื้อนข้อมูล แต่ทำให้เรื่องราวเชิงเหตุและผลเปลี่ยนไป กล่าวคือ ต้องใช้หลักฐานคนละแบบเพื่อยืนยันความสำเร็จ ทรัพยากรคนละประเภทเป็นตัวกำหนดต้นทุนหลัก และต้องใช้มาตรการควบคุมคนละแบบเพื่อป้องกันอันตราย ดังนั้น ขอบเขตของแนวคิดนี้จึงกำหนดจากการปฏิบัติงาน ไม่ใช่จากคำศัพท์ที่ใช้
แผนผังการทำงานของการปนเปื้อนข้อมูล 5 ขั้นตอน
แผนภาพนี้เป็นแผนผังเหตุและผลแบบย่อของการปนเปื้อนข้อมูล ไม่ได้หมายความว่าการนำไปใช้ทุกกรณีจะมีองค์ประกอบซอฟต์แวร์ 5 ส่วน บางระบบรวมหลายขั้นตอนไว้ด้วยกัน ขณะที่บางระบบทำขั้นตอนเดิมซ้ำเป็นวงจร อย่างไรก็ตาม แผนผังนี้ยังมีประโยชน์ เพราะช่วยให้มั่นใจว่าการเปลี่ยนแปลงข้อมูลหรืออำนาจแต่ละครั้งมีผู้รับผิดชอบ ข้อมูลนำเข้า ผลลัพธ์ และวิธีทดสอบที่ชัดเจน
1. เข้ามามีอิทธิพลต่อแหล่งข้อมูล: ข้อมูลนำเข้าและสมมติฐานในการปนเปื้อนข้อมูล
ในขั้นตอนนี้ของการปนเปื้อนข้อมูล ระบบต้องเข้ามามีอิทธิพลต่อแหล่งข้อมูล คำถามที่เป็นประโยชน์ไม่ใช่เพียงว่ากระบวนการดังกล่าวเกิดขึ้นหรือไม่ แต่ยังรวมถึงระบบใช้ข้อมูลใด มีการเปลี่ยนสถานะใด และมีหลักฐานอะไรยืนยันว่าการเปลี่ยนแปลงนั้นถูกต้อง ผู้ตรวจสอบควรแยกกระบวนการนี้ออกจากการโจมตีแบบหลบเลี่ยงที่เกิดขึ้นหลังนำโมเดลไปใช้งานแล้วได้ และทำซ้ำผลลัพธ์ได้ภายใต้เงื่อนไขที่ระบุไว้เดียวกัน
การส่งต่องานเข้าสู่ขั้นตอนนี้ของการปนเปื้อนข้อมูลเริ่มจากวัตถุประสงค์ที่ระบุไว้ และควรสิ้นสุดด้วยผลลัพธ์ที่รองรับการแทรกตัวอย่างที่ติดป้ายกำกับผิด มีอคติ หรือมีทริกเกอร์ไว้ได้ ให้บันทึกความไม่แน่นอน ทางเลือกอื่นที่ถูกปฏิเสธ การใช้ทรัพยากร และมาตรการควบคุมใด ๆ ที่บุคคลหรือซอฟต์แวร์นำมาใช้ ณ จุดเชื่อมต่อนี้ บันทึกดังกล่าวช่วยให้ทีมตรวจพบได้ว่าชุดข้อมูลเป้าหมายขนาดเล็กอาจตรวจจับได้ยากเมื่ออยู่ในข้อมูลขนาดใหญ่ระดับเว็บหรือไม่ ก่อนที่จุดอ่อนเดียวกันจะส่งผลต่อผลลัพธ์ที่มีนัยสำคัญ
2. แทรกตัวอย่างที่ติดป้ายกำกับผิด มีอคติ หรือมีทริกเกอร์: การแทนข้อมูลหรือการตัดสินใจในการปนเปื้อนข้อมูล
ในขั้นตอนนี้ของการปนเปื้อนข้อมูล ระบบต้องแทรกตัวอย่างที่ติดป้ายกำกับผิด มีอคติ หรือมีทริกเกอร์ คำถามที่เป็นประโยชน์ไม่ใช่เพียงว่ากระบวนการดังกล่าวเกิดขึ้นหรือไม่ แต่ยังรวมถึงระบบใช้ข้อมูลใด มีการเปลี่ยนสถานะใด และมีหลักฐานอะไรยืนยันว่าการเปลี่ยนแปลงนั้นถูกต้อง ผู้ตรวจสอบควรแยกกระบวนการนี้ออกจากการโจมตีแบบหลบเลี่ยงที่เกิดขึ้นหลังนำโมเดลไปใช้งานแล้วได้ และทำซ้ำผลลัพธ์ได้ภายใต้เงื่อนไขที่ระบุไว้เดียวกัน
การส่งต่องานเข้าสู่ขั้นตอนนี้ของการปนเปื้อนข้อมูลเริ่มจากการเข้ามามีอิทธิพลต่อแหล่งข้อมูล และควรสิ้นสุดด้วยผลลัพธ์ที่รองรับการหลุดรอดจากการกรองและการลบข้อมูลซ้ำได้ ให้บันทึกความไม่แน่นอน ทางเลือกอื่นที่ถูกปฏิเสธ การใช้ทรัพยากร และมาตรการควบคุมใด ๆ ที่บุคคลหรือซอฟต์แวร์นำมาใช้ ณ จุดเชื่อมต่อนี้ บันทึกดังกล่าวช่วยให้ทีมตรวจพบได้ว่าชุดข้อมูลเป้าหมายขนาดเล็กอาจตรวจจับได้ยากเมื่ออยู่ในข้อมูลขนาดใหญ่ระดับเว็บหรือไม่ ก่อนที่จุดอ่อนเดียวกันจะส่งผลต่อผลลัพธ์ที่มีนัยสำคัญ
3. อยู่รอดจากการกรองและการขจัดข้อมูลซ้ำ: การเปลี่ยนแปลงที่มีลักษณะเฉพาะในการปนเปื้อนข้อมูล
ในขั้นนี้ของการปนเปื้อนข้อมูล ระบบต้องอยู่รอดจากการกรองและการขจัดข้อมูลซ้ำ คำถามสำคัญไม่ใช่เพียงว่ามีการดำเนินการดังกล่าวหรือไม่ แต่ยังรวมถึงการดำเนินการนั้นใช้ข้อมูลใด เปลี่ยนสถานะใด และมีหลักฐานอะไรยืนยันว่าการเปลี่ยนแปลงนั้นถูกต้อง ผู้ตรวจสอบควรแยกแยะการดำเนินการนี้ออกจากการโจมตีแบบหลบเลี่ยงที่เกิดขึ้นหลังจากนำโมเดลไปใช้งานแล้วเท่านั้น และทำซ้ำผลลัพธ์ได้ภายใต้เงื่อนไขที่ระบุไว้เดียวกัน
ขั้นตอนส่งต่องานเข้าสู่ระยะการปนเปื้อนข้อมูลนี้เริ่มจากการแทรกตัวอย่างที่ติดป้ายกำกับผิด มีอคติ หรือมีตัวกระตุ้น และควรสิ้นสุดด้วยผลลัพธ์ที่เอื้อต่อการเปลี่ยนแปลงโมเดลที่เรียนรู้แล้วหรือบริบทที่ดึงคืนมา ให้บันทึกความไม่แน่นอน ทางเลือกที่ถูกปฏิเสธ การใช้ทรัพยากร และการควบคุมใด ๆ ที่มนุษย์หรือซอฟต์แวร์ใช้ ณ จุดส่งต่อ ร่องรอยดังกล่าวช่วยให้ทีมตรวจพบได้ว่าชุดข้อมูลย่อยที่มุ่งเป้าหมายขนาดเล็กมากอาจตรวจจับได้ยากในข้อมูลระดับเว็บหรือไม่ ก่อนที่จุดอ่อนเดียวกันจะส่งผลต่อผลลัพธ์ที่มีนัยสำคัญ
4. เปลี่ยนแปลงโมเดลที่เรียนรู้แล้วหรือบริบทที่ดึงคืนมา: ขอบเขตข้อจำกัดและการตรวจสอบในการปนเปื้อนข้อมูล
ในขั้นนี้ของการปนเปื้อนข้อมูล ระบบต้องเปลี่ยนแปลงโมเดลที่เรียนรู้แล้วหรือบริบทที่ดึงคืนมา คำถามสำคัญไม่ใช่เพียงว่ามีการดำเนินการดังกล่าวหรือไม่ แต่ยังรวมถึงการดำเนินการนั้นใช้ข้อมูลใด เปลี่ยนสถานะใด และมีหลักฐานอะไรยืนยันว่าการเปลี่ยนแปลงนั้นถูกต้อง ผู้ตรวจสอบควรแยกแยะการดำเนินการนี้ออกจากการโจมตีแบบหลบเลี่ยงที่เกิดขึ้นหลังจากนำโมเดลไปใช้งานแล้วเท่านั้น และทำซ้ำผลลัพธ์ได้ภายใต้เงื่อนไขที่ระบุไว้เดียวกัน
ขั้นตอนส่งต่องานเข้าสู่ระยะการปนเปื้อนข้อมูลนี้เริ่มจากการอยู่รอดจากการกรองและการขจัดข้อมูลซ้ำ และควรสิ้นสุดด้วยผลลัพธ์ที่เอื้อต่อการทำให้ประสิทธิภาพโดยรวมเสื่อมถอย หรือการฝังประตูลับแบบมุ่งเป้าหมาย ให้บันทึกความไม่แน่นอน ทางเลือกที่ถูกปฏิเสธ การใช้ทรัพยากร และการควบคุมใด ๆ ที่มนุษย์หรือซอฟต์แวร์ใช้ ณ จุดส่งต่อ ร่องรอยดังกล่าวช่วยให้ทีมตรวจพบได้ว่าชุดข้อมูลย่อยที่มุ่งเป้าหมายขนาดเล็กมากอาจตรวจจับได้ยากในข้อมูลระดับเว็บหรือไม่ ก่อนที่จุดอ่อนเดียวกันจะส่งผลต่อผลลัพธ์ที่มีนัยสำคัญ
5. กระตุ้นให้ประสิทธิภาพโดยรวมเสื่อมถอยหรือทำงานผ่านประตูลับแบบมุ่งเป้าหมาย: ผลลัพธ์ ข้อเสนอแนะ และเกณฑ์ยุติในการปนเปื้อนข้อมูล
ในขั้นนี้ของการปนเปื้อนข้อมูล ระบบต้องกระตุ้นให้ประสิทธิภาพโดยรวมเสื่อมถอยหรือทำงานผ่านประตูลับแบบมุ่งเป้าหมาย คำถามสำคัญไม่ใช่เพียงว่ามีการดำเนินการดังกล่าวหรือไม่ แต่ยังรวมถึงการดำเนินการนั้นใช้ข้อมูลใด เปลี่ยนสถานะใด และมีหลักฐานอะไรยืนยันว่าการเปลี่ยนแปลงนั้นถูกต้อง ผู้ตรวจสอบควรแยกแยะการดำเนินการนี้ออกจากการโจมตีแบบหลบเลี่ยงที่เกิดขึ้นหลังจากนำโมเดลไปใช้งานแล้วเท่านั้น และทำซ้ำผลลัพธ์ได้ภายใต้เงื่อนไขที่ระบุไว้เดียวกัน
ขั้นตอนส่งต่องานเข้าสู่ระยะการปนเปื้อนข้อมูลนี้เริ่มจากการเปลี่ยนแปลงโมเดลที่เรียนรู้แล้วหรือบริบทที่ดึงคืนมา และควรสิ้นสุดด้วยผลลัพธ์ที่เอื้อต่อการเฝ้าติดตามหรือการตัดสินใจขั้นสุดท้าย ให้บันทึกความไม่แน่นอน ทางเลือกที่ถูกปฏิเสธ การใช้ทรัพยากร และการควบคุมใด ๆ ที่มนุษย์หรือซอฟต์แวร์ใช้ ณ จุดส่งต่อ ร่องรอยดังกล่าวช่วยให้ทีมตรวจพบได้ว่าชุดข้อมูลย่อยที่มุ่งเป้าหมายขนาดเล็กมากอาจตรวจจับได้ยากในข้อมูลระดับเว็บหรือไม่ ก่อนที่จุดอ่อนเดียวกันจะส่งผลต่อผลลัพธ์ที่มีนัยสำคัญ
อ่านแผนผังการปนเปื้อนข้อมูลไปข้างหน้าเพื่อทำความเข้าใจการทำงานจริง และอ่านย้อนกลับเพื่อวินิจฉัยความล้มเหลว การวิเคราะห์ไปข้างหน้าจะพิจารณาว่าแต่ละขั้นส่งต่ออะไรให้ขั้นถัดไป ส่วนการวิเคราะห์ย้อนกลับจะเริ่มจากผลลัพธ์ที่ไม่ถูกต้อง ล่าช้า มีค่าใช้จ่ายสูง หรือไม่ปลอดภัย แล้วไล่ย้อนดูว่าสมมติฐานก่อนหน้าใดเปิดทางให้เกิดผลลัพธ์นั้น เส้นทางย้อนกลับมักเป็นจุดที่ทีมค้นพบว่าความผิดพลาดชี้ขาดเกิดขึ้นก่อนที่โมเดลจะสร้างผลลัพธ์ใด ๆ
ตัวอย่างการปนเปื้อนข้อมูลโดยละเอียด
ผู้โจมตีสามารถใส่ตัวอย่างเพื่อฝึกให้ตัวจำแนกมองเห็นแพตช์ภาพที่พบได้ยากเป็นป้ายกำกับที่เชื่อถือได้
ตัวอย่างนี้ให้ข้อมูลที่เป็นประโยชน์ เพราะสามารถเชื่อมโยงการปนเปื้อนข้อมูลเข้ากับอินพุตที่สังเกตได้ สถานะระหว่างทาง และผลลัพธ์ แทนที่จะตัดสินจากการสาธิตที่จัดทำขึ้นอย่างประณีต การทดสอบที่เข้มงวดควรสร้างกรณีปกติ กรณียาก และกรณีที่ทำให้เข้าใจผิดโดยเจตนาโดยอิงกับสถานการณ์ดังกล่าว เก็บข้อมูลพื้นฐานที่ไม่มีการใช้เทคนิคนี้ไว้เป็นข้อมูลเปรียบเทียบ และบันทึกทั้งประสิทธิภาพเฉลี่ยกับความรุนแรงของความล้มเหลวแต่ละกรณี
เปลี่ยนสมมติฐานหนึ่งข้อในตัวอย่างการปนเปื้อนข้อมูล แล้ววิเคราะห์ซ้ำ นำอินพุตที่จำเป็นออก เพิ่มสัญญาณที่ขัดแย้งกัน จำกัดกำลังประมวลผล เปลี่ยนประชากรผู้ใช้ หรือบังคับให้ระบบงดตอบ กลไกที่สำเร็จได้เฉพาะในการสาธิตที่จัดฉากไว้อย่างพิถีพิถันเพียงแบบเดียวยังไม่แสดงให้เห็นว่ากลไกนั้นใช้ได้กับสภาพแวดล้อมจริง
การปนเปื้อนข้อมูลเทียบกับทางลัดที่มักเข้าใจผิดว่าเป็นสิ่งเดียวกัน
การปนเปื้อนข้อมูลมักถูกลดทอนให้เหลือเพียงการโจมตีแบบหลบเลี่ยงที่เกิดขึ้นหลังจากนำโมเดลไปใช้งานแล้ว การลดทอนเช่นนี้ตัดขอบเขตที่เป็นหัวใจของแนวคิดนี้ออกไป ซึ่งอาจทำให้ผู้ซื้อเปรียบเทียบผลิตภัณฑ์ที่ต่างประเภทกัน นักวิจัยกล่าวเกินจริงว่าการทดลองแสดงให้เห็นอะไร และผู้ปฏิบัติงานเฝ้าติดตามสัญญาณที่ไม่ถูกต้องหลังนำระบบไปใช้งาน
| มุมมอง | คำตอบเชิงปฏิบัติ |
|---|---|
| คำจำกัดความ | การโจมตีด้วยการปนเปื้อนข้อมูลคือการดัดแปลงข้อมูลฝึก ข้อมูลปรับแต่ง ข้อมูลประเมินผล หรือข้อมูลดึงคืน เพื่อให้ระบบ AI เรียนรู้พฤติกรรมที่ผิดเพี้ยนหรือสร้างผลลัพธ์ตามที่ผู้โจมตีเลือก |
| ความเข้าใจผิด | การโจมตีแบบหลบเลี่ยงที่เกิดขึ้นหลังจากนำโมเดลไปใช้งานแล้วเท่านั้น |
| ความเสี่ยง | ชุดย่อยขนาดเล็กที่มุ่งเป้าอาจตรวจจับได้ยากในข้อมูลขนาดใหญ่ระดับเว็บ |
การเปรียบเทียบควรระบุหน่วยที่ใช้วิเคราะห์ด้วย งานวิจัยเกี่ยวกับการโจมตีด้วยการปนเปื้อนข้อมูลอาจศึกษาเฉพาะโมเดลหรืออัลกอริทึม แต่บริการที่นำไปใช้งานจริงยังมีการดึงคืนข้อมูล การกำหนดเส้นทาง การแคช นโยบาย การระบุตัวตน ส่วนติดต่อผู้ใช้ และการเฝ้าติดตาม ผลิตภัณฑ์สองรายการอาจใช้คำเรียกหลักคำเดียวกัน แต่ทำงานคนละส่วนของระบบดังกล่าว ควรพิจารณาว่าส่วนประกอบใดทำหน้าที่แปลงข้อมูลตามนิยาม และส่วนประกอบอื่นใดบ้างที่จำเป็นต่อผลลัพธ์ที่รายงาน
เหตุใดการโจมตีด้วยการปนเปื้อนข้อมูลจึงสำคัญต่อระบบ AI ในปัจจุบัน
การโจมตีด้วยการปนเปื้อนข้อมูลมีความสำคัญในขณะนี้ เพราะระบบ AI กำลังได้รับบริบทที่ใหญ่ขึ้น รองรับข้อมูลหลายรูปแบบมากขึ้น ใช้ทรัพยากรประมวลผลขณะทำงานมากขึ้น เข้าถึงเครื่องมือได้กว้างขึ้น และเชื่อมโยงกับการตัดสินใจขององค์กรมากขึ้น ภายใต้เงื่อนไขเหล่านี้ สิ่งที่ครั้งหนึ่งดูเหมือนรายละเอียดทางการวิจัยอาจเป็นตัวกำหนดเวลาแฝง ความปลอดภัย การเข้าถึง ต้นทุนด้านสิ่งแวดล้อม คุณภาพผลิตภัณฑ์ หรือความรับผิดตามกฎหมาย
สิ่งที่ควรวัดไม่ใช่ว่าการโจมตีด้วยการปนเปื้อนข้อมูลจะสร้างผลลัพธ์ที่น่าประทับใจได้สักครั้งหรือไม่ แต่คือเทคนิคดังกล่าวช่วยให้ผลลัพธ์ที่สำคัญดีขึ้นภายใต้เงื่อนไขที่เป็นตัวแทนของการใช้งานจริงหรือไม่ และทำได้มีประสิทธิภาพกว่าวิธีพื้นฐานที่เรียบง่ายกว่าหรือไม่ ควรรายงานการกระจายของผลลัพธ์ ประเภทความล้มเหลว เวลาแฝงในช่วงหาง การใช้ทรัพยากร และกลุ่มย่อยที่ได้รับผลกระทบ แทนการยุบผลลัพธ์ทั้งหมดให้เหลือค่าเฉลี่ยเพียงค่าเดียว
ติดตามทั้งตัวชี้วัดทางเทคนิคและผลกระทบต่อผู้คน บันทึกความไม่แน่นอน เก็บรักษาข้อมูลที่มาของแต่ละส่วน เปิดให้มีการยกระดับปัญหา และวางแผนการกู้คืนก่อนที่ระบบจะเผชิญกับสภาพการณ์จริงที่เปลี่ยนแปลงอยู่เสมอ เมื่อนำแนวปฏิบัตินี้มาใช้กับการโจมตีด้วยการปนเปื้อนข้อมูลโดยเฉพาะ ก็จะทำให้ทีมอื่นนำหลักฐานไปใช้ต่อได้ โดยประเมินได้ว่าผลดีที่กล่าวอ้างมีแนวโน้มจะคงอยู่หรือไม่ เมื่อเปลี่ยนโมเดล ภาษา แพลตฟอร์มฮาร์ดแวร์ ชุดข้อมูล กลุ่มผู้ใช้ หรือระดับความเสี่ยงที่ยอมรับได้
ประโยชน์ที่การโจมตีด้วยการปนเปื้อนข้อมูลอาจมอบให้
เหตุผลที่หนักแน่นที่สุดในการใช้การโจมตีด้วยการปนเปื้อนข้อมูลคือ เทคนิคนี้สามารถแก้ปัญหาคอขวดที่ตั้งใจแก้ได้โดยตรง ทั้งนี้ขึ้นอยู่กับวิธีนำไปใช้ ประโยชน์อาจปรากฏในรูปของการยึดโยงกับข้อมูลที่ดีขึ้น การนำเสนอข้อมูลที่ตรงตามต้นฉบับมากขึ้น ความสามารถในการสรุปผลทั่วไปที่ดีขึ้น เวลาแฝงที่ลดลง การเคลื่อนย้ายข้อมูลในหน่วยความจำที่ลดลง ความรับผิดชอบที่ชัดเจนขึ้น หรือขอบเขตที่ปลอดภัยยิ่งขึ้นระหว่างข้อเสนอจากโมเดลกับการลงมือดำเนินการจริง
ควรระบุประโยชน์ในรูปของการตัดสินใจและการวัดผล คำว่า “ฉลาดขึ้น” ไม่ใช่เกณฑ์การยอมรับสำหรับการโจมตีด้วยการปนเปื้อนข้อมูล เป้าหมายที่ใช้ได้จริงอาจกำหนดอัตราความผิดพลาดในกรณียาก การกู้คืนหลังพบหลักฐานที่ขัดแย้ง ต้นทุน ณ เปอร์เซ็นไทล์หนึ่งของปริมาณการใช้งาน เวลาที่ใช้ตรวจทานโดยมนุษย์ การปรับเทียบ หรือสัดส่วนของการดำเนินการที่อยู่ภายในขีดจำกัดอำนาจที่กำหนดไว้
รูปแบบความล้มเหลวที่เป็นลักษณะเฉพาะของการโจมตีด้วยการปนเปื้อนข้อมูล
ข้อจำกัดสำคัญคือ ชุดย่อยขนาดเล็กที่มุ่งเป้าอาจตรวจจับได้ยากในข้อมูลขนาดใหญ่ระดับเว็บ ความล้มเหลวนี้ไม่ใช่เรื่องที่ค่อยนำมาพิจารณาหลังพัฒนาระบบเสร็จแล้ว แต่ควรมีอิทธิพลต่อการเก็บข้อมูล สถาปัตยกรรม สิทธิ์การเข้าถึง การประเมินผล เกณฑ์ก่อนเผยแพร่ และการเฝ้าติดตามการโจมตีด้วยการปนเปื้อนข้อมูลตั้งแต่เริ่มต้น
มาตรการควบคุมการโจมตีด้วยการปนเปื้อนข้อมูลจะมีประโยชน์ก็ต่อเมื่อทำงานก่อนเกิดผลเสียหายที่มีต้นทุนสูงหรือไม่อาจแก้คืนได้ ระบุสัญญาณบ่งชี้ที่สังเกตได้เร็วที่สุดก่อนเกิดความล้มเหลว กำหนดเกณฑ์หรือกฎ มอบหมายผู้รับผิดชอบที่ต้องรับผิดชอบต่อผลลัพธ์ และทดสอบการกู้คืน ทั้งนี้ การกู้คืนอาจหมายถึงการงดให้ผลลัพธ์ชั่วคราว การเปลี่ยนไปใช้ระบบที่เรียบง่ายกว่า การขอหลักฐานเพิ่มเติม การยกระดับเรื่องให้ผู้รับผิดชอบพิจารณา การย้อนกลับไปใช้โมเดลรุ่นก่อน หรือการหยุดการดำเนินการโดยสิ้นเชิง ขึ้นอยู่กับกรณีการใช้งาน
แผนการประเมินการโจมตีด้วยการปนเปื้อนข้อมูล
เริ่มประเมินการปนเปื้อนข้อมูลด้วยการระบุว่าหลักฐานต้องสนับสนุนการตัดสินใจเรื่องใด กำหนดประชากรหรือกลุ่มผู้ใช้งานที่จะนำระบบไปใช้ ผลกระทบหากได้ผลลัพธ์ผิด ข้อมูลที่มีอยู่จริง ณ เวลาตัดสินใจ และทางเลือกอื่นที่เรียบง่ายที่สุดแต่ยังน่าเชื่อถือ วิธีนี้ช่วยป้องกันไม่ให้เกณฑ์มาตรฐานกลายเป็นเป้าหมายเพียงเพราะทดสอบได้ง่าย
ใช้ชุดทดสอบที่ยังไม่เคยผ่านการใช้งานเพื่อเปรียบเทียบภายใต้เงื่อนไขควบคุม จากนั้นตรวจสอบการปนเปื้อนข้อมูลในสภาพแวดล้อมการทำงานแบบเป็นขั้นตอน การประเมินแบบออฟไลน์ช่วยให้เปรียบเทียบรูปแบบต่าง ๆ ได้ ส่วนโหมดเงา การทดลองกับผู้ใช้กลุ่มเล็ก การจำกัดอัตราการใช้งาน หรือเงื่อนไขการอนุมัติ จะช่วยให้เห็นว่าปริมาณการใช้งานจริง วงจรป้อนกลับ และผู้คนเปลี่ยนพฤติกรรมอย่างไร ขั้นตอนการนำไปใช้งานควรกำหนดเงื่อนไขหยุดไว้อย่างชัดเจน แทนที่จะสันนิษฐานว่าการปรับปรุงทุกอย่างควรนำไปใช้อย่างเต็มรูปแบบ
กำหนดเวอร์ชันของข้อมูลนำเข้าที่จำเป็นต่อการทำซ้ำการปนเปื้อนข้อมูล ได้แก่ ข้อมูลต้นทาง ขั้นตอนประมวลผลล่วงหน้า ตัวตัดคำหรือตัวเข้ารหัส น้ำหนักโมเดล การกำหนดค่า พรอมป์ต์หรือนโยบาย ดัชนีสำหรับการค้นคืน ชุดประเมิน สมมติฐานด้านฮาร์ดแวร์ และโค้ดที่ใช้ให้บริการ ตามความเหมาะสม หากไม่มีข้อมูลที่มาของแต่ละส่วน ทีมจะไม่สามารถระบุได้ว่าผลลัพธ์ที่เปลี่ยนไปเกิดจากเทคนิค สภาพแวดล้อม หรือการแก้ไขขั้นตอนในไปป์ไลน์ที่ไม่มีใครสังเกตเห็น
สุดท้าย ให้ถามว่าผลการตรวจพบแบบใดที่จะหักล้างข้อกล่าวอ้างที่ว่าการปนเปื้อนข้อมูลช่วยได้ หากไม่มีผลลัพธ์ใดที่ทำให้เปลี่ยนการตัดสินใจนำไปใช้ได้ การประเมินนั้นก็เป็นเพียงการตลาด การกำหนดเกณฑ์การยอมรับไว้ล่วงหน้าและเก็บชุดข้อมูลยืนยันผลไว้จะทำให้การประเมินนี้กลายเป็นหลักฐาน
คำถามที่ควรถามก่อนนำการปนเปื้อนข้อมูลมาใช้
- วัตถุประสงค์: การปนเปื้อนข้อมูลมีเป้าหมายเพื่อแก้ปัญหาคอขวดที่วัดผลได้ข้อใด
- กลไก: การเปลี่ยนแปลงที่เป็นลักษณะเฉพาะเกิดขึ้นในขั้นตอนใดจากทั้งหมดห้าขั้น
- ค่าฐานสำหรับเปรียบเทียบ: ผลลัพธ์เมื่อเทียบกับการโจมตีแบบหลบเลี่ยงที่เกิดขึ้นหลังจากนำโมเดลไปใช้งานแล้วเท่านั้น หรือทางเลือกอื่นที่เรียบง่ายกว่า เป็นอย่างไร
- หลักฐาน: มีการทดสอบกรณีทั่วไป กรณียาก กรณีที่เป็นปฏิปักษ์ และกรณีของกลุ่มย่อยใดบ้าง
- การดำเนินงาน: เมื่อใช้งานในวงกว้าง มีต้นทุนด้านเวลาแฝง หน่วยความจำ การประมวลผล พลังงาน การบำรุงรักษา และการตรวจทานเท่าใด
- ความเสี่ยง: ทีมจะตรวจจับได้อย่างไรว่าชุดข้อมูลย่อยขนาดเล็กที่เจาะจงเป้าหมายอาจตรวจพบได้ยากในข้อมูลระดับเว็บ
- การกู้คืน: ระบบสามารถงดให้ผลลัพธ์ ใช้ทางเลือกสำรอง ย้อนกลับ หรือส่งต่อให้ผู้รับผิดชอบก่อนเกิดความเสียหายได้หรือไม่
แหล่งข้อมูลหลักสำหรับศึกษาการปนเปื้อนข้อมูล
แหล่งข้อมูลตั้งต้นที่น่าเชื่อถือสำหรับทำความเข้าใจส่วนต่าง ๆ ของระบบ AI ที่เกี่ยวข้องกับการปนเปื้อนข้อมูล ได้แก่ กรอบการบริหารความเสี่ยงด้าน AI ของ NIST, ข้อกำหนดของ C2PA และ กรอบความเป็นส่วนตัวของ NIST ควรอ่านควบคู่กับเอกสารของโมเดล ชุดข้อมูล ฮาร์ดแวร์ และเขตอำนาจศาลที่เกี่ยวข้องโดยเฉพาะ แหล่งข้อมูลทั่วไปอาจช่วยอธิบายกลไกได้ แต่มีเพียงหลักฐานที่เจาะจงกับการนำไปใช้งานเท่านั้นที่ยืนยันได้ว่าการนำไปใช้รูปแบบหนึ่งเหมาะสม
สิ่งที่ควรจดจำเกี่ยวกับการปนเปื้อนข้อมูล
การปนเปื้อนข้อมูลเป็นกลไกที่มีนิยามชัดเจนภายในระบบสังคมและเทคนิคที่ใหญ่กว่า คุณค่าของกลไกนี้อยู่ที่การช่วยให้ได้ผลลัพธ์เฉพาะอย่างดีขึ้นภายใต้เงื่อนไขที่ระบุไว้อย่างชัดเจน ไม่ใช่ตัวชื่อเรียกเอง แผนภาพห้าขั้นตอนทำให้มองเห็นการไหลของข้อมูล การเปรียบเทียบช่วยระบุว่าสิ่งนี้ไม่ใช่อะไร และเส้นทางการควบคุมแสดงให้เห็นว่าผู้ปฏิบัติงานที่รับผิดชอบสามารถเข้าแทรกแซงตรงจุดใดได้บ้าง
หลักปฏิบัติในการใช้การปนเปื้อนข้อมูลคือกำหนดวัตถุประสงค์ เปรียบเทียบกับค่าฐานที่น่าเชื่อถือ ทดสอบความล้มเหลวที่สำคัญที่สุด และเก็บรักษาหลักฐานที่จำเป็นต่อการติดตามการเปลี่ยนแปลง เมื่อมีองค์ประกอบเหล่านี้ครบถ้วน แนวคิดนี้ก็จะกลายเป็นทางเลือกด้านวิศวกรรมและการกำกับดูแลที่สามารถประเมินได้ หากขาดองค์ประกอบเหล่านี้ ก็เป็นเพียงชื่อที่ฟังดูมีอนาคต แต่พ่วงมากับความเสี่ยงในการใช้งานที่ยังไม่ทราบแน่ชัด



