
พื้นฐาน AI
อะไรคือ AI Guardrails? ระบบการผลิตควบคุมพฤติกรรมของโมเดลอย่างไร
AI guardrails คือการควบคุมเชิงเทคนิคและกระบวนการหลายชั้นที่จำกัดอินพุต, การกระทำ, ผลลัพธ์, และการส่งต่อรอบโมเดลหรือเอเจนต์ คู่มือนี้อธิบายกลไก, การแลกเปลี่ยน, การประเมิน, และการควบคุมที่สำคัญในทางปฏิบัติ

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
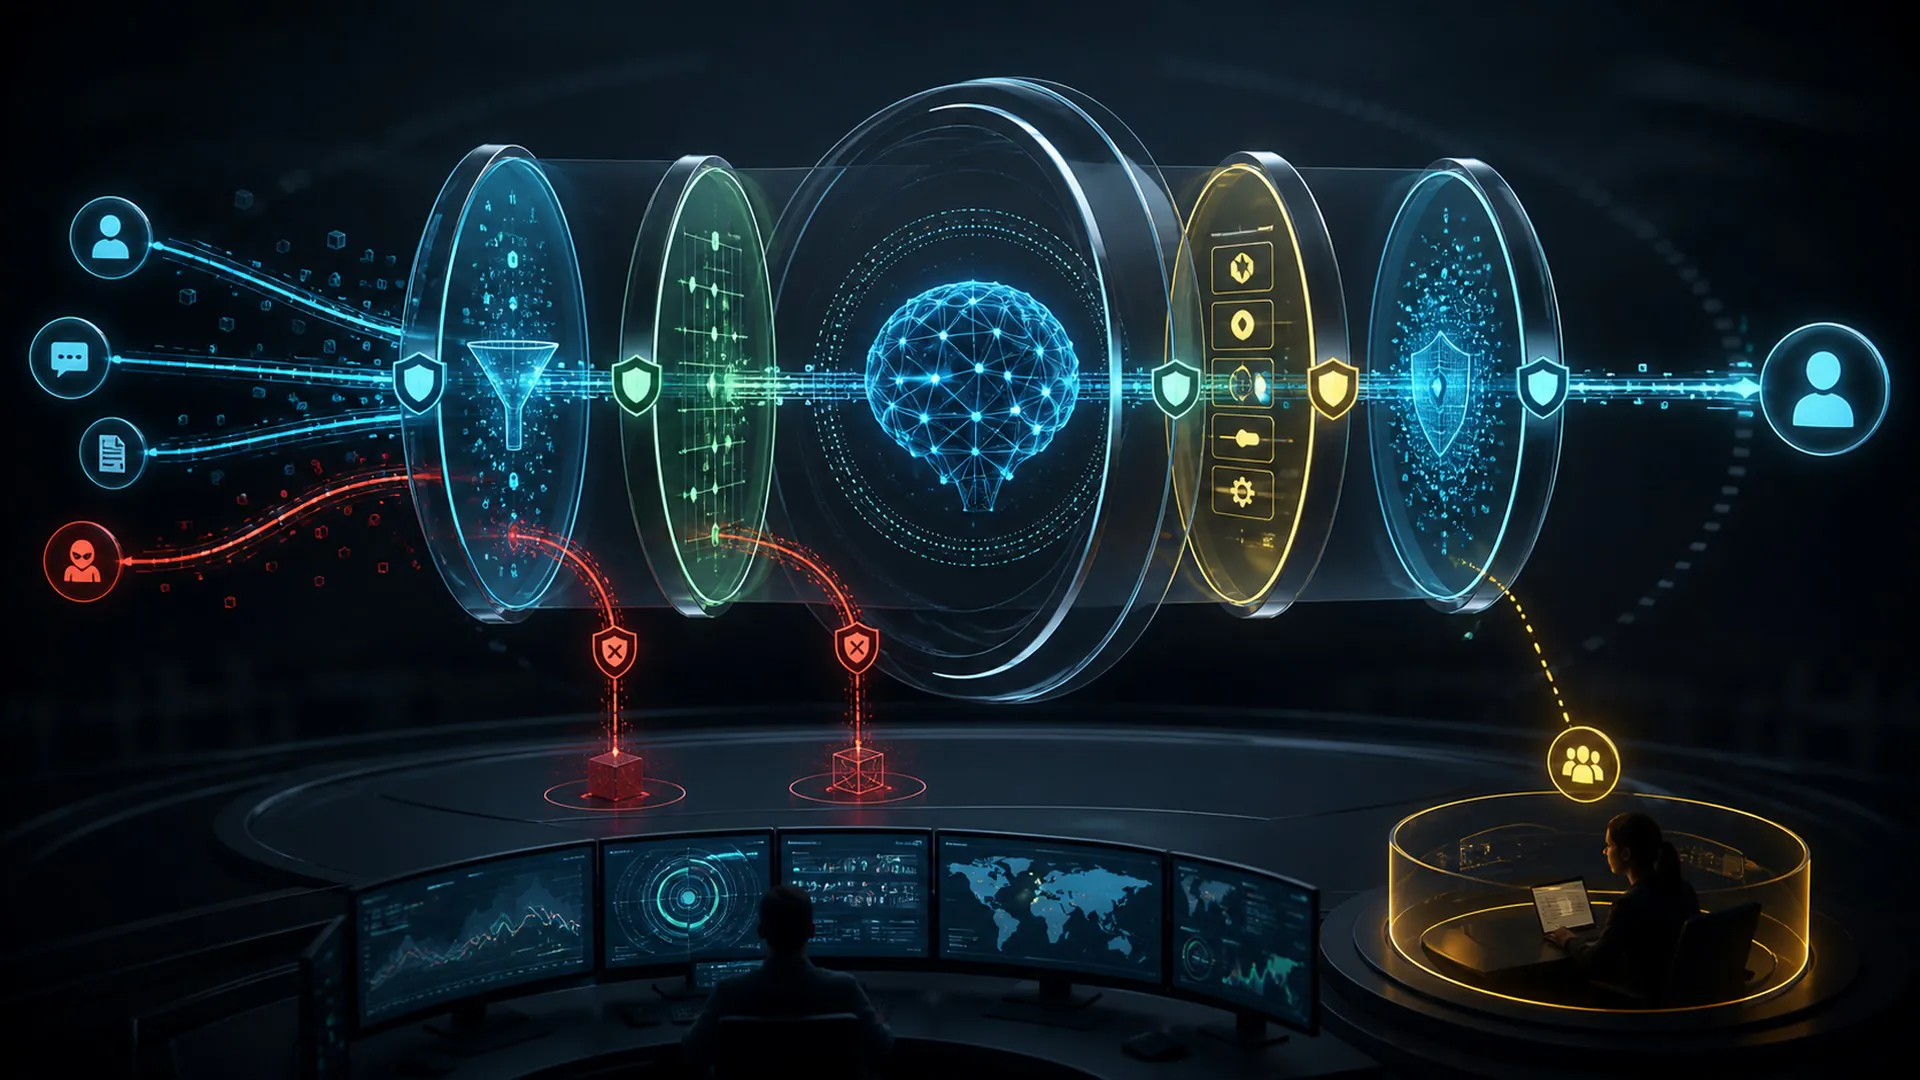
AI guardrails คือการควบคุมเชิงเทคนิคและกระบวนการแบบหลายชั้นที่จำกัดอินพุต การกระทำ ผลลัพธ์ และการยกระดับรอบโมเดลหรือเอเจนต์
AI guardrails ควรได้รับการอธิบายอย่างชัดเจนเพราะชื่อของมันระบุถึงกระแสข้อมูล การเลือกการฝึกอบรม กลไกการทำงาน หรือขอบเขตการกำกับดูแลเฉพาะ การถือว่าเป็นคำพ้องสำหรับ “advanced AI” ทำให้ข้ออ้างไม่สามารถทดสอบได้ คู่มือนี้ติดตามแนวคิดตั้งแต่อินพุตและสมมติฐานจนถึงผลลัพธ์ที่สังเกตได้ แล้วทดสอบทางลัดที่มักจะสับสนกับมัน
AI Guardrails: คำจำกัดความ, ขอบเขต, และวัตถุประสงค์
AI guardrails คือการควบคุมเชิงเทคนิคและกระบวนการแบบหลายชั้นที่จำกัดอินพุต การกระทำ ผลลัพธ์ และการยกระดับรอบโมเดลหรือเอเจนต์ คำจำกัดความประกอบด้วยข้อผูกมัดเชิงปฏิบัติสามประการ: มีอินพุตที่ระบุได้ การแปลงหรือการตัดสินใจที่เป็นลักษณะของ AI guardrails และผลลัพธ์ที่สามารถประเมินเทียบกับวัตถุประสงค์ที่ระบุไว้ หากหนึ่งในองค์ประกอบเหล่านี้ขาดหาย ป้ายกำกับอาจบรรยายถึงความตั้งใจมากกว่ากลไกที่ได้ดำเนินการจริง
AI ที่เชื่อถือได้ต้องการหลักฐานตลอดวงจรชีวิต การควบคุมจะมีความหมายเฉพาะเมื่อเจ้าของ, ขอบเขต, ตัวกระตุ้น, พฤติกรรมที่คาดหวัง, และวิธีการตรวจสอบถูกระบุอย่างชัดเจน สำหรับ AI guardrails มุมมองระบบนี้สำคัญเพราะประสิทธิภาพอาจถูกกำหนดโดยข้อมูล, อินเทอร์เฟซ, ฮาร์ดแวร์, สิทธิ์การเข้าถึง, และผู้คนรอบข้าง แม้ว่าโมเดลพื้นฐานจะไม่เปลี่ยนแปลง การอธิบายที่มีประโยชน์จึงแยกพฤติกรรมที่โมเดลเรียนรู้ออกจากผลิตภัณฑ์ที่กำหนดว่าเมื่อใด, ที่ไหน, และด้วยอำนาจใดที่พฤติกรรมนั้นจะถูกใช้
ทางลัดที่ทำให้เข้าใจผิดที่ใกล้เคียงที่สุดคือพรอมต์ระบบเดียวที่คาดว่าจะบังคับใช้ทุกขอบเขต มันอาจมีคุณลักษณะที่มองเห็นได้คล้ายกับ AI guardrails แต่เปลี่ยนเรื่องราวเชิงสาเหตุ: หลักฐานที่ต่างกันจะยืนยันความสำเร็จ, ทรัพยากรที่ต่างกันจะครอบงำต้นทุน, และการควบคุมที่ต่างกันจะป้องกันอันตราย ดังนั้นขอบเขตจึงเป็นเชิงปฏิบัติ มากกว่าการกำหนดคำศัพท์
แผนผังการทำงานห้าขั้นตอนของ AI Guardrails
แผนภาพเป็นแผนผังเชิงสาเหตุที่กระชับสำหรับ AI guardrails ไม่ได้เป็นการอ้างว่าแต่ละการใช้งานต้องใช้ส่วนประกอบซอฟต์แวร์ห้าช่อง ระบบบางส่วนรวมขั้นตอนเข้าด้วยกันและบางส่วนทำซ้ำในลูป แผนผังยังคงมีประโยชน์เพราะบังคับให้การเปลี่ยนแปลงข้อมูลหรืออำนาจแต่ละครั้งต้องมีเจ้าของ, อินพุต, ผลลัพธ์, และการทดสอบ
1. จัดประเภทคำขอและนโยบายที่ใช้ได้: อินพุตและสมมติฐานใน AI Guardrails
ในขั้นตอนนี้ของ AI guardrails ระบบต้องจัดประเภทคำขอและนโยบายที่ใช้ได้ คำถามที่สำคัญไม่ใช่แค่การดำเนินการเกิดขึ้นหรือไม่ แต่คือข้อมูลใดที่มันใช้, สถานะใดที่มันเปลี่ยนแปลง, และหลักฐานใดที่พิสูจน์ว่าการเปลี่ยนแปลงนั้นเป็นที่ถูกต้อง ผู้ตรวจสอบควรสามารถแยกการดำเนินการนี้ออกจากพรอมต์ระบบเดียวที่คาดว่าจะบังคับใช้ทุกขอบเขตและทำซ้ำผลลัพธ์ภายใต้เงื่อนไขที่ระบุเดียวกัน
การส่งต่อเข้าสู่ขั้นตอน AI guardrails นี้เริ่มต้นด้วยวัตถุประสงค์ที่ระบุและควรจบด้วยผลลัพธ์ที่สามารถสนับสนุนการจำกัดบริบท, เครื่องมือ, และการเข้าถึงข้อมูล บันทึกความไม่แน่นอน, ตัวเลือกที่ถูกปฏิเสธ, การใช้ทรัพยากร, และการควบคุมใด ๆ ทั้งจากมนุษย์หรือซอฟต์แวร์ที่ใช้ที่ขอบเขต ร่องรอยนี้เป็นจุดที่ทีมสามารถตรวจจับได้ว่า guardrails สามารถบล็อกงานที่ถูกต้อง, ถูกข้าม, หรือสร้างความรู้สึกปลอดภัยเท็จก่อนที่จุดอ่อนเดียวกันจะส่งผลต่อผลลัพธ์สำคัญ
2. จำกัดบริบท, เครื่องมือ, และการเข้าถึงข้อมูล: การแสดงหรือการตัดสินใจใน AI Guardrails
ในขั้นตอนนี้ของ AI guardrails ระบบต้องจำกัดบริบท, เครื่องมือ, และการเข้าถึงข้อมูล คำถามที่สำคัญไม่ใช่แค่การดำเนินการเกิดขึ้นหรือไม่ แต่คือข้อมูลใดที่มันใช้, สถานะใดที่มันเปลี่ยนแปลง, และหลักฐานใดที่พิสูจน์ว่าการเปลี่ยนแปลงนั้นเป็นที่ถูกต้อง ผู้ตรวจสอบควรสามารถแยกการดำเนินการนี้ออกจากพรอมต์ระบบเดียวที่คาดว่าจะบังคับใช้ทุกขอบเขตและทำซ้ำผลลัพธ์ภายใต้เงื่อนไขที่ระบุเดียวกัน
การส่งต่อเข้าสู่ขั้นตอน AI guardrails นี้เริ่มต้นด้วยการจัดประเภทคำขอและนโยบายที่ใช้ได้และควรจบด้วยผลลัพธ์ที่สามารถสนับสนุนการตรวจสอบการกระทำที่เสนอก่อนการดำเนินการ บันทึกความไม่แน่นอน, ตัวเลือกที่ถูกปฏิเสธ, การใช้ทรัพยากร, และการควบคุมใด ๆ ทั้งจากมนุษย์หรือซอฟต์แวร์ที่ใช้ที่ขอบเขต ร่องรอยนี้เป็นจุดที่ทีมสามารถตรวจจับได้ว่า guardrails สามารถบล็อกงานที่ถูกต้อง, ถูกข้าม, หรือสร้างความรู้สึกปลอดภัยเท็จก่อนที่จุดอ่อนเดียวกันจะส่งผลต่อผลลัพธ์สำคัญ
3. ตรวจสอบการกระทำที่เสนอก่อนการดำเนินการ: การแปลงที่โดดเด่นใน AI Guardrails
ในขั้นตอนนี้ของ AI Guardrails ระบบต้องตรวจสอบการกระทำที่เสนอก่อนการดำเนินการ คำถามที่มีประโยชน์ไม่ได้เพียงว่าการดำเนินการนั้นเกิดขึ้นหรือไม่ แต่คือข้อมูลใดที่มันใช้, สถานะใดที่มันเปลี่ยนแปลง, และหลักฐานใดที่พิสูจน์ว่าการเปลี่ยนนั้นเป็นที่ถูกต้อง ผู้ตรวจสอบควรสามารถแยกแยะการดำเนินการออกจากคำสั่งระบบเดียวที่คาดว่าจะบังคับใช้ทุกขอบเขตและทำซ้ำผลลัพธ์ภายใต้เงื่อนไขที่ระบุเดียวกัน
การส่งต่อเข้าสู่ขั้นตอน AI Guardrails นี้เริ่มด้วยการจำกัดบริบท, เครื่องมือและการเข้าถึงข้อมูล และควรจบด้วยผลลัพธ์ที่สามารถสนับสนุนการตรวจสอบผลลัพธ์และสถานะที่เปลี่ยนแปลงได้ บันทึกความไม่แน่นอน, ทางเลือกที่ถูกปฏิเสธ, การใช้ทรัพยากร, และการควบคุมใด ๆ ที่มนุษย์หรือซอฟต์แวร์ใช้ที่ขอบเขตนั้น ตราสารนี้คือที่ที่ทีมสามารถตรวจจับได้ว่า Guardrails สามารถบล็อกงานที่ถูกต้อง, ถูกหลีกเลี่ยง, หรือสร้างความรู้สึกปลอดภัยเท็จก่อนที่จุดอ่อนเดียวกันจะส่งผลต่อผลลัพธ์ที่สำคัญ
4. ตรวจสอบผลลัพธ์และสถานะที่เปลี่ยนแปลง: ขอบเขตการจำกัดและการตรวจสอบใน AI Guardrails
ในขั้นตอนนี้ของ AI Guardrails ระบบต้องตรวจสอบผลลัพธ์และสถานะที่เปลี่ยนแปลง คำถามที่มีประโยชน์ไม่ได้เพียงว่าการดำเนินการนั้นเกิดขึ้นหรือไม่ แต่คือข้อมูลใดที่มันใช้, สถานะใดที่มันเปลี่ยนแปลง, และหลักฐานใดที่พิสูจน์ว่าการเปลี่ยนนั้นเป็นที่ถูกต้อง ผู้ตรวจสอบควรสามารถแยกแยะการดำเนินการออกจากคำสั่งระบบเดียวที่คาดว่าจะบังคับใช้ทุกขอบเขตและทำซ้ำผลลัพธ์ภายใต้เงื่อนไขที่ระบุเดียวกัน
การส่งต่อเข้าสู่ขั้นตอน AI Guardrails นี้เริ่มด้วยการตรวจสอบการกระทำที่เสนอก่อนการดำเนินการและควรจบด้วยผลลัพธ์ที่สามารถสนับสนุนการยกระดับ, การบันทึก, และการปรับปรุงจากเหตุการณ์ต่าง ๆ บันทึกความไม่แน่นอน, ทางเลือกที่ถูกปฏิเสธ, การใช้ทรัพยากร, และการควบคุมใด ๆ ที่มนุษย์หรือซอฟต์แวร์ใช้ที่ขอบเขตนั้น ตราสารนี้คือที่ที่ทีมสามารถตรวจจับได้ว่า Guardrails สามารถบล็อกงานที่ถูกต้อง, ถูกหลีกเลี่ยง, หรือสร้างความรู้สึกปลอดภัยเท็จก่อนที่จุดอ่อนเดียวกันจะส่งผลต่อผลลัพธ์ที่สำคัญ
5. ยกระดับ, บันทึก, และปรับปรุงจากเหตุการณ์: ผลลัพธ์, ข้อเสนอแนะ, และกฎการหยุดใน AI Guardrails
ในขั้นตอนนี้ของ AI Guardrails ระบบต้องยกระดับ, บันทึก, และปรับปรุงจากเหตุการณ์ คำถามที่มีประโยชน์ไม่ได้เพียงว่าการดำเนินการนั้นเกิดขึ้นหรือไม่ แต่คือข้อมูลใดที่มันใช้, สถานะใดที่มันเปลี่ยนแปลง, และหลักฐานใดที่พิสูจน์ว่าการเปลี่ยนนั้นเป็นที่ถูกต้อง ผู้ตรวจสอบควรสามารถแยกแยะการดำเนินการออกจากคำสั่งระบบเดียวที่คาดว่าจะบังคับใช้ทุกขอบเขตและทำซ้ำผลลัพธ์ภายใต้เงื่อนไขที่ระบุเดียวกัน
การส่งต่อเข้าสู่ขั้นตอน AI Guardrails นี้เริ่มด้วยการตรวจสอบผลลัพธ์และสถานะที่เปลี่ยนแปลงและควรจบด้วยผลลัพธ์ที่สามารถสนับสนุนการเฝ้าติดตามหรือการตัดสินใจขั้นสุดท้าย บันทึกความไม่แน่นอน, ทางเลือกที่ถูกปฏิเสธ, การใช้ทรัพยากร, และการควบคุมใด ๆ ที่มนุษย์หรือซอฟต์แวร์ใช้ที่ขอบเขตนั้น ตราสารนี้คือที่ที่ทีมสามารถตรวจจับได้ว่า Guardrails สามารถบล็อกงานที่ถูกต้อง, ถูกหลีกเลี่ยง, หรือสร้างความรู้สึกปลอดภัยเท็จก่อนที่จุดอ่อนเดียวกันจะส่งผลต่อผลลัพธ์ที่สำคัญ
อ่านแผนที่ AI Guardrails ไปข้างหน้าเพื่อเข้าใจการผลิตและย้อนกลับเพื่อวินิจฉัยความล้มเหลว การวิเคราะห์ไปข้างหน้าถามว่าขั้นตอนหนึ่งส่งต่ออะไรให้ขั้นตอนต่อไป การวิเคราะห์ย้อนกลับเริ่มจากผลลัพธ์ที่ไม่ถูกต้อง, ช้า, มีค่าใช้จ่ายสูง, หรือไม่ปลอดภัยและตามรอยว่าการสันนิษฐานใดในขั้นตอนก่อนหน้าที่ทำให้เกิดผลนั้น เส้นทางย้อนกลับมักเป็นที่ที่ทีมค้นพบว่าข้อผิดพลาดสำคัญเกิดขึ้นก่อนที่โมเดลจะสร้างอะไรออกมา
ตัวอย่างการทำงานของ AI Guardrails
ผู้ช่วยด้านการเงินสามารถร่างคำสั่งโอนเงินได้ แต่กฎที่กำหนดและผู้ตรวจสอบที่ได้รับอนุญาตต้องอนุมัติการดำเนินการ
ตัวอย่างนี้ให้ข้อมูลเชิงลึกเพราะ AI Guardrails สามารถเชื่อมโยงกับอินพุตที่สังเกตได้, สถานะกลาง, และผลลัพธ์ แทนที่จะประเมินผ่านการสาธิตที่เรียบหรู การทดสอบที่เข้มงวดจะสร้างกรณีทั่วไป, ยาก, และหลอกลวงโดยเจตนาโดยรอบสถานการณ์นี้, รักษาฐานเปรียบเทียบโดยไม่มีเทคนิคดังกล่าว, และบันทึกทั้งประสิทธิภาพเฉลี่ยและความรุนแรงของความล้มเหลวแต่ละกรณี
เปลี่ยนสมมติฐานหนึ่งในตัวอย่าง AI Guardrails แล้วทำการวิเคราะห์ซ้ำ ลบอินพุตที่จำเป็น, แนะนำสัญญาณที่ขัดแย้ง, จำกัดการคำนวณ, ปรับเปลี่ยนกลุ่มผู้ใช้, หรือบังคับให้ระบบละเว้น กลไกที่สำเร็จเพียงในการสาธิตที่จัดเตรียมอย่างระมัดระวังเพียงครั้งเดียวไม่ได้แสดงว่ามันสามารถทั่วไปใช้ได้ในสภาพแวดล้อมการทำงาน
AI Guardrails กับทางลัดที่พบบ่อยที่สุด
AI Guardrails มักถูกย่อให้เป็นคำสั่งระบบเดียวที่คาดว่าจะบังคับใช้ทุกขอบเขต การย่อแบบนี้ทำให้ขอบเขตที่กำหนดแนวคิดหายไป มันอาจทำให้ผู้ซื้อเปรียบเทียบผลิตภัณฑ์ที่ไม่เหมือนกัน, นักวิจัยอ้างเกินจริงว่าการทดลองแสดงอะไร, และผู้ปฏิบัติงานเฝ้าติดตามสัญญาณที่ผิดหลังการใช้งาน
| เลนส์ | คำตอบเชิงปฏิบัติ |
|---|---|
| คำนิยาม | ระบบควบคุม AI คือการควบคุมเชิงเทคนิคและกระบวนการหลายชั้นที่จำกัดอินพุต การกระทำ ผลลัพธ์ และการยกระดับรอบโมเดลหรือเอเจนต์ |
| ความสับสน | คาดว่าจะมีพรอมต์ระบบเดียวเพื่อบังคับใช้ทุกขอบเขต |
| ความเสี่ยง | ระบบควบคุมอาจบล็อกงานที่ถูกต้อง, ถูกข้าม, หรือสร้างความรู้สึกปลอดภัยเท็จ |
การเปรียบเทียบควรระบุหน่วยการวิเคราะห์ด้วย บทความเกี่ยวกับระบบควบคุม AI อาจแยกโมเดลหรืออัลกอริทึมออกมา ในขณะที่บริการที่ใช้งานจริงจะเพิ่มการดึงข้อมูล, การกำหนดเส้นทาง, แคช, นโยบาย, การระบุตัวตน, อินเทอร์เฟซผู้ใช้, และการตรวจสอบ สินค้าสองรายการอาจใช้คำหลักเดียวกันแต่ดำเนินการส่วนต่างของสแตกนั้น ขอให้ถามว่าองค์ประกอบใดทำการแปลงที่กำหนดและองค์ประกอบอื่นใดที่จำเป็นสำหรับผลลัพธ์ที่รายงาน
ทำไมระบบควบคุม AI จึงสำคัญในระบบ AI ปัจจุบัน
ระบบควบคุม AI มีความสำคัญในขณะนี้เพราะระบบ AI กำลังได้รับบริบทที่ใหญ่ขึ้น, รูปแบบที่หลากหลายมากขึ้น, การคำนวณระหว่างทำงานที่เพิ่มขึ้น, การเข้าถึงเครื่องมือที่กว้างขวางขึ้น, และการเชื่อมต่อที่ลึกซึ้งกับการตัดสินใจขององค์กร ภายใต้เงื่อนไขเหล่านี้ สิ่งที่เคยดูเหมือนรายละเอียดการวิจัยอาจกำหนดความหน่วง, ความปลอดภัย, การเข้าถึง, ต้นทุนต่อสิ่งแวดล้อม, คุณภาพผลิตภัณฑ์ หรือความรับผิดชอบทางกฎหมาย
มาตรการที่เกี่ยวข้องไม่ใช่ว่า ระบบควบคุม AI สามารถสร้างผลลัพธ์ที่น่าประทับใจหนึ่งอย่างหรือไม่ แต่คือว่าเทคนิคนั้นปรับปรุงผลลัพธ์ที่สำคัญในสภาวะที่เป็นตัวแทนได้หรือไม่ และทำได้อย่างมีประสิทธิภาพกว่าฐานเส้นง่ายกว่า รายงานการกระจาย, ประเภทความล้มเหลว, ความหน่วงส่วนท้าย, การใช้ทรัพยากร, และกลุ่มผู้ได้รับผลกระทบ แทนการบีบอัดผลลัพธ์ทั้งหมดเป็นค่าเฉลี่ยเดียว
ตรวจสอบทั้งเมตริกเชิงเทคนิคและผลกระทบต่อผู้คน บันทึกความไม่แน่นอน, รักษาแหล่งที่มา, ทำให้การยกระดับเป็นไปได้, และออกแบบการกู้คืนก่อนที่ระบบจะเผชิญกับสภาวะโลกจริงที่เปลี่ยนแปลงได้ เมื่อประยุกต์ใช้โดยเฉพาะกับระบบควบคุม AI ระเบียบนี้ทำให้หลักฐานสามารถพกพาได้: ทีมอื่นสามารถประเมินว่าการเพิ่มประสิทธิภาพที่อ้างอิงนั้นมีโอกาสคงอยู่กับโมเดล, ภาษา, แพลตฟอร์มฮาร์ดแวร์, ชุดข้อมูล, ประชากรผู้ใช้, หรือระดับความเสี่ยงที่แตกต่างหรือไม่
ประโยชน์ที่ระบบควบคุม AI สามารถมอบให้
เหตุผลที่แข็งแกร่งที่สุดในการใช้ระบบควบคุม AI คือมันสามารถแก้ไขคอขวดที่ตั้งใจไว้โดยตรง ขึ้นอยู่กับการดำเนินการ ประโยชน์อาจปรากฏเป็นการอ้างอิงที่ดีกว่า, การแทนที่ที่แม่นยำยิ่งขึ้น, การทั่วไปที่พัฒนา, ความหน่วงที่ต่ำลง, การเคลื่อนย้ายหน่วยความจำที่ลดลง, ความรับผิดชอบที่ชัดเจนยิ่งขึ้น, หรือขอบเขตที่ปลอดภัยยิ่งขึ้นระหว่างข้อเสนอโมเดลและการกระทำจริง
ประโยชน์ควรแสดงเป็นการตัดสินใจและการวัดผล “ฉลาดขึ้น” ไม่ใช่เกณฑ์การยอมรับสำหรับระบบควบคุม AI เป้าหมายที่เป็นประโยชน์อาจระบุอัตราความผิดพลาดในกรณีที่ยาก, การกู้คืนหลังจากหลักฐานขัดแย้ง, ค่าใช้จ่ายที่เปอร์เซ็นไทล์ของปริมาณการใช้งาน, เวลาในการตรวจสอบโดยมนุษย์, การปรับเทียบ, หรือเปอร์เซ็นต์ของการกระทำที่คงอยู่ภายในขอบเขตอำนาจที่กำหนด
โหมดความล้มเหลวที่กำหนดระบบควบคุม AI
ข้อจำกัดหลักคือระบบควบคุมอาจบล็อกงานที่ถูกต้อง, ถูกข้าม, หรือสร้างความรู้สึกปลอดภัยเท็จ ความล้มเหลวนี้ไม่ใช่สิ่งที่เพิ่มเข้ามาหลังจากการพัฒนาเสร็จแล้ว ควรเป็นส่วนที่กำหนดการเก็บรวบรวมข้อมูล, สถาปัตยกรรม, สิทธิ์การเข้าถึง, การประเมินผล, ประตูการปล่อย, และการตรวจสอบสำหรับระบบควบคุม AI ตั้งแต่แรกเริ่ม
การควบคุมสำหรับระบบควบคุม AI มีประโยชน์เฉพาะเมื่อทำงานก่อนผลลัพธ์ที่มีค่าใช้จ่ายสูงหรือไม่สามารถย้อนกลับได้ ระบุสัญญาณล่วงหน้าที่สังเกตได้เร็วที่สุดของความล้มเหลว, กำหนดเกณฑ์หรือกฎ, มอบหมายเจ้าของที่รับผิดชอบ, และทดสอบการกู้คืน ขึ้นอยู่กับกรณีการใช้งาน การกู้คืนอาจหมายถึงการละเว้น, การย้อนกลับไปสู่ระบบที่ง่ายกว่า, การขอหลักฐานเพิ่มเติม, การยกระดับไปยังบุคคล, การย้อนโมเดลกลับ, หรือการหยุดการกระทำทั้งหมด
แผนการประเมินสำหรับระบบควบคุม AI
เริ่มการประเมิน AI guardrails โดยเขียนการตัดสินใจที่หลักฐานต้องสนับสนุน กำหนดประชากรที่ใช้งาน ผลลัพธ์ที่ผิดพลาดจะส่งผลอย่างไร ข้อมูลที่มีอยู่จริงในเวลาตัดสินใจ และทางเลือกที่เชื่อถือได้ที่ง่ายที่สุด สิ่งนี้ช่วยป้องกันไม่ให้เกณฑ์มาตรฐานกลายเป็นเป้าหมายเพียงเพราะทำได้ง่าย
ใช้ชุดทดสอบที่ยังไม่ถูกแก้ไขสำหรับการเปรียบเทียบที่ควบคุม แล้วตรวจสอบ AI guardrails ในสภาพแวดล้อมการทำงานแบบขั้นตอน การประเมินแบบออฟไลน์ทำให้ตัวแปรต่าง ๆ สามารถเปรียบเทียบได้; โหมดเงา, แคนารี, การจำกัดอัตรา, หรือประตูอนุมัติจะเปิดเผยว่าการจราจรจริง, วงจรตอบกลับ, และผู้คนเปลี่ยนพฤติกรรมอย่างไร ขั้นตอนการปรับใช้ควรมีเงื่อนไขการหยุดอย่างชัดเจน แทนที่จะสมมติว่าการปรับปรุงทุกอย่างสมควรเปิดตัวเต็มรูปแบบ
ทำเวอร์ชันของข้อมูลที่จำเป็นต่อการทำซ้ำ AI guardrails ได้แก่ ข้อมูลต้นทาง, การเตรียมข้อมูล, ตัวแยกโทเคนหรือเอ็นโค้ดเดอร์, น้ำหนักโมเดล, การกำหนดค่า, พรอมต์หรือแนวนโยบาย, ดัชนีการดึงข้อมูล, ชุดประเมิน, สมมติฐานฮาร์ดแวร์, และโค้ดการให้บริการตามที่เกี่ยวข้อง หากไม่มีร่องรอยการสืบทอด ทีมงานจะไม่สามารถบอกได้ว่าผลลัพธ์ที่เปลี่ยนแปลงมาจากเทคนิค, สภาพแวดล้อม, หรือการแก้ไขในสายการทำงานที่ไม่ได้สังเกต
สุดท้าย ให้ถามว่าการค้นหาอะไรจะทำให้ข้ออ้างว่า AI guardrails ช่วยเหลือเป็นเท็จ หากไม่มีผลลัพธ์ใดที่สามารถย้อนกลับการตัดสินใจนำไปใช้ การประเมินก็เป็นการตลาด การกำหนดเกณฑ์การยอมรับล่วงหน้าและชุดการยืนยันที่เก็บไว้ทำให้การฝึกฝนกลายเป็นหลักฐาน
คำถามที่ควรถามก่อนนำ AI Guardrails ไปใช้
- วัตถุประสงค์: ข้อจำกัดที่วัดได้ใดที่ AI guardrails ตั้งใจจะแก้ไข?
- กลไก: ขั้นตอนใดในห้าขั้นตอนที่มีการแปลงที่โดดเด่น?
- ฐานเปรียบเทียบ: มันเปรียบเทียบกับพรอมต์ระบบเดียวที่คาดว่าจะบังคับใช้ทุกขอบเขตหรือทางเลือกที่ง่ายกว่าอย่างไร?
- หลักฐาน: กรณีทั่วไป, ยาก, ปรับตัวต่อการโจมตี, และกลุ่มย่อยใดบ้างที่ได้ทำการทดสอบ?
- การดำเนินงาน: ความหน่วง, หน่วยความจำ, การคำนวณ, พลังงาน, การบำรุงรักษา, และค่าใช้จ่ายในการตรวจสอบใดที่ปรากฏเมื่อขยายขนาด?
- ความเสี่ยง: ทีมจะตรวจจับได้อย่างไรว่า guardrails อาจบล็อกงานที่ถูกต้อง, ถูกหลบเลี่ยง, หรือสร้างความรู้สึกปลอดภัยเท็จ?
- การกู้คืน: ระบบสามารถละเว้น, ย้อนกลับ, ยกเลิก, หรือส่งต่อก่อนเกิดอันตรายได้หรือไม่?
แหล่งข้อมูลหลักสำหรับการศึกษา AI Guardrails
จุดเริ่มต้นที่มีอำนาจสำหรับส่วนของสแตก AI ที่ล้อมรอบ AI guardrails รวมถึง NIST AI Risk Management Framework, C2PA specifications, NIST Privacy Framework อ่านคู่กับเอกสารของโมเดล, ชุดข้อมูล, ฮาร์ดแวร์, และเขตอำนาจที่เกี่ยวข้อง แหล่งข้อมูลทั่วไปอาจกำหนดกลไกได้ แต่เพียงหลักฐานที่เฉพาะเจาะจงต่อการปรับใช้เท่านั้นที่สามารถยืนยันว่าการนำไปใช้เฉพาะกรณีนั้นเหมาะสม
สิ่งที่ควรจำเกี่ยวกับ AI Guardrails
AI guardrails เป็นกลไกที่กำหนดไว้ภายในระบบสังคม-เทคนิคที่ใหญ่ขึ้น มูลค่าของมันมาจากการปรับปรุงผลลัพธ์เฉพาะภายใต้เงื่อนไขที่ชัดเจน ไม่ได้มาจากฉลากเอง แผนที่ห้าขั้นตอนทำให้การไหลของข้อมูลเป็นที่มองเห็น การเปรียบเทียบระบุว่ามันไม่ใช่อะไร และเส้นทางการควบคุมแสดงจุดที่ผู้ปฏิบัติหน้าที่ที่รับผิดชอบสามารถแทรกแซงได้
กฎปฏิบัติสำหรับ AI guardrails คือการกำหนดวัตถุประสงค์, เปรียบเทียบกับฐานเปรียบเทียบที่เชื่อถือได้, ทดสอบความล้มเหลวที่สำคัญที่สุด, และเก็บหลักฐานที่จำเป็นเพื่อเฝ้าติดตามการเปลี่ยนแปลง เมื่อมีส่วนเหล่านี้ครบถ้วน แนวคิดจะกลายเป็นตัวเลือกด้านวิศวกรรมและการกำกับดูแลที่สามารถประเมินได้ หากไม่มีส่วนเหล่านี้ มันยังคงเป็นชื่อที่มีศักยภาพแต่เชื่อมโยงกับความเสี่ยงการดำเนินงานที่ไม่ทราบ


