
มุมมองของ Anderson
สู่การสร้างมนุษย์ AI ในแบบเรียลไทม์ด้วย Neural Lumigraph Rendering

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
ประเด็นสำคัญการเรนเดอร์แบบ Neural Lumigraph ช่วยปรับปรุง NeRF ให้ดีขึ้นประมาณสองลำดับขนาด
ดูเพิ่มเติม
- การเรนเดอร์แบบ Neural Lumigraph ช่วยปรับปรุง NeRF ให้ดีขึ้นประมาณสองลำดับขนาด
- NLR ใช้เครือข่าย SIREN เพื่อรวมจุดแข็งของ NeRF และ IDR สำหรับงานกราฟิกแบบเรียลไทม์
- NLR ขาดความสามารถด้านแสงแบบไดนามิกและการปรับแสงใหม่ ทำให้เอาต์พุตจำกัดอยู่ที่แสง ณ เวลาที่บันทึกภาพ
แม้ปัจจุบันจะมีกระแสความสนใจใน Neural Radiance Fields (NeRF), เทคโนโลยีที่สร้างสภาพแวดล้อมและวัตถุ 3 มิติด้วย AI ได้ แต่แนวทางใหม่ในการสังเคราะห์ภาพนี้ยังต้องใช้เวลาฝึกมาก และยังไม่มีการนำไปใช้ที่รองรับอินเทอร์เฟซแบบเรียลไทม์ซึ่งตอบสนองได้รวดเร็ว
อย่างไรก็ตาม ความร่วมมือระหว่างบุคคลชั้นนำในภาคอุตสาหกรรมและวิชาการนำเสนอมุมมองใหม่ต่อความท้าทายนี้ ซึ่งเรียกโดยทั่วไปว่าการสังเคราะห์มุมมองใหม่ หรือ NVS
บทความวิจัยชื่อ Neural Lumigraph Rendering อ้างว่าปรับปรุงผลลัพธ์จากเทคโนโลยีล้ำสมัยเดิมได้ประมาณสองลำดับขนาด หรือราว 100 เท่า เป็นความก้าวหน้าอีกหลายก้าวสู่การเรนเดอร์ CG แบบเรียลไทม์ผ่านกระบวนการเรียนรู้ของเครื่อง

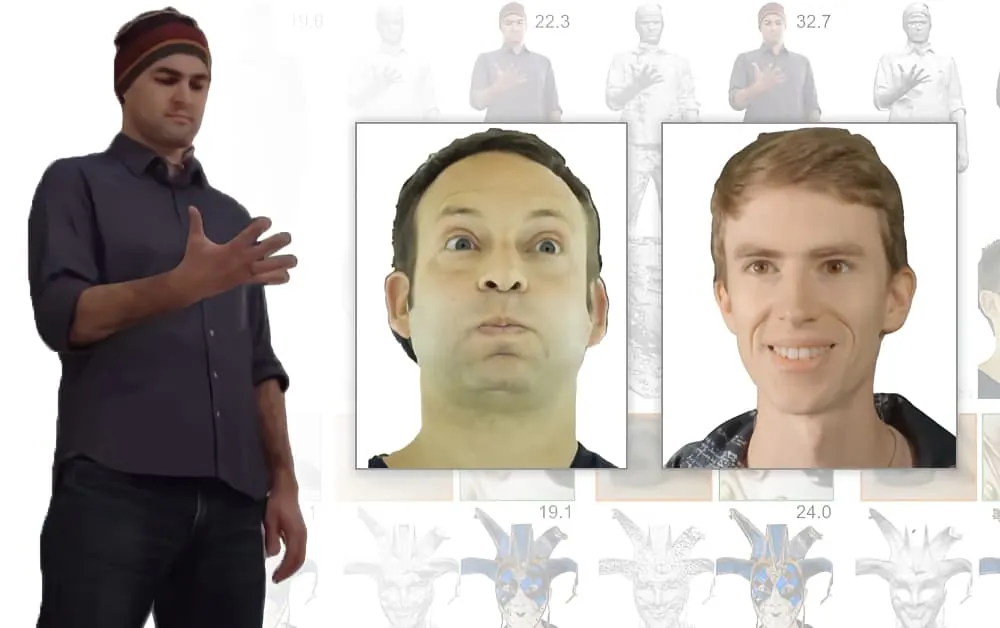
Neural Lumigraph Rendering (ขวา) แก้ไขรอยผิดเพี้ยนจากการผสมภาพและจัดการการบดบังได้ดีกว่าวิธีเดิม ที่มา
แม้บทความจะระบุสังกัดเพียง Stanford University และบริษัทเทคโนโลยีจอแสดงผลโฮโลกราฟิก Raxium ซึ่งปัจจุบันดำเนินงานในโหมดไม่เปิดเผยรายละเอียด แต่ผู้ร่วมงานยังประกอบด้วยสถาปนิกด้านการเรียนรู้ของเครื่องระดับอาวุโสที่ Google, นักวิทยาศาสตร์คอมพิวเตอร์ที่ Adobe (ADBE ) และประธานเจ้าหน้าที่ฝ่ายเทคโนโลยีของ StoryFile ซึ่งเพิ่งเป็นข่าวพาดหัวจาก William Shatner เวอร์ชัน AI
ในบริบทของการประชาสัมพันธ์ Shatner อย่างเข้มข้นเมื่อไม่นานมานี้ ดูเหมือนว่า StoryFile กำลังใช้ NLR ในกระบวนการใหม่สำหรับสร้างตัวตนแบบโต้ตอบที่ AI สร้างขึ้นจากคุณลักษณะและเรื่องราวของบุคคลแต่ละคน
StoryFile คาดว่าจะใช้เทคโนโลยีนี้กับนิทรรศการพิพิธภัณฑ์ เรื่องเล่าออนไลน์แบบโต้ตอบ จอแสดงผลโฮโลกราฟิก ความเป็นจริงเสริม (AR) และการบันทึกมรดกทางวัฒนธรรม อีกทั้งดูเหมือนกำลังพิจารณาการประยุกต์ใช้ NLR รูปแบบใหม่ในการสัมภาษณ์งานและแอปนัดเดตเสมือนจริงด้วย:

ตัวอย่างการใช้งานที่เสนอไว้ในวิดีโอออนไลน์ของ StoryFile
การบันทึกข้อมูลเชิงปริมาตรสำหรับอินเทอร์เฟซการสังเคราะห์มุมมองใหม่และวิดีโอ
หลักการบันทึกข้อมูลเชิงปริมาตรที่ปรากฏในงานวิจัยจำนวนมากขึ้นเรื่อย ๆ คือการถ่ายภาพนิ่งหรือวิดีโอของตัวแบบ แล้วใช้การเรียนรู้ของเครื่องเติมมุมมองที่ชุดกล้องเดิมไม่ได้ครอบคลุม
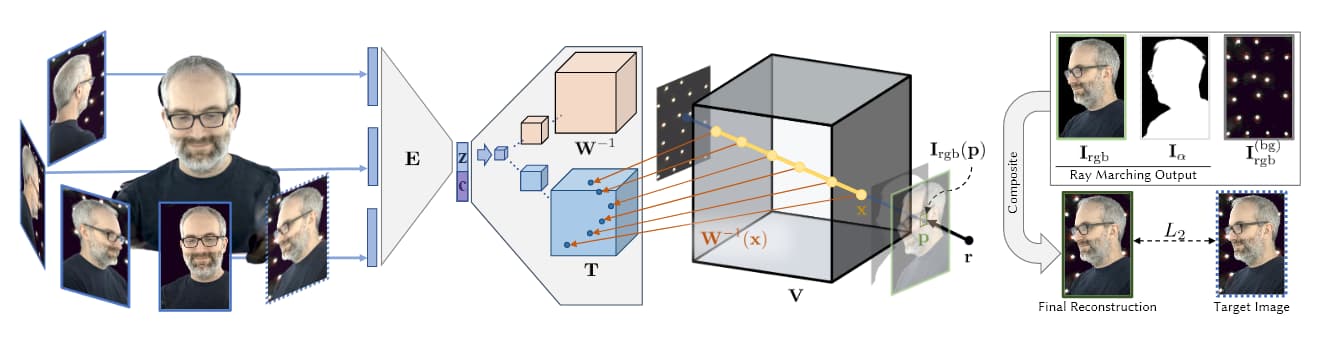
ที่มา: https://research.fb.com/wp-content/uploads/2019/06/Neural-Volumes-Learning-Dynamic-Renderable-Volumes-from-Images.pdf
ภาพด้านบนจากงานวิจัย AI ปี 2019 ของ Facebook (ดูด้านล่าง) แสดงสี่ขั้นตอนของการบันทึกเชิงปริมาตร: กล้องหลายตัวเก็บภาพหรือวิดีโอ; สถาปัตยกรรมตัวเข้ารหัส/ตัวถอดรหัส หรือสถาปัตยกรรมอื่น คำนวณและเชื่อมโยงความสัมพันธ์ระหว่างมุมมอง; อัลกอริทึม ray marching คำนวณวอกเซล หรือหน่วยเรขาคณิตเชิงพื้นที่ XYZ อื่น ๆ ของแต่ละจุดในปริมาตร; และในงานวิจัยล่าสุดส่วนใหญ่ จะฝึกระบบเพื่อสังเคราะห์ตัวตนที่สมบูรณ์ซึ่งปรับเปลี่ยนได้แบบเรียลไทม์
ขั้นตอนการฝึกที่มักมีขนาดใหญ่และใช้ข้อมูลมากนี้เองที่ทำให้การสังเคราะห์มุมมองใหม่ยังไม่สามารถบันทึกข้อมูลแบบเรียลไทม์หรือมีการตอบสนองสูงได้จนถึงปัจจุบัน
เนื่องจากการสังเคราะห์มุมมองใหม่สร้างแผนที่ 3 มิติที่สมบูรณ์ของพื้นที่เชิงปริมาตร การเชื่อมจุดเหล่านี้เป็นเมชคอมพิวเตอร์กราฟิกแบบดั้งเดิมจึงค่อนข้างง่าย ทำให้บันทึกและขยับข้อต่อของมนุษย์ CGI หรือวัตถุอื่นที่มีขอบเขตค่อนข้างชัดเจนได้ทันทีระหว่างการทำงาน
แนวทางที่ใช้ NeRF อาศัยกลุ่มจุดและแผนที่ความลึกเพื่อประมาณค่าระหว่างมุมมองที่มีอยู่อย่างห่าง ๆ ของอุปกรณ์บันทึก:
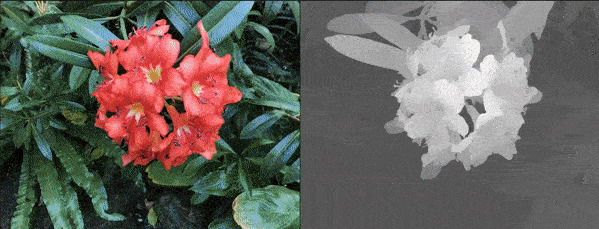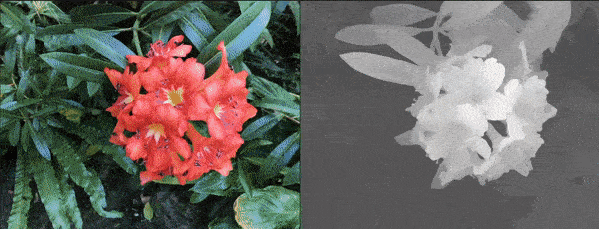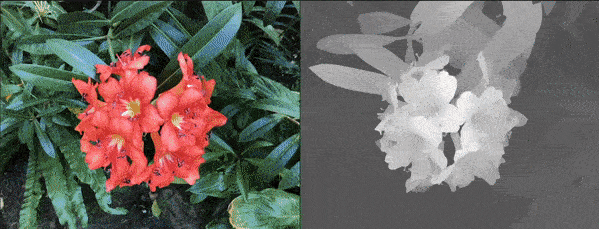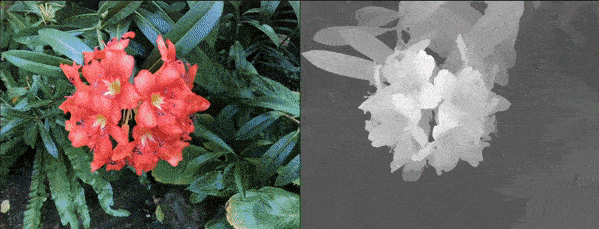
NeRF สร้างความลึกเชิงปริมาตรได้โดยคำนวณแผนที่ความลึก แทนการสร้างเมช CG ที่มา: https://www.youtube.com/watch?v=JuH79E8rdKc
แม้ NeRF จะสามารถคำนวณเมชได้ แต่การนำไปใช้ส่วนใหญ่ไม่ได้ใช้ความสามารถนี้เพื่อสร้างฉากเชิงปริมาตร
ในทางตรงกันข้าม แนวทาง Implicit Differentiable Renderer (IDR) ซึ่งเผยแพร่โดย Weizmann Institute of Science ในเดือนตุลาคม 2020 อาศัยข้อมูลเมช 3 มิติที่สร้างโดยอัตโนมัติจากชุดอุปกรณ์บันทึก:
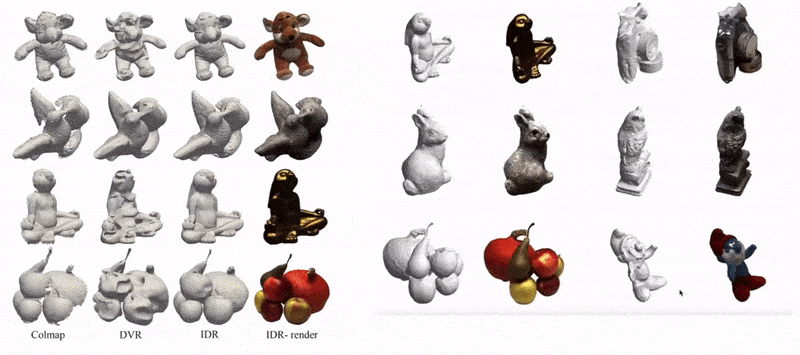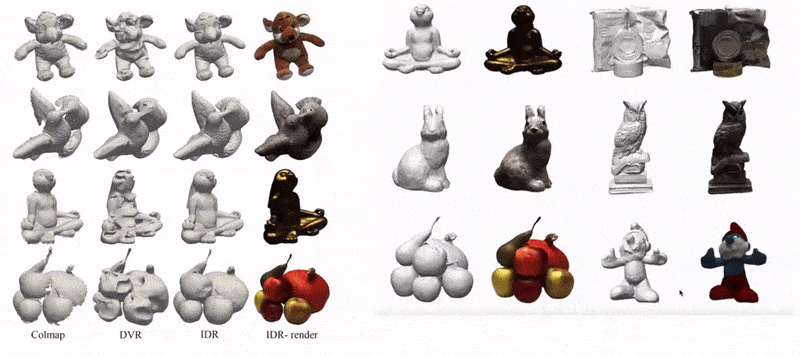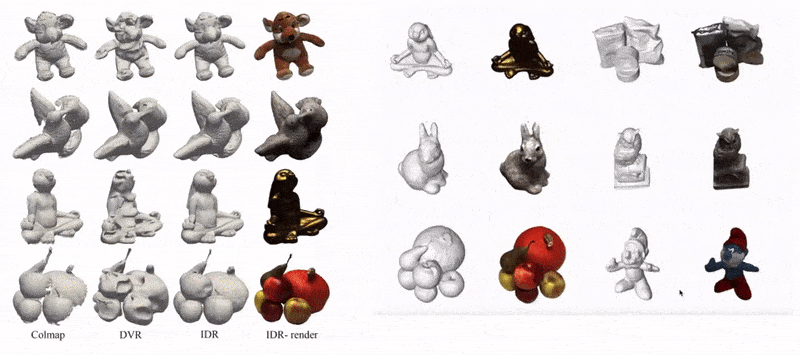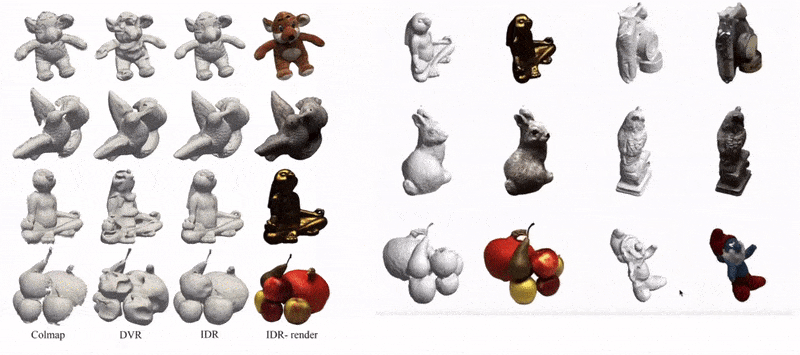
ตัวอย่างข้อมูลที่บันทึกด้วย IDR แล้วแปลงเป็นเมช CGI แบบโต้ตอบ ที่มา: https://www.youtube.com/watch?v=C55y7RhJ1fE
แม้ NeRF จะขาดความสามารถในการประมาณรูปร่างแบบ IDR แต่ IDR ก็มีคุณภาพภาพไม่เท่า NeRF และทั้งสองวิธีต้องใช้ทรัพยากรมากในการฝึกและรวบรวมข้อมูล แม้นวัตกรรมล่าสุดของ NeRF จะเริ่ม แก้ไขปัญหานี้แล้วก็ตาม

ชุดกล้องที่ออกแบบเฉพาะของ NLR ประกอบด้วย GoPro HERO7 จำนวน 16 ตัว และ Back-Bone H7PRO ตรงกลางอีก 6 ตัว สำหรับการเรนเดอร์แบบเรียลไทม์ กล้องเหล่านี้ทำงานอย่างน้อย 60fps ที่มา: https://arxiv.org/pdf/2103.11571.pdf
Neural Lumigraph Rendering เลือกใช้ SIREN (Sinusoidal Representation Networks) เพื่อรวมจุดแข็งของแต่ละแนวทางไว้ในกรอบการทำงานของตน โดยมุ่งสร้างผลลัพธ์ที่นำไปใช้กับกระบวนการกราฟิกเรียลไทม์ที่มีอยู่ได้โดยตรง
ในช่วงปีที่ผ่านมา SIREN ถูกใช้ในการประยุกต์ใช้ที่คล้ายกัน และปัจจุบันเป็นการเรียก API ที่ได้รับความนิยมสำหรับ Colab ของผู้สนใจในชุมชนสังเคราะห์ภาพ อย่างไรก็ตาม นวัตกรรมของ NLR คือการใช้ SIREN กับการเรียนรู้แบบมีผู้สอนจากภาพสองมิติหลายมุมมอง ซึ่งมีความท้าทายเพราะ SIREN มักให้ผลลัพธ์ที่จดจำข้อมูลฝึกมากเกินไป แทนที่จะสรุปใช้กับข้อมูลทั่วไปได้
เมื่อดึงเมช CG ออกจากภาพจากชุดกล้องแล้ว จะทำการแรสเตอร์ไรซ์เมชด้วย OpenGL และจับคู่ตำแหน่งจุดยอดของเมชกับพิกเซลที่เหมาะสม จากนั้นจึงคำนวณการผสมแผนที่ต่าง ๆ ที่มีส่วนร่วม
เมชที่ได้มีความเป็นทั่วไปและเป็นตัวแทนของตัวแบบได้ดีกว่าของ NeRF (ดูภาพด้านล่าง) ใช้การคำนวณน้อยกว่า และไม่เพิ่มรายละเอียดเกินจำเป็นในบริเวณที่ไม่ได้ประโยชน์จากรายละเอียดนั้น เช่น ผิวหน้าที่เรียบ:

ที่มา: https://arxiv.org/pdf/2103.11571.pdf
ในด้านข้อจำกัด NLR ยังไม่รองรับแสงแบบเปลี่ยนแปลงได้หรือการจัดแสงใหม่ และผลลัพธ์ถูกจำกัดด้วยแผนที่เงาและเงื่อนไขแสงอื่น ๆ ที่ได้ในขณะบันทึก นักวิจัยตั้งใจแก้ไขเรื่องนี้ในการทำงานต่อไป
บทความยังยอมรับว่ารูปร่างที่ NLR สร้างขึ้นไม่แม่นยำเท่าบางแนวทางอื่น เช่น การเลือกมุมมองรายพิกเซลสำหรับภาพสเตอริโอหลายมุมมองแบบไร้โครงสร้าง หรืองานวิจัยของ Weizmann Institute ที่กล่าวถึงก่อนหน้านี้
การเติบโตของการสังเคราะห์ภาพเชิงปริมาตร
แนวคิดการสร้างตัวตน 3 มิติจากภาพถ่ายจำนวนจำกัดด้วยโครงข่ายประสาทมีมาก่อน NeRF โดยมีบทความที่มองการณ์ไกลย้อนหลังไปถึงปี 2007 หรือก่อนหน้านั้น ในปี 2019 ฝ่ายวิจัย AI ของ Facebook เผยแพร่งานวิจัยสำคัญชื่อ Neural Volumes: การเรียนรู้ปริมาตรแบบเคลื่อนไหวที่เรนเดอร์ได้จากภาพ ซึ่งเปิดทางเป็นครั้งแรกให้อินเทอร์เฟซตอบสนองได้รวดเร็วสำหรับมนุษย์สังเคราะห์ที่สร้างจากการบันทึกเชิงปริมาตรด้วยการเรียนรู้ของเครื่อง
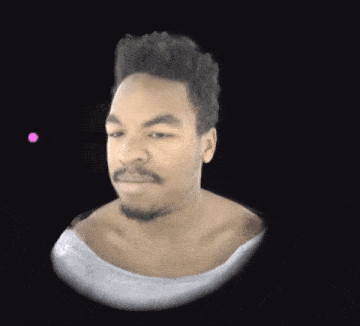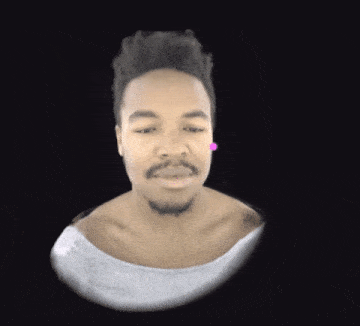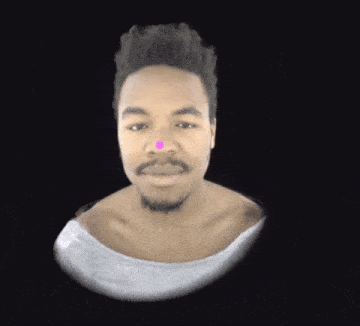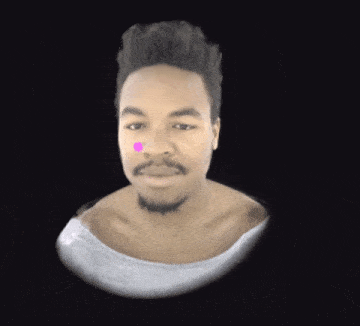
งานวิจัยปี 2019 ของ Facebook ทำให้สร้างอินเทอร์เฟซผู้ใช้ที่ตอบสนองได้รวดเร็วสำหรับมนุษย์เชิงปริมาตรได้ ที่มา: https://research.fb.com/publications/neural-volumes-learning-dynamic-renderable-volumes-from-images/


