
โมเดลและแพลตฟอร์ม AI
Test-Time Scaling: ส่วนผสมลับแห่งรุ่นใหม่ของโมเดลการให้เหตุผลระดับ PhD

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
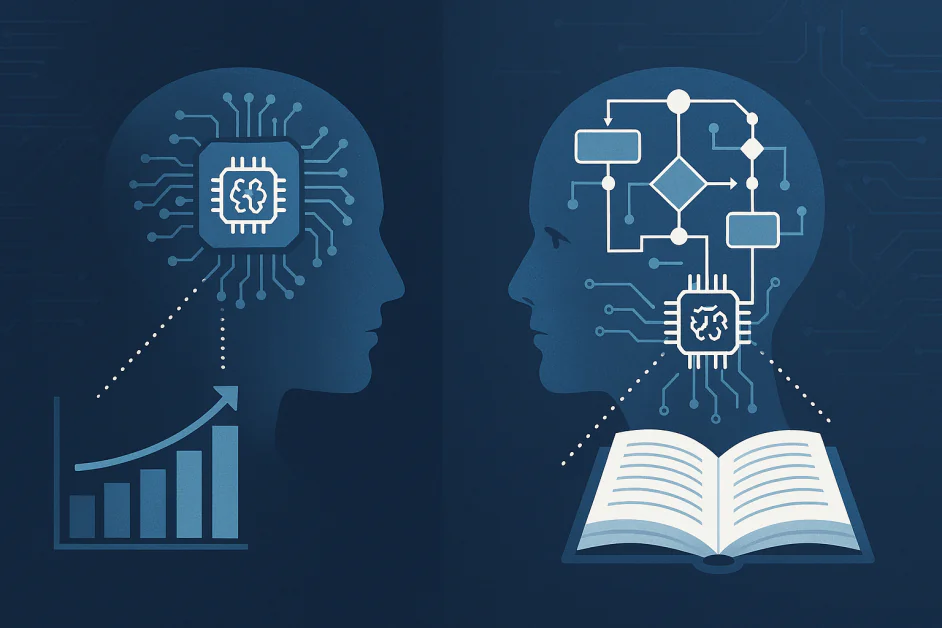
ประเด็นสำคัญการปรับขนาดช่วงทดสอบเปลี่ยนความพยายามด้านการคำนวณของ AI จากช่วงฝึกฝนไปสู่ช่วงอนุมาน…
ดูเพิ่มเติม
- การปรับขนาดช่วงทดสอบเปลี่ยนความพยายามด้านการคำนวณของ AI จากช่วงฝึกฝนไปสู่ช่วงอนุมาน เพื่อให้เกิดการให้เหตุผลที่ลึกซึ้งยิ่งขึ้น
- แนวทางนี้ทำให้โมเดลอย่าง o1 ของ OpenAI สามารถแก้ไขปัญหาในระดับปริญญาเอกได้ผ่านกระบวนการตรวจสอบภายใน
- เทคนิคดังกล่าวนำมาซึ่งต้นทุนการคำนวณที่แปรผันต่อคำถาม แต่ช่วยปลดล็อกศักยภาพของ AI ในการค้นพบสิ่งใหม่ๆ แบบเดิมพัน
สาขาปัญญาประดิษฐ์ได้มาถึงจุดที่การเพิ่มขนาดของโมเดลหรือการเพิ่มปริมาณข้อมูลไม่ใช่วิธีที่ดีที่สุดในการทำให้โมเดลมีความฉลาดมากขึ้น ในช่วงไม่กี่ปีที่ผ่านมา เราเชื่อว่าหากเราสร้างโครงข่ายประสาทเทียมที่ใหญ่ขึ้นและให้ข้อมูลอินเทอร์เน็ตมากขึ้น โมเดลเหล่านั้นจะกลายเป็นโมเดลที่ฉลาดขึ้น วิธีการนี้ซึ่งเรียกว่า กฎการปรับขนาด (scaling laws) ทำงานได้ดีมาก ทำให้เราได้รับโมเดลที่สามารถเขียนบทกวี, แปลภาษา และผ่านการสอบบาร์เอ็กซาม์ แต่โมเดลเหล่านี้มักจะดิ้นรนในการแก้ปัญหาที่ต้องใช้ตรรกะลึกซึ้ง คณิตศาสตร์ที่ซับซ้อน และปัญหาทางวิทยาศาสตร์ที่ต้องใช้การให้เหตุผลหลายขั้นตอน พวกมันเก่งในการจับคู่รูปแบบ แต่ล้มเหลวในการแก้ปัญหาที่ต้องใช้การให้เหตุผลหลายขั้นตอน
เมื่อเร็วๆ นี้ มีการเปลี่ยนแปลงแนวโน้มใหม่ที่เปลี่ยนแปลงวิธีการคิดเกี่ยวกับความสามารถของ AI แนวโน้มนี้เรียกว่า การปรับขนาดในขณะทดสอบ (test-time scaling) แทนที่จะเน้นไปที่สิ่งที่โมเดลเรียนรู้ในช่วงการฝึกอบรม นักวิจัยกำลังเน้นไปที่สิ่งที่โมเดล “คิด” เมื่อมันกำลังตอบคำถาม การเปลี่ยนแปลงนี้คือ ส่วนผสมลับแห่งรุ่นใหม่ของโมเดลการให้เหตุผล เช่น ซีรีส์ o1 ของ OpenAI ซึ่งสามารถทำงานได้ในระดับเดียวกับนักศึกษาระดับ PhD ในสาขาวิชาที่ยาก เช่น ฟิสิกส์ เคมี และชีววิทยา
การเปลี่ยนแปลงจากการจัดขนาดการฝึกอบรมไปสู่การจัดขนาดการอนุมาน
เพื่อเข้าใจว่าทำไมการเปลี่ยนแปลงนี้จึงสำคัญ เราต้องดูว่า AI ถูกสร้างขึ้นอย่างไรจนถึงตอนนี้ ตามประเพณี “ความฉลาด” ของโมเดลจะถูกกำหนดโดยการฝึกอบรม ซึ่งหมายถึงการลงทุนหลายเดือนและหลายล้านดอลลาร์เพื่อฝึกโมเดลด้วยข้อมูลจำนวนมากผ่าน GPU หลายพันเครื่อง เมื่อการฝึกอบรมเสร็จสิ้น โมเดลจะถูก “แช่แข็ง” เมื่อคุณถามคำถาม มันจะตอบคำถามนั้นเกือบจะทันทีโดยอาศัยรูปแบบที่มันเรียนรู้ไว้แล้ว นี่คือสิ่งที่เรียกว่า การอนุมาน (inference) หรือ การทดสอบ
ปัญหากับวิธีการแบบดั้งเดิมคือโมเดลมีโอกาสเพียงครั้งเดียวในการตอบคำถามให้ถูกต้อง มันประมวลผลคำถามและสร้างโทเค็นต่อไปเรื่อยๆ โดยไม่มีทาง “คิด” หรือ “ตรวจสอบ” ตรรกะของมันเองก่อนที่จะตอบ การปรับขนาดในขณะทดสอบเปลี่ยนแปลงพลวัตนี้ มันทำให้โมเดลสามารถใช้พลังการประมวลผลมากขึ้นในช่วงการอนุมาน เช่นเดียวกับมนุษย์ที่อาจใช้ไม่กี่วินาทีตอบคำถามง่ายๆ แต่ใช้หลายนาทีหรือหลายชั่วโมงแก้โจทย์คณิตศาสตร์ซับซ้อน โมเดล AI จึงถูกออกแบบให้ปรับความพยายามตามความยากของงาน
การกำหนดแนวคิดเรื่องการปรับขนาดในขณะทดสอบ
การปรับขนาดในขณะทดสอบ หมายถึงเทคนิคที่ทำให้โมเดล AI สามารถใช้ทรัพยากรการประมวลผลเพิ่มเติมเพื่อประมวลผลคำขอในขณะส่งมอบ ในคำอื่นๆ มันหมายถึงการให้ “เวลาในการคิด” มากขึ้นแก่โมเดล นี่ไม่ใช่เรื่องของการทำให้โมเดลใหญ่ขึ้น แต่เป็นการทำให้โมเดล “คิด” มากขึ้น เมื่อโมเดลใช้การปรับขนาดในขณะทดสอบ มันไม่ได้เพียงแต่สร้างคำตอบแรกที่นึกออกเท่านั้น แต่อาจจะสำรวจเส้นทางต่างๆ ตรวจสอบข้อผิดพลาดในตรรกะของมันเอง และปรับปรุงคำตอบก่อนที่ผู้ใช้จะเห็นมัน
แนวคิดนี้มักถูกเปรียบกับการทำงานของสมองมนุษย์ นักจิตวิทยามักพูดถึงการคิดแบบ “ระบบ 1” และ “ระบบ 2” ระบบ 1 รวดเร็ว อาศัยสัญชาตญาณและอารมณ์ เป็นสิ่งที่คุณใช้เมื่อจดจำใบหน้าหรือขับรถบนถนนที่คุ้นเคย ระบบ 2 ช้ากว่า รอบคอบกว่า และมีเหตุผล เป็นสิ่งที่คุณใช้เมื่อแก้สมการคณิตศาสตร์ยากๆ หรือวางแผนโครงการซับซ้อน จนกระทั่งไม่นานมานี้ LLM ส่วนใหญ่เป็นนักคิดแบบระบบ 1 การปรับขนาดในขณะทดสอบเป็นสะพานที่ช่วยให้เข้าถึงการคิดแบบระบบ 2 ได้
กลไกของกระบวนการให้เหตุผล
มีหลายวิธีที่นักวิจัยบรรลุการปรับขนาดในขณะทดสอบ วิธีการที่พบบ่อยที่สุดหนึ่งวิธีคือ การกระตุ้น Chain of Thought (CoT) แต่ในโมเดลใหม่ๆ วิธีการนี้ถูกสร้างเข้าไปในระบบโดยตรง ไม่ใช่สิ่งที่ผู้ใช้ต้องขอ โมเดลถูกฝึกให้แบ่งปัญหาออกเป็นขั้นตอนย่อยที่เป็นเหตุเป็นผล เมื่อทำเช่นนี้ โมเดลสามารถตรวจสอบส่วนต่างๆ ของคำตอบก่อนที่จะไปยังขั้นตอนถัดไป
อีกเทคนิคสำคัญคืออัลกอริทึมค้นหา เช่น Monte Carlo Tree Search แทนที่จะเพียงทำนายคำถัดไปที่มีความเป็นไปได้สูงสุด โมเดล จะสร้างเส้นทางคำตอบที่เป็นไปได้หลายทาง ประเมินเส้นทางเหล่านั้น และเลือกเส้นทางที่มีแนวโน้มจะนำไปสู่คำตอบที่ถูกต้องมากที่สุด หากพบทางตันหรือตระหนักว่าขั้นตอนก่อนหน้าผิด ก็สามารถย้อนกลับไปลองวิธีอื่นได้ ความสามารถในการมองล่วงหน้านี้คล้ายกับเอนจินหมากรุกที่ประเมินตาเดินที่เป็นไปได้นับพันก่อนเลือกตาที่ดีที่สุด การค้นหาความเป็นไปได้หลายทางระหว่างการอนุมานช่วยให้โมเดลแก้ปัญหาที่ซับซ้อนกว่าปัญหาที่ LLM มาตรฐานตอบได้โดยตรงอย่างมาก
ทำไมการให้เหตุผลระดับ PhD ต้องการมากกว่าความจำ
สิ่งนี้มีความสำคัญมากเพราะการให้เหตุผลระดับสูงในวิทยาศาสตร์และคณิตศาสตร์ไม่สามารถแก้ไขได้ด้วยความจำเพียงอย่างเดียว ในการสอบ PhD ในฟิสิกส์ คุณไม่สามารถตอบซ้ำข้อเท็จจริงที่คุณอ่านในหนังสือได้ คุณต้องใช้หลักการซับซ้อนกับสถานการณ์ใหม่และไม่เหมือนใคร โมเดลมาตรฐานมักจะสร้างข้อมูลผิดหรือ “หลอน” ในสถานการณ์เหล่านี้เพราะพวกมันพยายามคาดการณ์คำถัดไปตามความน่าจะเป็นมากกว่าตรรกะ
การปรับขนาดในขณะทดสอบทำให้โมเดลทำงานคล้ายนักวิจัยมากขึ้น โดยทดสอบสมมติฐานภายในได้ เช่น เมื่อถูกขอให้เขียนโค้ดซับซ้อน โมเดลสามารถ “รัน” ตรรกะในสายโซ่ความคิดที่ซ่อนอยู่ ระบุบั๊กที่อาจเกิดขึ้น และแก้ไขก่อนนำเสนอโค้ดสุดท้าย ความสามารถในการแก้ไขตนเองนี้ทำให้โมเดลรุ่นใหม่ได้คะแนนสูงในการทดสอบอย่าง American Invitational Mathematics Examination (AIME) หรือ GPQA ซึ่งเป็นข้อสอบวิทยาศาสตร์ยากที่ผู้เชี่ยวชาญออกแบบ โมเดลไม่ได้เพียงคาดเดา แต่กำลังตรวจสอบ
การแลกเปลี่ยนระหว่างประสิทธิภาพและต้นทุนการประมวลผล
แม้ว่าการปรับขนาดในขณะทดสอบจะมีพลัง แต่ก็มีค่าใช้จ่ายที่สำคัญ ในวิธีการแบบดั้งเดิม ส่วนแพงที่สุดของ AI คือการฝึกอบรม เมื่อโมเดลถูกใช้งาน ค่าใช้จ่ายจะลดลงและประมวลผลได้เร็วขึ้น แต่ด้วยการปรับขนาดในขณะทดสอบ ค่าใช้จ่ายจะเปลี่ยนไปที่คำขอของผู้ใช้ เนื่องจากโมเดลทำงานมากขึ้นด้วยการสร้างหลายเส้นทางและตรวจสอบงานของตนเอง จึงตอบช้าลงและต้องใช้ทรัพยากรฮาร์ดแวร์มากขึ้น
สิ่งนี้สร้างเศรษฐศาสตร์แบบใหม่สำหรับ AI เรากำลังก้าวสู่สถานการณ์ที่ “ต้นทุนต่อคำถาม” อาจแตกต่างกันอย่างมาก คำถามง่ายๆ เกี่ยวกับสภาพอากาศอาจมีต้นทุนเพียงเศษเสี้ยวของเซนต์และใช้เวลาหนึ่งวินาที การค้นคว้าวิทยาศาสตร์เชิงลึกอาจมีต้นทุนการประมวลผลหลายดอลลาร์และใช้เวลาหนึ่งชั่วโมง ข้อแลกเปลี่ยนนี้จำเป็นต่อการให้เหตุผลระดับสูง แต่ก็หมายความว่านักพัฒนาต้องหาวิธีทำให้โมเดลมีประสิทธิภาพเพื่อใช้งานในวงกว้างในสาขาอย่างการแพทย์หรือวิศวกรรม
ผลกระทบต่ออนาคตของปัญญาประดิษฐ์
การเพิ่มขึ้นของการปรับขนาดในขณะทดสอบชี้ให้เห็นว่าเราอาจจะเข้าสู่ยุคใหม่ของการพัฒนา AI มาหลายปีที่ผ่านมา มีความกังวลว่าเราจะหมดข้อมูลคุณภาพสูงของมนุษย์ที่จะฝึกโมเดล หากโมเดลเรียนรู้จากสิ่งที่มนุษย์เขียนไว้เท่านั้น พวกมันอาจจะถึงขีดจำกัด
อย่างไรก็ตาม การปรับขนาดในขณะทดสอบ แสดงให้เห็น ว่าโมเดลปรับปรุงประสิทธิภาพได้ด้วยการคิดให้หนักขึ้น ไม่ใช่เพียงอ่านมากขึ้น
สิ่งนี้เปิดทางให้ AI ค้นพบสิ่งใหม่ด้วยตนเอง หากโมเดลให้เหตุผลเพื่อแก้ปัญหาที่ไม่เคยเห็นมาก่อนได้ ก็อาจค้นพบวิธีแก้ใหม่ในวัสดุศาสตร์ การค้นพบยา หรือพลังงานหมุนเวียน เป็นการเปลี่ยน AI จากผู้ช่วยสรุปข้อความไปเป็นผู้ร่วมงานดิจิทัลที่ช่วยแก้ปัญหายากที่สุดของโลก เรากำลังเห็นการเปลี่ยนจาก AI “สร้างสรรค์เนื้อหา” ไปสู่ AI “ให้เหตุผล”
สรุป
การปรับขนาดในขณะทดสอบเป็นกุญแจสำคัญในการบรรลุความสามารถ AI ที่ขั้นสูง โดยการทำให้โมเดลสามารถใช้ทรัพยากรการประมวลผลมากขึ้นในขณะอนุมาน เราได้ปลดล็อกระดับประสิทธิภาพที่ก่อนหน้านี้คิดว่ายังต้องรออีกหลายปี โมเดลเหล่านี้เริ่มแสดงตรรกะที่รู้สึกใกล้เคียงกับมนุษย์มากกว่าการจับคู่รูปแบบแบบง่ายๆ ในอดีต
เมื่อเราเดินหน้าต่อไป ท้าทายจะอยู่ที่การปรับปรุงเทคนิคเหล่านี้ เราต้องทำให้การให้เหตุผลเร็วขึ้นและเข้าถึงได้ง่ายขึ้น ในขณะเดียวกันก็หาสมดุลที่ถูกต้องระหว่าง “การคิดเร็ว” และ “การคิดช้า” ส่วนผสมลับไม่ใช่ขนาดของโมเดลหรือปริมาณข้อมูลที่มันเห็นอีกต่อไป ส่วนผสมลับอยู่ที่ว่าโมเดลใช้เวลาในการคิดอย่างไร สำหรับทุกคนที่ติดตามความก้าวหน้าของ AI มันชัดเจนว่าจุดสนใจได้เปลี่ยนไป การแข่งขันไม่ใช่แค่เรื่องของใครมีโมเดลที่ใหญ่ที่สุด แต่เป็นใครมีโมเดลที่ให้เหตุผลได้ดีที่สุด การเปลี่ยนแปลงนี้มีแนวโน้มที่จะกำหนดความก้าวหน้าในอุตสาหกรรมนี้ใน ทศวรรษหน้า


