
โมเดลและแพลตฟอร์ม AI
เทคนิคใหม่ช่วยให้ AI คิดล่วงหน้าไปในอนาคตได้ไกล

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
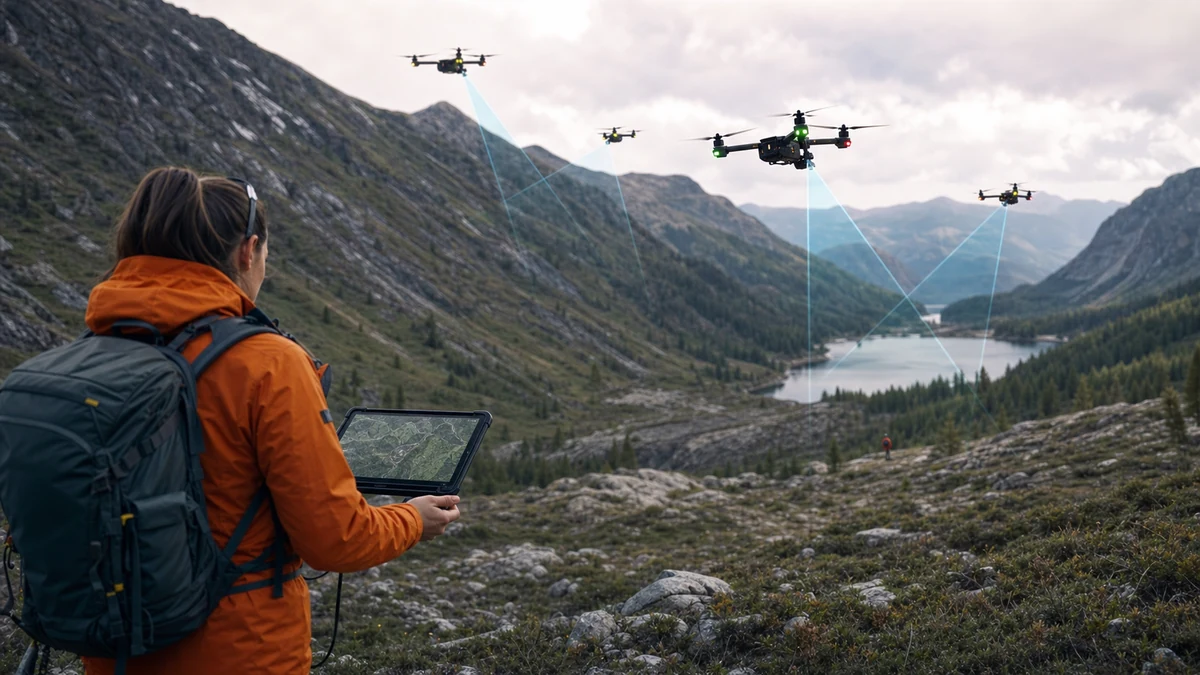
ทีมนักวิจัยจาก MIT, MIT-IBM Watson AI Lab และสถาบันอื่นๆ ได้พัฒนาแนวทางใหม่ที่ช่วยให้เอไอ (AI) มีมุมมองในระยะยาว ในอีกคำหนึ่ง เอไอสามารถคิดล่วงหน้าไปในอนาคตได้เมื่อพิจารณาว่าพฤติกรรมของตนเองจะส่งผลต่อพฤติกรรมของเอไออื่นๆ เมื่อทำงานร่วมกัน
งานวิจัยนี้ มีกำหนดนำเสนอที่ Conference on Neural Information Processing Systems
เอไอพิจารณาการกระทำในอนาคตของเอไออื่นๆ
เฟรมเวิร์กการเรียนรู้ของเครื่องจากทีมนักวิจัยช่วยให้เอไอสามารถทำงานร่วมกันหรือแข่งขันกัน โดยพิจารณาว่าเอไออื่นๆ จะทำอะไรในอนาคต ไม่ใช่แค่ในขั้นตอนถัดไป แต่ในระยะเวลาที่เข้าใกล้อนันต์ เอไอเหล่านี้ปรับพฤติกรรมของตนเองตามนั้นเพื่อส่งผลต่อพฤติกรรมของเอไออื่นๆ ในอนาคต และช่วยให้พวกมันบรรลุเป้าหมายที่ดีที่สุดในระยะยาว
ตามทีมนักวิจัย เฟรมเวิร์กนี้สามารถใช้ได้ เช่น ในกลุ่มโดรนอัตโนมัติที่ทำงานร่วมกันเพื่อค้นหาผู้ที่สูญหาย หรือในรถยนต์ไร้คนขับที่ต้องคาดการณ์การเคลื่อนไหวของรถยนต์อื่นๆ เพื่อเพิ่มความปลอดภัยให้กับผู้โดยสาร
Dong-Ki Kim เป็นนักศึกษาระดับบัณฑิตศึกษาใน MIT Laboratory for Information and Decision Systems (LIDS) และเป็นผู้เขียนหลักของการวิจัย
“เมื่อเอไอทำงานร่วมกันหรือแข่งขันกัน สิ่งที่สำคัญที่สุดคือเมื่อพฤติกรรมของพวกมันบรรลุจุดเดียวกันในอนาคต” Kim กล่าว “มีพฤติกรรมชั่วคราวมากมายระหว่างทางที่ไม่สำคัญมากนักในระยะยาว สิ่งที่เราต้องการคือการบรรลุพฤติกรรมที่บรรจบกัน และตอนนี้เรามีวิธีการทางคณิตศาสตร์ในการทำให้ได้ผล”
ปัญหาที่นักวิจัยต้องเผชิญคือการเรียนรู้แบบเสริมกำลังหลายตัวแทน (multi-agent reinforcement learning) โดยการเรียนรู้แบบเสริมกำลังเป็นรูปแบบหนึ่งของการเรียนรู้ของเครื่อง ที่เอไอเรียนรู้ผ่านการลองผิดลองถูก
เมื่อมีเอไอหลายตัวที่เรียนรู้พร้อมๆ กัน การเรียนรู้จะซับซ้อนมากขึ้น เมื่อเอไอต้องพิจารณาการกระทำในอนาคตของเอไออื่นๆ รวมถึงพฤติกรรมของตนเองและวิธีที่มันส่งผลต่อผู้อื่น ปัญหาเหล่านี้ต้องการกำลังการประมวลผลมากเกินไป
เอไอคิดถึงอนันต์
“เอไออยากคิดถึงจุดสิ้นสุดของเกม แต่พวกมันไม่รู้ว่าเกมจะสิ้นสุดเมื่อไหร่” Kim กล่าว “พวกมันต้องคิดว่าจะปรับพฤติกรรมของตนเองอย่างไรเพื่อให้ชนะในอนาคตที่ไกลโพ้น การวิจัยของเราขอเสนอวัตถุประสงค์ใหม่ที่ช่วยให้เอไอคิดถึงอนันต์ได้”
ไม่สามารถรวมอนันต์เข้ากับอัลกอริทึมได้ ดังนั้นทีมจึงออกแบบระบบให้เอไอเน้นไปที่จุดในอนาคตที่พฤติกรรมของพวกมันจะบรรจบกับเอไออื่นๆ จุดนี้เรียกว่าสมดุล และจุดสมดุลกำหนดการทำงานในระยะยาวของเอไอ
ในสถานการณ์หลายตัวแทน อาจมีสมดุลหลายจุดได้ และเมื่อเอไอที่มีประสิทธิภาพสามารถส่งผลต่อพฤติกรรมในอนาคตของเอไออื่นๆ พวกมันสามารถบรรลุสมดุลที่พึงประสงค์ได้ เมื่อทุกเอไอส่งผลต่อผู้อื่น พวกมันจะบรรจบกันที่แนวคิดที่เรียกว่า “สมดุลเชิงรุก”
เฟรมเวิร์ก FURTHER
เฟรมเวิร์กการเรียนรู้ของเครื่องจากทีมนักวิจัยเรียกว่า FURTHER และช่วยให้เอไอเรียนรู้วิธีการปรับพฤติกรรมตามการโต้ตอบกับเอไออื่นๆ เพื่อบรรลุสมดุลเชิงรุก
เฟรมเวิร์กนี้พึ่งพาโมดูลการเรียนรู้ของเครื่องสองแบบ โมดูลแรกคือโมดูลการอนุมานที่ช่วยให้เอไอสามารถเดาพฤติกรรมในอนาคตของเอไออื่นๆ และอัลกอริทึมการเรียนรู้ที่พวกมันใช้ตามการกระทำในอดีต ข้อมูลนี้จะถูกส่งไปยังโมดูลการเรียนรู้แบบเสริมกำลังที่เอไอใช้ในการปรับพฤติกรรมและส่งผลต่อเอไออื่นๆ
“ความท้าทายคือการคิดถึงอนันต์ เราต้องใช้เครื่องมือทางคณิตศาสตร์มากมายเพื่อให้ได้ผลลัพธ์ และต้องมีการตั้งสมมติฐานบางอย่างเพื่อให้ได้ผลในทางปฏิบัติ” Kim กล่าว
ทีมนักวิจัยทดสอบวิธีการของตนเทียบกับเฟรมเวิร์กการเรียนรู้แบบเสริมกำลังหลายตัวแทนอื่นๆ ในสถานการณ์ต่างๆ และพบว่าเอไอที่ใช้ FURTHER มีประสิทธิภาพมากกว่า
วิธีการนี้เป็นการกระจายอำนาจ ทำให้เอไอเรียนรู้และชนะได้อย่างอิสระ นอกจากนี้ยังเหมาะสมสำหรับการขยายขนาดมากกว่าวิธีอื่นๆ ที่ต้องการคอมพิวเตอร์กลางในการควบคุมเอไอ
ตามทีมนักวิจัย FURTHER สามารถใช้ได้ในหลายปัญหาที่เกี่ยวข้องกับหลายตัวแทน Kim มีความหวังว่าจะสามารถนำไปใช้ในด้านเศรษฐศาสตร์เพื่อสร้างนโยบายที่มีประสิทธิภาพในสถานการณ์ที่มีหลายหน่วยที่มีพฤติกรรมและความสนใจที่เปลี่ยนแปลงไปตามเวลา



