

โมเดลและแพลตฟอร์ม AI
SEER: ความก้าวหน้าครั้งสำคัญของโมเดลคอมพิวเตอร์วิทัศน์แบบกำกับตนเองหรือไม่?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
ในช่วงสิบปีที่ผ่านมา ปัญญาประดิษฐ์ (AI) และการเรียนรู้ของเครื่อง (ML) ก้าวหน้าอย่างมาก ปัจจุบันมีความแม่นยำ ประสิทธิภาพ และความสามารถสูงกว่าที่เคย โมเดล AI และ ML สมัยใหม่สามารถจดจำวัตถุในภาพหรือไฟล์วิดีโอได้อย่างราบรื่นและแม่นยำ อีกทั้งสร้างข้อความและคำพูดที่เทียบเคียงกับความสามารถทางสติปัญญาของมนุษย์ได้
โมเดล AI และ ML ในปัจจุบันพึ่งพาการฝึกด้วยชุดข้อมูลที่มีป้ายกำกับอย่างมาก เพื่อเรียนรู้วิธีตีความข้อความ ระบุวัตถุในภาพหรือเฟรมวิดีโอ และทำงานอื่น ๆ อีกหลายประเภท
แม้จะมีความสามารถสูง แต่โมเดล AI และ ML ยังไม่สมบูรณ์แบบ นักวิทยาศาสตร์กำลังพัฒนาโมเดลที่เรียนรู้จากข้อมูลที่ได้รับ โดยไม่จำเป็นต้องพึ่งข้อมูลที่ติดป้ายกำกับหรือคำอธิบายประกอบ แนวทางนี้เรียกว่าการเรียนรู้แบบกำกับตนเองซึ่งเป็นหนึ่งในวิธีที่มีประสิทธิภาพที่สุดในการสร้างโมเดล ML และ AI ที่มี “สามัญสำนึก” หรือความรู้พื้นฐานสำหรับแก้ปัญหาที่เกินความสามารถของโมเดล AI ในปัจจุบัน
การเรียนรู้แบบกำกับตนเองแสดงผลลัพธ์แล้วในด้านการประมวลผลภาษาธรรมชาติ โดยช่วยให้นักพัฒนาฝึกโมเดลขนาดใหญ่ที่ทำงานกับข้อมูลมหาศาล และนำไปสู่ความก้าวหน้าหลายด้าน ได้แก่การอนุมานภาษาธรรมชาติ การแปลด้วยเครื่อง และการตอบคำถาม
โมเดล SEER ของ Facebook (META ) AI มุ่งเพิ่มขีดความสามารถของการเรียนรู้แบบกำกับตนเองในด้านคอมพิวเตอร์วิทัศน์ SEER ย่อมาจาก SElf SupERvised เป็นโมเดลคอมพิวเตอร์วิทัศน์ที่เรียนรู้แบบกำกับตนเอง มีพารามิเตอร์กว่าหนึ่งพันล้านตัว และค้นหารูปแบบหรือเรียนรู้ได้แม้จากกลุ่มภาพสุ่มบนอินเทอร์เน็ตที่ไม่มีคำอธิบายประกอบหรือป้ายกำกับที่เหมาะสม
ความจำเป็นของการเรียนรู้แบบกำกับตนเองในคอมพิวเตอร์วิทัศน์
การใส่คำอธิบายประกอบหรือป้ายกำกับข้อมูลเป็นขั้นตอนก่อนประมวลผลในการพัฒนาโมเดลการเรียนรู้ของเครื่องและ AI กระบวนการนี้ระบุข้อมูลดิบ เช่น ภาพหรือเฟรมวิดีโอ แล้วเพิ่มป้ายกำกับเพื่อบอกบริบทของข้อมูลแก่โมเดล ป้ายกำกับเหล่านี้ช่วยให้โมเดลทำนายข้อมูลได้แม่นยำ
หนึ่งในอุปสรรคสำคัญที่สุดของนักพัฒนาโมเดลคอมพิวเตอร์วิทัศน์คือการหาข้อมูลคุณภาพสูงที่มีคำอธิบายประกอบ โมเดลคอมพิวเตอร์วิทัศน์ในปัจจุบันอาศัยชุดข้อมูลที่ติดป้ายกำกับหรือคำอธิบายประกอบเหล่านี้เพื่อเรียนรู้รูปแบบที่ช่วยให้จดจำวัตถุในภาพได้
การใส่คำอธิบายประกอบข้อมูลและนำไปใช้ในโมเดลคอมพิวเตอร์วิทัศน์ก่อให้เกิดความท้าทายดังนี้
การรักษาคุณภาพชุดข้อมูลให้สม่ำเสมอ
อุปสรรคใหญ่ที่สุดของนักพัฒนาอาจเป็นการเข้าถึงชุดข้อมูลคุณภาพสูงอย่างต่อเนื่อง เพราะข้อมูลที่มีป้ายกำกับเหมาะสมและภาพชัดเจนช่วยให้เรียนรู้ได้ดีและสร้างโมเดลที่แม่นยำ แต่การเข้าถึงข้อมูลเช่นนี้อย่างสม่ำเสมอก็มีความท้าทายของตนเอง
การบริหารกำลังคน
การติดป้ายกำกับข้อมูลมักมีปัญหาด้านการบริหารกำลังคน เนื่องจากต้องใช้คนจำนวนมากในการประมวลผลและติดป้ายกำกับข้อมูลปริมาณมหาศาลที่ไม่มีโครงสร้างหรือป้ายกำกับ พร้อมรักษาคุณภาพไว้ นักพัฒนาจึงต้องสร้างสมดุลระหว่างคุณภาพและปริมาณ
ข้อจำกัดทางการเงิน
อุปสรรคใหญ่ที่สุดอีกประการคือข้อจำกัดทางการเงินที่มากับกระบวนการติดป้ายกำกับข้อมูล ซึ่งมักมีต้นทุนคิดเป็นสัดส่วนสำคัญของต้นทุนโครงการทั้งหมด
ดังนั้น การใส่คำอธิบายประกอบข้อมูลจึงเป็นอุปสรรคสำคัญในการพัฒนาโมเดลคอมพิวเตอร์วิทัศน์ขั้นสูง โดยเฉพาะโมเดลซับซ้อนที่ใช้ข้อมูลฝึกจำนวนมาก นี่คือเหตุผลที่วงการคอมพิวเตอร์วิทัศน์ต้องการการเรียนรู้แบบกำกับตนเอง เพื่อพัฒนาโมเดลซับซ้อนและก้าวหน้าที่รับมือกับงานเกินขอบเขตของโมเดลปัจจุบันได้
อย่างไรก็ตาม มีโมเดลการเรียนรู้แบบกำกับตนเองหลายตัวที่ทำงานได้ดีในสภาพแวดล้อมควบคุม โดยเฉพาะบนชุดข้อมูล ImageNet แต่โมเดลเหล่านี้ยังไม่ตอบเงื่อนไขสำคัญของการเรียนรู้แบบกำกับตนเองในคอมพิวเตอร์วิทัศน์ นั่นคือการเรียนรู้จากชุดข้อมูลที่ไม่จำกัดขอบเขตหรือภาพสุ่มใด ๆ แทนที่จะจำกัดอยู่กับชุดข้อมูลที่กำหนดไว้อย่างชัดเจนหากนำไปใช้อย่างเหมาะสม การเรียนรู้แบบกำกับตนเองจะช่วยพัฒนาโมเดลคอมพิวเตอร์วิทัศน์ที่แม่นยำและมีความสามารถสูงขึ้น พร้อมทั้งคุ้มค่าและนำไปใช้ได้จริง
แนะนำโมเดล SEER หรือ SElf-supERvised
แนวโน้มล่าสุดในวงการ AI และ ML ชี้ว่าแนวทางการฝึกล่วงหน้า เช่น การเรียนรู้แบบกึ่งมีผู้สอน แบบมีการกำกับอย่างอ่อน และแบบกำกับตนเอง สามารถเพิ่มประสิทธิภาพของโมเดลการเรียนรู้เชิงลึกส่วนใหญ่ในงานปลายทางได้อย่างมาก
มีปัจจัยสำคัญสองประการที่ช่วยเพิ่มประสิทธิภาพของโมเดลการเรียนรู้เชิงลึกเหล่านี้อย่างมาก
การฝึกล่วงหน้าบนชุดข้อมูลมหาศาล
การฝึกล่วงหน้าบนชุดข้อมูลมหาศาลมักให้ความแม่นยำและประสิทธิภาพดีขึ้น เพราะโมเดลได้พบข้อมูลหลากหลาย ชุดข้อมูลขนาดใหญ่ช่วยให้เข้าใจรูปแบบในข้อมูลได้ดีขึ้น และท้ายที่สุดทำงานในสถานการณ์จริงได้ดีขึ้น
โมเดลที่มีประสิทธิภาพสูง เช่น GPT-3 และ Wav2vec 2.0 ได้รับการฝึกบนชุดข้อมูลมหาศาล โมเดลภาษา GPT-3 ใช้ชุดข้อมูลฝึกล่วงหน้าที่มีมากกว่าสามแสนล้านคำส่วนโมเดลรู้จำเสียงพูด Wav2vec 2.0 ใช้ชุดข้อมูลที่มีข้อมูลเสียงมากกว่า 53,000 ชั่วโมง
โมเดลที่มีความจุสูงมาก
โมเดลที่มีพารามิเตอร์มากมักให้ผลลัพธ์แม่นยำ เพราะช่วยให้โมเดลมุ่งเน้นเฉพาะวัตถุที่จำเป็นในข้อมูล แทนที่จะสนใจสิ่งรบกวนหรือสัญญาณรบกวน
นักพัฒนาเคยพยายามฝึกโมเดลการเรียนรู้แบบกำกับตนเองด้วยข้อมูลที่ไม่มีป้ายกำกับหรือไม่ได้คัดสรร แต่ใช้ชุดข้อมูลขนาดเล็กที่มีภาพเพียงไม่กี่ล้านภาพแล้วโมเดลการเรียนรู้แบบกำกับตนเองจะให้ความแม่นยำสูงได้หรือไม่ เมื่อฝึกด้วยข้อมูลมหาศาลที่ไม่มีป้ายกำกับและไม่ได้คัดสรร?นี่คือคำถามที่ SEER มุ่งตอบ
SEER เป็นกรอบการเรียนรู้เชิงลึกที่มุ่งประมวลผลภาพบนอินเทอร์เน็ตโดยไม่พึ่งชุดข้อมูลที่คัดสรรหรือติดป้ายกำกับ กรอบนี้ช่วยให้นักพัฒนาฝึกโมเดล ML ขนาดใหญ่และซับซ้อนด้วยข้อมูลสุ่มโดยไม่มีการกำกับ กล่าวคือโมเดลวิเคราะห์ข้อมูลและเรียนรู้รูปแบบหรือข้อมูลด้วยตนเอง โดยไม่ต้องเพิ่มข้อมูลป้อนเข้าด้วยมือ
เป้าหมายสูงสุดของ SEER คือช่วยพัฒนากลยุทธ์การฝึกล่วงหน้าที่ใช้ข้อมูลซึ่งไม่ได้คัดสรร เพื่อให้การเรียนรู้แบบถ่ายโอนมีประสิทธิภาพระดับแนวหน้า นอกจากนี้SEER ยังมุ่งสร้างระบบที่เรียนรู้แบบกำกับตนเองได้อย่างต่อเนื่องจากกระแสข้อมูลที่ไม่มีวันสิ้นสุด
กรอบ SEER ฝึกโมเดลความจุสูงด้วยภาพสุ่มที่ไม่มีข้อจำกัดจำนวนหลายพันล้านภาพจากอินเทอร์เน็ต โมเดลเหล่านี้ไม่พึ่งเมทาดาทาหรือคำอธิบายประกอบภาพในการฝึกหรือกรองข้อมูล ในช่วงหลัง การเรียนรู้แบบกำกับตนเองแสดงศักยภาพสูง เพราะโมเดลที่ฝึกด้วยข้อมูลซึ่งไม่ได้คัดสรรให้ผลลัพธ์ในงานปลายทางดีกว่าโมเดลที่ฝึกล่วงหน้าแบบมีผู้สอน
กรอบ SEER กับ RegNet เชื่อมโยงกันอย่างไร?
การวิเคราะห์ SEER เน้นสถาปัตยกรรม RegNet ที่มีพารามิเตอร์มากกว่า 700 ล้านตัว ซึ่งสอดคล้องกับเป้าหมายการเรียนรู้แบบกำกับตนเองบนข้อมูลที่ไม่ได้คัดสรรด้วยเหตุผลหลักสองข้อ
- ให้สมดุลที่ดีมากระหว่างประสิทธิภาพและความคุ้มค่าของทรัพยากร
- มีความยืดหยุ่นสูงและขยายขนาดตามจำนวนพารามิเตอร์ได้

กรอบ SEER: งานก่อนหน้าในหลายสาขา
กรอบ SEER มุ่งสำรวจขีดจำกัดของการฝึกสถาปัตยกรรมโมเดลขนาดใหญ่บนชุดข้อมูลที่ไม่ได้คัดสรรหรือไม่มีป้ายกำกับ ด้วยการเรียนรู้แบบกำกับตนเอง โดยได้รับแรงบันดาลใจจากงานก่อนหน้าในสาขานี้
การฝึกลักษณะเฉพาะทางภาพล่วงหน้าแบบไม่มีผู้สอน
คอมพิวเตอร์วิทัศน์ใช้การเรียนรู้แบบกำกับตนเองมาระยะหนึ่งแล้ว โดยอาศัยวิธีต่าง ๆ เช่นออโตเอนโคเดอร์ การแยกแยะระดับตัวอย่าง หรือการจัดกลุ่ม ช่วงหลัง วิธีการเรียนรู้แบบเปรียบต่างแสดงให้เห็นว่าการฝึกโมเดลล่วงหน้าแบบไม่มีผู้สอนสำหรับงานปลายทางอาจให้ผลดีกว่าแนวทางแบบมีผู้สอน
ข้อสรุปสำคัญจากการเรียนรู้ลักษณะเฉพาะทางภาพแบบไม่มีผู้สอนคือตราบใดที่ฝึกด้วยข้อมูลที่ผ่านการกรอง ก็ไม่จำเป็นต้องใช้ป้ายกำกับแบบมีผู้สอน SEER มุ่งสำรวจว่าโมเดลจะเรียนรู้ตัวแทนข้อมูลที่แม่นยำได้หรือไม่ เมื่อสถาปัตยกรรมขนาดใหญ่ได้รับการฝึกด้วยภาพสุ่มจำนวนมากที่ไม่ได้คัดสรรและไม่มีป้ายกำกับ
การเรียนรู้ลักษณะเฉพาะทางภาพในระดับใหญ่
โมเดลก่อนหน้าได้ประโยชน์จากการฝึกล่วงหน้าบนชุดข้อมูลติดป้ายกำกับขนาดใหญ่ ด้วยการเรียนรู้แบบกำกับอย่างอ่อน แบบมีผู้สอน และแบบกึ่งมีผู้สอน บนภาพที่กรองแล้วหลายล้านภาพ การวิเคราะห์ยังชี้ว่าการฝึกล่วงหน้าบนภาพหลายพันล้านภาพมักแม่นยำกว่าการฝึกโมเดลจากศูนย์
การฝึกระดับใหญ่มักใช้ขั้นตอนกรองข้อมูลเพื่อให้ภาพตรงกับแนวคิดเป้าหมาย โดยใช้การทำนายจากตัวจำแนกที่ฝึกไว้แล้ว หรือแฮชแท็กที่มักสอดคล้องกับกลุ่มคำพ้องความหมายของคลาสใน ImageNet แต่ SEER ต่างออกไป เพราะมุ่งเรียนรู้ลักษณะเฉพาะในภาพสุ่มใด ๆ ดังนั้นจึงไม่คัดสรรข้อมูลฝึกให้ตรงกับชุดลักษณะเฉพาะหรือแนวคิดที่กำหนดไว้ล่วงหน้า
การขยายสถาปัตยกรรมสำหรับการรู้จำภาพ
โมเดลมักได้ประโยชน์จากการฝึกสถาปัตยกรรมขนาดใหญ่ด้วยลักษณะเฉพาะทางภาพที่มีคุณภาพดีขึ้น การฝึกสถาปัตยกรรมขนาดใหญ่จำเป็นเมื่อฝึกล่วงหน้าบนชุดข้อมูลใหญ่ เพราะโมเดลที่มีความจุจำกัดมักเรียนรู้ข้อมูลได้ไม่เพียงพอ เรื่องนี้ยิ่งสำคัญเมื่อใช้การเรียนรู้แบบเปรียบต่างร่วมด้วย เพราะโมเดลต้องเรียนรู้การแยกแยะตัวอย่างในชุดข้อมูลเพื่อให้ได้ตัวแทนทางภาพที่ดีขึ้น
อย่างไรก็ตาม การขยายสถาปัตยกรรมสำหรับรู้จำภาพต้องทำมากกว่าปรับความลึกและความกว้างของโมเดล การสร้างโมเดลความจุสูงที่ขยายขนาดได้อย่างมีประสิทธิภาพต้องอาศัยงานศึกษาจำนวนมาก SEER แสดงประโยชน์ของตระกูลโมเดล RegNets ในการใช้การเรียนรู้แบบกำกับตนเองระดับใหญ่
SEER: วิธีการและองค์ประกอบที่ใช้
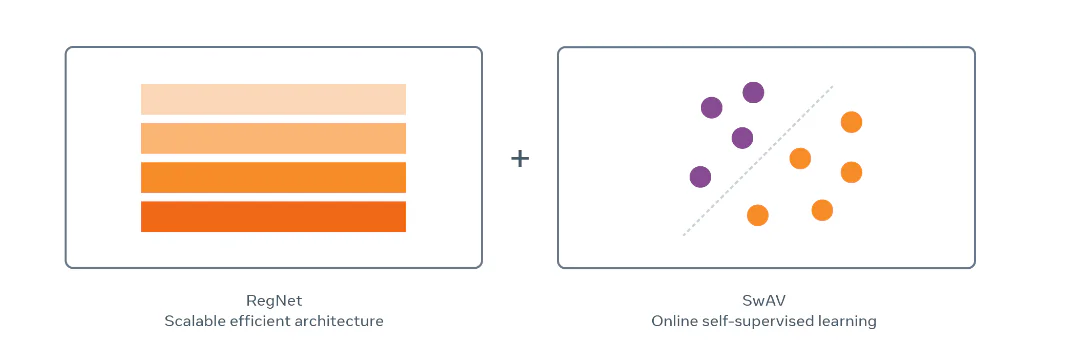
กรอบ SEER ใช้วิธีการและองค์ประกอบหลายอย่างในการฝึกโมเดลล่วงหน้าให้เรียนรู้ตัวแทนทางภาพ องค์ประกอบหลัก ได้แก่ RegNet และ SwAV ต่อไปจะอธิบายโดยย่อ
การฝึกล่วงหน้าแบบกำกับตนเองด้วย SwAV
กรอบ SEER ฝึกล่วงหน้าด้วย SwAV ซึ่งเป็นแนวทางการเรียนรู้แบบกำกับตนเองออนไลน์ โดย SwAV คือวิธีจัดกลุ่มแบบออนไลน์ที่ใช้ฝึกเครือข่ายประสาทเทียมแบบคอนโวลูชันโดยไม่มีคำอธิบายประกอบ SwAV ฝึกตัวแทนแบบฝังที่ให้การกำหนดกลุ่มสอดคล้องกันระหว่างมุมมองต่าง ๆ ของภาพเดียวกัน จากนั้นระบบเรียนรู้ตัวแทนเชิงความหมายด้วยการค้นหากลุ่มที่ไม่เปลี่ยนไปตามการแปลงเพื่อเพิ่มข้อมูล
ในทางปฏิบัติ SwAV เปรียบเทียบลักษณะเฉพาะของมุมมองต่าง ๆ ของภาพ โดยใช้การกำหนดกลุ่มอย่างอิสระของแต่ละมุมมอง หากการกำหนดกลุ่มจับลักษณะเฉพาะที่เหมือนหรือคล้ายกันได้ ก็สามารถใช้ลักษณะเฉพาะจากมุมมองหนึ่งทำนายการกำหนดกลุ่มของอีกมุมมองได้
SEER พิจารณากลุ่มจำนวน K กลุ่ม โดยแต่ละกลุ่มเชื่อมโยงกับเวกเตอร์ที่เรียนรู้ได้ขนาด d มิติ ซึ่งเขียนเป็น vkสำหรับแบตช์ที่มีภาพจำนวน B ภาพ แต่ละภาพ i ถูกแปลงเป็นสองมุมมอง ได้แก่ xi1 และ xi2จากนั้นใช้เครือข่ายคอนโวลูชันสกัดลักษณะเฉพาะของมุมมองทั้งสอง ได้เป็นลักษณะเฉพาะสองชุด คือ (f11, …, fB2) และ (f12, …, fB2) แต่ละชุดจะถูกกำหนดให้กับต้นแบบกลุ่มอย่างอิสระด้วยตัวแก้ปัญหาการขนส่งที่เหมาะสมที่สุด
ตัวแก้ปัญหาการขนส่งที่เหมาะสมที่สุดช่วยกระจายลักษณะเฉพาะระหว่างกลุ่มอย่างสมดุล และหลีกเลี่ยงคำตอบแบบง่ายที่ตัวแทนทั้งหมดถูกจับคู่กับต้นแบบเดียว จากนั้นสลับการกำหนดกลุ่มระหว่างสองชุด กล่าวคือ การกำหนดกลุ่ม yi1 ของมุมมอง xi1 ต้องถูกทำนายด้วยตัวแทนลักษณะเฉพาะ fi2 ของมุมมอง xi2 และทำในทิศทางกลับกันด้วย
จากนั้นฝึกน้ำหนักของต้นแบบและเครือข่ายคอนโวลูชันให้ลดค่าความสูญเสียของทุกตัวอย่าง ค่าความสูญเสียในการทำนายกลุ่ม l โดยพื้นฐานคือครอสเอนโทรปีระหว่างผลซอฟต์แมกซ์ของผลคูณจุดของ f กับการกำหนดกลุ่ม

RegNetY: ตระกูลโมเดลที่ขยายขนาดได้อย่างมีประสิทธิภาพ
การขยายความจุโมเดลและข้อมูลต้องใช้สถาปัตยกรรมที่มีประสิทธิภาพทั้งด้านหน่วยความจำและเวลาทำงาน RegNets เป็นตระกูลโมเดลที่ออกแบบมาเพื่อจุดประสงค์นี้โดยเฉพาะ
ตระกูลสถาปัตยกรรม RegNet กำหนดจากพื้นที่การออกแบบของเครือข่ายคอนโวลูชันที่มีสี่ช่วง แต่ละช่วงมีบล็อกเหมือนกันหลายบล็อก โดยคงโครงสร้างบล็อกไว้ โดยเฉพาะบล็อกคอขวดแบบมีการเชื่อมต่อส่วนตกค้าง
กรอบ SEER เน้นสถาปัตยกรรม RegNetY และเพิ่มองค์ประกอบ Squeeze-and-Excitation ให้กับ RegNets มาตรฐานเพื่อปรับปรุงประสิทธิภาพ RegNetY ยังมีพารามิเตอร์ห้าตัวที่ช่วยค้นหาโครงแบบที่ดีภายใต้จำนวน FLOP คงที่และใช้ทรัพยากรเหมาะสม SEER มุ่งปรับปรุงผลลัพธ์ด้วยการใช้ RegNetY โดยตรงในงานฝึกล่วงหน้าแบบกำกับตนเอง
สถาปัตยกรรม RegNetY 256GF:SEER เน้น RegNetY 256GF ในตระกูล RegNetY เป็นหลัก โดยพารามิเตอร์ใช้กฎการขยายขนาดของ RegNets รายละเอียดมีดังนี้

RegNetY 256GF มีสี่ช่วง โดยมีความกว้าง (528, 1056, 2904, 7392) และความลึก (2, 7, 17, 1) รวมพารามิเตอร์กว่า 696 ล้านตัว เมื่อฝึกบน NVIDIA V100 32 GB จำนวน 512 GPU แต่ละรอบใช้เวลาประมาณ 6,125 มิลลิวินาทีสำหรับแบตช์ขนาด 8,704 ภาพ การฝึกบนชุดข้อมูลกว่าหนึ่งพันล้านภาพด้วยแบตช์ 8,704 ภาพบน GPU มากกว่า 512 ตัว ต้องใช้ 114,890 รอบ และกินเวลาประมาณแปดวัน
การปรับให้เหมาะสมและการฝึกระดับใหญ่
SEER เสนอการปรับหลายอย่างเพื่อใช้และปรับวิธีการเรียนรู้แบบกำกับตนเองให้เหมาะกับขนาดใหญ่ ได้แก่
- ตารางอัตราการเรียนรู้
- การลดการใช้หน่วยความจำต่อ GPU
- การเพิ่มความเร็วในการฝึก
- ข้อมูลฝึกล่วงหน้าระดับใหญ่
ต่อไปจะอธิบายโดยย่อ
ตารางอัตราการเรียนรู้
SEER ศึกษาความเป็นไปได้ของการใช้ตารางอัตราการเรียนรู้สองแบบ ได้แก่ตารางอัตราการเรียนรู้แบบคลื่นโคไซน์และตารางอัตราการเรียนรู้แบบคงที่
ตารางอัตราการเรียนรู้แบบคลื่นโคไซน์ใช้เปรียบเทียบโมเดลต่าง ๆ อย่างเป็นธรรม เพราะปรับตามจำนวนครั้งของการอัปเดต แต่ไม่เหมาะกับการฝึกระดับใหญ่ เนื่องจากให้น้ำหนักภาพต่างกันตามเวลาที่พบภาพระหว่างฝึก และใช้จำนวนการอัปเดตทั้งหมดในการกำหนดตาราง
ตารางแบบคงที่รักษาอัตราการเรียนรู้ไว้จนค่าความสูญเสียหยุดลดลง แล้วหารอัตราการเรียนรู้ด้วยสอง การวิเคราะห์ชี้ว่าตารางแบบคงที่ทำงานได้ดีกว่า เพราะยืดหยุ่นต่อการฝึกมากกว่า อย่างไรก็ตาม เนื่องจากโมเดลฝึกบนภาพเพียงหนึ่งพันล้านภาพ จึงใช้ตารางโคไซน์สำหรับโมเดลใหญ่ที่สุด คือ RegNet 256GF
การลดการใช้หน่วยความจำต่อ GPU
โมเดลมุ่งลดหน่วยความจำ GPU ที่ต้องใช้ระหว่างฝึกด้วยการคำนวณแบบความละเอียดผสมและการทำจุดตรวจสอบเกรเดียนต์ โดยใช้ระดับการปรับให้เหมาะสม O1 ของไลบรารี NVIDIA Apex เพื่อคำนวณคอนโวลูชันและ GEMM ด้วยเลขทศนิยมแบบลอยตัว 16 บิต อีกทั้งใช้การทำจุดตรวจสอบเกรเดียนต์ของ PyTorch ซึ่งแลกการคำนวณเพิ่มเติมกับการประหยัดหน่วยความจำ
โมเดลยังทิ้งค่าการกระตุ้นระหว่างทางที่เกิดในการส่งผ่านไปข้างหน้า แล้วคำนวณค่าเหล่านี้ใหม่ระหว่างการส่งผ่านย้อนกลับ
การเพิ่มความเร็วในการฝึก
การใช้ความละเอียดผสมเพื่อจัดการหน่วยความจำมีประโยชน์เพิ่มขึ้น เพราะตัวเร่งใช้ขนาดที่เล็กกว่าของ FP16 เพื่อเพิ่มปริมาณงานเมื่อเทียบกับ FP32 การบรรเทาคอขวดด้านแบนด์วิดท์หน่วยความจำช่วยให้ฝึกเร็วขึ้น
SEER ยังซิงโครไนซ์ชั้น BatchNorm ระหว่าง GPU โดยสร้างกลุ่มกระบวนการ แทนการซิงโครไนซ์ทั่วทั้งระบบซึ่งมักใช้เวลามากกว่า สุดท้าย ตัวโหลดข้อมูลของ SEER ดึงแบตช์ฝึกล่วงหน้ามากขึ้น ทำให้ส่งผ่านข้อมูลได้มากกว่าตัวโหลดข้อมูลของ PyTorch
ข้อมูลฝึกล่วงหน้าระดับใหญ่
SEER ใช้ภาพกว่าหนึ่งพันล้านภาพในการฝึกล่วงหน้า โดยตัวโหลดข้อมูลสุ่มภาพโดยตรงจากอินเทอร์เน็ตและ Instagram เนื่องจากฝึกกับภาพจากสภาพจริงแบบออนไลน์ จึงไม่ประมวลผลภาพล่วงหน้าหรือคัดสรรด้วยวิธีอย่างการลบภาพซ้ำหรือกรองแฮชแท็ก
ชุดข้อมูลไม่ได้คงที่ แต่เปลี่ยนภาพใหม่ทุกสามเดือน อย่างไรก็ตาม การเปลี่ยนชุดข้อมูลไม่กระทบประสิทธิภาพของโมเดล
การนำโมเดล SEER ไปใช้
SEER ฝึก RegNetY 256GF ล่วงหน้าด้วย SwAV โดยใช้ภาพครอปหกส่วนต่อภาพในรูปแบบความละเอียด 2×224 + 4×96 ระหว่างฝึกล่วงหน้าใช้ MLP หรือเพอร์เซปตรอนหลายชั้นจำนวนสามชั้น พร้อมหัวฉายขนาด 10444×8192, 8192×8192 และ 8192×256
แทนที่จะใช้ชั้น BatchNorm ในส่วนหัว SEER ใช้ต้นแบบ 16,000 ตัว โดยตั้งพารามิเตอร์อุณหภูมิ t เป็น 0.1 และตั้งพารามิเตอร์การทำให้เป็นระเบียบของ Sinkhorn เป็น 0.05 พร้อมทำอัลกอริทึม 10 รอบ โมเดลยังซิงโครไนซ์สถิติ BatchNorm ระหว่าง GPU และสร้างกลุ่มกระบวนการขนาด 64 หลายกลุ่มเพื่อซิงโครไนซ์
นอกจากนี้ยังใช้ตัวปรับให้เหมาะสม LARS หรือการปรับอัตราแบบปรับตัวรายชั้น ค่าการลดน้ำหนัก 10-5 จุดตรวจสอบค่าการกระตุ้น และการปรับให้เหมาะสมแบบความละเอียดผสม O1 จากนั้นฝึกด้วยการลดระดับเกรเดียนต์แบบสุ่ม โดยใช้แบตช์ภาพสุ่ม 8,192 ภาพที่กระจายบน NVIDIA GPU จำนวน 512 ตัว หรือ 16 ภาพต่อ GPU
อัตราการเรียนรู้เพิ่มเชิงเส้นจาก 0.15 เป็น 9.6 ในการอัปเดต 8,000 ครั้งแรก หลังช่วงอุ่นเครื่อง โมเดลใช้ตารางโคไซน์ที่ลดลงจนถึง 0.0096 โดยรวม SEER ฝึกบนภาพกว่าหนึ่งพันล้านภาพตลอด 122,000 รอบ
กรอบ SEER: ผลลัพธ์
คุณภาพของลักษณะเฉพาะที่ได้จากการฝึกล่วงหน้าแบบกำกับตนเองถูกศึกษาและวิเคราะห์ด้วยเกณฑ์เปรียบเทียบและงานปลายทางหลายประเภท โมเดลยังพิจารณาสถานการณ์ที่มีตัวอย่างน้อย ซึ่งเข้าถึงภาพและป้ายกำกับสำหรับงานปลายทางได้จำกัด
การปรับจูนโมเดลขนาดใหญ่ที่ฝึกไว้ล่วงหน้า
คุณภาพของโมเดลที่ฝึกล่วงหน้าด้วยข้อมูลสุ่มวัดโดยถ่ายโอนไปยังเกณฑ์เปรียบเทียบ ImageNet สำหรับการจำแนกวัตถุ ผลการปรับจูนโมเดลขนาดใหญ่พิจารณาภายใต้พารามิเตอร์ต่อไปนี้
การตั้งค่าการทดลอง
โมเดลฝึกสถาปัตยกรรม RegNet ที่มีความจุต่างกันหกแบบล่วงหน้า ได้แก่ RegNetY-{8,16,32,64,128,256}GF โดยใช้ SwAV บนภาพ Instagram สาธารณะแบบสุ่มกว่าหนึ่งพันล้านภาพ จากนั้นปรับจูนเพื่อจำแนกภาพบน ImageNet ซึ่งมีภาพฝึกมาตรฐานพร้อมป้ายกำกับที่เหมาะสมกว่า 1.28 ล้านภาพ และชุดตรวจสอบมาตรฐานกว่า 50,000 ภาพสำหรับประเมินผล
โมเดลใช้เทคนิคเพิ่มข้อมูลแบบเดียวกับ SwAV และปรับจูน 35 รอบข้อมูลด้วยตัวปรับให้เหมาะสม SGD หรือการลดระดับเกรเดียนต์แบบสุ่ม โดยใช้แบตช์ 256 ภาพ อัตราการเรียนรู้ 0.0125 ซึ่งลดลงสิบเท่าหลังผ่าน 30 รอบข้อมูล โมเมนตัม 0.9 และค่าการลดน้ำหนัก 10-4 โมเดลรายงานความแม่นยำอันดับหนึ่งบนชุดตรวจสอบ โดยครอปส่วนกลางขนาด 224×224
เปรียบเทียบกับแนวทางฝึกล่วงหน้าแบบกำกับตนเองอื่น ๆ
ตารางต่อไปเปรียบเทียบ RegNetY-256GF ซึ่งเป็นโมเดลที่ฝึกล่วงหน้าขนาดใหญ่ที่สุด กับโมเดลที่ฝึกไว้ล่วงหน้าอื่น ๆ ซึ่งใช้การเรียนรู้แบบกำกับตนเอง

SEER ให้ความแม่นยำอันดับหนึ่งบน ImageNet ที่ 84.2% และเหนือกว่า SimCLRv2 ซึ่งเป็นโมเดลที่ฝึกไว้ล่วงหน้าที่ดีที่สุดในขณะนั้นอยู่ 1%
รูปต่อไปยังเปรียบเทียบกรอบ SEER กับโมเดลความจุต่าง ๆ จะเห็นว่าการรวม RegNet กับ SwAV ให้ผลแม่นยำในการฝึกล่วงหน้า ไม่ว่าความจุโมเดลจะเป็นเท่าใด

SEER ฝึกล่วงหน้าบนภาพสุ่มที่ไม่ได้คัดสรร โดยใช้สถาปัตยกรรม RegNet กับวิธีเรียนรู้แบบกำกับตนเอง SwAV และเปรียบเทียบกับ SimCLRv2 และ ViT ที่มีสถาปัตยกรรมเครือข่ายต่างกัน จากนั้นปรับจูนบน ImageNet และรายงานความแม่นยำอันดับหนึ่ง
ผลของความจุโมเดล
ความจุโมเดลมีผลสำคัญต่อประสิทธิภาพการฝึกล่วงหน้า รูปด้านล่างเปรียบเทียบผลนี้กับกรณีฝึกจากศูนย์

เห็นได้ชัดว่าความแม่นยำอันดับหนึ่งของโมเดลที่ฝึกไว้ล่วงหน้าสูงกว่าโมเดลที่ฝึกจากศูนย์ และส่วนต่างเพิ่มขึ้นตามจำนวนพารามิเตอร์ แม้ความจุที่เพิ่มขึ้นช่วยโมเดลทั้งสองแบบ แต่เมื่อพารามิเตอร์มีจำนวนมาก ผลดีต่อโมเดลที่ฝึกไว้ล่วงหน้าจะสูงกว่า
สาเหตุหนึ่งที่โมเดลซึ่งฝึกจากศูนย์บน ImageNet อาจเกิดการเรียนรู้เกินพอดี คือชุดข้อมูลมีขนาดเล็ก
การเรียนรู้ด้วยตัวอย่างน้อย
การเรียนรู้ด้วยตัวอย่างน้อยหมายถึงการประเมิน SEER ในสถานการณ์ที่ใช้ข้อมูลเพียงบางส่วนของทั้งหมดสำหรับงานปลายทาง
การตั้งค่าการทดลอง
กรอบ SEER ใช้ชุดข้อมูลสองชุดสำหรับการเรียนรู้ด้วยตัวอย่างน้อย ได้แก่ Places205 และ ImageNet อีกทั้งสมมติว่าระหว่างการเรียนรู้แบบถ่ายโอนสามารถเข้าถึงทั้งภาพและป้ายกำกับได้จำกัด ต่างจากการตั้งค่าปกติของการเรียนรู้แบบกำกับตนเองที่เข้าถึงทั้งชุดข้อมูลได้ แต่จำกัดเฉพาะการเข้าถึงป้ายกำกับภาพ
-
ผลลัพธ์บนชุดข้อมูล Place205
รูปด้านล่างแสดงผลของการฝึกโมเดลล่วงหน้าบนสัดส่วนต่าง ๆ ของชุดข้อมูล Place205

แนวทางนี้ถูกเปรียบเทียบกับการฝึกล่วงหน้าแบบมีผู้สอนบน ImageNet ด้วยสถาปัตยกรรม RegNetY-128GF เดียวกัน ผลลัพธ์น่าสนใจ เพราะความแม่นยำอันดับหนึ่งเพิ่มขึ้นอย่างสม่ำเสมอประมาณ 2.5% ไม่ว่าสัดส่วนข้อมูลที่มีสำหรับปรับจูนบน Places205 จะเป็นเท่าใด
ความแตกต่างระหว่างการฝึกล่วงหน้าแบบมีผู้สอนกับแบบกำกับตนเองอธิบายได้จากธรรมชาติของข้อมูลฝึกที่ต่างกัน ลักษณะเฉพาะที่เรียนรู้จากภาพสุ่มในสภาพจริงอาจเหมาะกับการจำแนกฉากมากกว่า อีกทั้งการกระจายแนวคิดพื้นฐานที่ไม่สม่ำเสมออาจเป็นข้อได้เปรียบในการฝึกล่วงหน้าบนชุดข้อมูลไม่สมดุลอย่าง Places205
ผลลัพธ์บน ImageNet

ตารางด้านบนเปรียบเทียบแนวทางของ SEER กับการฝึกล่วงหน้าแบบกำกับตนเองและแนวทางกึ่งมีผู้สอนสำหรับการเรียนรู้ด้วยตัวอย่างน้อย วิธีเหล่านี้ทั้งหมดใช้ภาพ 1.2 ล้านภาพใน ImageNet เพื่อฝึกล่วงหน้า และจำกัดเฉพาะการเข้าถึงป้ายกำกับ ส่วน SEER ได้เห็นภาพในชุดข้อมูลเพียง 1–10%
การที่เครือข่ายได้เห็นภาพจากการกระจายเดียวกันมากกว่าในช่วงฝึกล่วงหน้า ช่วยแนวทางเหล่านั้นอย่างมาก แต่สิ่งที่น่าประทับใจคือ แม้ SEER เห็น ImageNet เพียง 1–10% ก็ยังทำความแม่นยำอันดับหนึ่งได้ประมาณ 80% ซึ่งต่ำกว่าวิธีในตารางด้านบนเพียงเล็กน้อย
ผลของความจุโมเดล
รูปด้านล่างกล่าวถึงผลของความจุโมเดลต่อการเรียนรู้ด้วยตัวอย่างน้อย เมื่อใช้ ImageNet ในสัดส่วน 1%, 10% และ 100%

เมื่อการเข้าถึงทั้งภาพและป้ายกำกับลดลง การเพิ่มความจุโมเดลสามารถเพิ่มความแม่นยำได้
การถ่ายโอนไปยังเกณฑ์เปรียบเทียบอื่น
เพื่อประเมิน SEER เพิ่มเติมและวิเคราะห์ประสิทธิภาพ ลักษณะเฉพาะที่ฝึกไว้ล่วงหน้าจะถูกถ่ายโอนไปยังงานปลายทางอื่น
การประเมินการจำแนกภาพแบบเชิงเส้น

ตารางด้านบนเปรียบเทียบลักษณะเฉพาะจาก RegNetY-256GF ที่ SEER ฝึกไว้ล่วงหน้า กับ RegNetY128-GF สถาปัตยกรรมเดียวกันที่ฝึกล่วงหน้าบน ImageNet ทั้งแบบมีผู้สอนและไม่มีผู้สอน เพื่อวิเคราะห์คุณภาพ จะตรึงน้ำหนักโมเดลและใช้ตัวจำแนกเชิงเส้นบนลักษณะเฉพาะ โดยอาศัยชุดฝึกของงานปลายทาง เกณฑ์เปรียบเทียบที่ใช้ ได้แก่ Open-Images (OpIm), iNaturalist (iNat), Places205 (Places) และ Pascal VOC (VOC)
การตรวจจับและการแบ่งส่วน
รูปด้านล่างเปรียบเทียบและประเมินลักษณะเฉพาะที่ฝึกไว้ล่วงหน้าในงานตรวจจับและแบ่งส่วน

กรอบ SEER ฝึก Mask-RCNN บนเกณฑ์เปรียบเทียบ COCO โดยใช้ RegNetY-64GF และ RegNetY-128GF ที่ฝึกไว้ล่วงหน้าเป็นองค์ประกอบพื้นฐาน สำหรับทั้งสองสถาปัตยกรรมและงานปลายทาง แนวทางฝึกล่วงหน้าแบบกำกับตนเองของ SEER เหนือกว่าการฝึกแบบมีผู้สอนอยู่ 1.5–2 คะแนน AP
เปรียบเทียบกับการฝึกล่วงหน้าแบบกำกับอย่างอ่อน
ภาพส่วนใหญ่บนอินเทอร์เน็ตมักมีเมทาดิสคริปชัน ข้อความทางเลือก คำอธิบาย หรือพิกัดภูมิศาสตร์ที่ใช้ประโยชน์ระหว่างฝึกล่วงหน้าได้ งานก่อนหน้าชี้ว่าการทำนายชุดแฮชแท็กที่คัดสรรหรือติดป้ายกำกับช่วยเพิ่มคุณภาพการทำนายลักษณะเฉพาะทางภาพ แต่แนวทางนี้ต้องกรองภาพและทำงานได้ดีที่สุดเมื่อมีเมทาดาทาที่เป็นข้อความ
รูปด้านล่างเปรียบเทียบการฝึกล่วงหน้าของสถาปัตยกรรม ResNetXt101-32dx8d บนภาพสุ่ม กับสถาปัตยกรรมเดียวกันที่ฝึกบนภาพติดป้ายกำกับพร้อมแฮชแท็กและเมทาดาทา โดยรายงานความแม่นยำอันดับหนึ่งของทั้งคู่

แม้ SEER ไม่ใช้เมทาดาทาระหว่างฝึกล่วงหน้า แต่มีความแม่นยำเทียบเคียงกับโมเดลที่ใช้เมทาดาทาได้
การศึกษาด้วยการตัดองค์ประกอบออก
การศึกษาประเภทนี้วิเคราะห์ผลขององค์ประกอบหนึ่งต่อประสิทธิภาพโดยรวม โดยนำองค์ประกอบนั้นออกจากโมเดลทั้งหมด แล้วดูว่าโมเดลทำงานอย่างไร ช่วยให้นักพัฒนาเห็นภาพรวมของผลที่องค์ประกอบดังกล่าวมีต่อประสิทธิภาพ
ผลของสถาปัตยกรรมโมเดล
สถาปัตยกรรมมีผลสำคัญต่อประสิทธิภาพ โดยเฉพาะเมื่อขยายขนาดโมเดลหรือเปลี่ยนคุณสมบัติของข้อมูลฝึกล่วงหน้า
รูปต่อไปกล่าวถึงผลของการเปลี่ยนสถาปัตยกรรมต่อคุณภาพลักษณะเฉพาะที่ฝึกไว้ล่วงหน้า โดยประเมินเชิงเส้นบน ImageNet ในกรณีนี้ตรวจสอบลักษณะเฉพาะได้โดยตรง เพราะการประเมินไม่เอื้อให้โมเดลที่แม่นยำสูงเมื่อฝึกจากศูนย์บน ImageNet

สำหรับ ResNeXts และ ResNet ลักษณะเฉพาะจากชั้นรองสุดท้ายทำงานได้ดีกว่าภายใต้การตั้งค่าปัจจุบัน ส่วนสถาปัตยกรรม RegNet มีประสิทธิภาพเหนือกว่าสถาปัตยกรรมอื่น
โดยรวม การเพิ่มความจุโมเดลส่งผลดีต่อคุณภาพลักษณะเฉพาะ และทำให้ประสิทธิภาพเพิ่มขึ้นในลักษณะลอการิทึม
การขยายข้อมูลฝึกล่วงหน้า
มีเหตุผลหลักสองข้อที่การฝึกบนชุดข้อมูลใหญ่ขึ้นช่วยเพิ่มคุณภาพโดยรวมของลักษณะเฉพาะทางภาพที่โมเดลเรียนรู้ ได้แก่ ภาพที่ไม่ซ้ำกันมากขึ้นและพารามิเตอร์มากขึ้น ต่อไปจะดูผลของทั้งสองปัจจัยโดยย่อ
การเพิ่มจำนวนภาพที่ไม่ซ้ำกัน

รูปด้านบนเปรียบเทียบ RegNet8 และ RegNet16 ซึ่งมีจำนวนพารามิเตอร์เท่ากันแต่ฝึกด้วยจำนวนภาพที่ไม่ซ้ำกันต่างกัน กรอบ SEER ฝึกโมเดลด้วยจำนวนการอัปเดตที่เทียบเท่าหนึ่งรอบข้อมูลสำหรับหนึ่งพันล้านภาพ หรือ 32 รอบข้อมูลสำหรับภาพที่ไม่ซ้ำกัน 32 ภาพ พร้อมตารางอัตราการเรียนรู้โคไซน์ครึ่งคลื่นเดียว
เพื่อให้โมเดลทำงานได้ดี จำนวนภาพที่ไม่ซ้ำกันที่ป้อนให้โมเดลควรสูง ในกรณีนี้โมเดลทำงานได้ดีเมื่อได้รับภาพที่ไม่ซ้ำกันมากกว่าจำนวนภาพใน ImageNet
พารามิเตอร์มากขึ้น
รูปด้านล่างแสดงประสิทธิภาพของโมเดลที่ฝึกบนภาพกว่าหนึ่งพันล้านภาพด้วยสถาปัตยกรรม RegNet-128GF จะเห็นว่าประสิทธิภาพเพิ่มขึ้นอย่างต่อเนื่องเมื่อจำนวนพารามิเตอร์เพิ่มขึ้น

คอมพิวเตอร์วิทัศน์แบบกำกับตนเองในโลกจริง
จนถึงตอนนี้เราอธิบายการทำงานของการเรียนรู้แบบกำกับตนเองและ SEER ในคอมพิวเตอร์วิทัศน์ในเชิงทฤษฎี ต่อไปจะดูการทำงานในสถานการณ์จริง และเหตุใด SEER จึงเป็นอนาคตของคอมพิวเตอร์วิทัศน์แบบกำกับตนเอง
SEER เทียบเคียงกับงานในวงการประมวลผลภาษาธรรมชาติ ซึ่งโมเดลระดับแนวหน้าใช้ชุดข้อมูลและพารามิเตอร์จำนวนหลายล้านล้าน ร่วมกับข้อความหลายล้านล้านคำในการฝึกล่วงหน้า ประสิทธิภาพของงานปลายทางมักเพิ่มขึ้นเมื่อข้อมูลนำเข้าสำหรับฝึกเพิ่มขึ้น และงานคอมพิวเตอร์วิทัศน์ก็เช่นเดียวกัน
แต่การใช้การเรียนรู้แบบกำกับตนเองในภาษาธรรมชาติต่างจากคอมพิวเตอร์วิทัศน์ เพราะในข้อความ แนวคิดเชิงความหมายมักแยกเป็นคำแต่ละคำได้ ขณะที่ในภาพ โมเดลต้องตัดสินว่าพิกเซลใดเป็นของแนวคิดใด
ภาพต่างกันยังมีมุมมองต่างกัน แม้หลายภาพจะมีวัตถุเดียวกัน แนวคิดก็อาจต่างกันมาก เช่น ชุดข้อมูลภาพแมว แม้แมวเป็นวัตถุหลักเหมือนกันทุกภาพ แต่ในภาพหนึ่งอาจยืนนิ่ง ส่วนอีกภาพอาจเล่นลูกบอล เนื่องจากภาพมักมีแนวคิดหลากหลาย โมเดลจึงต้องเห็นภาพจำนวนมากเพื่อเข้าใจความแตกต่างรอบแนวคิดเดียวกัน
การขยายโมเดลให้ทำงานกับข้อมูลภาพมิติสูงและซับซ้อนได้อย่างมีประสิทธิภาพต้องมีองค์ประกอบสองอย่าง
- เครือข่ายประสาทเทียมแบบคอนโวลูชันหรือ CNN ที่ใหญ่พอจะจับและเรียนรู้แนวคิดทางภาพจากชุดข้อมูลภาพขนาดใหญ่มาก
- อัลกอริทึมที่เรียนรู้รูปแบบจากภาพจำนวนมากได้โดยไม่มีป้ายกำกับ คำอธิบายประกอบ หรือเมทาดาทา
SEER มุ่งนำองค์ประกอบเหล่านี้ไปใช้ในคอมพิวเตอร์วิทัศน์ โดยอาศัยความก้าวหน้าของ SwAV ซึ่งใช้การจัดกลุ่มออนไลน์เพื่อจัดกลุ่มหรือจับคู่ภาพที่มีแนวคิดทางภาพคล้ายกัน และใช้ความคล้ายเหล่านี้ระบุรูปแบบได้ดีขึ้น
ด้วยสถาปัตยกรรม SwAV โมเดล SEER ทำให้การเรียนรู้แบบกำกับตนเองในคอมพิวเตอร์วิทัศน์มีประสิทธิภาพขึ้นมาก และลดเวลาฝึกได้ถึงหกเท่า
การฝึกระดับใหญ่บนภาพกว่าหนึ่งพันล้านภาพต้องใช้สถาปัตยกรรมที่มีประสิทธิภาพทั้งด้านเวลาทำงาน หน่วยความจำ และความแม่นยำ นี่คือบทบาทของ RegNet ซึ่งเป็นโมเดลคอนโวลูชันที่ขยายได้ถึงพารามิเตอร์หลายล้านล้านตัว และปรับให้เหมาะกับข้อจำกัดหน่วยความจำและเวลาทำงานได้
บทสรุป: อนาคตแบบกำกับตนเอง
การเรียนรู้แบบกำกับตนเองเป็นประเด็นสำคัญในวงการ AI และ ML มาระยะหนึ่ง เพราะช่วยให้โมเดลเรียนรู้ข้อมูลโดยตรงจากข้อมูลจำนวนมากที่มีอยู่แบบสุ่มบนอินเทอร์เน็ต แทนที่จะพึ่งชุดข้อมูลที่คัดสรรและติดป้ายกำกับอย่างรอบคอบเพื่อฝึก AI โดยเฉพาะ
แนวคิดนี้สำคัญต่ออนาคตของ AI และ ML เพราะอาจช่วยให้นักพัฒนาสร้างโมเดลที่ปรับตัวเข้ากับสถานการณ์จริงได้ดีและใช้งานได้หลายรูปแบบ แทนที่จะมีจุดประสงค์เฉพาะอย่างเดียว SEER เป็นหมุดหมายในการนำการเรียนรู้แบบกำกับตนเองมาใช้ในคอมพิวเตอร์วิทัศน์
SEER เป็นก้าวแรกในการเปลี่ยนแปลงวงการคอมพิวเตอร์วิทัศน์และลดการพึ่งชุดข้อมูลติดป้ายกำกับ โดยมุ่งขจัดความจำเป็นในการใส่คำอธิบายประกอบ เพื่อให้นักพัฒนาทำงานกับข้อมูลที่หลากหลายและมีจำนวนมากได้ การใช้ SEER มีประโยชน์อย่างยิ่งสำหรับโมเดลในสาขาที่มีภาพหรือเมทาดาทาจำกัด เช่น การแพทย์
การขจัดความจำเป็นในการใส่คำอธิบายประกอบโดยมนุษย์ยังช่วยให้พัฒนาและนำโมเดลไปใช้ได้เร็วขึ้น ทำให้ตอบสนองต่อสถานการณ์ที่เปลี่ยนแปลงรวดเร็วได้ไวและแม่นยำยิ่งขึ้น



