
โมเดลและแพลตฟอร์ม AI
LoRA, QLoRA และ QA-LoRA: ปรับโมเดลภาษาขนาดใหญ่อย่างมีประสิทธิภาพด้วยการแยกตัวประกอบเมทริกซ์อันดับต่ำ

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google

ประเด็นสำคัญLoRA…
ดูเพิ่มเติม
- LoRA ลดจำนวนพารามิเตอร์ที่ต้องฝึกด้วยการตรึงน้ำหนักของโมเดลฐานและเพิ่มเมทริกซ์ปรับตัวขนาดเล็ก
- QLoRA ผสานการควอนไทซ์ 4-บิต กับ LoRA เพื่อลดความต้องการหน่วยความจำ GPU อย่างมาก
- วิธีการเหล่านี้ทำให้การปรับแต่งโมเดลที่มีพารามิเตอร์พันล้านเป็นไปได้บนฮาร์ดแวร์มาตรฐาน
โมเดลภาษาขนาดใหญ่ (LLM) ได้สร้างความโดดเด่นด้วยความสามารถที่ไม่มีใครเทียบได้ในการทำความเข้าใจและสร้างข้อความที่เหมือนมนุษย์ ความสามารถของ LLM สามารถย้อนกลับไปสู่ขนาดที่ใหญ่ของมัน ซึ่งมีพารามิเตอร์หลายพันล้าน ในขณะที่ขนาดที่ใหญ่นี้เป็นพลังหลักที่ขับเคลื่อนประสิทธิภาพของมัน แต่ก็สร้างความท้าทาย โดยเฉพาะอย่างยิ่งเมื่อพูดถึงการปรับให้เหมาะสมของโมเดลสำหรับงานหรือโดเมนเฉพาะ วิธีการจัดการ LLM ในแบบดั้งเดิม เช่น การปรับให้เหมาะสมพารามิเตอร์ทั้งหมด นำไปสู่ภาระทางคำนวณและค่าใช้จ่ายทางการเงินที่หนักหน่วง ซึ่งเป็นอุปสรรคสำคัญต่อการนำไปใช้ในสถานการณ์จริง
ในบทความก่อนหน้านี้ เราได้พูดถึงการปรับให้เหมาะสมของ LLM เพื่อตอบสนองความต้องการเฉพาะ เราได้สำรวจวิธีการปรับให้เหมาะสมต่างๆ เช่น การปรับให้เหมาะสมตามคำแนะนำ การปรับให้เหมาะสมสำหรับงานเดียว และการปรับให้เหมาะสมที่มีประสิทธิภาพ (PEFT) แต่ละวิธีมีการเข้าถึงที่เป็นเอกลักษณ์ในการปรับให้เหมาะสมของ LLM สำหรับงานที่แตกต่างกัน สิ่งสำคัญที่สุดคือโครงสร้างของทรานส์ฟอร์เมอร์ ซึ่งเป็นกระดูกสันหลังของ LLM และความท้าทายที่เกิดจากความต้องการทางคำนวณและหน่วยความจำในการจัดการพารามิเตอร์จำนวนมากในช่วงการปรับให้เหมาะสม

https://huggingface.co/blog/hf-bitsandbytes-integration
รูปด้านบนแสดงถึงขนาดของโมเดลภาษาขนาดใหญ่หลายรุ่น โดยเรียงลำดับตามจำนวนพารามิเตอร์ สิ่งสำคัญคือ PaLM, BLOOM ฯลฯ
ในปีนี้ มีการพัฒนาโมเดลที่ใหญ่ขึ้น แต่การปรับให้เหมาะสมของโมเดลเหล่านี้ในระบบมาตรฐานนั้นเป็นไปไม่ได้โดยไม่มีการปรับให้เหมาะสมแบบเฉพาะเจาะจง
นี่คือจุดที่ Low-Rank Adaptation (LoRA) เข้ามา โดย Microsoft (MSFT ) ได้แนะนำใน บทความ นี้ เพื่อลดความท้าทายเหล่านี้และทำให้ LLM มีความสามารถและปรับให้เหมาะสมได้มากขึ้น
LoRA มีจุดมุ่งหมายในการปรับให้เหมาะสมของโมเดลโดยไม่ต้องเข้าไปสู่รายละเอียดของการฝึกอบรมโมเดลทั้งหมด ไม่เหมือนกับการปรับให้เหมาะสมแบบดั้งเดิมที่ทุกพารามิเตอร์ต้องเปลี่ยนแปลง LoRA ใช้วิธีการที่ชาญฉลาดโดยการแช่แข็งน้ำหนักของโมเดลที่ฝึกไว้แล้วและแนะนำเมทริกซ์การแยกตัวประกอบที่สามารถฝึกได้เข้าไปในแต่ละชั้นของโครงสร้างทรานส์ฟอร์เมอร์ วิธีการนี้ช่วยลดจำนวนพารามิเตอร์ที่สามารถฝึกได้ลงอย่างมาก ทำให้กระบวนการปรับให้เหมาะสมมีประสิทธิภาพมากขึ้น
การพัฒนาวิธีการปรับให้เหมาะสมของ LLM
เมื่อมองย้อนกลับไปที่การเดินทางของการปรับให้เหมาะสมของ LLM เราสามารถระบุวิธีการต่างๆ ที่ผู้ปฏิบัติงานใช้ตลอดหลายปีที่ผ่านมา ในตอนแรก มีการเน้นไปที่การปรับให้เหมาะสมของโมเดลที่ฝึกไว้แล้ว ซึ่งหมายถึงการเปลี่ยนแปลงพารามิเตอร์ของโมเดลทั้งหมดเพื่อให้เหมาะสมกับงานที่ต้องการ อย่างไรก็ตาม เมื่อโมเดลมีขนาดใหญ่ขึ้นและซับซ้อนมากขึ้น ความต้องการทางคำนวณของวิธีการนี้ก็เพิ่มขึ้นตามไปด้วย
วิธีการต่อไปที่ได้รับความนิยมคือการปรับให้เหมาะสมของส่วนหนึ่งของโมเดล ซึ่งเป็นวิธีการที่มีการจำกัดมากขึ้นกว่าเดิม โดยที่เฉพาะพารามิเตอร์บางส่วนของโมเดลเท่านั้นที่จะถูกปรับให้เหมาะสม วิธีการนี้ช่วยลดภาระทางคำนวณลงบ้าง แต่ก็ยังไม่สามารถตามทันการเติบโตของขนาดโมเดลได้
เมื่อผู้ปฏิบัติงานพยายามหาวิธีการที่มีประสิทธิภาพมากขึ้น การปรับให้เหมาะสมแบบเต็มรูปแบบก็ได้รับการพัฒนาเป็นวิธีการที่เข้มงวดแต่มีผลตอบแทนที่ดี
การแนะนำ LoRA
อันดับของเมทริกซ์คือจำนวนแถวหรือคอลัมน์ที่เป็นอิสระเชิงเส้น หมายเหตุเกี่ยวกับต้นฉบับภาษาอังกฤษ: เพียงมีค่าไม่ซ้ำกันยังไม่เพียงพอ ต้องพิจารณาความเป็นอิสระเชิงเส้น
- เมทริกซ์เต็มอันดับ: อันดับของมันตรงกับจำนวนแถวหรือคอลัมน์ที่น้อยกว่า
- เมทริกซ์อันดับต่ำ: อันดับของมันเล็กกว่าจำนวนแถวและคอลัมน์ทั้งสองอย่าง
โมเดลขนาดใหญ่เข้าใจโดเมนของมันอย่างกว้างขวาง เช่น ภาษาในโมเดลภาษา แต่การปรับให้เหมาะสมของมันสำหรับงานเฉพาะมักต้องการเน้นย้ำส่วนเล็กๆ ของความเข้าใจเหล่านี้ นี่คือจุดที่ LoRA ส่องแสง LoRA แสดงว่าเมทริกซ์ที่แสดงถึงการปรับเปลี่ยนน้ำหนักสามารถเป็นเมทริกซ์อันดับต่ำได้ ซึ่งจับคุณลักษณะที่น้อยลง
LoRA จึงจำกัดอันดับของเมทริกซ์การปรับเปลี่ยนนี้โดยการแทนค่าปรับปรุงเป็นผลคูณของเมทริกซ์ขนาดเล็กสองตัว ดังนั้น แทนที่จะเปลี่ยนแปลงเมทริกซ์น้ำหนักทั้งหมด LoRA จะเปลี่ยนแปลงเฉพาะส่วนหนึ่งของมัน ทำให้การปรับให้เหมาะสมมีประสิทธิภาพมากขึ้น
การนำ LoRA ไปใช้กับทรานส์ฟอร์เมอร์
LoRA ช่วยลดภาระการฝึกอบรมในเครือข่ายประสาทเทียมโดยการเน้นไปที่เมทริกซ์น้ำหนักที่เฉพาะเจาะจง ในโครงสร้างทรานส์ฟอร์เมอร์ เมทริกซ์น้ำหนักบางตัวเชื่อมโยงกับกลไกการดึงความสนใจตนเอง เช่น Wq, Wk, Wv และ Wo นอกจากนี้ยังมีเมทริกซ์อีกสองตัวในโมดูล Multi-Layer Perceptron (MLP)

โครงสร้างทรานส์ฟอร์เมอร์

หัวการดึงความสนใจของทรานส์ฟอร์เมอร์
คำอธิบายทางคณิตศาสตร์ของ LoRA
มาดูหลักคณิตศาสตร์ของ LoRA กัน:
- เมทริกซ์น้ำหนักที่ฝึกมาแล้ว :
- เริ่มจากเมทริกซ์น้ำหนักที่ฝึกมาแล้ว ที่มีมิติ หมายความว่าเมทริกซ์มีจำนวนแถวเท่ากับ และจำนวนคอลัมน์เท่ากับ
- การแยกตัวประกอบอันดับต่ำ:
- แทนที่จะปรับปรุงเมทริกซ์ทั้งหมดโดยตรง ซึ่งอาจมีค่าใช้จ่ายในการคำนวณสูง วิธีนี้ใช้การแยกตัวประกอบอันดับต่ำ
- ค่าปรับปรุง สำหรับ สามารถแทนด้วยผลคูณของเมทริกซ์สองตัว: และ .
- มีมิติ
- มีมิติ
- ประเด็นสำคัญคืออันดับ มีค่าน้อยกว่าทั้ง และ มาก จึงแทนข้อมูลได้อย่างมีประสิทธิภาพด้านการคำนวณกว่า
- การฝึก:
- ในระหว่างฝึก จะไม่เปลี่ยนแปลง เรียกว่าการตรึงน้ำหนัก
- ในทางตรงกันข้าม และ เป็นพารามิเตอร์ที่ฝึกได้ หมายความว่าระหว่างฝึกจะปรับเมทริกซ์ และ เพื่อเพิ่มประสิทธิภาพของโมเดล
- การคูณและการบวก:
- ทั้ง และค่าปรับปรุง (ซึ่งเป็นผลคูณของ และ ) คูณด้วยอินพุตเดียวกัน ซึ่งแทนด้วย .
- จากนั้นนำผลคูณทั้งสองมาบวกกัน
- สรุปได้ด้วยสมการ: ในที่นี้ คือเอาต์พุตสุดท้ายหลังใช้ค่าปรับปรุงกับอินพุต .
วิธีนี้ปรับปรุงเมทริกซ์น้ำหนักขนาดใหญ่ได้มีประสิทธิภาพขึ้นด้วยการแทนค่าปรับปรุงผ่านการแยกตัวประกอบอันดับต่ำ จึงเป็นประโยชน์ทั้งด้านการคำนวณและการใช้หน่วยความจำ
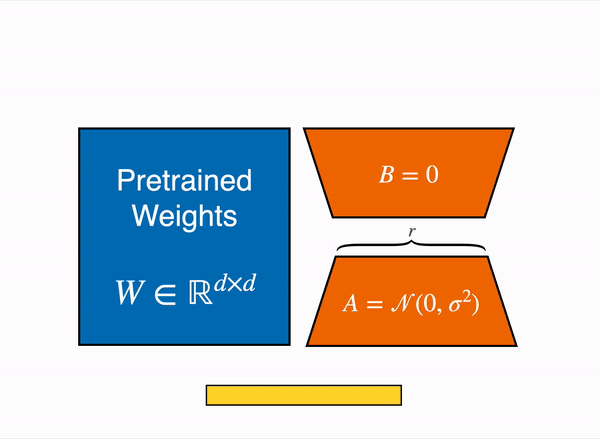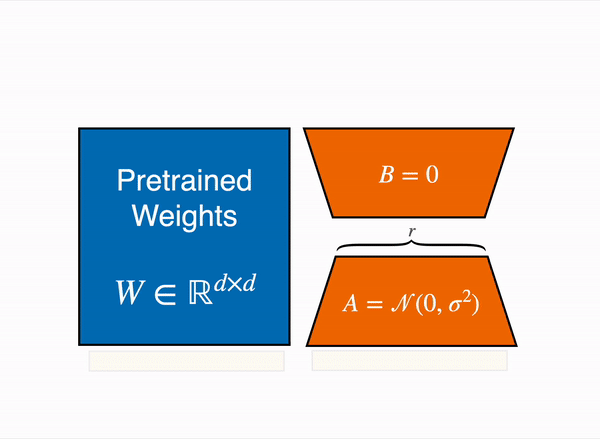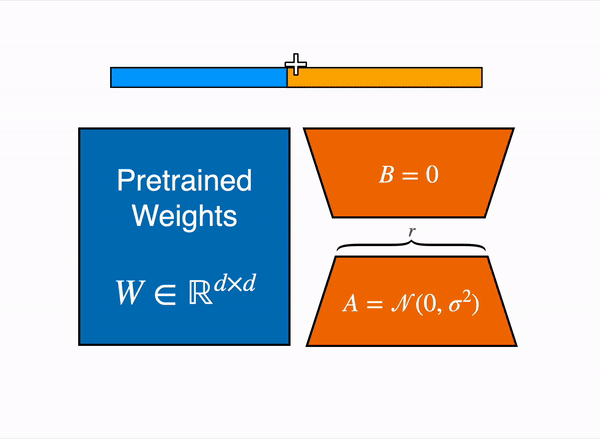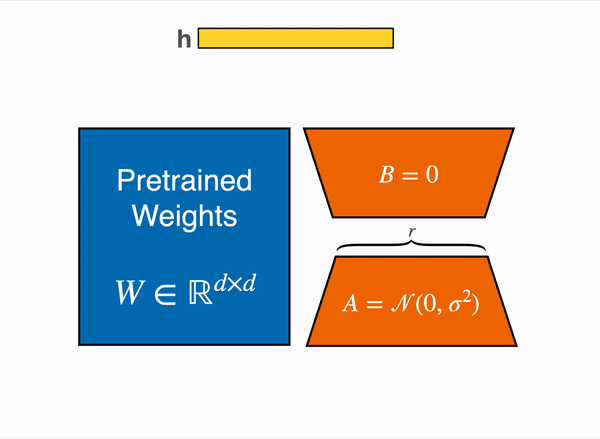
LORA
การกำหนดค่าเริ่มต้นและการปรับขนาด:
วิธีกำหนดค่าเริ่มต้นของพารามิเตอร์มีผลต่อประสิทธิภาพและผลลัพธ์ของการเรียนรู้ ในที่นี้พิจารณาการปรับปรุงเมทริกซ์น้ำหนักโดยใช้ และ :
- การกำหนดค่าเริ่มต้นของเมทริกซ์ และ :
- เมทริกซ์ : กำหนดค่าเริ่มต้นด้วยค่าที่สุ่มจากการแจกแจงเกาส์เซียนหรือการแจกแจงปกติ เพื่อทำลายความสมมาตร นิวรอนต่างตัวในชั้นเดียวกันจึงเรียนรู้คุณลักษณะที่แตกต่างกันได้เมื่อมีน้ำหนักเริ่มต้นต่างกัน
- เมทริกซ์ : กำหนดค่าเริ่มต้นเป็นศูนย์ ทำให้ค่าปรับปรุง เป็นศูนย์ตอนเริ่มฝึก พฤติกรรมของโมเดลจึงไม่เปลี่ยนกะทันหันและค่อยๆ ปรับตัวขณะที่ เรียนรู้ค่าที่เหมาะสมระหว่างฝึก
- การปรับขนาดเอาต์พุตจาก :
- หลังคำนวณค่าปรับปรุง จะปรับขนาดเอาต์พุตด้วยตัวคูณ โดยที่ เป็นค่าคงที่ การปรับขนาดช่วยควบคุมขนาดของค่าปรับปรุง
- การปรับขนาดสำคัญเป็นพิเศษเมื่ออันดับ เปลี่ยนแปลง เช่น เมื่อต้องการเพิ่มอันดับเพื่อความแม่นยำสูงขึ้นโดยยอมใช้การคำนวณมากขึ้น การปรับขนาดช่วยลดความจำเป็นที่จะต้องเปลี่ยนไฮเปอร์พารามิเตอร์อื่นจำนวนมากและช่วยรักษาเสถียรภาพของโมเดล
ผลกระทบเชิงปฏิบัติของ LoRA
ชุมชน AI ใช้ LoRA เพื่อปรับโมเดลภาพให้สร้างงานในสไตล์เฉพาะ เช่น สไตล์ของ Greg Rutkowski หมายเหตุเกี่ยวกับต้นฉบับ: ตัวอย่างที่ลิงก์ถึงเป็นอะแดปเตอร์ของโมเดลภาพ SDXL ไม่ใช่โมเดลภาษา
งานวิจัย LoRA ยก GPT-3 ขนาด 175 พันล้านพารามิเตอร์เป็นตัวอย่างว่า การเก็บโมเดลที่ปรับแต่งแยกกันแต่ละชุดขนาดนี้มีค่าใช้จ่ายสูง LoRA ลดจำนวนพารามิเตอร์ที่ต้องฝึกลงได้ 10,000 เท่า และลดความต้องการหน่วยความจำ GPU เหลือหนึ่งในสามในตัวอย่างดังกล่าว

ผลของ LoRA ต่อการปรับแต่ง GPT-3
แนวทางนี้ช่วยให้ LLM เข้าถึงได้ง่ายขึ้น เชื่อมความก้าวหน้าทางทฤษฎีกับงานจริง และลดข้อจำกัดในการคำนวณด้วยการปรับโมเดลที่มีประสิทธิภาพกว่า จึงมีศักยภาพสนับสนุนการนำ LLM ไปใช้อย่างกว้างขวาง
QLoRA หรือ LoRA แบบควอนไทซ์
แม้ LoRA ลดพื้นที่จัดเก็บ แต่ยังต้องใช้ GPU ที่มีหน่วยความจำมากพอเพื่อโหลดโมเดลระหว่างฝึก QLoRA จึงรวม LoRA กับการควอนไทซ์เพื่อลดภาระนี้

การควอนไทซ์
ตัวอย่างเช่น การเก็บค่าน้ำหนักใน FP32 ใช้32บิตต่อองค์ประกอบ แนวคิดคือแทนค่าด้วย8หรือ4บิตแทน การควอนไทซ์แมปค่าต่อเนื่องไปยังชุดค่าที่ไม่ต่อเนื่องและมีจำนวนจำกัด สำหรับ LLM คือการแปลงน้ำหนักจากชนิดข้อมูลความแม่นยำสูงเป็นชนิดความแม่นยำต่ำกว่า

การควอนไทซ์ใน LLM
QLoRA สรุปได้เป็นสองส่วน:
- การควอนไทซ์เริ่มต้น: เก็บน้ำหนักพื้นฐานแบบ4บิตเพื่อลดการใช้หน่วยความจำ
- การฝึก LoRA: ฝึกอะแดปเตอร์ด้วยความแม่นยำในการคำนวณที่สูงกว่า ต้นฉบับภาษาอังกฤษระบุ FP32 แต่เอกสาร QLoRA ต้นฉบับใช้ BF16 สำหรับการคำนวณและพารามิเตอร์อะแดปเตอร์โดยทั่วไป
หมายเหตุเกี่ยวกับต้นฉบับ: QLoRA แยกการเก็บน้ำหนักพื้นฐานที่ตรึงไว้แบบ4บิตออกจากการคำนวณซึ่งโดยทั่วไปใช้ BF16 เทนเซอร์ที่ต้องใช้จะถูกแปลงกลับเพื่อคำนวณ และคำนวณเกรเดียนต์ของน้ำหนักเฉพาะอะแดปเตอร์ LoRA ไม่ใช่การฝึกน้ำหนักพื้นฐานทั้งหมดใหม่ตามที่คำอธิบายเรื่องกลับไปใช้ FP32 ในบทความอาจทำให้เข้าใจ
LoRA ใช้งานได้ผ่านไลบรารี PEFT ของ Hugging Face ส่วน QLoRA ใช้ bitsandbytes ร่วมกับ PEFT และ TRL สนับสนุนการปรับแต่งแบบมีผู้สอนร่วมกับ LoRA ไลบรารีเหล่านี้เป็นเครื่องมือพื้นฐานสำหรับปรับโมเดลที่ฝึกมาแล้ว เช่น ให้สร้างคำอธิบายสินค้าที่น่าเชื่อถือและสอดคล้องกันตามคำสั่งที่ระบุคุณลักษณะ
ต้นฉบับกล่าวถึงความยุ่งยากในการแปลงและรวมอะแดปเตอร์หลัง QLoRA ซึ่งไม่ได้หมายความว่าการนำไปใช้ทุกแบบต้องเก็บน้ำหนักทั้งหมดด้วยความแม่นยำสูงเสมอไป วิธี QA-LoRA ใช้การดำเนินการเป็นกลุ่มกับน้ำหนักแต่ละส่วน เพื่อรวมการควอนไทซ์กับการปรับแบบอันดับต่ำ และรวมผลลัพธ์เป็นโมเดลควอนไทซ์โดยรักษาประสิทธิภาพของกระบวนการและคุณภาพของโมเดลสำหรับงานที่ต้องการ
สรุป
ในบทความนี้ เราได้พูดถึงความท้าทายที่เกิดจากขนาดพารามิเตอร์ที่ใหญ่ของ LLM เราได้สำรวจการปรับให้เหมาะสมแบบดั้งเดิมและความต้องการทางคำนวณและทางการเงินที่เกี่ยวข้อง LoRA เป็นวิธีการที่ช่วยให้สามารถปรับเปลี่ยนโมเดลที่ฝึกไว้แล้วโดยไม่ต้องฝึกอบรมทั้งหมด ทำให้กระบวนการปรับให้เหมาะสมมีประสิทธิภาพมากขึ้น
เรายังได้พูดถึง QLoRA ซึ่งเป็นการผสมผสานระหว่าง LoRA และการควอนไทซ์เพื่อลดความต้องการเก็บข้อมูลของโมเดลในขณะที่ยังคงรักษาความแม่นยำที่จำเป็นสำหรับการฝึกอบรม ด้วยเทคนิคเหล่านี้ ผู้ปฏิบัติงานสามารถนำ LLM ไปใช้ได้ง่ายขึ้นและปรับให้เหมาะสมสำหรับสถานการณ์จริงต่างๆ

เมทริกซ์
กลยุทธ์เหล่านี้ถูกออกแบบมาเพื่อสร้างสมดุลระหว่างการปรับให้เหมาะสมของ LLM สำหรับงานเฉพาะและรับประกันว่ากระบวนการปรับให้เหมาะสมและการใช้งานจะไม่หนักเกินไปในด้านการคำนวณและทรัพยากรเก็บข้อมูล


