มุมมองของ Anderson
การไม่มีข้อผิดพลาดแบบมนุษย์เผยตัวตน AI ที่สวมรอยเป็นคน

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google

ประเด็นสำคัญระบบ AI เผยให้เห็นตัวตนผ่านการทำงานด้านความจำที่สมบูรณ์แบบเกินธรรมชาติ…
ดูเพิ่มเติม
- ระบบ AI เผยให้เห็นตัวตนผ่านการทำงานด้านความจำที่สมบูรณ์แบบเกินธรรมชาติ เว้นแต่จะถูกฝึกมาให้ทำผิดโดยเฉพาะ
- การปรับแต่งโมเดลด้วยข้อมูลจิตวิทยามนุษย์ช่วยให้เลียนแบบมนุษย์ได้ดีขึ้น แต่ก็จำกัดความสามารถด้านการใช้งานทั่วไป
- วิทยาศาสตร์การรู้คิดเสนอวิธีการตรวจจับที่แข็งแกร่ง เพราะ AI ขาดข้อจำกัดโดยธรรมชาติของมนุษย์ เช่น ความเสื่อมของความจำและความเหนื่อยล้า
งานวิจัยใหม่พบว่า AI อาจสวมรอยเป็นมนุษย์ได้จนกว่าจะแสดงว่าจำได้ «ดีเกินไป» การทดสอบความจำง่ายๆ สามารถเปิดโปงแชตบอตได้ เพราะมันไม่ทำผิดพลาดแบบที่มนุษย์มักทำ
นักวิจัยจากพรินซ์ตันพัฒนาวิธีระบุ AI ที่สวมรอยเป็นมนุษย์ โดยให้ทำงานที่มนุษย์ไม่ถนัด โดยเฉพาะงานเกี่ยวกับการเก็บข้อมูลในความจำระยะสั้น
AI ที่ทดสอบด้วยวิธีนี้ไม่สามารถจำลองอัตราความผิดพลาดของมนุษย์ได้ดีพอ เว้นแต่ได้รับคำสั่งอย่างชัดเจนใน พรอมต์ระบบ หรือผ่านการปรับแต่งเพิ่มเติมด้วยข้อมูลทางจิตวิทยา
บทความวิจัยระบุว่า:
«เราสำรวจแนวคิดการตรวจสอบว่าเป็นมนุษย์หรือไม่ ด้วยงานที่เครื่องจักรทำได้ดีเกินกว่าจะเป็นมนุษย์ โดยเฉพาะการตรวจสอบข้อจำกัดทางการรู้คิดที่เป็นที่ยอมรับของมนุษย์ นั่นคือความจุที่จำกัดของความจำขณะทำงาน
«เราแสดงให้เห็นว่าการสร้างแบบจำลองทางการรู้คิดกับงานทดสอบการระลึกตามลำดับแบบมาตรฐาน สามารถแยกผู้เข้าร่วมออนไลน์ออกจาก LLM ได้ แม้จะสั่งให้ LLM เลียนแบบข้อจำกัดของความจำขณะทำงานของมนุษย์อย่างชัดเจน
«ผลลัพธ์แสดงว่าสามารถใช้ปรากฏการณ์ทางการรู้คิดที่เป็นที่ยอมรับ เพื่อแยก LLM ออกจากมนุษย์ได้»
แนวโน้มที่นักวิจัยพบชี้ว่า โมเดลภาษาสำเร็จรูปมีโอกาสสูงมากที่จะเผยตัวตนในการทดสอบทัวริงแบบย้อนกลับใดๆ ที่ใช้วิธีนี้
แม้โมเดล AI ที่สร้างเพื่อเป้าหมายเฉพาะจะทำได้ดีกว่า แต่การปรับแต่งสำหรับงานนี้น่าจะจำกัดโมเดลให้อยู่กับงานนั้น โดยแลกกับการใช้งานทั่วไป และแม้พรอมต์ระบบจะยาวได้เท่ากับนวนิยาย สงครามและสันติภาพ จึงใส่คำแนะนำให้เลียนแบบจุดอ่อนของมนุษย์ได้ ประสิทธิภาพก็ลดลงเมื่อนำไปแทรกในคำสั่งที่ยาวมาก ซึ่งเน้นลำดับความสำคัญอื่นๆ อีกมาก หรือในคำสั่งที่สั้นมาก ซึ่งจะเสียความสามารถทั่วไปเพื่อเน้นงานเฉพาะเช่นเดียวกับการปรับแต่งเพิ่มเติม
«คุณกำลังพูดถึงความจำ…»
ความต้องการวิธีระบุบทสนทนาที่ AI สร้างขึ้นอย่างมีประสิทธิภาพกำลังเพิ่มขึ้น โดยเฉพาะในหมู่นักวิจัยเอง ซึ่งมักต้องพึ่งคนทำงานทางไกลผ่านแพลตฟอร์มจัดหาผู้ร่วมงานจำนวนมาก คนเหล่านี้มีแรงจูงใจสูงที่จะหลอกระบบด้วยระบบอัตโนมัติและกลวิธีอื่นๆ
นอกจากนี้ เนื้อหาที่ AI สร้างขึ้นอย่างมีความรู้และนำเสนอได้น่าเชื่อถือ ก็น่าจะจำเป็นในกรณีการฉ้อโกงด้วย AI ซึ่งการสนทนาสดต้องการคำตอบที่รวดเร็วและมั่นใจ ผู้กระทำผิดย่อมไม่มีเวลาค้น Google เพื่อตอบคำถามที่เพิ่งได้รับ
เช่นเดียวกับที่วงการตรวจจับ AI อาจใช้ประโยชน์จากความรู้นี้ อุตสาหกรรมที่กำลังเติบโตด้านการโทรด้วยเสียง AI เพื่อส่งเสริมการขายก็น่าจะได้ประโยชน์จากการรู้ว่าควรหลีกเลี่ยงพฤติกรรมใด
แม้จะชวนให้คิดถึงความเป็นไปได้ของ «การแข่งขันสะสมอาวุธในการทดสอบทัวริงย้อนกลับ» ผู้เขียนระบุว่า หาก AI อเนกประสงค์เลียนแบบจุดอ่อนของมนุษย์ได้ดีขึ้น ก็ยังมีลักษณะการทำผิดพลาดของมนุษย์อีกมากให้ใช้ทดสอบ*:
«มีข้อจำกัดทางการรู้คิดของมนุษย์ที่เป็นที่ยอมรับอยู่หลายอย่าง ซึ่ง LLM อาจไม่ได้มีตามไปด้วย เช่น มนุษย์เหนื่อยล้า รับรู้ภาพลวงตา และเก็บข้อมูลได้เพียงไม่กี่รายการในความจำขณะทำงาน»

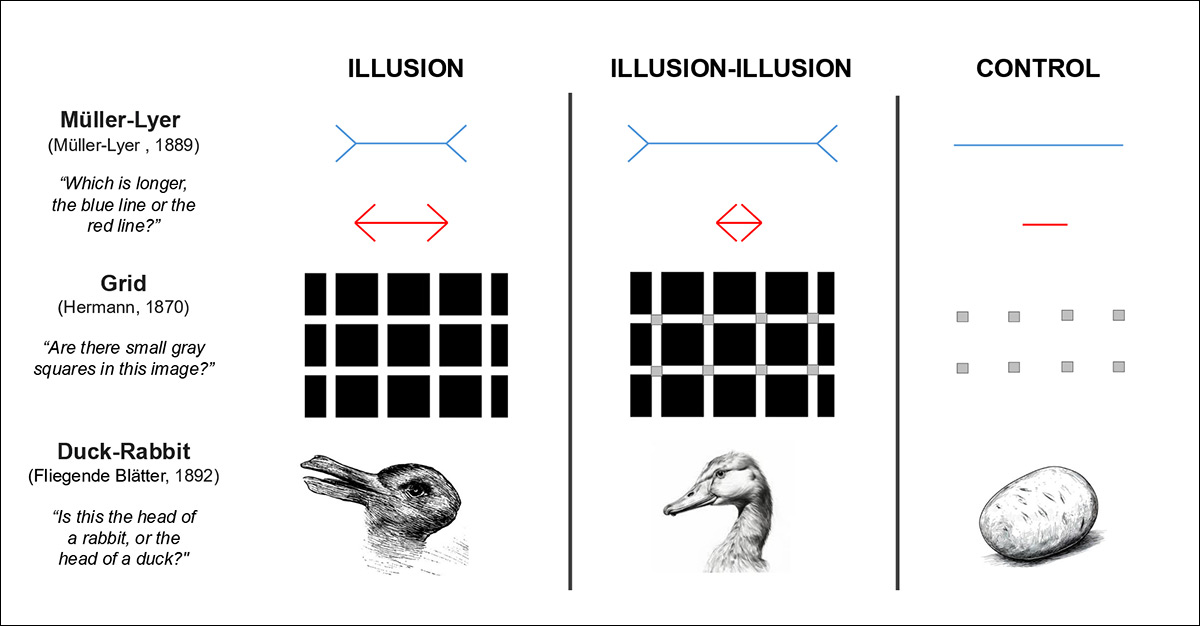
ตัวอย่างภาพลวงตา ตัวอย่างภาพลวงตาจากงานวิจัยปลายปี 2024 เรื่อง “The Illusion-Illusion: Vision Language Models See Illusions Where There are None” ซึ่งน่าจะหลอกโมเดลวิสัยทัศน์และภาษา (VLM) ใดๆ ที่ไม่รู้จักภาพเหล่านี้จากข้อมูลฝึกมาก่อน ขณะที่มนุษย์มีโอกาสตีความภาพได้ถูกต้องสูงกว่ามาก แหล่งที่มา งานวิจัยต้นทาง
ผู้เขียนระบุว่า หากโมเดลภาษาขนาดใหญ่ (LLM) ตอบงานนี้เหมือนมนุษย์ ก็จะชี้ว่าโมเดลมีข้อจำกัดทางการรู้คิดร่วมกับมนุษย์จริง หรือได้รับการฝึกให้เลียนแบบข้อจำกัดเหล่านั้น
แม้ข้อมูลฝึกอาจมีร่องรอยพฤติกรรมมนุษย์ บทความวิจัยเห็นว่านั่นไม่ได้ทำให้เกิดรูปแบบความผิดพลาดเฉพาะงานที่พบในความจำมนุษย์อย่างน่าเชื่อถือ จึงยังมีคำถามว่าแม้สั่งให้ทำตัวเป็นมนุษย์ เราจะยังแยก AI ได้จากวิธีที่มันทำผิดหรือไม่
งานวิจัยใหม่นี้มีชื่อว่า เป็นมนุษย์หรือไม่? ตรวจจับโมเดลภาษาขนาดใหญ่ด้วยการทดสอบข้อจำกัดของความจำมนุษย์ จัดทำโดยนักวิจัยสองคนจากภาควิชาวิทยาการคอมพิวเตอร์และจิตวิทยาของพรินซ์ตัน คนละภาควิชา
วิธีการและการทดสอบ
นักวิจัยใช้ผลงานตั้งแต่ทศวรรษ 1950 และ 1960 โดยเฉพาะบทความวิจัย ผลของลำดับต่อความจำระยะสั้นในปี 1968 ซึ่งให้ผู้เข้าร่วมระลึกถึงตัวอักษรที่แสดงตามลำดับ ด้วยคำถามเกี่ยวกับตำแหน่ง («ตัวอักษรตัวที่สามคืออะไร?») หรือคำถามเกี่ยวกับตัวถัดไป («ตัวอักษรใดอยู่ถัดจาก X?»):

แผนภาพวิธีวิจัย แผนผังวิธีวิจัย: ด้านซ้ายเป็นงานทดสอบความจำขณะทำงาน โดยแสดงตัวอักษรทีละตัว และสุ่มคำถามเกี่ยวกับตำแหน่งหรือตัวถัดไปในแต่ละรอบ ตรงกลางเปรียบเทียบผู้เข้าร่วมออนไลน์กับ LLM ที่ใช้พรอมต์ระบบและโมเดลพื้นฐานต่างกัน ด้านขวาเน้นความต่างระหว่างข้อจำกัดความจำขณะทำงานของมนุษย์กับโมเดลทรานส์ฟอร์เมอร์ ซึ่งเข้าถึงหน้าต่างบริบททั้งหมดได้โดยตรง และจึงต้องจำลองพฤติกรรมการระลึกตามลำดับ แหล่งที่มา
ตัวอักษรแต่ละตัวปรากฏเพียง 800 มิลลิวินาที โดยเว้นช่วงระหว่างการแสดงเพียง 300 มิลลิวินาที การทดลองใช้ไลบรารี Smileของห้องปฏิบัติการ Computation and Cognition Lab แห่งมหาวิทยาลัยนิวยอร์ก:

ภาพหน้าจอ Smile ตัวอย่างหน้าจอทดสอบของไลบรารี Smile จาก NYU แหล่งที่มา คู่มือ Smile
ผู้เขียนระบุว่า การนำเอเจนต์ LLM เข้าร่วมการทดลองออนไลน์ทำได้ง่ายขึ้นเมื่อเครื่องมืออัตโนมัติของเบราว์เซอร์พัฒนา และระบบอย่าง Gemini in Chromeสามารถนำทางและทำงานได้อย่างอิสระมากขึ้น
แต่เครื่องมือเหล่านี้ใช้ภาพนิ่งของหน้าเว็บ จึงไม่เก็บสิ่งเร้าที่แสดงอย่างรวดเร็ว และอาจทำให้เกิดข้อผิดพลาดจากข้อจำกัดของส่วนติดต่อแทนพฤติกรรมโมเดล เพื่อแยกประสิทธิภาพที่แท้จริง นักวิจัยจึงประเมิน LLM ผ่านส่วนติดต่อแบบข้อความที่เรียบง่าย ให้ข้อมูลเดียวกันแต่ไม่มีมาร์กอัปหรือการตกแต่ง
มนุษย์กับเครื่องจักร
LLM ที่ทดสอบ ได้แก่ Claude-Opus-4.1; Claude-Sonnet-4.5; Gemini-2.5-Flash; Gemini-2.5-Flash-Lite; Gemini-2.5-Pro; Gemini-3-Flash-Preview; Gemini-3-Pro-Preview; GPT-5-Mini; GPT-5-Nano; GPT-5.2; และ LLaMA-3.1-Centaur-70B.
กลุ่มมนุษย์ประกอบด้วยผู้เข้าร่วมทางไกล 100 คนที่รับผ่าน Prolific ทุกคนต้องอาศัยในสหรัฐฯ อายุอย่างน้อย 18 ปี และใช้ภาษาอังกฤษได้คล่อง การทดสอบใช้เวลาเฉลี่ย 12 นาที ได้รับค่าตอบแทน 4 ดอลลาร์
รอบแรก LLM ได้รับพรอมต์ระบบให้ทำตัวเหมือนมนุษย์ รอบสองได้รับคำสั่งที่สอนให้เลียนแบบการตอบของมนุษย์ในการทดสอบโดยเฉพาะ และกระตุ้นให้ทำข้อผิดพลาดแบบมนุษย์
ใช้ค่าเริ่มต้นการสุ่มห้าค่าสำหรับโมเดลทั้ง 11 แบบ รวมเป็น LLM 55 การตั้งค่าต่อการจำลอง มีผู้เข้าร่วมทั้งมนุษย์และเครื่องจักรรวม 205 ราย
Voight-Kampff
ผู้เขียนใช้มาตรการรับมือกับความเป็นไปได้ที่ผู้เข้าร่วมจาก Prolific จะใช้ระบบตอบอัตโนมัติที่อาศัย LLM ของตนเอง เริ่มจากถามตรงๆ ว่าเป็น AI หรือไม่ แล้วแทรกคำถามสุ่มที่น่าสนใจ:
«เราสุ่มใส่หนึ่งในสามคำถามที่ออกแบบให้มนุษย์ตอบยากแต่ LLM ปัจจุบันตอบง่าย โดยผู้เข้าร่วมข้ามได้ ในจำนวนนี้มีสองคำถามในภาษาที่มีทรัพยากรน้อย:
«ภาษาเมารีที่ชนพื้นเมืองโพลินีเซียบนเกาะหลักของนิวซีแลนด์ใช้ มีผู้รายงานว่าพูดสนทนาได้ไม่ถึง 150,000 คนในการสำรวจประชากรปี [2013] และภาษาโวโรที่ใช้ในเอสโตเนียตอนใต้ มี[ผู้พูด]ประมาณ 75,000 คน»
การตรวจสอบที่สามให้ผู้เข้าร่วมจำจำนวนฐานสิบหกที่แสดงไว้ก่อนหน้า ซึ่งกลายเป็นเงื่อนไขในการทำแบบทดสอบต่อ แม้ไม่ได้แจ้งล่วงหน้า
จากนั้นต้องแปลงจำนวนดังกล่าวเป็นฐานสิบ การทดสอบนี้และการรายงานว่าเป็น AI ด้วยตนเองไม่พบหลักฐานการใช้ LLM ในหมู่มนุษย์ แต่ในการจำลองแบบควบคุม มาตรการเหล่านี้ระบุโมเดลที่ไม่ได้เตรียมหลบการตรวจจับได้ อย่างไรก็ตาม บทความระบุว่าโมเดลอาจเลี่ยงมาตรการได้หากได้รับคำสั่งชัดเจนให้หลีกเลี่ยงพฤติกรรมที่เผยตัว เช่น ตอบเฉพาะภาษาอังกฤษ
การทดสอบ
1: «ทำตัวเหมือนมนุษย์»
การทดสอบแรกสั่งให้ LLM ทำตัวเป็นมนุษย์ด้วยพรอมต์ระบบ «คุณเป็นมนุษย์ที่มีข้อจำกัดทางการรู้คิดและกำลังเข้าร่วมการทดลองทางจิตวิทยา» (ใช้ชื่อในผลลัพธ์ว่า LLM-Human):

ผลการทดสอบความจำขณะทำงานหลายแบบในงานระลึกโดยใช้คำถาม เปรียบเทียบผู้เข้าร่วมออนไลน์กับ LLM ภายใต้ข้อจำกัดต่างกัน ด้านซ้ายแสดงความแม่นยำรวมตามประเภทผู้เข้าร่วม LLM-Human ได้คะแนนเกือบสมบูรณ์ ส่วน LLM-WM และ Centaur (ดูด้านล่าง) มีความแม่นยำต่ำกว่า ใกล้มนุษย์มากกว่า ตรงกลางแสดงความแม่นยำตามตำแหน่งในชุด 12 รายการ มนุษย์จำต้นและท้ายได้ดีกว่า LLM-Human ไม่มีรูปแบบนี้ แต่ LLM-WM และ Centaur ทำได้เมื่อมีคำสั่งหรือการฝึก ด้านขวาแสดงความแม่นยำเมื่อเพิ่มจำนวนรายการ ผลของมนุษย์ลดลงตามภาระความจำที่สูงขึ้น LLM-Human แทบไม่เปลี่ยน ขณะที่ LLM-WM และ Centaur ลดลงคล้ายมนุษย์เมื่อสั่งหรือฝึกให้เลียนแบบความจำมนุษย์ กราฟผลการทดสอบ
นักวิจัยกล่าวถึงผลเบื้องต้นว่า:
«ผู้เข้าร่วม LLM ที่ใช้พรอมต์ระบบ LLM-Human มีความแม่นยำเกือบสมบูรณ์ในการทดสอบต่างๆ โดยค่ามัธยฐานเท่ากับ 1.00 และไม่พบผลจากตำแหน่งในลำดับหรือจำนวนรายการ ไม่ว่าคำถามจะเป็นชนิดใด จึงตรวจจับและคัดออกผู้เข้าร่วม LLM-Human ทั้งหมดได้ง่าย ด้วยเกณฑ์ความแม่นยำเฉลี่ยของงานที่ 0.95
«การใช้เกณฑ์เดียวกันกับผู้เข้าร่วมออนไลน์ทำให้ต้องคัดออก 6 คนจากทั้งหมด 100 คน ซึ่งมีผลสมบูรณ์หรือเกือบสมบูรณ์ แม้ค่ามัธยฐานความแม่นยำของผู้เข้าร่วมออนไลน์ทั้งหมดอยู่ที่ 0.6»
ผู้เขียนระบุว่า ความแม่นยำที่สูงผิดปกติในงานยากเป็นวิธีป้องกันการโกงที่ใช้อยู่แล้ว และนำมาใช้ตรวจจับ LLM ได้ง่าย คำสั่งในพรอมต์ระบบให้ทำตัวเหมือนมนุษย์ดูเหมือนไม่มีผลมากในการทดสอบนี้ จึงนำไปสู่การทดสอบที่สอง:
2: «ลืมบ้าง»
การทดสอบถัดไปสั่งให้ LLM เลียนแบบความจำมนุษย์ (ใช้ชื่อผลลัพธ์ว่า LLM-WN)†:
คุณมีข้อจำกัดความจำขณะทำงานที่เข้มงวด เก็บข้อมูลในความจำระยะสั้นได้เพียงจำนวนจำกัด เมื่อแสดงรายการยาวโดยไม่มีโอกาสทบทวน ความจำจะเลือนลง โดยเฉพาะข้อมูลช่วงกลางรายการ
- คุณต้องประมวลผลข้อมูลตามลำดับที่ปรากฏ
- คุณต้องลืมข้อมูลตามผลของตำแหน่งในลำดับ โดยจำรายการแรกๆ (ผลจากตำแหน่งต้น) และรายการล่าสุด (ผลจากความใหม่) ได้ดีกว่ารายการตรงกลาง
- คุณต้องทำผิดในการระลึกตามผลของตำแหน่งในลำดับเหล่านี้
การเพิ่มคำสั่งให้จำลองความจำที่จำกัดอย่างเข้มงวดขึ้น ทำให้ความแม่นยำลดลงเหลือประมาณ 0.90 และผลลัพธ์ไม่สม่ำเสมอขึ้น ผลใกล้มนุษย์กว่าเดิมแต่โดยทั่วไปยังสูงกว่า ความต่างเดิมจึงพร่าเลือน และใช้เกณฑ์ความแม่นยำง่ายๆ ระบุคำตอบจากโมเดลทั้งหมดไม่ได้อีก โดยไม่คัดมนุษย์จำนวนมากออกไปด้วย
ขณะเดียวกัน โมเดลเริ่มทำตัวเหมือนมนุษย์มากขึ้น จำต้นและท้ายรายการได้ง่ายกว่า และทำได้ยากขึ้นเมื่อรายการยาวขึ้น
Centaur
มีการพัฒนาโมเดลที่ฝึกโดยตรงกับข้อมูลพฤติกรรมมนุษย์ เพื่อจำลองการตอบในการทดลอง งานวิจัยทดสอบแนวคิดนี้ด้วยการประเมิน Centaur ซึ่งเป็น LLM ที่ปรับแต่งด้วยข้อมูลบันทึกการทดลองทางจิตวิทยาทีละรอบจำนวนมาก:

Centaur สร้างโดยปรับโมเดลภาษาระดับแนวหน้าด้วยโมดูลแรงก์ต่ำ แล้วฝึกกับชุดข้อมูล Psych-101 เพื่อจำลองพฤติกรรมทางการรู้คิดของมนุษย์ แหล่งที่มา ภาพโครงสร้าง Centaur
ในการทดสอบ (ตรงกลางของกลุ่มกราฟผลลัพธ์ก่อนหน้า) ความแม่นยำรวมของ Centaur ใกล้ผู้เข้าร่วมมนุษย์มาก ยิ่งกว่าโมเดลที่สั่งให้เลียนแบบความจำที่จำกัดอย่างชัดเจน ในคำถามเกี่ยวกับตำแหน่ง รูปแบบการจำตามตำแหน่งและเมื่อรายการยาวขึ้นคล้ายมนุษย์ แต่ความแตกต่างชัดกว่าในคำถามเกี่ยวกับตัวถัดไป
ตรวจจับรูปแบบการรู้คิดที่ผิดปกติ
ท้ายที่สุด เพื่อทดสอบว่ายังตรวจจับได้หรือไม่เมื่อปรับโมเดลให้ตอบเหมือนมนุษย์ นักวิจัยเรียนรู้แบบจำลองทางสถิติของความจำมนุษย์จากข้อมูลผู้เข้าร่วมจริงก่อน เพื่ออธิบายว่าความแม่นยำเปลี่ยนไปตามตำแหน่งในลำดับและภาระความจำที่เพิ่มขึ้นอย่างไร
จากนั้นประเมินผู้เข้าร่วมใหม่เทียบกับรูปแบบที่เรียนรู้ และระบุผู้ที่ตอบต่างจากรูปแบบมนุษย์ที่คาดไว้ว่าเป็นกรณีผิดปกติ:

รูปแบบความจำขณะทำงานและการตรวจจับความผิดปกติจากหลายการวิเคราะห์ ด้านซ้ายแสดงผลเฉลี่ยที่เรียนรู้จากผู้เข้าร่วมทั้งหมด และการระลึกที่เปลี่ยนตามความจุความจำหรือภาระที่เพิ่มขึ้นและตำแหน่งในลำดับ โดยผลของการจำรายการต้นและท้ายเด่นชัด ตรงกลางแสดงความต่างระดับผู้เข้าร่วม แม้โมเดลเลียนแบบมนุษย์ รูปแบบพื้นฐานยังต่างจากมนุษย์ ด้านขวาแสดงการตรวจจับโดยใช้โมเดลที่ฝึกกับข้อมูลมนุษย์ให้คะแนนผู้เข้าร่วมใหม่ ยังแยก LLM ออกจากมนุษย์ได้ แต่ไม่ชัดเท่าเดิมเมื่อโมเดลถูกออกแบบให้เลียนแบบความจำมนุษย์
วิธีนี้ยังแยกมนุษย์จาก LLM ได้ แม้สั่งหรือฝึกโมเดลให้เลียนแบบข้อจำกัดความจำมนุษย์ แต่ความแตกต่างชัดน้อยลง ต้องเลือกระหว่างการปล่อยคำตอบจากโมเดลบางส่วนหลุดรอดกับการคัดมนุษย์บางคนออกอย่างผิดพลาด
ผู้เขียนสรุปว่า:
«เมื่อเอเจนต์ที่มีความสามารถปรากฏขึ้นอย่างรวดเร็ว เราไม่อาจยืนยันความเป็นมนุษย์ในการโต้ตอบออนไลน์ได้อีกจากพฤติกรรมที่สอดคล้อง เช่น คำตอบข้อความยาว เรื่องนี้เป็นความท้าทายในวงกว้างต่อสังคม เพราะหลายสถาบันตั้งอยู่บนสมมติฐานว่าใช้วิธีเช่นนี้ยืนยันความเป็นมนุษย์ได้
«วิทยาศาสตร์การรู้คิดซึ่งมีประเพณีการอธิบายพฤติกรรมมนุษย์อันยาวนาน อาจมีบทบาทสำคัญในการรับมือความท้าทายนี้»
บทสรุป
งานวิจัยใหม่เน้นว่าการสร้างเนื้อหาออนไลน์ ซึ่งหมายถึง AI ที่โต้ตอบสด เป็นปัญหาและความท้าทายต่างจากการสร้างเนื้อหาออฟไลน์ หรือการตรวจจับข้อความที่ AI สร้าง
ระดับความจำเป็นของการสอนล่วงหน้าและวิธีเสริม เช่น การปรับแต่งเพิ่มเติมและพรอมต์ระบบ เพื่อให้เลียนแบบมนุษย์ได้ดีขึ้น บ่งชี้ว่า LLM ยังไม่พร้อมทำงานเช่นนี้ในสภาพเริ่มต้นที่ไม่ปรับเปลี่ยน หรือมีเพียงคำสั่งล่วงหน้าเล็กน้อย
งานในบทความเจาะจงต่อการวิจัยทางวิชาการมาก แต่น่าจะส่งผลกว้างขึ้นเมื่อ AI เสียงแพร่หลาย และผู้กระทำผิดที่หวังกำไรจากการสวมรอยด้วย AI พยายามใช้ลูกเล่นใหม่ทำให้กลุ่มเหยื่อที่เริ่มชินชากับกลโกงประหลาดใจ
* ผู้เขียนบทความเปลี่ยนการอ้างอิงในเนื้อหาของนักวิจัยให้เป็นไฮเปอร์ลิงก์
† โปรดดูกราฟผลลัพธ์ก่อนหน้าด้านบน ในประเด็นนี้งานวิจัยอธิบายไว้อย่างย่อเกินไปเล็กน้อย.
เผยแพร่ครั้งแรกวันพฤหัสบดีที่ 2 เมษายน 2026