
มุมมองของ Anderson
DALL-E 2 เพียงแปะสิ่งต่าง ๆ เข้าด้วยกันโดยไม่เข้าใจความสัมพันธ์หรือไม่?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google

ประเด็นสำคัญDALL-E 2 ไม่สามารถสร้างความสัมพันธ์เชิงพื้นที่พื้นฐาน เช่น 'ใน' หรือ 'บน'…
ดูเพิ่มเติม
- DALL-E 2 ไม่สามารถสร้างความสัมพันธ์เชิงพื้นที่พื้นฐาน เช่น 'ใน' หรือ 'บน' ในภาพที่สร้างขึ้นได้
- มีเพียง 22% ของภาพจาก DALL-E 2 ที่ตรงกับคำอธิบายในการศึกษาที่มีผู้เข้าร่วม 169 คน
- ความล้มเหลวด้านความสัมพันธ์ของระบบจะแย่ลงเมื่อข้อมูลการฝึกอบรมขาดตัวอย่างของเหตุการณ์ที่ถูกบรรยาย
งานวิจัยใหม่จากมหาวิทยาลัยฮาร์วาร์ดชี้ว่า DALL-E 2 ระบบสร้างภาพจากข้อความของ OpenAI ที่ได้รับความสนใจอย่างมาก มีปัญหาอย่างชัดเจนในการถ่ายทอดความสัมพันธ์ระหว่างองค์ประกอบในภาพสังเคราะห์ แม้แต่ความสัมพันธ์ที่ทารกเข้าใจได้ แม้ผลลัพธ์จำนวนมากจะซับซ้อนและน่าทึ่งก็ตาม
นักวิจัยศึกษาผู้เข้าร่วมที่รับสมัครผ่านการระดมผู้เข้าร่วมออนไลน์ 169 คน โดยแสดงภาพ DALL-E 2 ซึ่งสร้างจากหลักพื้นฐานของความหมายเชิงความสัมพันธ์ พร้อมข้อความคำสั่งที่ใช้สร้างภาพ เมื่อถามว่าภาพสอดคล้องกับคำสั่งหรือไม่ ภาพน้อยกว่า 22% ได้รับการประเมินว่าสอดคล้องกับความสัมพันธ์อย่างง่ายที่ขอให้ DALL-E 2 แสดง

ภาพหน้าจอจากการทดลองในงานวิจัยใหม่ ผู้เข้าร่วมต้องเลือกภาพทั้งหมดที่ตรงกับคำสั่ง แม้ข้อความชี้แจงด้านล่างของอินเทอร์เฟซจะระบุไว้เช่นนั้น แต่ที่จริงทุกภาพสร้างจากคำสั่งที่แสดง โดยผู้เข้าร่วมไม่ทราบข้อเท็จจริงนี้ ที่มา: https://arxiv.org/pdf/2208.00005.pdf
ผลยังชี้ว่าความสามารถที่ดูเหมือนจะรวมองค์ประกอบต่างชนิดของ DALL-E อาจลดลงเมื่อองค์ประกอบเหล่านั้นมีโอกาสปรากฏร่วมกันน้อยลงในข้อมูลฝึกจากโลกจริงที่ใช้พัฒนาระบบ
ตัวอย่างเช่น ภาพจากคำสั่ง «เด็กสัมผัสชาม» มีอัตราความเห็นว่าสอดคล้อง 87% กล่าวคือผู้เข้าร่วมเลือกภาพส่วนใหญ่ว่าตรงกับคำสั่ง ขณะที่ภาพสมจริงในลักษณะเดียวกันจากคำสั่ง «ลิงสัมผัสอิกัวนา» ได้เพียง 11%:

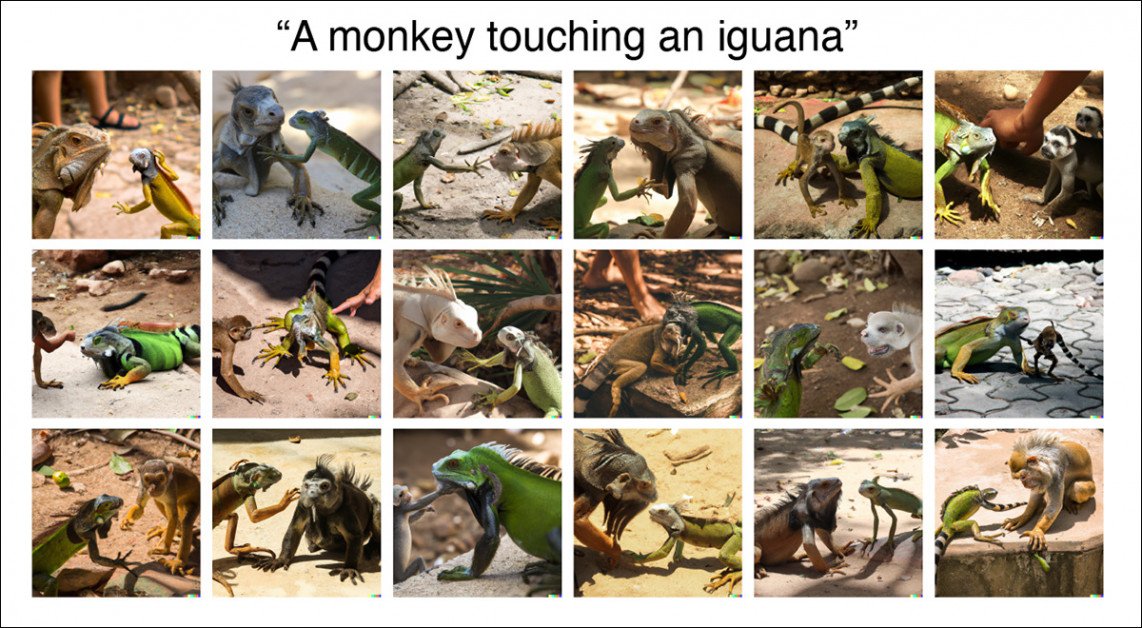
DALL-E สร้างภาพเหตุการณ์ที่ไม่น่าเกิดขึ้นอย่าง «ลิงสัมผัสอิกัวนา» ได้ยาก อาจเพราะเหตุการณ์นี้พบไม่บ่อย หรืออาจไม่มีเลยในชุดข้อมูลฝึก
ในตัวอย่างที่สอง DALL-E 2 มักแสดงขนาดและแม้กระทั่งชนิดสัตว์ผิด คาดว่าเพราะมีภาพจริงของเหตุการณ์นี้น้อย ในทางกลับกัน สมเหตุสมผลที่จะคาดว่ามีภาพฝึกเกี่ยวกับเด็กและอาหารจำนวนมาก และหมวดข้อมูลย่อยนี้ได้รับการพัฒนาไว้ดี
การที่ DALL-E วางองค์ประกอบภาพที่แตกต่างกันอย่างมากไว้ด้วยกันได้ยาก ชี้ว่าผู้คนอาจตื่นตากับความสมจริงและความสามารถตีความของระบบจนยังไม่ได้พิจารณาอย่างวิพากษ์ในกรณีที่ระบบเพียง «แปะ» องค์ประกอบหนึ่งทับอีกองค์ประกอบอย่างแปลกแยก ดังตัวอย่างจากเว็บไซต์ทางการของ DALL-E 2:
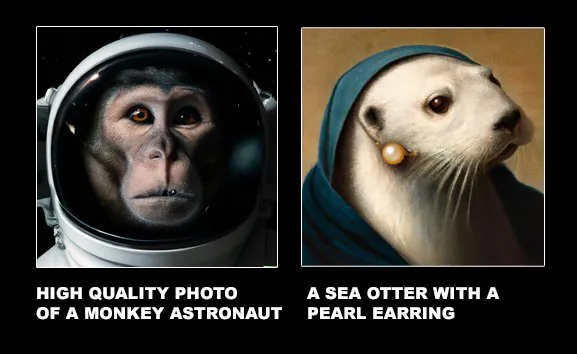
การสังเคราะห์แบบตัดแปะจากตัวอย่างทางการของ DALL-E 2 ที่มา: https://openai.com/dall-e-2/
งานวิจัยใหม่ระบุว่า*:
«ความเข้าใจความสัมพันธ์เป็นองค์ประกอบพื้นฐานของสติปัญญามนุษย์ ซึ่งปรากฏ ตั้งแต่ช่วงต้นของพัฒนาการ และประมวลผลได้อย่างรวดเร็วโดยอัตโนมัติ ในการรับรู้.
«การที่ DALL-E 2 มีปัญหากับแม้แต่ความสัมพันธ์เชิงพื้นที่พื้นฐาน เช่น อยู่ใน, อยู่บน, อยู่ใต้) ชี้ว่าไม่ว่าระบบจะเรียนรู้อะไรมา ก็ยังไม่ได้เรียนรู้รูปแบบการแทนข้อมูลที่ช่วยให้มนุษย์จัดโครงสร้างโลกได้อย่างยืดหยุ่นและมั่นคง
«การตีความปัญหานี้โดยตรงคือ ระบบอย่าง DALL-E 2 ยังไม่มีความสามารถในการประกอบองค์รวมโดยเข้าใจความสัมพันธ์ของส่วนต่าง ๆ»
ผู้เขียนเสนอว่าระบบสร้างภาพตามข้อความอย่าง DALL-E อาจได้ประโยชน์จากอัลกอริทึมที่ใช้ทั่วไปในหุ่นยนต์ ซึ่งจำลองตัวตนของสิ่งต่าง ๆ และความสัมพันธ์พร้อมกัน เพราะตัวกระทำต้องโต้ตอบกับสิ่งแวดล้อมจริง แทนที่จะเพียงสร้างส่วนผสมขององค์ประกอบหลากหลาย
แนวทางหนึ่งที่เรียกว่า CLIPort ใช้ กลไก CLIP เดียวกับที่ทำหน้าที่ประเมินคุณภาพใน DALL-E 2:
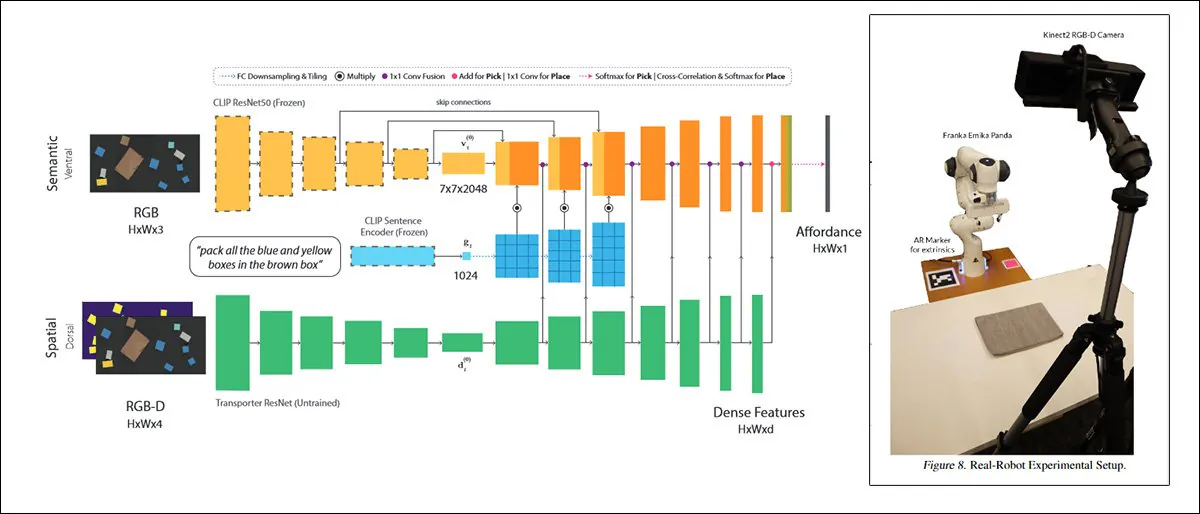
CLIPort เป็นความร่วมมือในปี 2021 ระหว่างมหาวิทยาลัยวอชิงตันและ NVIDIA โดยใช้ CLIP ในบริบทเชิงปฏิบัติที่ทำให้ระบบที่ฝึกจำเป็นต้องพัฒนาความเข้าใจความสัมพันธ์ทางกายภาพ ซึ่งเป็นแรงจูงใจที่ไม่มีใน DALL-E 2 และระบบสังเคราะห์ภาพแฟนตาซีลักษณะเดียวกัน ที่มา: https://arxiv.org/pdf/2109.12098.pdf
ผู้เขียนยังเสนอว่าการปรับปรุงที่เป็นไปได้อีกอย่างคือให้สถาปัตยกรรมระบบสังเคราะห์ภาพอย่าง DALL-E รวม ผลแบบคูณ ในชั้นประมวลผลเพียงชั้นเดียว เพื่อคำนวณความสัมพันธ์โดยรับแรงบันดาลใจจากความสามารถประมวลผลข้อมูลของระบบ ทางชีวภาพ.
งานวิจัยใหม่ มีชื่อว่า การทดสอบความเข้าใจความสัมพันธ์ในการสร้างภาพตามข้อความ โดย Colin Conwell และ Tomer D. Ullman จากภาควิชาจิตวิทยาของมหาวิทยาลัยฮาร์วาร์ด
นอกเหนือจากคำวิจารณ์ช่วงแรก
เมื่อกล่าวถึง «กลลวง» ที่อยู่เบื้องหลังความสมจริงและความกลมกลืนของภาพ DALL-E 2 ผู้เขียนยกงานก่อนหน้าที่พบข้อบกพร่องในระบบสร้างภาพลักษณะนี้
ในเดือนมิถุนายนปีนี้ UoC Berkeley ระบุ ว่า DALL-E จัดการภาพสะท้อนและเงาได้ยาก เดือนเดียวกัน งานจากเกาหลีตรวจสอบความเป็นเอกลักษณ์และความเป็นต้นฉบับของภาพแบบ DALL-E 2 อย่างวิพากษ์ ส่วน การวิเคราะห์เบื้องต้น ของภาพ DALL-E 2 โดย NYU และมหาวิทยาลัยเทกซัสไม่นานหลังเปิดตัว พบปัญหาการประกอบองค์รวมและปัจจัยสำคัญอื่น ๆ และเมื่อเดือนที่แล้ว งานร่วม ระหว่างมหาวิทยาลัยอิลลินอยส์และ MIT เสนอการปรับปรุงสถาปัตยกรรมเพื่อเพิ่มความสามารถประกอบองค์รวม
นักวิจัยยังชี้ว่าผู้เชี่ยวชาญ DALL-E เช่น Aditya Ramesh ยอมรับ ปัญหาของระบบในการผูกคุณสมบัติกับสิ่งต่าง ๆ ขนาดสัมพัทธ์ ข้อความ และประเด็นอื่น
ผู้พัฒนา Imagen ซึ่งเป็นระบบสังเคราะห์ภาพคู่แข่งของ Google ยังเสนอ DrawBench ซึ่งเป็นระบบเปรียบเทียบใหม่ที่วัดความถูกต้องของภาพจากหลายระบบด้วยเกณฑ์ที่หลากหลาย
แต่ผู้เขียนงานใหม่นี้เสนอว่า การใช้การประเมินของมนุษย์กับภาพที่ได้ แทนตัวชี้วัดเชิงอัลกอริทึมระหว่างระบบ อาจช่วยระบุจุดอ่อนและแนวทางลดปัญหาได้ดีกว่า
การศึกษา
โครงการใหม่นี้จึงตั้งอยู่บนหลักจิตวิทยา และพยายามถอยออกมาจาก กระแสความสนใจ ใน การออกแบบคำสั่ง ซึ่งแท้จริงคือการยอมรับข้อบกพร่องของ DALL-E 2 หรือระบบที่เทียบเคียงกัน เพื่อสำรวจและอาจแก้ไขข้อจำกัดที่ทำให้จำเป็นต้องใช้วิธีแก้ขัดเหล่านี้
งานวิจัยระบุว่า:
«งานนี้มุ่งศึกษาความสัมพันธ์พื้นฐาน 15 แบบที่เคยอธิบาย ศึกษา หรือเสนอในวรรณกรรมด้านการรู้คิด พัฒนาการ หรือภาษาศาสตร์ ชุดนี้ครอบคลุมทั้งความสัมพันธ์เชิงพื้นที่ที่เป็นรูปธรรม เช่น X อยู่บน Y และความสัมพันธ์ระหว่างตัวกระทำที่เป็นนามธรรมกว่า เช่น X ช่วย Y
«คำสั่งตั้งใจให้เรียบง่าย ไม่มีคุณสมบัติซับซ้อนหรือรายละเอียดเพิ่มเติม แทนที่จะใช้คำสั่งว่า ‘ลาและปลาหมึกกำลังเล่นเกม ลาถือปลายเชือกด้านหนึ่ง ปลาหมึกถืออีกด้าน ลาคาบเชือกไว้ในปาก แมวกระโดดข้ามเชือก’ เราใช้ ‘กล่องอยู่บนมีด’
«ความเรียบง่ายนี้ยังครอบคลุมความสัมพันธ์มากมายจากหลายสาขาย่อยของจิตวิทยามนุษย์ และทำให้ความล้มเหลวที่อาจเกิดกับโมเดลเห็นได้เด่นชัดและเฉพาะเจาะจงขึ้น»
ผู้เขียนรับสมัครผู้เข้าร่วม 169 คนจาก Prolific ทุกคนอยู่ในสหรัฐฯ อายุเฉลี่ย 33 ปี และเป็นผู้หญิง 59%
ผู้เข้าร่วมเห็นภาพ 18 ภาพในตาราง 3×6 พร้อมคำสั่งด้านบนและข้อความชี้แจงด้านล่างว่า ภาพทั้งหมด บางภาพ หรือไม่มีภาพใดเลยอาจสร้างจากคำสั่งที่แสดง จากนั้นให้เลือกภาพที่คิดว่าสอดคล้องกับคำสั่ง
ภาพอ้างอิงวรรณกรรมภาษาศาสตร์ พัฒนาการ และการรู้คิด ครอบคลุมความสัมพันธ์ทางกายภาพแปดแบบและความสัมพันธ์ระหว่างตัวกระทำเจ็ดแบบ ซึ่งจะอธิบายต่อไป
ความสัมพันธ์ทางกายภาพ
อยู่ใน, อยู่บน, อยู่ใต้, ปกคลุม, อยู่ใกล้, ถูกบดบังโดย, ห้อยอยู่เหนือ, และ ผูกติดกับ.
ความสัมพันธ์ระหว่างตัวกระทำ
ผลัก, ดึง, สัมผัส, ตี, เตะ, ช่วย, และ ขัดขวาง.
ความสัมพันธ์ทั้งหมดนำมาจากงานวิจัยนอกสาขาวิทยาการคอมพิวเตอร์ที่กล่าวไว้ข้างต้น
จึงได้สิ่งต่าง ๆ 12 ชนิดสำหรับใช้ในคำสั่ง แบ่งเป็นวัตถุหกชนิดและตัวกระทำหกชนิด:
วัตถุ
กล่อง, ทรงกระบอก, ผ้าห่ม, ชาม, ถ้วยชา, และ มีด
ตัวกระทำ
ผู้ชาย, ผู้หญิง, เด็ก, หุ่นยนต์, ลิง, และ อิกัวนา
(นักวิจัยยอมรับว่าการใส่อิกัวนา ซึ่งไม่ใช่สิ่งที่พบทั่วไปในงานสังคมวิทยาหรือจิตวิทยาที่เคร่งขรึม เป็น «ความสนุกเล็กน้อย»)
สำหรับแต่ละความสัมพันธ์ มีการสุ่มสิ่งสองชนิดห้าครั้งเพื่อสร้างคำสั่งต่างกันห้าชุด รวมเป็น 75 คำสั่ง ทุกคำสั่งส่งให้ DALL-E 2 และใช้ภาพ 18 ภาพแรกที่ได้ โดยไม่อนุญาตให้สร้างรูปแบบอื่นหรือลองใหม่
ผลลัพธ์
งานวิจัยระบุว่า*:
«ผู้เข้าร่วมเห็นความสอดคล้องระหว่างภาพ DALL-E 2 และคำสั่งที่ใช้สร้างภาพในระดับต่ำโดยเฉลี่ย โดยเฉลี่ยอยู่ที่ 22.2% [18.3, 26.6] จากคำสั่งต่างกัน 75 ชุด
«คำสั่งเกี่ยวกับตัวกระทำ 35 ชุดมีค่าเฉลี่ย 28.4% [22.8, 34.2] ซึ่งสูงกว่าคำสั่งทางกายภาพ 40 ชุดที่มีค่าเฉลี่ย 16.9% [11.9, 23.0]»

ผลการศึกษา จุดสีดำแสดงคำสั่งทั้งหมด โดยแต่ละจุดคือหนึ่งคำสั่ง และสีแบ่งตามว่าคำสั่งเกี่ยวกับตัวกระทำหรือสิ่งทางกายภาพ คือวัตถุ
เพื่อเปรียบเทียบการรับรู้ภาพของมนุษย์กับอัลกอริทึม นักวิจัยประมวลผลภาพผ่านระบบโอเพนซอร์สของ OpenAI ViT-L/14 ที่ใช้ CLIP เมื่อเฉลี่ยคะแนน พบ «ความสัมพันธ์ระดับปานกลาง» ระหว่างผลสองชุด ซึ่งอาจน่าแปลกใจเมื่อพิจารณาว่า CLIP เองช่วยสร้างภาพมากเพียงใด

ผลการเปรียบเทียบ CLIP (ViT-L/14) กับคำตอบของมนุษย์
นักวิจัยเสนอว่ากลไกอื่นในสถาปัตยกรรม อาจร่วมกับความมากหรือน้อยของข้อมูลในชุดฝึกที่เกิดขึ้นโดยบังเอิญ อธิบายได้ว่าเหตุใด CLIP จึงเห็นข้อจำกัดของ DALL-E แต่ไม่สามารถแก้ปัญหาได้มากนักในทุกกรณี
ผู้เขียนสรุปว่า DALL-E 2 มีความสามารถเพียงผิวเผิน หรืออาจไม่มีเลย ในการสร้างภาพที่รวมความเข้าใจความสัมพันธ์ ซึ่งเป็นองค์ประกอบพื้นฐานของสติปัญญามนุษย์ที่พัฒนาตั้งแต่ช่วงต้นมาก
«แนวคิดที่ว่าระบบอย่าง DALL-E 2 ไม่มีความสามารถประกอบองค์รวม อาจทำให้ผู้ที่เคยเห็นผลลัพธ์สมเหตุสมผลจากคำสั่งอย่าง ‘ภาพการ์ตูนหัวไชเท้าญี่ปุ่นตัวน้อยสวมกระโปรงบัลเลต์กำลังพาสุนัขพุดเดิลเดินเล่น’ ประหลาดใจ คำสั่งเช่นนี้มักให้ภาพโดยประมาณที่สมเหตุสมผลของแนวคิดประกอบ โดยส่วนต่าง ๆ ของคำสั่งปรากฏครบและอยู่ในตำแหน่งถูกต้อง
«แต่การประกอบองค์รวมไม่ได้เป็นเพียงความสามารถแปะสิ่งต่าง ๆ เข้าด้วยกัน แม้เป็นสิ่งที่ไม่เคยเห็นร่วมกันมาก่อน ความสามารถนี้ต้องเข้าใจ กฎ ที่ยึดโยงสิ่งต่าง ๆ เข้าด้วยกัน ความสัมพันธ์ก็คือกฎเหล่านี้»
คนกัดทีเร็กซ์
ความเห็น เมื่อ OpenAI เปิดรับ ผู้ใช้จำนวนมากขึ้น หลังเพิ่งเริ่มหารายได้จาก DALL-E 2 รุ่นเบตา และเมื่อผู้ใช้ต้องจ่ายเงินสำหรับการสร้างภาพส่วนใหญ่ ข้อบกพร่องในการเข้าใจความสัมพันธ์อาจชัดเจนขึ้น เพราะความพยายามที่ล้มเหลวแต่ละครั้งมีต้นทุนและไม่สามารถขอคืนเงินได้
พวกเราที่ได้รับคำเชิญก่อนหน้านี้เล็กน้อยมีเวลา และจนถึงไม่นานมานี้ก็มีอิสระในการทดลองมากกว่า เพื่อสังเกตความผิดพลาดด้านความสัมพันธ์ที่ DALL-E 2 สร้างขึ้น
ตัวอย่างเช่น สำหรับแฟน Jurassic Park การทำให้ไดโนเสาร์ไล่ตามคนใน DALL-E 2 ยากมาก แม้แนวคิด ‘ไล่ตาม’ ดูเหมือนไม่ได้อยู่ใน ระบบเซ็นเซอร์ ของ DALL-E 2 และแม้ ประวัติอันยาวนาน ของภาพยนตร์ไดโนเสาร์น่าจะให้ตัวอย่างฝึกมากมาย อย่างน้อยในรูปแบบตัวอย่างหนังและภาพประชาสัมพันธ์ สำหรับการพบกันระหว่างสิ่งมีชีวิตที่เป็นไปไม่ได้ในโลกจริงนี้
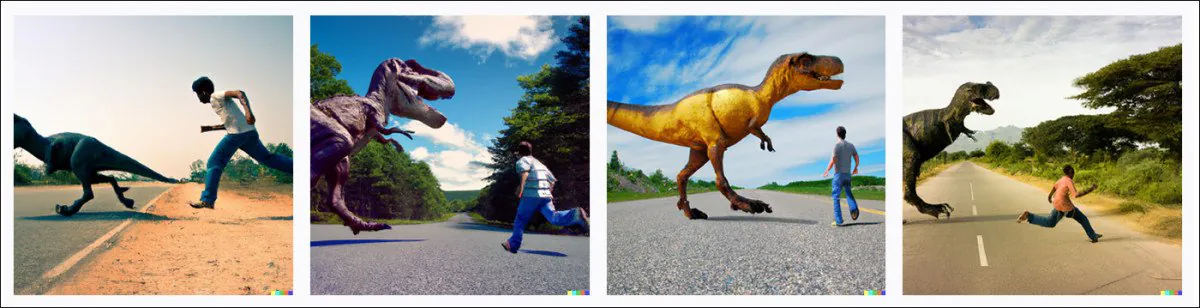
ผลลัพธ์ทั่วไปของ DALL-E 2 จากคำสั่ง ‘ภาพสีของทีเร็กซ์ไล่ตามชายคนหนึ่งไปตามถนน’ ที่มา: DALL-E 2
ผมพบว่าภาพข้างต้นเป็นผลลัพธ์ทั่วไปของคำสั่งรูปแบบ ‘[ไดโนเสาร์] ไล่ตาม [คน]’ และไม่ว่าจะเพิ่มรายละเอียดอย่างไร ก็ไม่อาจทำให้ทีเร็กซ์ทำตามได้จริง ในภาพแรกและภาพที่สอง ชายคนนั้นเป็นฝ่ายไล่ตามทีเร็กซ์ไม่มากก็น้อย ภาพที่สามเขาเดินเข้าใกล้มันอย่างไม่ใส่ใจความปลอดภัย และภาพสุดท้ายดูเหมือนวิ่งเหยาะ ๆ ขนานกับสัตว์ยักษ์ จากการลองราว 10–15 ครั้งในหัวข้อนี้ ผมพบว่าไดโนเสาร์ดูวอกแวกคล้ายกัน
เป็นไปได้ว่าข้อมูลฝึกเพียงอย่างเดียวที่ DALL-E 2 เข้าถึงได้อยู่ในแนว ‘คนต่อสู้กับไดโนเสาร์’ จากภาพประชาสัมพันธ์หนังเก่า เช่น One Million Years B.C. (1966) และการ หนีอันโด่งดัง ของ Jeff Goldblum จากราชานักล่าเป็นเพียงข้อยกเว้นในข้อมูลชุดเล็กนั้น
* ผู้เขียนแปลงการอ้างอิงในเนื้อหาของนักวิจัยเป็นไฮเปอร์ลิงก์
เผยแพร่ครั้งแรก 4 สิงหาคม 2022





