
มุมมองของ Anderson
การระบุตัวตนของดารา Deepfake จากภูมิภาคใบหน้าภายนอก

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
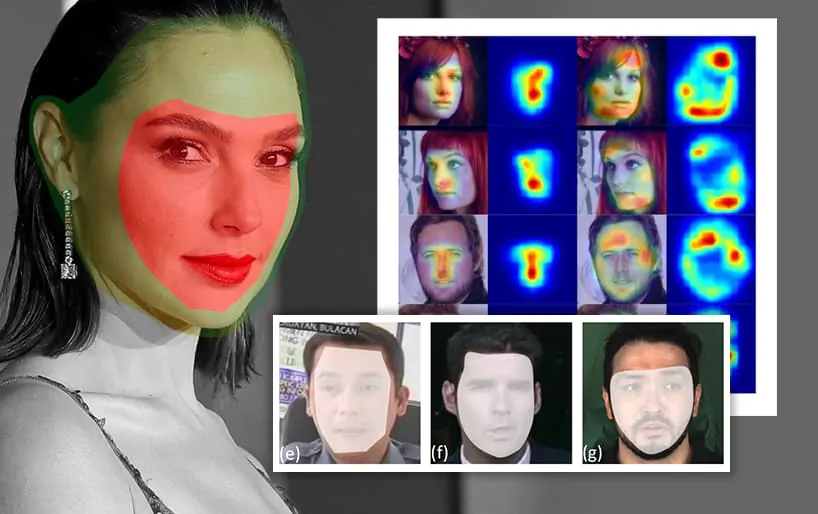
การร่วมมือใหม่ระหว่าง Microsoft (MSFT ) และมหาวิทยาลัยจีนได้เสนอวิธีการใหม่ในการระบุตัวตนของดารา Deepfake โดยใช้ข้อบกพร่องของเทคนิค Deepfake ปัจจุบันเพื่อรับรู้ตัวตนที่ถูก ‘ฉาย’ ไปยังคนอื่น
แนวทางนี้เรียกว่า Identity Consistency Transformer (ICT) และทำงานโดยการเปรียบเทียบส่วนภายนอกของใบหน้า (ขากรรไกร ขนหู เส้นผม และอื่นๆ) กับส่วนภายในของใบหน้า ระบบนี้ใช้ข้อมูลภาพสาธารณะที่มีอยู่ของคนดัง ซึ่งจำกัดความมีประสิทธิภาพของมันให้แคบลงเฉพาะคนดังที่มีภาพในจำนวนมากในฐานข้อมูลการมองเห็นของคอมพิวเตอร์และบนอินเทอร์เน็ต

พื้นที่การครอบคลุมของใบหน้าปลอมที่ใช้เทคนิคต่างๆ: DeepFake in FF+; DeepFake in Google DeepFake Detection; DeepFaceLab; Face2Face; FSGAN; และ DF-VAE. Source: https://arxiv.org/pdf/2203.01318.pdf
ตามที่รูปด้านบนแสดง เทคนิค Deepfake ที่ใช้กันอยู่ในปัจจุบันถูกจำกัดอย่างมาก และพึ่งพา ‘ใบหน้าโฮสต์’ (ภาพหรือวิดีโอของบุคคลที่จะมีตัวตนถูกแทนที่ด้วย Deepfake) เพื่อลดหลักฐานการแทนที่ใบหน้า
แม้ว่าเทคนิคต่างๆ อาจครอบคลุมหน้าผากและพื้นที่แก้มและขากรรไกร แต่ทั้งหมดถูกจำกัดไว้ภายในกรอบของใบหน้าโฮสต์

แผนที่ความสำคัญที่เน้น ‘ตัวตนภายใน’ และ ‘ตัวตนภายนอก’ ที่คำนวณโดย ICT. เมื่อความสอดคล้องของใบหน้าภายในถูกกำหนดไว้ แต่ตัวตนภายนอกไม่สอดคล้องกัน ICT จะประเมินภาพว่าเป็นเท็จ
ในการทดสอบ ICT พิสูจน์แล้วว่าสามารถตรวจจับเนื้อห Deepfake ในสภาพแวดล้อมที่เป็นมิตรกับ Deepfake เช่น วิดีโอที่มีความละเอียดต่ำ ซึ่งเนื้อหาทั้งหมดของวิดีโอมีการบิดเบือนโดยอาร์ติแฟคต์ของการบีบอัด ซึ่งช่วยให้ซ่อนหลักฐานของกระบวนการ Deepfake – สภาพที่ทำให้หลายวิธีการตรวจจับ Deepfake ต้องสับสน

ICT มีประสิทธิภาพเหนือกว่าวิธีการตรวจจับ Deepfake อื่นๆ ในการรับรู้เนื้อห Deepfake. ดูวิดีโอที่ฝังไว้ท้ายบทความสำหรับตัวอย่างเพิ่มเติมและความละเอียดที่ดีกว่า. ดูวิดีโอที่ฝังไว้ท้ายบทความสำหรับตัวอย่างเพิ่มเติม Source: https://www.youtube.com/watch?v=zgF50dcymj8
เอกสารวิจัย เรื่องนี้ มีชื่อเรื่องว่า การปกป้องคนดังด้วย Identity Consistency Transformer และมาจากนักวิจัย 9 คนจากมหาวิทยาลัยวิทยาศาสตร์และเทคโนโลยีของจีน Microsoft Research Asia และ Microsoft Cloud + AI
ช่องว่างความน่าเชื่อถือ
มีเหตุผลอย่างน้อยสองประการว่าทำไมอัลกอริทึมการเปลี่ยนใบหน้าแบบ Deepfake ที่ได้รับความนิยม เช่น DeepFaceLab และ FaceSwap ถึงละเลยพื้นที่ภายนอกของใบหน้าที่ถูกเปลี่ยน
ประการแรก การฝึกอบรมแบบจำลอง Deepfake ใช้เวลาและทรัพยากรมาก และการนำ ‘ใบหน้าโฮสต์’ ที่เข้ากันได้มาใช้จะช่วยให้สามารถใช้ GPU และช่วงเวลาในการฝึกอบรมได้อย่างมีประสิทธิภาพมากขึ้น โดยมุ่งเน้นไปที่พื้นที่ภายในของใบหน้าที่เราใช้ในการแยกแยะตัวตน (เนื่องจากตัวแปรเช่นการเปลี่ยนแปลงน้ำหนักและอายุจะไม่น่าจะเปลี่ยนลักษณะใบหน้าเหล่านี้ในระยะสั้น)
ประการที่สอง วิธีการ Deepfake ส่วนใหญ่ (และนี่คือกรณีของ DeepFaceLab ซึ่งเป็นซอฟต์แวร์ที่ใช้โดยผู้ปฏิบัติงานที่มีชื่อเสียงหรือเป็นที่รู้จักมากที่สุด) มีความสามารถในการจำลอง ‘ขอบเขตของใบหน้า’ เช่น พื้นที่แก้มและขากรรไกรได้จำกัด และถูกจำกัดโดยข้อเท็จจริงที่ว่ารหัสต้นฉบับ (2017) ไม่ได้กล่าวถึงประเด็นนี้อย่างกว้างขวาง
ในกรณีที่ตัวตนไม่ตรงกัน อัลกอริทึม Deepfake จะต้อง ‘ทาสี’ พื้นที่หลังของใบหน้า ซึ่งทำได้ไม่ดีนัก แม้แต่ในมือของผู้สร้าง Deepfake ที่มีชื่อเสียง เช่น Ctrl Shift Face ซึ่งผลงานของพวกเขาถูกใช้ในการศึกษาของเอกสารวิจัย

สุดยอดของสุดยอด: ภาพจากวิดีโอ Deepfake ของ Ctrl-Shift-Face ที่มีชื่อเสียง ซึ่งเปลี่ยน Jim Carrey เป็น Gary Oldman. ผลงานนี้อาจเป็นตัวอย่างที่ดีที่สุดของผลลัพธ์ที่ได้จาก DeepFaceLab และเทคนิคหลังการประมวลผล. อย่างไรก็ตาม การเปลี่ยนใบหน้ายังคงจำกัดอยู่ที่การให้ความสนใจกับใบหน้าภายนอก ซึ่งต้องใช้ความพยายามอย่างมากในการดูแลข้อมูลและการฝึกอบรมเพื่อแก้ไขปัญหาเหล่านี้ Source: https://www.youtube.com/watch?v=x8igrh1eyLk
การ ‘หลอกลวง’ หรือการเบี่ยงเบนความสนใจนี้หลบเลี่ยงความสนใจของสาธารณชนในเรื่องความกังวลที่เพิ่มขึ้นเกี่ยวกับความสมจริงที่เพิ่มขึ้นของ Deepfake เนื่องจากความสามารถในการวิเคราะห์ของเรายังอยู่ในขั้นตอน ‘ตกใจและตื่นตะลึง’
ตัวตนแบ่งแยก
เอกสารวิจัยใหม่ระบุว่าวิธีการตรวจจับ Deepfake ก่อนหน้านี้ส่วนใหญ่พึ่งพาอาร์ติแฟคต์ที่ทรยศการเปลี่ยนใบหน้า เช่น ท่าทางที่ไม่สอดคล้องกัน และ การกระพริบตา เป็นต้น ในหมู่เทคนิคอื่นๆ อีกมากมาย เพียงแค่สัปดาห์ที่แล้ว เอกสารวิจัยใหม่เกี่ยวกับการตรวจจับ Deepfake ได้ เสนอ การใช้ ‘ลายเซ็น’ ของรูปแบบโมเดลต่างๆ ในเฟรมเวิร์ก FaceSwap เพื่อช่วยในการระบุวิดีโอที่ปลอมโดยใช้เฟรมเวิร์กนั้น (ดูภาพด้านล่าง)

การระบุ Deepfake โดยการอธิบาย ‘ลายเซ็น’ ของรูปแบบโมเดลต่างๆ ในเฟรมเวิร์ก FaceSwap. Source: https://arxiv.org/pdf/2202.12951.pdf
ในทางตรงกันข้าม สถาปัตยกรรมของ ICT สร้างตัวตนแบ่งแยกสองตัวสำหรับบุคคลหนึ่งๆ โดยที่ตัวตนแต่ละตัวต้องได้รับการยืนยันก่อนที่ตัวตนจะถือว่าเป็น ‘แท้’ หรือ ‘ปลอม’

สถาปัตยกรรมสำหรับระยะการฝึกอบรมและการทดสอบของ ICT.
การแบ่งตัวตนนี้ได้รับการอำนวยความสะดวกโดย Transformer ที่ทำงานการระบุใบหน้าโดยการแบ่งพื้นที่ที่สำรวจออกเป็นโทเค็นที่เป็นส่วนหนึ่งของตัวตนภายในหรือภายนอก

การกระจายพैचให้กับตัวตนด้านในและด้านนอก
เอกสารวิจัยระบุว่า:
‘ไม่น่าเสียดายที่วิธีการยืนยันตัวตนใบหน้าแบบเดิมๆ มักจะอธิบายพื้นที่ที่มีผลกระทบมากที่สุด เช่น ใบหน้าภายในเพื่อยืนยันตัวตนและล้มเหลวในการจับข้อมูลตัวตนในใบหน้าภายนอก ด้วย Identity Consistency Transformer เราได้ฝึกโมเดลเพื่อเรียนรู้เวกเตอร์ตัวตนสองตัว หนึ่งสำหรับใบหน้าภายในและอีกตัวสำหรับใบหน้าภายนอก โดยการออกแบบ Transformer เพื่อให้ตัวตนด้านในและด้านนอกสามารถเรียนรู้พร้อมๆ กันในโมเดลที่รวมกันอย่างไม่มีข้อผิดพลาด’
เนื่องจากไม่มีโมเดลที่มีอยู่สำหรับโพรโทคอลการระบุตัวตนนี้ ผู้เขียนจึงได้สร้างความสูญเสียความสอดคล้องใหม่ที่สามารถทำหน้าที่เป็นมาตรฐานสำหรับการตรวจสอบความถูกต้องได้ ‘โทเค็นภายใน’ และ ‘โทเค็นภายนอก’ ที่ได้มาจากโมเดลการระบุตัวตนนี้จะถูกเพิ่มเข้ากับอิมเบดดิ้งพैचที่ผลิตโดยเฟรมเวิร์กการระบุใบหน้า
ข้อมูลและการฝึกอบรม
เครือข่าย ICT ถูกฝึกอบรมบนชุดข้อมูล MS-Celeb-1M ของ Microsoft Research ซึ่งมีภาพใบหน้าคนดัง 10 ล้านภาพที่ครอบคลุมตัวตน 1 ล้านคน รวมถึงนักแสดง นักการเมือง และบุคคลสำคัญอื่นๆ ตามขั้นตอนของวิธีการก่อนหน้า Face X-ray (โครงการริเริ่มอีกโครงการหนึ่งของ Microsoft Research) รูทีนการสร้างภาพปลอมของ ICT จะสลับพื้นที่ภายในและภายนอกของใบหน้าจากชุดข้อมูลนี้เพื่อสร้างวัสดุสำหรับทดสอบอัลกอริทึม
ในการทำการเปลี่ยนภายในเหล่านี้ ICT จะระบุสองภาพในฐานข้อมูลที่มีท่าทางและลักษณะใบหน้าที่คล้ายกัน สร้างพื้นที่มาสก์ของคุณลักษณะกลาง (ที่สามารถทำการเปลี่ยนได้) และทำการเปลี่ยนใบหน้าแบบ Deepfake พร้อมการแก้ไขสี RGB
เหตุผลที่ ICT มีจำกัดในการระบุตัวตนคนดังคือเพราะว่ามันพึ่งพาชุดอ้างอิงใหม่ที่รวมเวกเตอร์ใบหน้าที่ได้มาจากคอร์ปัสกลาง (ในกรณีนี้คือ MS-Celeb-1M แม้ว่าชุดอ้างอิงนี้จะสามารถขยายออกไปได้ถึงภาพที่มีอยู่บนอินเทอร์เน็ต ซึ่งจะน่าจะมีคุณภาพและปริมาณเพียงพอสำหรับบุคคลที่มีชื่อเสียงเท่านั้น)
เวกเตอร์คู่ที่ได้มาจากวิธีการเหล่านี้ทำหน้าที่เป็นโทเค็นความถูกต้องเพื่อยืนยันพื้นที่ใบหน้าภายในและภายนอกพร้อมๆ กัน
ผู้เขียนระบุว่าโทเค็นเหล่านี้ที่ได้มาจากวิธีการเหล่านี้เป็น ‘คุณลักษณะระดับสูง’ ซึ่งนำไปสู่กระบวนการตรวจจับ Deepfake ที่มีแนวโน้มที่จะรอดพ้นจากสภาพแวดล้อมที่ท้าทาย เช่น วิดีโอที่มีความละเอียดต่ำหรือเสื่อมสภาพอื่นๆ
สิ่งสำคัญคือ ICT ไม่ กำลังมองหาความแตกต่างของอาร์ติแฟคต์ แต่กำลังมุ่งเน้นไปที่วิธีการยืนยันตัวตนที่สอดคล้องกับเทคนิคการระบุใบหน้า – วิธีการที่ยากเมื่อมีข้อมูลในปริมาณน้อย เช่น ในกรณีของการตรวจสอบการสร้างภาพลามกอนาจารแบบ Deepfake ที่มีต่อผู้ที่ไม่ชื่อเสียง
การทดสอบ
หลังจากฝึกอบรมบน MS-Celeb-1M แล้ว ICT ก็ถูกแบ่งออกเป็นรูปแบบที่มีการอ้างอิงและ ‘盲’ ของอัลกอริทึม และทดสอบกับชุดข้อมูลและวิธีการตรวจจับ Deepfake ที่แตกต่างกัน รวมถึง FaceForensics++ (FF++) ชุดข้อมูลที่มีวิดีโอจริงและวิดีโอ Deepfake 1,000 รายการซึ่งสร้างขึ้นโดยใช้วิธีการ 4 วิธี รวมถึง Face2Face และ FaceSwap; การตรวจจับ Deepfake ของ Google ซึ่งประกอบด้วยวิดีโอ Deepfake ที่สร้างโดย Google จำนวนหลายพันรายการ; Celeb-DeepFake v1 (CD1) ซึ่งมีวิดีโอจริง 408 รายการและวิดีโอ Deepfake 795 รายการ; Celeb-DeepFake v2 ซึ่งเป็นขยายของ v1 ที่มีวิดีโอจริง 590 รายการและวิดีโอ Deepfake 5,639 รายการ; และ Deeper-Forensics (Deeper) ของจีนในปี 2020
ชุดข้อมูลเหล่านี้คือชุดข้อมูลที่ใช้ในการทดสอบ ในขณะที่วิธีการตรวจจับที่ใช้ในการทดสอบ ได้แก่ Multi-task, MesoInc4, Capsule, Xception-c0, c2 (วิธีการที่ใช้ใน FF++), FWA/DSP-FW จากมหาวิทยาลัยอัลบานี, Two-Branch, PCL+I2G และวิธีการ ความไม่สอดคล้องของบริบท ของ Yuval Nirkin
วิธีการตรวจจับเหล่านี้มุ่งเน้นไปที่การตรวจจับการจัดการใบหน้าแบบเฉพาะเจาะจง นอกจากนี้ยังทดสอบวิธีการตรวจจับ Deepfake ทั่วไป เช่น Face X-ray, FFD ของมหาวิทยาลัยมิชิแกน, CNNDetection และ Patch-Forensics ของ MIT CSAIL
ผลลัพธ์ที่เห็นได้ชัดเจนที่สุดจากการทดสอบคือวิธีการตรวจจับ Deepfake ที่แข่งขันกันลดประสิทธิภาพลงอย่างมากเมื่อความละเอียดและคุณภาพของวิดีโอลดลง เนื่องจากหนึ่งในศักยภาพที่รุนแรงที่สุดของการเจาะจง Deepfake ที่มีต่ออำนาจการวิเคราะห์ของเรานั้นอยู่ในวิดีโอที่ไม่ใช่ HD หรือคุณภาพที่เสื่อมสภาพอื่นๆ

ในกราฟผลลัพธ์ด้านบน เส้นสีน้ำเงินและแดงแสดงถึงความทนทานของวิธีการ ICT ต่อการเสื่อมสภาพของภาพในพื้นที่ทั้งหมดยกเว้นอุปสรรคของสัญญาณรบกวนแบบกอสมอส (ซึ่งไม่น่าจะเกิดขึ้นในวิดีโอที่บันทึกจาก Zoom และเว็บแคม) ในขณะที่วิธีการตรวจจับที่แข่งขันกันลดความน่าเชื่อถือลงอย่างมาก
ในตารางผลลัพธ์ด้านล่าง เราจะเห็นประสิทธิภาพของวิธีการตรวจจับ Deepfake ที่แตกต่างกันบนชุดข้อมูลที่ไม่ทราบก่อนหน้านี้ สัญลักษณ์เทาและดอกจันแสดงถึงผลลัพธ์ที่เปรียบเทียบจากผลลัพธ์ที่ตีพิมพ์เดิมในโครงการที่ปิด ซึ่งไม่สามารถตรวจสอบได้จากภายนอก ในชุดข้อมูลส่วนใหญ่ ICT มีประสิทธิภาพเหนือกว่าวิธีการตรวจจับ Deepfake ที่แข่งขันกัน (แสดงเป็นตัวหนา)

ในฐานะการทดสอบเพิ่มเติม ผู้เขียนได้ใช้เนื้อหาจากรายการ YouTube ของ Ctrl Shift Face ซึ่งเป็นนักสร้าง Deepfake ที่มีชื่อเสียง และพบว่าวิธีการที่แข่งขันกันบรรลุผลลัพธ์ที่ด้อยกว่า:

สิ่งที่น่าสังเกตคือวิธีการ FF++ (Xception-c23) และ FFD ซึ่งบรรลุผลลัพธ์ที่สูงในบางชุดข้อมูลที่ทดสอบในเอกสารวิจัยใหม่นี้ ได้ผลลัพธ์ที่ต่ำกว่า ICT ในบริบท ‘โลกแห่งความเป็นจริง’ ของเนื้อห Deepfake ที่มีระดับการสร้างที่สูง
ผู้เขียนสรุปเอกสารวิจัยด้วยความหวังว่าผลลัพธ์ของเอกสารวิจัยนี้จะชี้นำชุมชนในการตรวจจับ Deepfake ไปสู่การริเริ่มที่คล้ายกันซึ่งมุ่งเน้นไปที่คุณลักษณะระดับสูงซึ่งสามารถนำไปใช้ได้ง่าย และหันเหความสนใจไปจาก ‘สงครามเย็น’ ของการตรวจจับอาร์ติแฟคต์ ซึ่งวิธีการใหม่ๆ ถูกทำให้ไม่มีประสิทธิภาพโดยการพัฒนาในเฟรมเวิร์ก Deepfake หรือโดยปัจจัยอื่นๆ ที่ทำให้วิธีการเหล่านี้มีประสิทธิภาพน้อยลง
ดูวิดีโอที่ฝังไว้ท้ายบทความสำหรับตัวอย่างเพิ่มเติมของ ICT ที่ระบุเนื้อห Deepfake ที่สามารถหลบหลีกวิธีการอื่นๆ ได้
ตีพิมพ์ครั้งแรกเมื่อวันที่ 4 มีนาคม 2022.


