
มุมมองของ Anderson
วิธีการหยุด AI ที่แสดง iPhone ในยุคสมัยที่ล่วงแล้ว

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
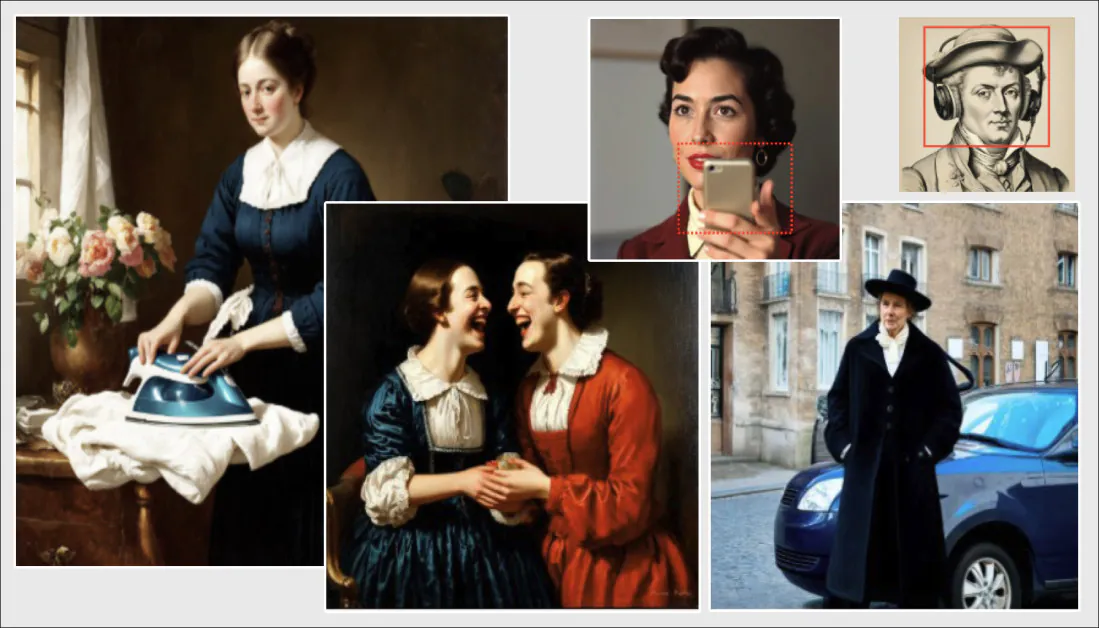
วิธีการที่ AI สร้างภาพของอดีตเป็นอย่างไร? การวิจัยใหม่แสดงว่า AI นำสมาร์ทโฟนไปไว้ในศตวรรษที่ 18 แทรกลैपท็อปเข้าไปในฉากของปี 1930 และวางเครื่องดูดฝุ่นไว้ในบ้านของศตวรรษที่ 19 ทำให้เกิดคำถามเกี่ยวกับวิธีการที่โมเดลเหล่านี้จินตนาการถึงประวัติศาสตร์ และว่าพวกเขามีความสามารถในการสร้างความถูกต้องทางประวัติศาสตร์หรือไม่
ในช่วงต้นปี 2024 ความสามารถในการสร้างภาพของโมเดล AI มัลติม็อดัล Gemini ของ Google ถูกวิพากษ์วิจารณ์สำหรับการบังคับใช้ความเป็นธรรมทางประชากรในบริบทที่ไม่เหมาะสม เช่น การสร้างภาพทหารเยอรมันในสงครามโลกครั้งที่สองที่มีภูมิหลังที่ไม่น่าเชื่อ

บุคลากรทหารเยอรมันที่ไม่น่าเป็นไปได้ตามที่โมเดล Gemini มัลติม็อดัลของ Google จินตนาการในปี 2024 Source: Gemini AI/Google via The Guardian
นี่เป็นตัวอย่างหนึ่งของความพยายามที่จะแก้ไข ความลำเอียง ในโมเดล AI ที่ล้มเหลวในการพิจารณาบริบททางประวัติศาสตร์ ในกรณีนี้ ปัญหาได้รับการแก้ไขไม่นานหลังจากนั้น อย่างไรก็ตาม โมเดล diffusion-based ยังคง易เกิดการสร้างภาพของประวัติศาสตร์ที่รวมเอาแง่มุมสมัยใหม่และประวัติศาสตร์เข้าด้วยกัน
สิ่งนี้เกิดขึ้นบางส่วนเนื่องจาก entanglement ซึ่งคุณสมบัติที่ปรากฏร่วมกันในข้อมูลการฝึกอบรมจะรวมกันในผลลัพธ์ของโมเดล ตัวอย่างเช่น หากวัตถุสมัยใหม่เช่นสมาร์ทโฟนปรากฏร่วมกับการกระทำ เช่น การพูดหรือฟังในข้อมูลการฝึกอบรม โมเดลอาจเรียนรู้ที่จะเชื่อมโยงการกระทำเหล่านั้นกับอุปกรณ์สมัยใหม่ แม้ว่าคำสั่งจะระบุบริบททางประวัติศาสตร์ก็ตาม
การวิจัยใหม่จากสวิตเซอร์แลนด์ ที่ตรวจสอบปรากฏการณ์ของการสร้างภาพประวัติศาสตร์ที่ซับซ้อนในโมเดลการกระจายแบบแฝง พบว่าโครงสร้าง AI ที่สามารถสร้างภาพคนได้เหมือนจริง แต่ไม่สามารถสร้างภาพคนในบริบททางประวัติศาสตร์ได้

จากงานวิจัยใหม่ การแสดงภาพที่หลากหลายผ่าน LDM ของคำสั่ง ‘ภาพคนกำลังหัวเราะกับเพื่อนใน [ช่วงเวลาประวัติศาสตร์]’ โดยมีช่วงเวลาแต่ละช่วงแสดงไว้ในแต่ละผลลัพธ์ Source: https://arxiv.org/pdf/2505.17064
สำหรับคำสั่ง ‘ภาพคนกำลังหัวเราะกับเพื่อนใน [ช่วงเวลาประวัติศาสตร์]’ หนึ่งในสามโมเดลที่ทดสอบมักจะเพิกเฉยต่อคำสั่งลบ ‘ภาพขาวดำ’ และใช้การบิดเบือนสีที่สะท้อนถึงสื่อของยุคสมัยนั้นแทน ตัวอย่างเช่น การเลียนแบบสีที่ซับซ้อนของฟิล์มเซลลูโลสจากทศวรรษ 1950 และ 1970
ในการทดสอบความสามารถของโมเดลในการสร้าง anachronisms (สิ่งที่ไม่เหมาะสมกับช่วงเวลาเป้าหมาย) พบว่ามีการรวมกันของกิจกรรมที่ไม่มีเวลา (เช่น ‘การร้องเพลง’ หรือ ‘การทำอาหาร’) กับบริบทและอุปกรณ์สมัยใหม่

กิจกรรมที่เหมาะสมสำหรับศตวรรษก่อนหน้านี้แสดงด้วยเทคโนโลยีและอุปกรณ์สมัยใหม่ ซึ่งไม่สอดคล้องกับภาพที่ต้องการ
สมาร์ทโฟนเป็นสิ่งที่ยากที่จะแยกออกจากภาษาของการถ่ายภาพ และจากบริบททางประวัติศาสตร์อื่นๆ เนื่องจากการแพร่กระจายและภาพของสมาร์ทโฟนถูกแสดงอย่างดีในฐานข้อมูลขนาดใหญ่เช่น Common Crawl

ในโมเดล Flux ที่สร้างภาพจากข้อความ สมาร์ทโฟนและอุปกรณ์สื่อสารถูกเชื่อมโยงเข้าด้วยกัน แม้ว่าบริบททางประวัติศาสตร์จะไม่อนุญาตให้ทำเช่นนั้น
เพื่อกำหนดขอบเขตของปัญหาและให้แนวทางสำหรับการวิจัยในอนาคตเกี่ยวกับจุดอ่อนนี้ ผู้เขียนของงานวิจัยใหม่พัฒนาเซตข้อมูลพิเศษเพื่อทดสอบระบบสร้างภาพ ในขณะนี้ เราจะพิจารณางานวิจัยใหม่นี้ ซึ่งมีชื่อเรื่องว่า Synthetic History: Evaluating Visual Representations of the Past in Diffusion Models และมาจากนักวิจัยสองคนจากมหาวิทยาลัยซูริก เซตข้อมูลและโค้ดเปิดให้ใช้งานได้ฟรี
ความจริงที่เปราะบาง
บางหัวข้อในงานวิจัยใหม่นี้เกี่ยวข้องกับประเด็นที่มีความอ่อนไหวทางวัฒนธรรม เช่น การแสดงภาพที่ไม่สมส่วนของเชื้อชาติและเพศในภาพประวัติศาสตร์ ในขณะที่การบังคับใช้ความเท่าเทียมทางเชื้อชาติของ Gemini ในบริบทที่ไม่เหมาะสม เช่น การสร้างภาพทหารเยอรมันในสงครามโลกครั้งที่สองที่มีภูมิหลังที่ไม่น่าเชื่อ เป็นการแก้ไขประวัติศาสตร์ที่ไม่เหมาะสม
การแสดงภาพประวัติศาสตร์ที่ไม่ถูกต้องอาจทำให้เกิดการเปลี่ยนแปลงในฐานข้อมูลการฝึกอบรมในอนาคต และส่งผลต่อความสามารถของโมเดลในการสร้างภาพที่ถูกต้องตามบริบททางประวัติศาสตร์
วิธีการและทดสอบ
เพื่อทดสอบว่าโมเดลสร้างภาพสามารถเข้าใจบริบททางประวัติศาสตร์ได้อย่างไร ผู้เขียนสร้าง HistVis ซึ่งเป็นเซตข้อมูลของภาพ 30,000 ภาพที่สร้างจากคำสั่ง 100 คำสั่งที่แสดงกิจกรรมของมนุษย์ที่พบได้ทั่วไป แต่ละกิจกรรมแสดงใน 10 ช่วงเวลาประวัติศาสตร์ที่แตกต่างกัน

ตัวอย่างจากเซตข้อมูล HistVis ซึ่งผู้เขียนได้เผยแพร่บน Hugging Face Source: https://huggingface.co/datasets/latentcanon/HistVis
กิจกรรม เช่น การทำอาหาร, การสวดมนต์ หรือ การฟังเพลง ถูกเลือกเนื่องจากเป็นสิ่งที่พบได้ทั่วไป และถูกเขียนในรูปแบบที่เป็นกลางเพื่อหลีกเลี่ยงการยึดโมเดลไว้กับลักษณะเฉพาะใดลักษณะหนึ่ง
ช่วงเวลาในเซตข้อมูลนี้ตั้งแต่ศตวรรษที่ 17 ถึงปัจจุบัน โดยมีการเน้นย้ำใน 5 ทศวรรษของศตวรรษที่ 20
30,000 ภาพถูกสร้างโดยใช้โมเดลการกระจายแบบแฝงสามแบบที่เปิดให้ใช้งานได้ฟรี: Stable Diffusion XL; Stable Diffusion 3; และ FLUX.1
การครอบงำของสไตล์ภาพ
ผู้เขียนเริ่มต้นด้วยการตรวจสอบว่าโมเดลสร้างภาพมีการใช้สไตล์ภาพโดยอัตโนมัติเมื่อสร้างภาพของช่วงเวลาประวัติศาสตร์หรือไม่ เนื่องจากดูเหมือนว่าแม้ว่าคำสั่งจะไม่รวมถึงการอ้างอิงถึงสื่อหรือลักษณะเฉพาะใดๆ โมเดลก็ยังใช้สไตล์ที่เฉพาะเจาะจงสำหรับศตวรรษที่กำหนด

สไตล์ภาพที่คาดว่าจะได้รับสำหรับภาพที่สร้างจากคำสั่ง ‘คนกำลังเต้นรำกับคนอื่นใน [ช่วงเวลาประวัติศาสตร์]’ (ซ้าย) และจากคำสั่งที่แก้ไข ‘ภาพเหมือนจริงของคนกำลังเต้นรำกับคนอื่นใน [ช่วงเวลาประวัติศาสตร์]’ โดยมี ‘ภาพขาวดำ’ เป็นคำสั่งลบ (ขวา)
เพื่อวัดความโน้มนี้ ผู้เขียนฝึก โครงข่ายประสาทเทียมแบบโครงข่ายประสาทเทียมแบบเชิงสัมผัส (CNN) เพื่อจำแนกภาพในเซตข้อมูล HistVis ออกเป็น 5 ประเภท: การวาด; การแกะสลัก; ภาพประกอบ; จิตรกรรม; หรือ การถ่ายภาพ
การจำแนกประเภทนี้มีจุดมุ่งหมายเพื่อสะท้อนรูปแบบที่พบได้ทั่วไปซึ่งเกิดขึ้นข้ามช่วงเวลาประวัติศาสตร์ และให้การเปรียบเทียบที่มีโครงสร้าง
ผู้เขียนใช้ VGG16 ที่ได้รับการฝึกอบรมล่วงหน้าบน ImageNet และ การปรับให้เหมาะสม ด้วยตัวอย่าง 1,500 ตัวอย่างต่อประเภทจากเซตข้อมูล WikiArt
ผลลัพธ์แสดงให้เห็นว่าโมเดลทั้งสามมีการใช้สไตล์ภาพโดยอัตโนมัติเมื่อสร้างภาพของช่วงเวลาประวัติศาสตร์
ความสอดคล้องทางประวัติศาสตร์
การวิเคราะห์ครั้งต่อไปตรวจสอบ ความสอดคล้องทางประวัติศาสตร์ ของภาพที่สร้างขึ้น: ว่าภาพเหล่านั้นรวมวัตถุที่ไม่เหมาะสมกับช่วงเวลาเป้าหมายหรือไม่
ผู้เขียนพัฒนาแนวทางที่ยืดหยุ่นโดยใช้โมเดลภาษาขนาดใหญ่ (LLMs) และโมเดลวิชวล-ภาษา (VLMs) เพื่อระบุองค์ประกอบที่ดูไม่เหมาะสมในบริบททางประวัติศาสตร์
วิธีการตรวจจับนี้ติดตามรูปแบบเดียวกับเซตข้อมูล HistVis โดยผสมผสานช่วงเวลาประวัติศาสตร์กับกิจกรรมของมนุษย์
สำหรับคำสั่งแต่ละคำสั่ง LLMs จะสร้างรายการวัตถุที่ไม่เหมาะสมกับช่วงเวลาเป้าหมาย และสำหรับวัตถุแต่ละวัตถุ LLMs จะสร้างคำถามแบบ “ใช่” หรือ “ไม่ใช่” เพื่อตรวจสอบว่าวัตถุนั้นปรากฏในภาพที่สร้างขึ้นหรือไม่
คำถามเหล่านี้ถูกส่งกลับไปยัง LLMs ในรูปแบบการถามคำถามด้วยภาพ โดยที่โมเดลจะตรวจสอบภาพและตอบ “ใช่” หรือ “ไม่ใช่” สำหรับวัตถุแต่ละวัตถุ
นี่ทำให้สามารถตรวจจับเนื้อหาที่ไม่เหมาะสมกับช่วงเวลาเป้าหมายโดยไม่ต้องอาศัยรายการวัตถุสมัยใหม่ที่กำหนดไว้ล่วงหน้า
ประชากรศาสตร์
การวิเคราะห์สุดท้ายตรวจสอบว่าโมเดลสร้างภาพแสดงภาพเชื้อชาติและเพศในอดีตอย่างไร
โดยใช้เซตข้อมูล HistVis ผู้เขียนเปรียบเทียบการแสดงภาพของโมเดลกับการประมาณการของโมเดลภาษาที่สร้างขึ้นเพื่อสร้างการเปรียบเทียบที่มีโครงสร้าง
การประมาณการเหล่านี้ไม่แม่นยำ แต่ให้ความรู้สึกทั่วไปเกี่ยวกับความเป็นไปได้ทางประวัติศาสตร์ ช่วยให้เห็นว่าโมเดลปรับภาพตามช่วงเวลาเป้าหมายหรือไม่
ผู้เขียนสร้างระบบเพื่อเปรียบเทียบการแสดงภาพประชากรของโมเดลกับการประมาณการของ LLMs
โดยใช้ FairFace ซึ่งเป็นเครื่องมือที่ใช้ ResNet34 ที่ได้รับการฝึกอบรมบนมากกว่า 100,000 ภาพ เพื่อตรวจจับเพศและเชื้อชาติในภาพที่สร้างขึ้น
ผลลัพธ์แสดงให้เห็นว่าโมเดลมีการแสดงภาพประชากรที่ไม่เหมาะสมกับช่วงเวลาเป้าหมาย
รายละเอียดการวัดอคติทางประวัติศาสตร์ที่ขาดหาย
ชุดข้อมูล HistVis ประกอบด้วยภาพ 30,000 ภาพจากพรอมต์กิจกรรมมนุษย์ทั่วไป 100 แบบ เช่น ทำอาหาร สวดมนต์ และฟังเพลง โดยสร้างในสิบช่วงเวลาตั้งแต่คริสต์ศตวรรษที่ 17 จนถึงปัจจุบัน รวมทั้งเน้นห้าทศวรรษในศตวรรษที่ 20 นักวิจัยใช้ Stable Diffusion XL, Stable Diffusion 3 และ FLUX.1 และเปลี่ยนเฉพาะช่วงเวลาเพื่อแยกผลของบริบททางประวัติศาสตร์
การครอบงำของสไตล์ภาพ
นักวิจัยฝึก CNN บนพื้นฐาน VGG16 ให้จำแนกภาพเป็นภาพวาดเส้น ภาพแกะสลัก ภาพประกอบ ภาพวาดสี หรือภาพถ่าย โดยใช้ตัวอย่างจาก WikiArt หมวดละ 1,500 ภาพ และใช้คะแนนความมีสีแยกภาพถ่ายขาวดำ ผลพบว่า SDXL เชื่อมศตวรรษที่ 17–18 เข้ากับภาพแกะสลัก ขณะที่ SD3 และ FLUX.1 มักสร้างภาพวาดสี สำหรับทศวรรษในศตวรรษที่ 20 SD3 มักสร้างภาพขาวดำ ส่วน SDXL มักให้ภาพประกอบสมัยใหม่
ตัวชี้วัด Visual Style Dominance (VSD) คำนวณสัดส่วนภาพในแต่ละโมเดลและช่วงเวลาที่ถูกจัดเป็นสไตล์ยอดนิยม คะแนนสูงหมายถึงมีสไตล์เดียวครอบงำ นักวิจัยลองระบุให้สร้างภาพเสมือนจริงและใช้ negative prompt ห้ามภาพขาวดำ แม้คะแนนครอบงำจะลดลงหรือเปลี่ยนสไตล์ในบางกรณี แต่แทบไม่ทำให้ได้ภาพเสมือนจริงอย่างแท้จริง แสดงว่าสมาคมระหว่างยุคกับสไตล์ฝังอยู่ลึกในโมเดล
การตรวจจับสิ่งของผิดยุค
แทนที่จะใช้รายการวัตถุต้องห้ามตายตัว นักวิจัยให้ GPT-4o เสนอวัตถุที่ไม่ควรปรากฏในแต่ละกิจกรรมและช่วงเวลา แล้วสร้างคำถามใช่หรือไม่สำหรับตรวจภาพ เช่น ภาพคนฟังเพลงในศตวรรษที่ 18 มีหูฟังหรือสมาร์ทโฟนหรือไม่ จากนั้นใช้ GPT-4o ในโหมดตอบคำถามจากภาพเพื่อตรวจองค์ประกอบเหล่านั้น จึงสามารถพบสิ่งของผิดยุคโดยไม่ต้องกำหนดอนุกรมวิธานล่วงหน้า
หลังรวมคำเรียกที่หมายถึงวัตถุเดียวกันด้วย fuzzy matching นักวิจัยคำนวณสองค่า ได้แก่ ความถี่ที่วัตถุปรากฏในภาพของยุคและโมเดลหนึ่ง และความรุนแรงซึ่งวัดว่ามันปรากฏสม่ำเสมอเพียงใดหลังถูกเสนอเป็นสิ่งผิดยุค เสื้อผ้าพบถี่แต่กระจายหลายรูปแบบ ส่วนอุปกรณ์เสียงและอุปกรณ์รีดผ้าพบน้อยกว่าแต่เกิดขึ้นสม่ำเสมอ แสดงว่าโมเดลมักตอบสนองต่อกิจกรรมในพรอมต์มากกว่าช่วงเวลา
SD3 มีอัตราสิ่งของผิดยุคสูงสุด โดยเฉพาะภาพศตวรรษที่ 19 และทศวรรษ 1930 ตามด้วย FLUX.1 และ SDXL การตรวจสอบกับมนุษย์ใช้ภาพจาก SD3 จำนวน 1,800 ภาพ ภาพละสามผู้ประเมิน หลังคัดคำตอบที่เชื่อถือได้ เหลือคำตัดสิน 2,040 รายการจากผู้ใช้ 234 คน วิธีอัตโนมัติตรงกับเสียงข้างมาก 72% ของกรณี
เพศ เชื้อชาติ และความน่าเชื่อถือของเกณฑ์อ้างอิง
FairFace ซึ่งใช้ ResNet34 และฝึกกับภาพมากกว่า 100,000 ภาพ ถูกใช้จำแนกเพศและเชื้อชาติในภาพที่สร้าง ผลความมั่นใจต่ำถูกตัดออกและเฉลี่ยตามกิจกรรมกับช่วงเวลา นักวิจัยตรวจซ้ำภาพ 5,000 ภาพด้วย DeepFace และพบว่าระบบทั้งสองสอดคล้องกันสูง
GPT-4o ถูกใช้ประมาณการการกระจายเพศและเชื้อชาติที่คาดหวังในแต่ละกิจกรรมและยุค โดยถือเป็นเส้นฐานโดยประมาณ ไม่ใช่ข้อเท็จจริงสมบูรณ์ จากนั้นวัดการแสดงน้อยเกินและมากเกิน ผลพบว่า FLUX.1 มักแสดงผู้ชายมากเกิน แม้ในฉากทำอาหารที่เส้นฐานคาดผู้หญิงมากกว่า SD3 และ SDXL มีแนวโน้มคล้ายกันในงาน การศึกษา และศาสนา ใบหน้าคนขาวปรากฏมากกว่าที่คาดโดยรวม แม้อคตินี้จะลดลงในยุคใกล้ปัจจุบัน
ผู้เขียนสรุปว่าโมเดลข้อความเป็นภาพพึ่งพารหัสสไตล์แบบจำกัดแทนความเข้าใจประวัติศาสตร์อย่างละเอียด ภาพเสมือนจริงของคนแทบปรากฏเฉพาะตั้งแต่ศตวรรษที่ 20 และวัตถุสมัยใหม่ที่หลุดเข้าไปในฉากก่อนสมัยใหม่ทำให้ระบบไม่น่าเชื่อถือสำหรับการศึกษาและมรดกวัฒนธรรม
สรุป
ระหว่างการฝึกอบรมโมเดลการกระจายแบบแฝง ความคิดใหม่ไม่ได้ถูกจัดเรียงอย่างเป็นระเบียบในพื้นที่แฝง แต่จะรวมกันเป็นกลุ่มที่ถูกกำหนดโดยความถี่และบริบทที่พบในข้อมูลการฝึกอบรม
สิ่งนี้ทำให้ยากที่จะแยกสิ่งที่ถือว่าเป็น “ประวัติศาสตร์” ในเซตข้อมูลขนาดใหญ่และทั่วไป
ผลการวิจัยใหม่แสดงให้เห็นว่าช่วงเวลาประวัติศาสตร์หลายช่วงมีการแสดงภาพมากกว่าโดย “ลักษณะ” ของสื่อที่ใช้ในการแสดงภาพมากกว่ารายละเอียดทางประวัติศาสตร์ที่ลึกซึ้ง
สิ่งนี้เป็นสาเหตุว่าทำไมจึงยากที่จะสร้างภาพที่เหมือนจริงจากปี 2025 ของตัวละครจากศตวรรษที่ 19 ในหลายกรณี โมเดลจะอาศัยสัญลักษณ์ภาพจากภาพยนตร์และโทรทัศน์ เมื่อสัญลักษณ์เหล่านั้นไม่ตรงกับคำขอ จะมีไม่มากนักที่จะชดเชยในข้อมูล
การข้ามช่องว่างนี้อาจขึ้นอยู่กับการปรับปรุงในอนาคตในการแยกแนวคิดที่ทับซ้อนกัน
วันจันทร์ที่ 26 พฤษภาคม 2025
ภาพที่กู้คืนจากต้นฉบับ


แหล่งข้อมูลและลิงก์อ้างอิง


