
มุมมองของ Anderson
GAN ในฐานะตัวเรนเดอร์ใบหน้าสำหรับ CGI แบบดั้งเดิม

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google

ประเด็นสำคัญการแยกอัตลักษณ์ออกจากการแสดงออกในพื้นที่แฝงของ GAN…
ดูเพิ่มเติม
- การแยกอัตลักษณ์ออกจากการแสดงออกในพื้นที่แฝงของ GAN ยังคงเป็นความท้าทายหลักที่ยังไม่ได้รับการแก้ไขสำหรับการสังเคราะห์วิดีโอใบหน้า
- โมเดล CGI แบบพารามิเตอร์ เช่น SMPL และ 3DMM ถูกนำมาใช้มากขึ้นเพื่อสร้างระเบียบให้กับรหัสแฝงที่ควบคุมไม่ได้ของ GAN
- แนวทางแบบผสมผสานของดิสนีย์ที่ชื่อ Rendering with Style ให้ผลลัพธ์ที่ดูไม่เป็นธรรมชาติโดยการรวมแผนที่พื้นผิวแบบดั้งเดิมเข้ากับภาพที่สร้างโดย GAN
บทความแสดงความคิดเห็น เมื่อ Generative Adversarial Networks (GAN) แสดงความสามารถเป็นครั้งแรกในการสร้างใบหน้า 3 มิติที่ดู สมจริง อย่างน่าทึ่ง ก็เกิดการแสวงหาศักยภาพที่ยังไม่ได้ใช้ของ GAN ในการสร้างวิดีโอใบหน้ามนุษย์ที่มีความต่อเนื่องสอดคล้องกันตามเวลา
ดูเหมือนว่า ณ ที่ใดสักแห่งในปริภูมิแฝงของ GAN จะต้อง มีระเบียบและเหตุผลซ่อนอยู่ เป็นโครงสร้างตรรกะเชิงความหมายที่เริ่มก่อตัวภายในรหัสแฝง ซึ่งทำให้ GAN สร้างหลายมุมมองและหลายรูปแบบ เช่น การเปลี่ยนสีหน้า ของใบหน้าเดียวกัน ได้อย่างสอดคล้องกัน และนำไปสู่วิธีสร้างวิดีโอ deepfake ที่น่าเชื่อถือในเชิงเวลาและเหนือกว่าออโตเอนโคเดอร์อย่างมาก
การสร้างผลลัพธ์ความละเอียดสูงน่าจะเป็นเรื่องง่าย เมื่อเทียบกับสภาพการทำงานความละเอียดต่ำที่ข้อจำกัด GPU บังคับให้ DeepFaceLab และ FaceSwap ต้องใช้ ส่วน “พื้นที่สลับใบหน้า” ในกระบวนการออโตเอนโคเดอร์จะกลายเป็น “พื้นที่สร้างใบหน้า” ของ GAN ซึ่งอาศัยภาพอินพุตเพียงไม่กี่ภาพ หรือแม้แต่ภาพเดียว
จะไม่มีความไม่ตรงกันระหว่างใบหน้าที่นำมาสลับกับใบหน้าในภาพต้นทางอีก เพราะภาพทั้งหมด จะถูกสร้างขึ้นใหม่ตั้งแต่ต้น รวมถึงเส้นผม แนวขากรรไกร และขอบนอกสุดขององค์ประกอบใบหน้า ซึ่งมักสร้างความท้าทายให้ deepfake แบบออโตเอนโคเดอร์ดั้งเดิม
ฤดูหนาวของวิดีโอใบหน้าจาก GAN
ปรากฏว่าเรื่องนี้ไม่ได้ง่ายเช่นนั้น ในที่สุด การแยกปัจจัยออกจากกัน กลายเป็นปัญหาหลักและยังเป็นความท้าทายสำคัญ เราจะคงอัตลักษณ์ใบหน้าไว้พร้อมเปลี่ยนท่าทางหรือสีหน้าได้อย่างไร โดยไม่รวบรวมภาพอ้างอิงนับพันภาพเพื่อสอนโครงข่ายประสาทว่าจะเกิดอะไรเมื่อเปลี่ยนสิ่งเหล่านี้ เหมือนที่ระบบออโตเอนโคเดอร์ต้องทำอย่างยากลำบาก?
แนวคิดต่อมาในการวิจัยการถ่ายทอดการเคลื่อนไหวและสังเคราะห์ใบหน้าด้วย GAN คืออาจปรับเปลี่ยนอัตลักษณ์อินพุตด้วยการแปลงที่มีเป้าหมาย ใช้ได้ทั่วไป และอิงแม่แบบ โดยไม่จำเพาะต่ออัตลักษณ์ เช่น การใส่สีหน้าให้ใบหน้า GAN ทั้งที่สีหน้านั้นไม่ปรากฏในภาพใดของบุคคลดังกล่าวที่ GAN เคยรู้จัก

จากงานวิจัยปี 2022 Tensor-based Emotion Editing in the StyleGAN Latent Space: นำสีหน้าอิงแม่แบบมาใช้กับใบหน้าอินพุตจากชุดข้อมูล FFHQ ที่มา: https://arxiv.org/pdf/2205.06102.pdf
เห็นได้ชัดว่าวิธีแบบเดียวใช้กับทุกคนไม่อาจครอบคลุมความหลากหลายของสีหน้าที่เป็นเอกลักษณ์เฉพาะบุคคล เราจึงต้องสงสัยว่ารอยยิ้มเฉพาะตัวอย่างของ Jack Nicholson หรือ Willem Dafoe จะถูกตีความอย่างเที่ยงตรงได้หรือไม่ ภายใต้อิทธิพลของรหัสแฝงสำหรับ “สีหน้าเฉลี่ย” เหล่านี้

ชายแปลกหน้าชาวลาตินผู้มีเสน่ห์คนนี้คือใคร? แม้ GAN สร้างใบหน้าที่ดู “สมจริง” และมีความละเอียดสูงกว่า แต่การเปลี่ยนแปลงไม่ได้อาศัยภาพจริงหลายภาพของนักแสดงเหมือน DeepFaceLab ซึ่งฝึกอย่างเข้มข้นบนฐานข้อมูลนับพันภาพ จึงทำให้ความคล้ายคลึงลดลง ที่พื้นหลังนี้ โมเดล DeepFaceLab ถูกนำเข้า DeepFaceLive ซึ่งเป็นการใช้งานแบบสตรีมมิงของซอฟต์แวร์ยอดนิยมและเป็นที่ถกเถียงดังกล่าว ตัวอย่างจาก https://www.youtube.com/watch?v=9tr35y-yQRY (2022) และ https://arxiv.org/pdf/2205.06102.pdf.
ช่วงหลายปีที่ผ่านมา มีการเสนอเครื่องมือแก้ไขสีหน้า GAN หลายตัว ส่วนใหญ่ ทำงานกับอัตลักษณ์ที่ไม่เป็นที่รู้จัก ทำให้ผู้อ่านทั่วไปไม่อาจประเมินความเที่ยงตรงของการแปลงได้ เพราะใบหน้าเหล่านั้นไม่คุ้นเคย

อัตลักษณ์ที่ไม่เป็นที่รู้จักถูกแปลงด้วย Cascade-EF-GAN ซึ่งนำเสนอในปี 2020 ที่มา: https://arxiv.org/pdf/2003.05905.pdf
เครื่องมือแก้ไขใบหน้า GAN ที่ได้รับความสนใจและการอ้างอิงมากที่สุดในช่วงสามปีที่ผ่านมาอาจเป็น InterFaceGAN ซึ่งเดินทางผ่านปริภูมิแฝงโดยใช้รหัสที่สัมพันธ์กับท่าทางหรือมุมกล้องและใบหน้า สีหน้า อายุ เชื้อชาติ เพศ และคุณสมบัติสำคัญอื่น ๆ
ความสามารถ “morphing” แบบยุค 1980 ของ InterFaceGAN และกรอบการทำงานคล้ายกัน มีไว้แสดงเส้นทางการแปลงเป็นหลัก เมื่อฉายภาพกลับผ่านรหัสแฝงที่เหมาะสม เช่น อายุ แต่สำหรับการสร้างวิดีโอที่ต่อเนื่องตามเวลา วิธีเหล่านี้ยังเป็น “หายนะที่น่าประทับใจ”
เมื่อรวมกับความยากในการสร้างเส้นผมที่สอดคล้องกันตามเวลา และการที่การสำรวจหรือปรับรหัสแฝงไม่มีแนวทางด้านเวลาโดยกำเนิด ก็อาจสรุปได้ว่า GAN ไม่ใช่ทุกสิ่งที่คุณต้องการ™ สำหรับการสังเคราะห์วิดีโอใบหน้า ทั้งยังยากที่จะรู้ว่าจะใส่แนวทางดังกล่าวในกรอบที่ออกแบบมารองรับและสร้างภาพนิ่ง โดยไม่มีระบบเอาต์พุตวิดีโอในตัวได้อย่างไร
ความพยายามต่อมาจึงนำมาซึ่ง การปรับปรุงทีละขั้น ด้านการแยกปัจจัย ขณะที่บางงานเพิ่มแนวทางอื่นจากคอมพิวเตอร์วิทัศน์เป็น “ชั้นนำทาง” เช่น การใช้การแบ่งส่วนเชิงความหมายเป็นกลไกควบคุมในงานวิจัย SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing ช่วงปลายปี 2021
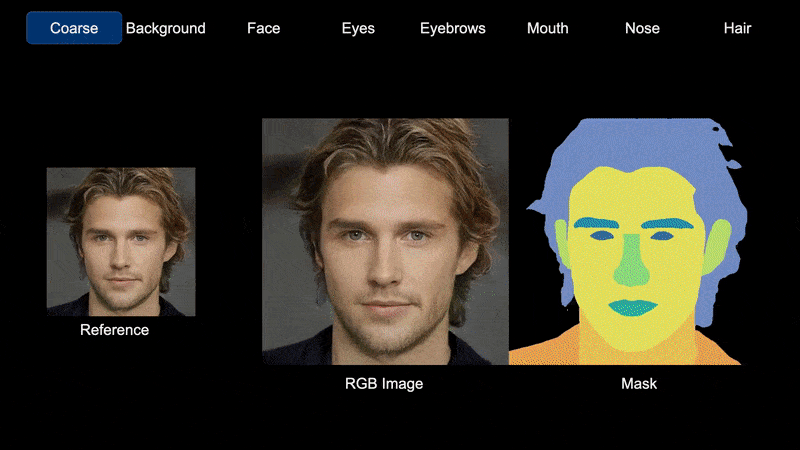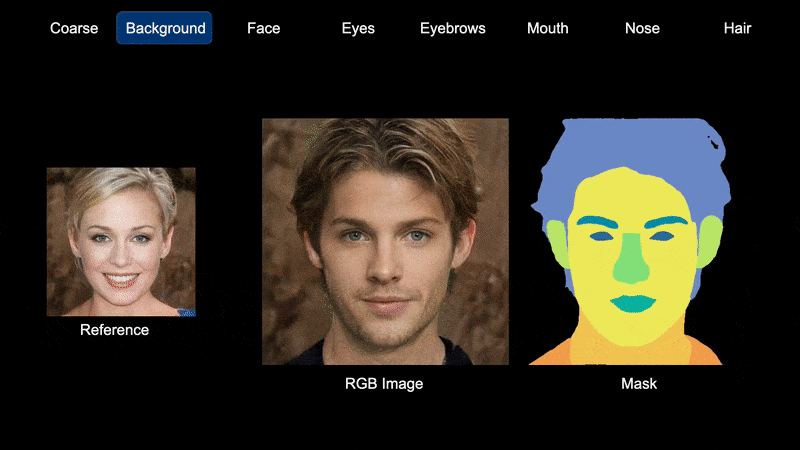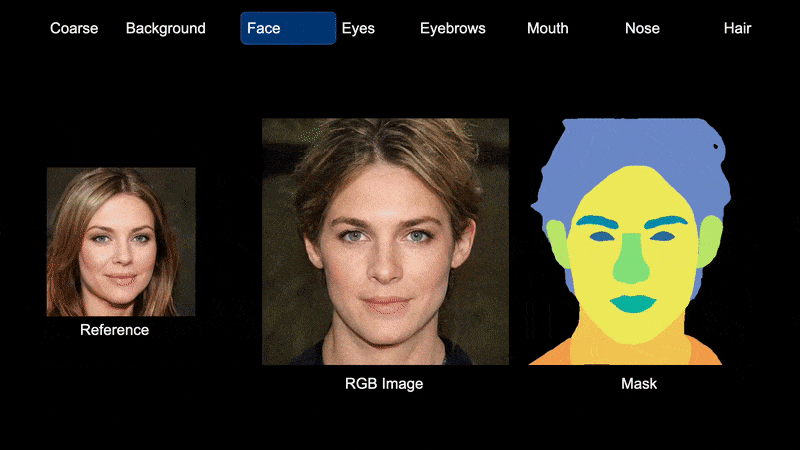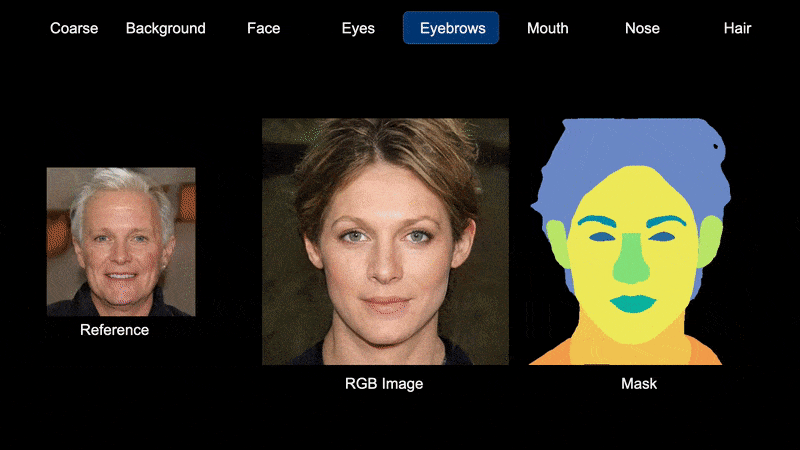
การแบ่งส่วนเชิงความหมายเป็นวิธีควบคุมปริภูมิแฝงใน SemanticStyleGAN ที่มา: https://semanticstylegan.github.io/
การนำทางด้วยพารามิเตอร์
ชุมชนวิจัยการสังเคราะห์ใบหน้า GAN หันมาใช้ใบหน้า CGI แบบพาราเมตริกดั้งเดิมมากขึ้น เพื่อชี้นำและจัดระเบียบรหัสแฝงที่ทรงพลังแต่ควบคุมยากในปริภูมิแฝงของ GAN
แม้รูปทรงพื้นฐานของใบหน้าแบบพาราเมตริกเป็นองค์ประกอบหลักของงานวิจัยคอมพิวเตอร์วิทัศน์มากว่ายี่สิบปีแล้ว แต่ความสนใจเพิ่งเพิ่มขึ้นพร้อมกับการใช้รูปทรง CGI จาก Skinned Multi-Person Linear Model (SMPL) มากขึ้น แนวทางนี้ริเริ่มโดยสถาบัน Max Planck และ ILM และต่อมาพัฒนาด้วยกรอบ Sparse Trained Articulated Human Body Regressor (STAR)

SMPL ซึ่งในกรณีนี้เป็นรุ่นที่เรียกว่า SMPL-X สามารถวางตาข่าย CGI แบบพาราเมตริกให้ตรงกับท่าทางที่ประเมินของร่างกายมนุษย์ทั้งหมดในภาพ รวมถึงสีหน้าเมื่อจำเป็น ทำให้ดำเนินการใหม่กับภาพได้ โดยใช้ตาข่ายเป็นแนวทางเชิงปริมาตรหรือการรับรู้ ที่มา: https://arxiv.org/pdf/1904.05866.pdf
พัฒนาการที่ได้รับการยกย่องมากที่สุดในแนวทางนี้คือโครงการปี 2019 ของ Disney Rendering with Style ซึ่งรวมแผนที่พื้นผิวแบบดั้งเดิมกับภาพที่ GAN สร้าง เพื่อพยายามสร้างภาพเคลื่อนไหวแบบ deepfake ที่ดีขึ้น

ของเก่าพบของใหม่ในแนวทางผสมผสานของ Disney สำหรับ deepfake ที่สร้างโดย GAN ที่มา: https://www.youtube.com/watch?v=TwpLqTmvqVk
แนวทางของ Disney ใส่องค์ประกอบ CGI ที่เรนเดอร์แบบดั้งเดิมลงในเครือข่าย StyleGAN2 เพื่อเติมส่วนของใบหน้ามนุษย์ใน “พื้นที่ปัญหา” ที่ความสอดคล้องตามเวลาเป็นอุปสรรคต่อการสร้างวิดีโอ เช่น พื้นผิวของผิวหนัง

ขั้นตอนการทำงานของ Rendering with Style
หัว CGI แบบพาราเมตริกที่นำทางกระบวนการนี้ปรับเปลี่ยนตามความต้องการของผู้ใช้ได้ ใบหน้าที่ GAN สร้างจึงสะท้อนการเปลี่ยนแปลงนั้น รวมถึงท่าทางของศีรษะและสีหน้า
แม้ออกแบบมาให้รวมความควบคุมได้ของ CGI กับความสมจริงตามธรรมชาติของใบหน้า GAN แต่สุดท้ายผลลัพธ์กลับแสดงข้อเสียของทั้งสองด้าน และยังรักษาพื้นผิวเส้นผมหรือแม้แต่ตำแหน่งองค์ประกอบพื้นฐานของใบหน้าให้สอดคล้องกันไม่ได้:
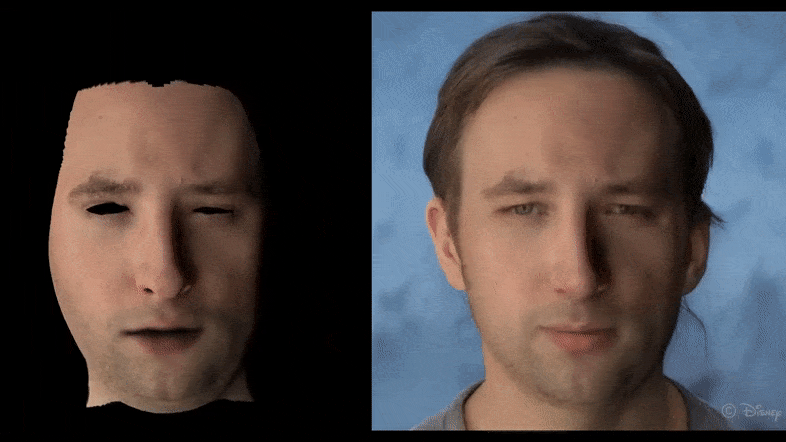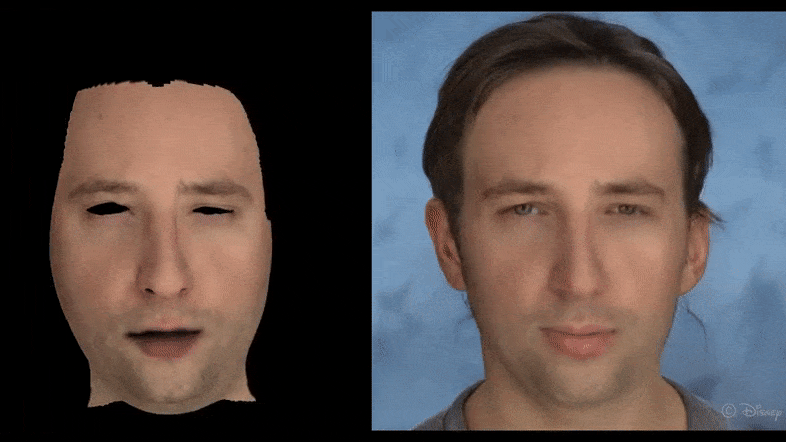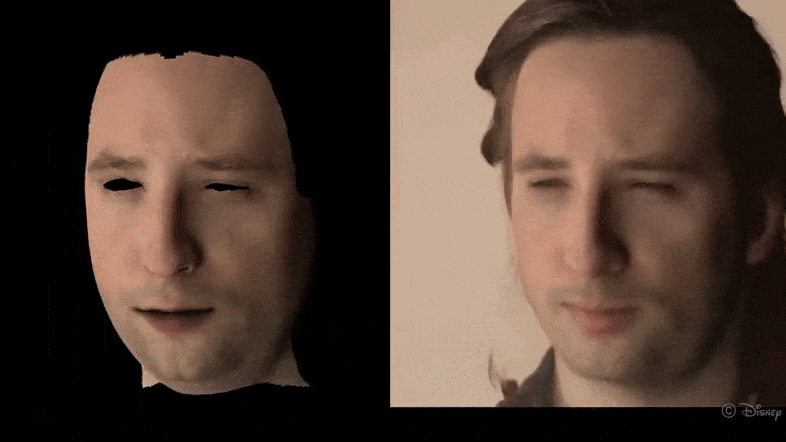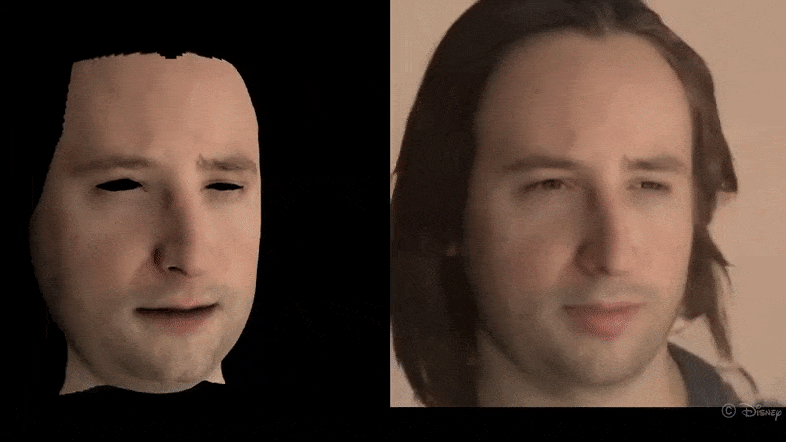
Rendering with Style ทำให้เกิดปรากฏการณ์ “หุบเขาแห่งความพิกล” แบบใหม่ แม้หลักการยังมีศักยภาพอยู่บ้าง
งานวิจัย StyleRig: Rigging StyleGAN for 3D Control over Portrait Images ในปี 2020 ใช้แนวทางที่ได้รับความนิยมมากขึ้น โดยใช้แบบจำลองใบหน้าสามมิติที่ปรับเปลี่ยนรูปทรงได้ (3DMM) เป็นตัวแทนเพื่อเปลี่ยนคุณสมบัติในสภาพแวดล้อม StyleGAN ผ่านเครือข่ายควบคุมใหม่ชื่อ RigNet:

แบบจำลอง 3DMM เป็นตัวแทนสำหรับตีความปริภูมิแฝงใน StyleRig ที่มา: https://arxiv.org/pdf/2004.00121.pdf
อย่างไรก็ตาม เช่นเดียวกับโครงการเหล่านี้ทั่วไป ผลลัพธ์ยังดูจำกัดอยู่ที่การปรับท่าทางเล็กน้อยและการเปลี่ยนสีหน้าหรืออารมณ์ที่ไม่ได้อาศัยข้อมูลเฉพาะของบุคคล

StyleRig เพิ่มระดับการควบคุม แต่เส้นผมที่สอดคล้องตามเวลายังเป็นความท้าทายที่ไม่คลี่คลาย ที่มา: https://www.youtube.com/watch?v=eaW_P85wQ9k
ผลลัพธ์คล้ายกันพบได้ใน MOST-GAN ของ Mitsubishi Research ซึ่งเป็นงานวิจัยปี 2021 ที่ใช้ 3DMM แบบไม่เชิงเส้นเป็นสถาปัตยกรรมแยกปัจจัย แต่ยังประสบความยากลำบากในการสร้างการเคลื่อนไหวที่พลวัตและสอดคล้องกัน
งานล่าสุดที่พยายามผสานการควบคุมกับการแยกปัจจัยคือ One-Shot Face Reenactment on Megapixels ซึ่งใช้หัวแบบพาราเมตริก 3DMM เป็นอินเทอร์เฟซที่ใช้ง่ายสำหรับ StyleGAN อีกครั้ง

ในขั้นตอน MegaFR ของ One-Shot Face Reenactment เครือข่ายสังเคราะห์ใบหน้าโดยรวมภาพจริงที่แปลงย้อนเข้าสู่ตัวแทนแฝงเข้ากับพารามิเตอร์ที่นำมาจากแบบจำลอง 3DMM ที่เรนเดอร์แล้ว ที่มา: https://arxiv.org/pdf/2205.13368.pdf
OSFR เป็นส่วนหนึ่งของเครื่องมือแก้ไขใบหน้า GAN ที่เพิ่มจำนวนขึ้นและพยายามสร้างกระบวนการแก้ไขแบบเชิงเส้นเหมือน Photoshop/After Effects ผู้ใช้ใส่ภาพที่ต้องการแล้วปรับเปลี่ยนภาพนั้น แทนการค้นหารหัสแฝงที่เกี่ยวกับอัตลักษณ์ในปริภูมิแฝง
เช่นเดิม สีหน้าแบบพาราเมตริกเป็นวิธีทั่วไปและไม่เฉพาะบุคคลในการใส่สีหน้า จึงนำไปสู่การเปลี่ยนแปลงที่ดูแปลกประหลาดในแบบของมันเองและไม่ใช่ในทางบวกเสมอไป

สีหน้าที่ใส่เข้าไปใน OSFR
เช่นเดียวกับงานก่อนหน้า OSFR อนุมานท่าทางใกล้เคียงต้นฉบับจากภาพเดียวได้ และทำ “frontalization” คือแปลงภาพใบหน้าที่หันออกจากแนวตรงให้เป็นภาพหน้าตรง:

ภาพต้นฉบับด้านบนและภาพหน้าตรงที่อนุมานจากหนึ่งในการใช้งาน OSFR ซึ่งอธิบายในงานวิจัยใหม่
ในทางปฏิบัติ การอนุมานนี้คล้ายหลักการโฟโตแกรมเมทรีบางส่วนที่เป็นพื้นฐานของ Neural Radiance Fields (NeRF) แต่ในกรณีนี้ต้องกำหนดเรขาคณิตจากภาพเดียว แทน 3–4 มุมมองที่ NeRF ใช้อนุมานท่าทางระหว่างมุมที่ขาดหายไปและสร้างฉากสามมิติเชิงประสาทที่มีมนุษย์และสำรวจได้
(อย่างไรก็ตาม NeRF ก็ไม่ใช่ทุกสิ่งที่คุณต้องการ™ เพราะอุปสรรคในการสังเคราะห์วิดีโอใบหน้าแทบจะ เป็นคนละชุดโดยสิ้นเชิง เมื่อเทียบกับ GAN)
GAN มีบทบาทในการสังเคราะห์วิดีโอใบหน้าหรือไม่?
การสร้างสีหน้าแบบพลวัตและท่าทางนอกการกระจายของข้อมูลฝึกจากภาพต้นทางเดียว ดูเป็นความหลงใหลคล้ายการเล่นแร่แปรธาตุของงานวิจัยใบหน้า GAN ในขณะนี้ เหตุผลหลักคือ GAN เป็นวิธีเดียวในปัจจุบันที่สร้างใบหน้าเชิงประสาทด้วยความละเอียดค่อนข้างสูงและความเที่ยงตรงค่อนข้างดีได้ แม้กรอบ deepfake แบบออโตเอนโคเดอร์ฝึกกับท่าทางและสีหน้าจริงได้หลากหลาย แต่ความละเอียดอินพุตและเอาต์พุตถูกจำกัดด้วย VRAM และต้องมีภาพ “โฮสต์” ส่วน NeRF ก็ถูกจำกัดในลักษณะคล้ายกัน อีกทั้งต่างจากอีกสองแนวทางตรงที่ยังไม่มีวิธีมาตรฐานในการเปลี่ยนสีหน้า และมีความสามารถแก้ไขจำกัดโดยทั่วไป
ดูเหมือนว่าทางไปต่อของระบบสังเคราะห์ใบหน้า CGI/GAN ที่แม่นยำคือหาแนวทางรวมอัตลักษณ์จากหลายภาพไว้ในปริภูมิแฝง เพื่อให้รหัสอัตลักษณ์ของบุคคลไม่ต้องเดินทางข้ามทั้งปริภูมิเพื่อใช้พารามิเตอร์ท่าทางที่ไม่เกี่ยวข้อง แต่ใช้อ้างอิงภาพจริงที่สัมพันธ์กับบุคคลนั้นสำหรับการเปลี่ยนแปลงได้
แม้ทำเช่นนั้นได้ หรือแม้ฝึก StyleGAN ทั้งเครือข่ายด้วยชุดใบหน้าของอัตลักษณ์เดียวเหมือนชุดฝึกของออโตเอนโคเดอร์ ก็ยังน่าจะต้องเติมตรรกะเชิงความหมายที่ขาดไปด้วยเทคโนโลยีเสริม เช่น การแบ่งส่วนเชิงความหมายหรือใบหน้า 3DMM แบบพาราเมตริก ซึ่งอย่างน้อยจะมีข้อมูลให้ใช้ทำงานมากขึ้นในกรณีดังกล่าว


