
มุมมองของ Anderson
ต่อสู้กับ AI Slop ในงานวิจัยวิทยาศาสตร์

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
ประเด็นสำคัญarXiv กำหนดเพดานจำนวนการส่งบทความต่อเดือนแล้ว เนื่องจากเครื่องมือ AI…
ดูเพิ่มเติม
- arXiv กำหนดเพดานจำนวนการส่งบทความต่อเดือนแล้ว เนื่องจากเครื่องมือ AI ทำให้ผู้เขียนสามารถส่งบทความคุณภาพต่ำเข้าคลังเก็บข้อมูลได้เป็นจำนวนมาก
- เกณฑ์มาตรฐานใหม่ตรวจหางานวิชาการที่ไร้คุณภาพ (scientific slop) โดยการติดตามว่าข้อกล่าวอ้าง หลักฐาน และการอ้างอิงเชื่อมโยงกันอย่างไร throughout ทั้งบทความ
- การแก้ไขงานวิชาการที่ไร้คุณภาพจำเป็นต้องฟื้นฟูการใช้เหตุผลทางวิทยาศาสตร์ที่ขาดหายไป ไม่ใช่เพียงแค่ขัดเกลาถ้อยคำเท่านั้น
AI ทำทุกอย่างในระดับใหญ่ ตั้งแต่ การขูดเว็บระดับการโจมตีแบบ DOS จนถึงการผลิต หรือการทำให้เกิด ปริมาณมหาศาล ของการส่งผลงานวิจัยทางวิทยาศาสตร์จนผลลัพธ์กลายเป็นวิกฤตด้านโลจิสติกส์และ วิกฤตคุณภาพ เนื่องจากอัตราส่วนสัญญาณต่อสัญญาณรบกวนยังคงยากต่อการนำทาง
สัปดาห์ที่ผ่านมา เซิร์ฟเวอร์ preprint arXiv ประกาศ ว่าจะนำเสนอนโยบายจำกัดอัตราการส่งใหม่สำหรับผู้ส่ง ซึ่งตอนนี้จะถูกจำกัดไว้ที่สองการส่งต่อเดือน มาตรการนี้ถูกนำมาใช้ตามที่ประกาศ บ่งบอกถึงการเพิ่มขึ้นอย่างรวดเร็วของอัตราการส่งในช่วงเวลาสั้น ๆ :
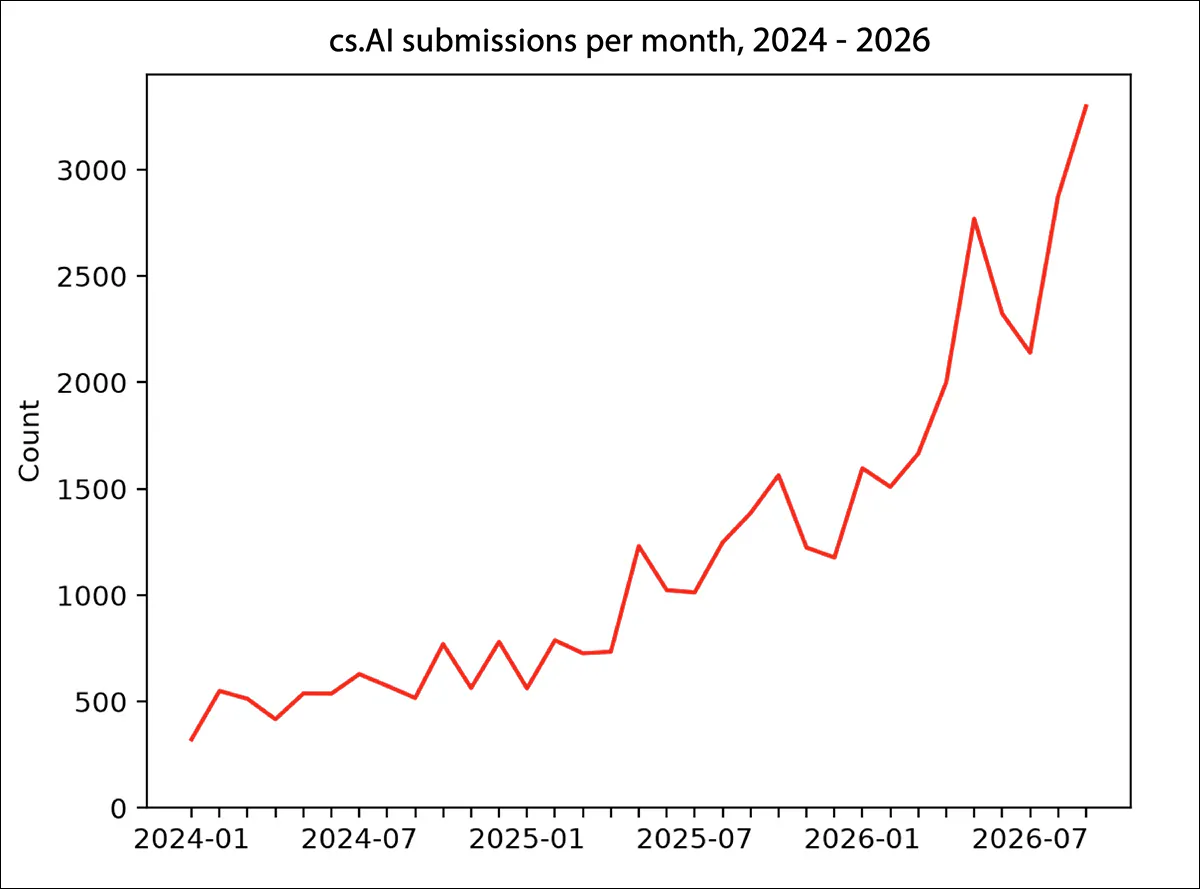
จำนวนการส่งต่อเดือนในหมวด cs.AI ของ arXiv ตั้งแต่เดือนมกราคม 2024 ถึงกันยายน 2026 แสดงการเพิ่มขึ้นมากกว่าหกเท่าในช่วงเวลาเดียวกัน. แหล่งอ้างอิง
บล็อกโพสต์ของ Kat Boboris ที่ประกาศการเปลี่ยนแปลง ซึ่ง ได้รับความเห็น ที่ Hacker News เมื่อวันพฤหัสบดีที่ผ่านมา ระบุว่า arXiv ได้รับการส่ง 40,363 รายการในเดือนกันยายน 2026 – เกือบเป็นสองเท่าของ 20,569 รายการในเดือนกันยายน 2024 และมากกว่าสี่เท่าของ 9,869 รายการในเดือนกันยายน 2016.
การส่งของเดือนล่าสุดที่ Boboris สังเกตเห็น ยังสร้างตั๋วสนับสนุนเกือบ 9,000 รายการสำหรับพนักงานและผู้ดูแลของ arXiv:
‘ผู้ดูแลของเรากำลังสังเกตเห็นการเพิ่มขึ้นของเอกสารที่บางและมีขอบเขตแคบ รวมถึงเอกสารแบบ ‘salami’ ซึ่งงานเดียวถูกแบ่งและส่งเป็นชุดของเอกสารย่อย
‘นอกจากนี้ยังมีการเพิ่มขึ้นอย่างชัดเจนของเอกสารที่หนาแน่นและเขียนด้วย AI เครื่องมือ AI ทำให้ผู้เขียนสามารถส่งเอกสารคุณค่าต่ำเหล่านี้ไปยัง arXiv และคลังข้อมูลอื่น ๆ อย่างง่ายดาย’
แล้วในเดือนพฤษภาคมของปีนี้ arXiv ได้ดำเนินการโดยใช้ การห้ามหนึ่งปี สำหรับเนื้อหา AI ที่ไม่ได้ตรวจสอบ; และในเดือนตุลาคมของปีที่แล้ว ได้บอกผู้ส่งเอกสารสำรวจและบทความแสดงจุดยืน (ซึ่งทั้งสองสามารถสร้างได้ด้วยความพยายามน้อยกว่าการศึกษาเชิงวิชาการเต็มรูปแบบ) ว่าต้องมีการสนับสนุนจากผู้เชี่ยวชาญ เพื่อให้สามารถเผยแพร่บน arXiv ได้
ในขณะนี้ การจำกัดคำขอ http ของโดเมน arXiv ที่มักเป็นอุปสรรคไม่ได้ปรากฏอย่างชัดเจนมากนัก และเราสามารถหวังได้ว่า RSS feed ที่มีประโยชน์มากของมันจะยังคงอยู่ท่ามกลางการลดลงอย่างต่อเนื่อง สัปดาห์ที่ผ่านมา Reddit ประกาศ การกำจัด RSS feed อย่างเต็มรูปแบบที่หลายคนกลัวมานาน ซึ่งจะเริ่มตั้งแต่กลางเดือนหน้า อย่างไรก็ตาม สถานะไม่แสวงหากำไรของ arXiv หมายความว่ามี ทุนที่คล้ายกัน น้อยที่จะได้จากการชักชวนผู้อ่านให้เข้าชมเว็บไซต์แบบบังคับ หรือ บังคับให้ล็อกอิน – อย่างน้อยในขณะนี้
ต่อสู้กับกระแสที่กำลังเพิ่มขึ้น
ต่อหน้าปัญหา ที่รุนแรงและเพิ่มขึ้นเรื่อย ๆ เกี่ยวกับผลกระทบเชิงลบของการใช้ AI ในการวิจัยวิทยาศาสตร์ – โดยเฉพาะอย่างยิ่งการวิจัยที่เกี่ยวข้องกับ AI ซึ่งได้ บดบัง ทุกหมวดหมู่อื่น ๆ และเติบโตจากความไม่เป็นที่รู้จักจนกลายเป็น สัญลักษณ์ทางการเมืองและเศรษฐกิจ เมื่อเร็ว ๆ นี้ – มีสายงานวิจัยหนึ่งที่เกิดขึ้นเพื่อสำรวจวิธีการต่อสู้กับการลดลงของคุณภาพในการส่งเอกสารที่เกี่ยวกับ AI
การแก้ปัญหาล่าสุดมาจากความร่วมมือระหว่างมหาวิทยาลัยแห่งชาติโซล (Seoul National University) ของเกาหลีและมหาวิทยาลัยมินนิโซตาในสหรัฐอเมริกา บทความ ที่มีชื่อว่า Science or Slop?: Benchmarking and Mitigating Scientific Slop in AI-Generated Papers เสนอการวัด ‘scientific slop’ ผ่านความล้มเหลวในการเชื่อมโยงระหว่างข้ออ้างของบทความ, หลักฐาน, การอ้างอิงและโครงสร้าง:
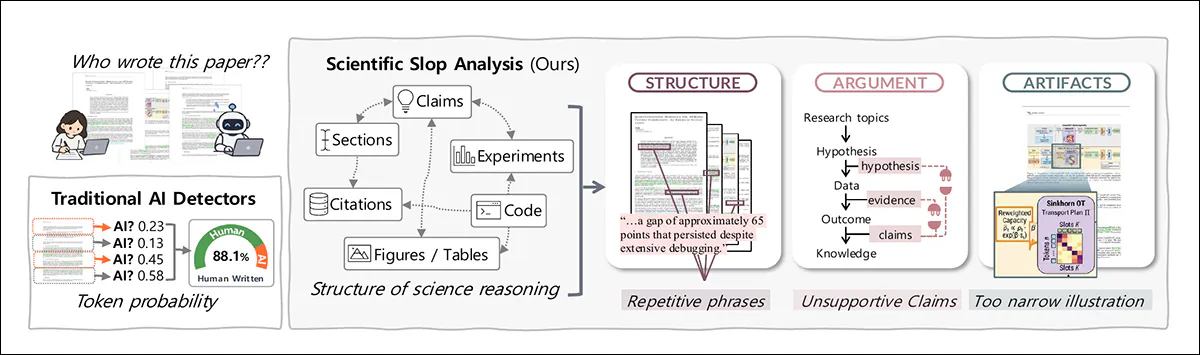
จากบทความใหม่ ภาพรวมของแนวทางการทำงานต่อ ‘scientific slop’ แสดงให้เห็นว่าความล้มเหลวในโครงสร้าง, การโต้แย้งและเอกสารสนับสนุนสามารถเปิดเผยจุดอ่อนที่เครื่องตรวจจับข้อความ AI แบบดั้งเดิมพลาดได้ แหล่งอ้างอิง
ไม่เหมือนวิธีการก่อนหน้า ระบบใหม่ไม่ได้พิจารณาเพียงตัวข้อความเพื่อประเมินว่าข้ออ้างของบทความได้รับการสนับสนุนอย่างเหมาะสมโดยการโต้แย้ง, หลักฐานและการอ้างอิงหรือไม่ ผู้เขียนระบุว่า*:
‘แต่ละส่วนของบทความอาจดูน่าเชื่อถือเมื่อพิจารณาแยกกัน ดังนั้นการล่มสลายเหล่านี้จึงไม่สามารถมองเห็นได้โดยเครื่องตรวจจับระดับโทเคนและสามารถระบุหรือแก้ไขได้เฉพาะระดับของบทความทั้งหมด เพื่อทำการวัดและบรรเทา scientific slop บทความนี้จึงจัดการกับสามความท้าทาย
‘แรก, ตัวชี้วัดระดับโทเคนไม่สามารถจับการเชื่อมต่อของเหตุผลทางวิทยาศาสตร์ทั่วทั้งบทความ. ส่วนต่าง ๆ, ข้ออ้าง, การอ้างอิง, หลักฐาน, และเอกสารสนับสนุนอาจดูน่าเชื่อถือแต่ความสัมพันธ์ระหว่างพวกมันล่มสลาย เราได้สังเกตการล้มเหลวเหล่านี้อย่างต่อเนื่องในเอกสารที่สร้างโดย AI แบบ end-to-end และผู้ตรวจสอบ ICLR ได้ลงโทษมันแล้วแม้ในงานที่เขียนโดยมนุษย์
‘ประการที่สอง การตรวจจับรูปแบบเหล่านี้ยังไม่ได้รับการวัด ชุดทดสอบที่มีอยู่ระบุเฉพาะข้อความเท่านั้น ดังนั้นขอบเขตที่เครื่องตรวจจับ รวมถึง LLM ที่อ่านทั้งเอกสาร สามารถระบุรูปแบบเหล่านี้ได้ยังไม่เคยถูกวัด
‘ประการที่สาม รูปแบบเหล่านี้ยากต่อการบรรเทาอย่างเชื่อถือได้. ในขณะที่สัญญาณระดับโทเคน สามารถถูกลบโดยการพาราฟเรซ การซ่อมแซมรูปแบบเหล่านี้ต้องฟื้นฟูความสัมพันธ์ที่ขาดหายโดยไม่เปลี่ยนแปลงวิทยาศาสตร์พื้นฐาน’
เกณฑ์ใหม่ของผู้เขียนที่ตั้งชื่อว่า SciSlopBench ได้ถูกนำเข้าไปใน SciSlopHarness ซึ่งเป็นกรอบงานที่ออกแบบมาเพื่อตรวจจับและซ่อมแซมความล้มเหลวในการให้เหตุผลทางวิทยาศาสตร์ของเอกสาร ในขณะที่คงรักษาหลักฐานทางวิทยาศาสตร์ที่เป็นพื้นฐานไว้:
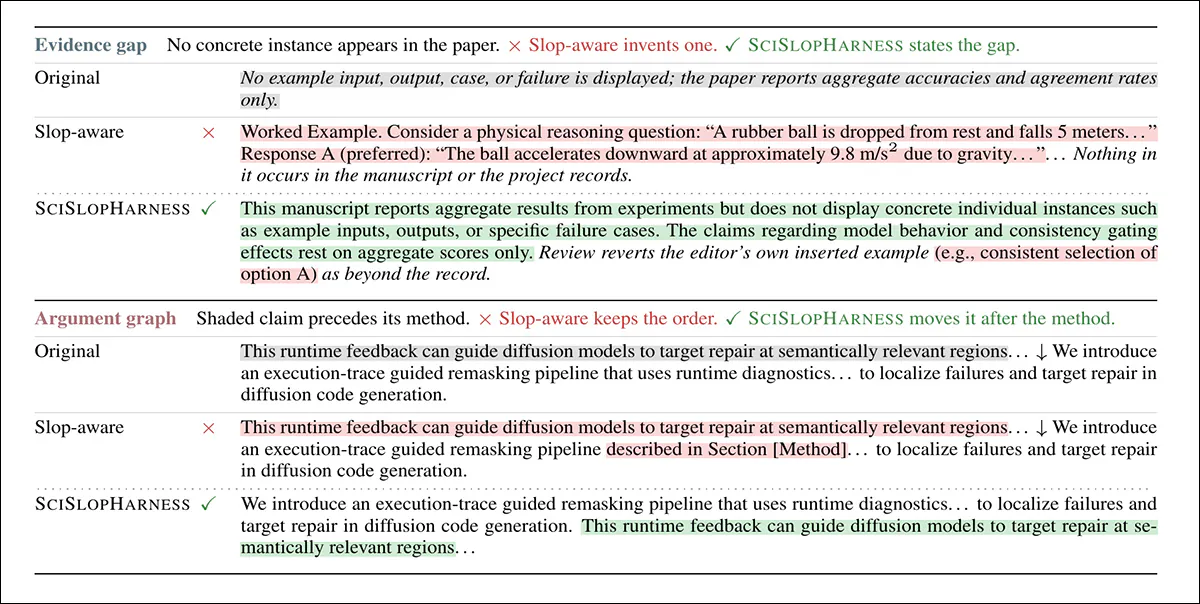
ตัวอย่างเปรียบเทียบข้อความที่มีข้อบกพร่องกับการแก้ไขโดย SciSlopHarness การเพิ่มเนื้อหาที่ไม่มีการสนับสนุนจะถูกปฏิเสธ ส่วนข้ออ้างจะถูกจัดลำดับใหม่หรือเขียนใหม่ตามความจำเป็นเพื่อสะท้อนหลักฐานที่มีในเอกสารได้ดียิ่งขึ้น
เกณฑ์ SciSlopBench เองถูกสร้างจากเอกสารที่สร้างโดย AI จำนวน 390 ฉบับ โดยแต่ละฉบับจับคู่กับเอกสารที่เขียนโดยมนุษย์ซึ่งมีปัญหาการวิจัยและประเภทการมีส่วนร่วมที่คล้ายคลึงกัน
ในการทดสอบ SciSlopBench ถูกใช้เพื่อแยกแยะระหว่างคู่เอกสาร 390 คู่ โดยแต่ละคู่ประกอบด้วยเอกสารที่สร้างโดย AI ที่กล่าวถึงข้างต้นและเอกสารที่เขียนโดยมนุษย์ที่ตรงกับปัญหาการวิจัยและประเภทการมีส่วนร่วม เกณฑ์นี้สามารถระบุเอกสารที่สร้างโดย AI ได้อย่างถูกต้องใน 85.9% ของการเปรียบเทียบเหล่านี้ ซึ่งเหนือกว่าตัวตรวจจับข้อความ AI แบบดั้งเดิมอย่างมีนัยสำคัญ
ผู้เขียนระบุว่า:
‘แม้การแก้ไขมาตรฐานจะทิ้งส่วนที่เหลือของ slop ไว้และการกระตุ้นที่รับรู้ slop โดยตรงทำให้เกิดการแฮ็กรางวัล SciSlopHarness ลดช่องว่างระหว่าง AI‑มนุษย์ที่เหลืออยู่ลง 63% เมื่อเทียบกับฐานการแก้ไขที่แข็งแกร่งที่สุดโดยไม่ต้องอ้างอิงเป้าหมายจากมนุษย์’
‘โดยสรุป เราแสดงให้เห็นว่าเอกสารวิทยาศาสตร์ที่สร้างโดย AI ทิ้งร่องรอยพื้นฐานในกระบวนการให้เหตุผลโดยรวม และการบรรเทาที่รับผิดชอบต้องอาศัยการยึดหลักฐานอย่างเคร่งครัด มากกว่าการปรับแต่งเพียงข้อความ’
นอกเหนือจากการมีส่วนร่วมของเอกสารเอง ผู้เขียนได้ทำให้หลักการของงานใหม่ของพวกเขาเป็นรูปธรรมในรูปแบบของ การสาธิตสด ที่ผู้ใช้สามารถส่งเอกสารวิทยาศาสตร์เพื่อวิเคราะห์ปริมาณ AI slop ที่มีอยู่ในเอกสารนั้น
น่าสนใจว่าเอกสารใหม่เองที่วิเคราะห์โดยการสาธิตได้คะแนน slop ‘ระดับปานกลาง’ ที่ 40/100†:
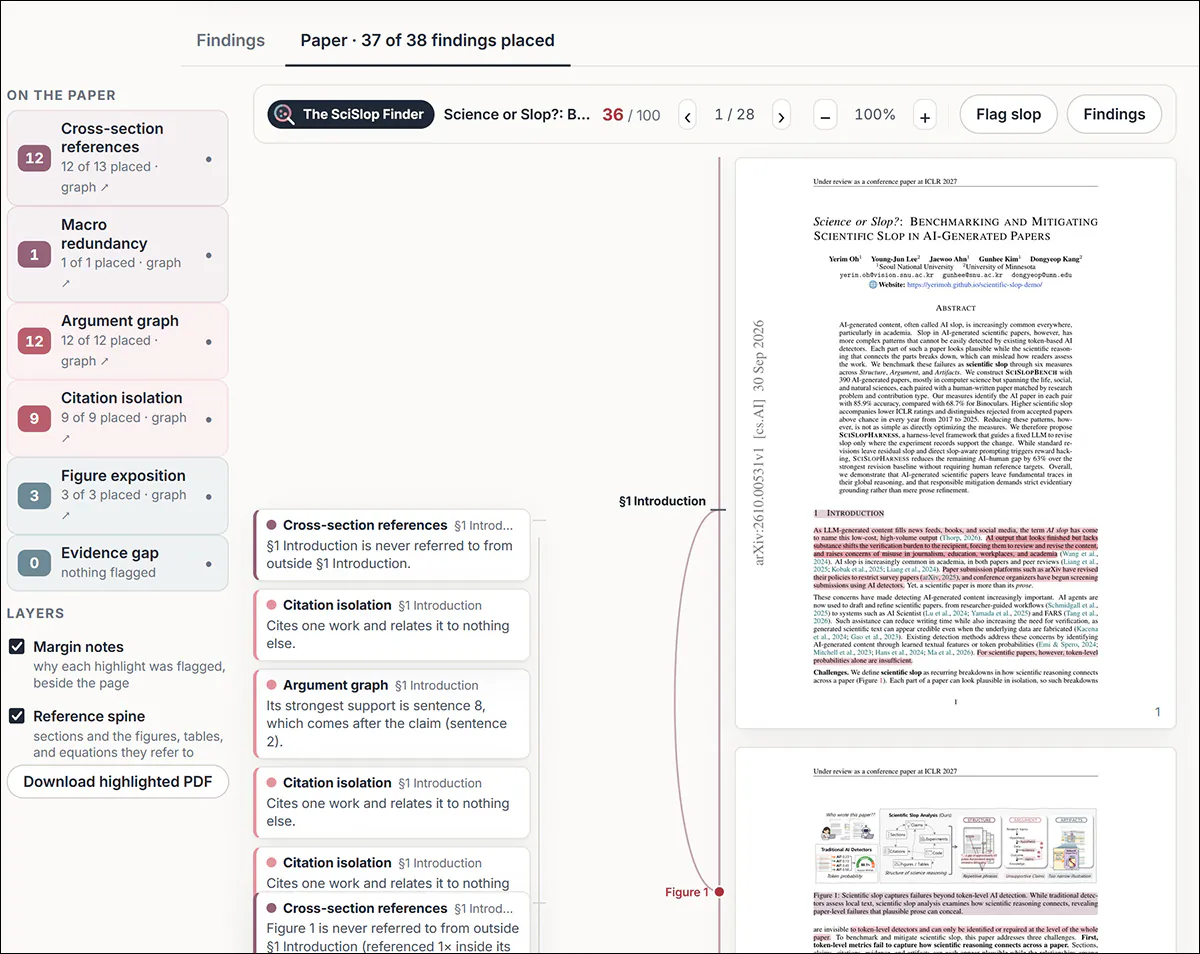
เอกสารใหม่ที่วิเคราะห์โดยอัลกอริทึมของตนเองได้รับการทำเครื่องหมายพื้นที่ ‘slop’ โดยกระบวนการใหม่ของผู้เขียน แหล่งที่มา
วิธีการและแนวทางข้อมูล
ความร่วมมือในปี 2025 Why Slop Matters ได้อธิบายว่า ‘ความสามารถผิวเผิน’ เป็นลักษณะสำคัญของ AI slop ซึ่งคุณภาพที่ดูเหมือนดีซ่อนการขาดเนื้อหา งานใหม่ได้นำแนวคิดนี้ไปใช้กับเอกสารวิทยาศาสตร์อย่างเฉพาะเจาะจง โดยกำหนด ‘scientific slop’ เป็นความล้มเหลวที่ทำให้ยากต่อการติดตามการจัดโครงสร้างของการศึกษา; วิธีการสนับสนุนข้ออ้าง; และวิธีการตรวจสอบวิธีการและหลักฐานของการศึกษา โดยความล้มเหลวเหล่านี้ถูกจัดเป็นกลุ่ม โครงสร้าง; ข้อโต้แย้ง; และ สิ่งประดิษฐ์:
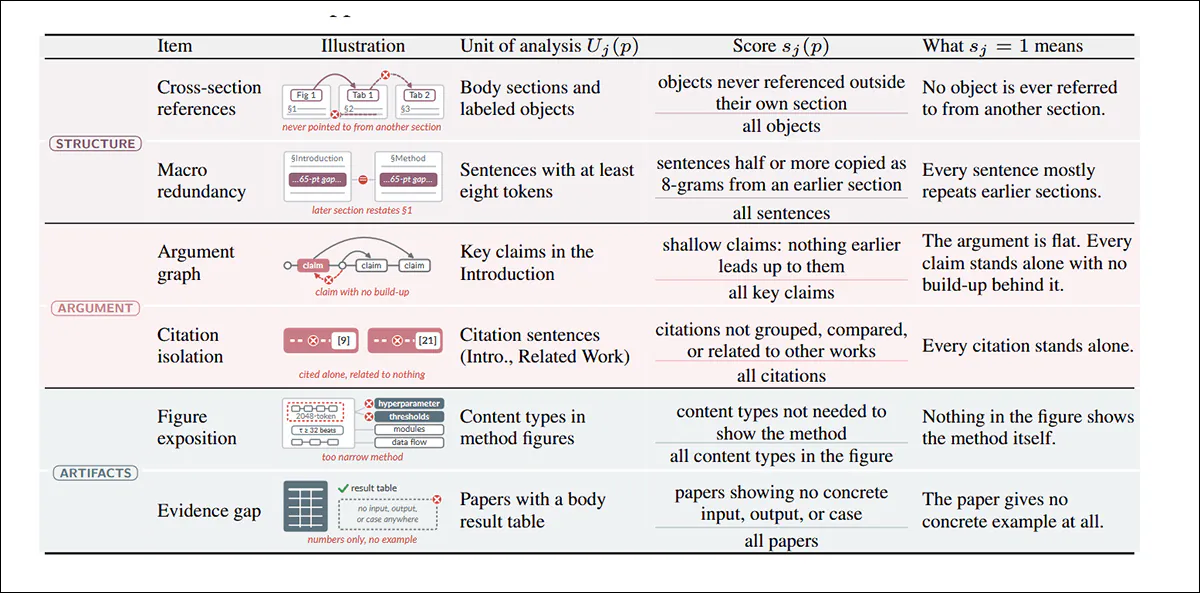
กฎการวัดสำหรับประเภท scientific slop หกประเภทที่ใช้ในเกณฑ์ ตารางแสดงสิ่งที่ตรวจสอบสำหรับแต่ละมาตรการ วิธีการคำนวณคะแนน และความหมายของคะแนนสูงสุดที่ 1 โดยคะแนนที่สูงกว่าแสดงถึงความล้มเหลวที่กว้างขวางมากขึ้น
หกมาตรการของ scientific slop ที่กำหนดในเอกสารคือ การอ้างอิงข้ามส่วน (ว่าหัวข้ออ้างอิงอย่างมีความหมายถึงเนื้อหาในส่วนอื่นของเอกสารหรือไม่); การซ้ำซ้อนระดับมหภาค (ว่าหัวข้อภายหลังทำซ้ำเนื้อหาก่อนหน้าหรือไม่); กราฟข้อโต้แย้ง (ว่าข้ออ้างได้รับการสนับสนุนอย่างเหมาะสมโดยเหตุผลก่อนหน้าหรือไม่); การแยกการอ้างอิง (ว่าการอ้างอิงถูกใช้แบบผิวเผินโดยไม่อธิบายว่าผลงานที่อ้างอิงสัมพันธ์กับเอกสารหรือกันและกันอย่างไร); การอธิบายรูปภาพ (ว่ารูปภาพวิธีการอธิบายวิธีการจริงหรือไม่); และ ช่องว่างของหลักฐาน (ว่าผลลัพธ์ที่รายงานได้รับการสนับสนุนโดยตัวอย่างที่เป็นรูปธรรมหรือไม่).
เกณฑ์นี้ถูกสร้างขึ้นโดยจับคู่เอกสารที่สร้างโดย AI กับเอกสารที่เขียนโดยมนุษย์ที่เทียบเคียงหรือเทียบเท่า โดยเอกสาร AI ถูกคัดสรรมาจาก FARS และการแข่งขัน 2025 Agents4Science
สำหรับแต่ละบทความ FARS ที่สร้างโดยเครื่องจักร นักวิจัยได้ค้นหาการอ้างอิงของบทความนั้นเพื่อหาเอกสารที่เขียนโดยมนุษย์ประเภทเดียวกันซึ่งได้รับการยอมรับในเวทีวิชาการชั้นนำ แล้วเลือกคู่ที่ใกล้เคียงที่สุดตามหัวข้อการวิจัย ผลลัพธ์ได้ 143 คู่ บทความ Agents4Science ก็ถูกจับคู่กับบทความที่เขียนโดยมนุษย์เช่นกัน เพิ่มอีก 247 คู่ ทำให้ฐานข้อมูลรวมเป็น 390 คู่ AI‑มนุษย์ทั้งหมด เอกสารเหล่านี้ครอบคลุมวิทยาศาสตร์ชีวิต สังคม และธรรมชาติ แม้ว่าชุดข้อมูลจะให้ความสำคัญอย่างมากกับวิทยาการคอมพิวเตอร์
สำหรับเมตริกต่าง ๆ การประเมินผลทำโดยใช้ PairAcc ซึ่งวัดความถี่ที่บทความมนุษย์ถูกจัดอันดับเหนือบทความ AI; และ AUROC ซึ่งวัดการแยกแยะโดยรวมระหว่างบทความมนุษย์และ AI ที่ระดับเกณฑ์ต่าง ๆ ผู้เขียนยังรายงานผลการตรวจจับเมื่ออัตราเท็จบวกของบทความมนุษย์ถูกกำหนดที่ 5 %
การทดสอบ
การทดสอบเบื้องต้นเปรียบเทียบ SciSlop กับเครื่องตรวจจับข้อความ AI Binoculars; DetectGPT; และ NTS†† รวมถึงระบบตรวจทานอัตโนมัติ AI Scientist Reviewer และ CycleReviewer
สำหรับการทดสอบการแก้ไขในขั้นต่อไป ใช้ฐานเปรียบเทียบสี่แบบ: base prompting; Claude Code; reviewer-based refinement; และ slop-aware revision ทั้งสามแบบแรกได้รับคำสั่งทั่วไปเพื่อปรับปรุงบทความเท่านั้น ในขณะที่ slop-aware revision ยังได้รับคำอธิบายและตำแหน่งของ slop ที่ตรวจพบ ทั้งหมดถูกเปรียบเทียบกับ SciSlopHarness ภายใต้เงื่อนไขการแก้ไขที่เท่าเทียมกัน
สำหรับการดำเนินการ ตัวตรวจจับข้อความได้รับข้อความของบทความ ส่วนวิธีอื่น ๆ ได้รับซอร์สโค้ดของบทความและเมื่อจำเป็นก็เข้าถึงโค้ดได้ Binoculars ใช้ Falcon-7B รุ่นฐานและรุ่นสั่งงาน; DetectGPT ใช้ T5-3B เพื่อสร้างการเปลี่ยนแปลง 100 ครั้ง; AI Scientist ใช้ Qwen2.5-32B-Instruct; และ CycleReviewer ใช้เช็คพอยต์ 8B ที่เผยแพร่ สำหรับบทความที่เกินขีดจำกัด 2,048 โทเคนของ Falcon จะทำการให้คะแนนหน้าต่างที่ไม่ทับซ้อนกันแยกกันแล้วเฉลี่ยผล
ผลการตรวจจับเบื้องต้นแสดงในตารางสองตารางด้านล่าง: SciSlop ได้คะแนน PairAcc 85.9 % เทียบกับ 68.7 % ของ Binoculars และ 68.5 % ของผู้ตรวจทานอัตโนมัติที่แข็งแกร่งที่สุด ลดอัตราความผิดพลาดลงมากกว่าครึ่งหนึ่ง
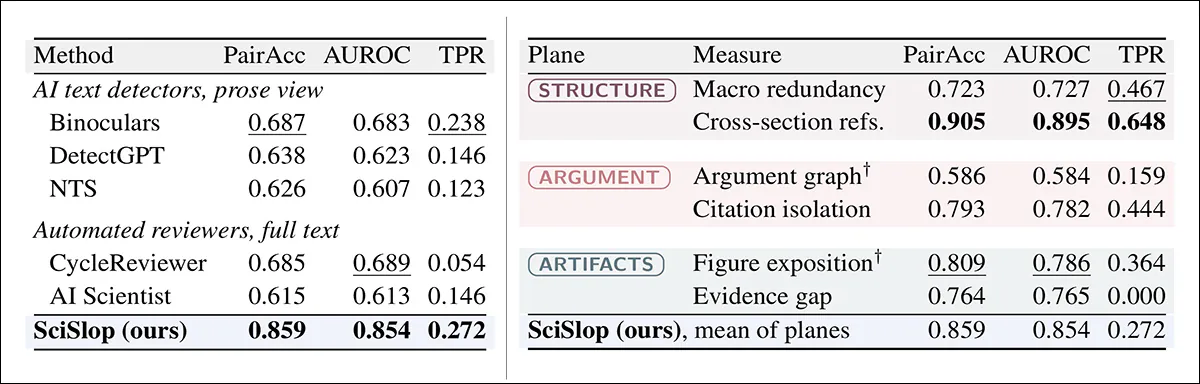
ผลการตรวจจับเปรียบเทียบ SciSlop กับเครื่องตรวจจับข้อความ AI และผู้ตรวจทานอัตโนมัติ พร้อมผลของมาตรการ slop หกประการแยกต่างหาก SciSlop มี PairAcc รวมสูงสุด ในขณะที่การอ้างอิงข้ามส่วนให้ผลลัพธ์ของตัวชี้วัดเดี่ยวที่แข็งแกร่งที่สุด
การอ้างอิงข้ามส่วนทำงานได้อย่างโดดเด่นโดยไม่ต้องใช้โมเดล โดยได้คะแนน PairAcc 90.5 % และตรวจจับ AI‑generated papers ได้ 65 % ที่อัตราเท็จบวก 5 % เทียบกับ 24 % ของ Binoculars
ผู้เขียนอธิบายว่าผลเหล่านี้บ่งชี้ว่าความสัมพันธ์ทั่วทั้งบทความให้สัญญาณที่แข็งแกร่งกว่าในการระบุการสร้างโดย AI เมื่อเทียบกับการตรวจจับระดับข้อความทั่วไปในชุดข้อมูลนี้ พร้อมทั้งชี้ให้เห็นจุดอ่อนเฉพาะที่อาจถูกแก้ไขในการปรับปรุงต่อไป
ต่อมามีการตรวจสอบความสัมพันธ์ระหว่าง scientific slop กับการประเมินคุณภาพของบทความโดยผู้ตรวจสอบ พบว่าในคอลัมน์แรกด้านล่าง slop ที่สูงกว่าจะสัมพันธ์กับคะแนน ICLR ที่ต่ำลงในด้านการให้คะแนนโดยรวม ความสมเหตุสมผล การนำเสนอ และการมีส่วนร่วม
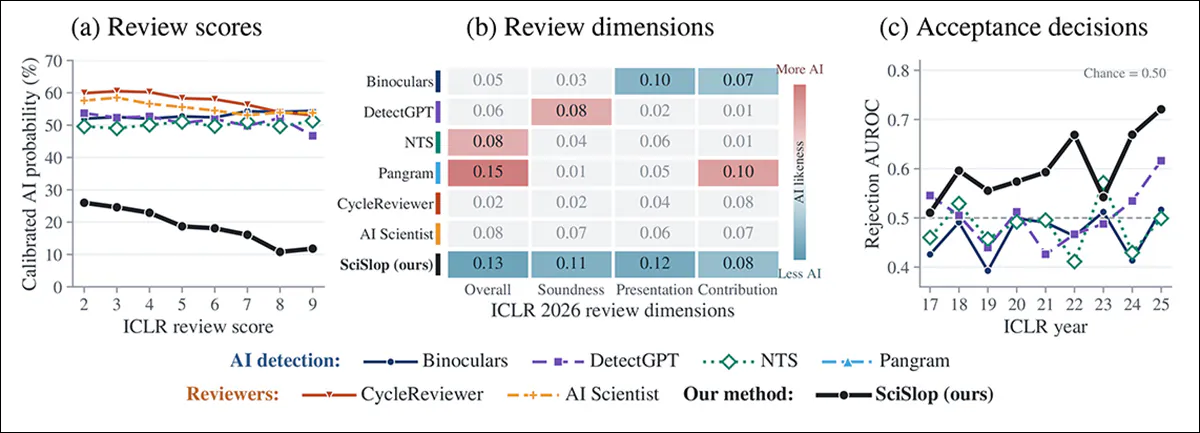
การเปรียบเทียบ SciSlop กับเครื่องตรวจจับข้อความ AI และผู้ตรวจทานอัตโนมัติต่อผลการรีวิว ICLR แผงซ้ายแสดงระดับความคล้าย AI กับคะแนนรีวิว; แผงกลางเปรียบเทียบมิติการรีวิวแต่ละด้าน; แผงขวาแสดงประสิทธิภาพในการแยกบทความที่ถูกปฏิเสธและยอมรับตลอดเก้าปี
บทความที่ถูกปฏิเสธและที่ได้รับการยอมรับยังสามารถแยกแยะได้เหนือระดับการเดาสุ่มในทุกปีที่ตรวจสอบทั้งหมดเก้า ปี ในขณะที่เครื่องตรวจจับแบบดั้งเดิมอยู่ต่ำกว่าระดับการเดาสุ่มในส่วนใหญ่ของการเปรียบเทียบ
ดังนั้น scientific slop จึงสะท้อนถึงจุดอ่อนที่ผู้ตรวจสอบมนุษย์ได้ลงโทษไว้แล้ว ไม่ได้ทำหน้าที่เป็นสัญญาณของการเขียนโดย AI เพียงอย่างเดียว
การทดสอบสุดท้ายตรวจสอบว่า SciSlopHarness สามารถกำจัด slop ที่เหลือหลังจากการแก้ไขทั่วไปได้หรือไม่ ตามที่แสดงด้านล่าง harness ทำคะแนนใกล้เคียงกับค่าเฉลี่ยของมนุษย์ในทุกหกมาตรการมากที่สุด ในขณะที่การแก้ไขทั่วไปมักทิ้ง slop ไว้จำนวนมาก และการแก้ไขแบบ slop-aware บางครั้งก็แก้ไขเกินความจำเป็น
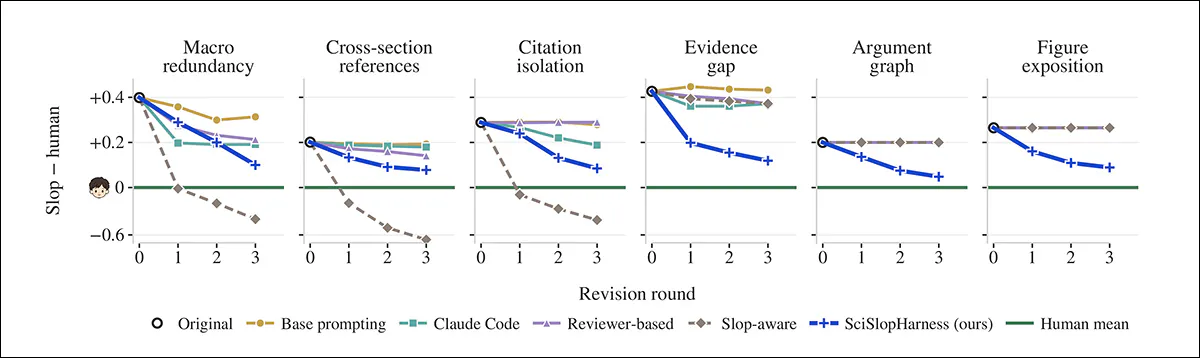
ผลการปรับปรุงที่เปรียบเทียบ SciSlopHarness กับวิธีฐานสี่วิธีในหกมาตรการ slop ค่าใกล้ศูนย์หมายถึงใกล้ค่าเฉลี่ยของบทความที่เขียนโดยมนุษย์ โดย SciSlopHarness มักเคลื่อนที่ไปสู่ระดับนี้ในขณะที่การปรับปรุงที่รับรู้ slop มักจะข้ามเกินไป
การเปลี่ยนแปลงที่เสนอแต่ละรายการถูกตรวจสอบกับเหตุผลทางวิทยาศาสตร์ของบทความและหลักฐานสนับสนุน โดยการแก้ไขที่ไม่มีการสนับสนุนจะถูกปฏิเสธ ในหกมาตรการทั้งหมด ช่องว่างที่เหลือจากบทความที่เขียนโดยมนุษย์ลดลง 63% เมื่อเทียบกับ Claude Code ซึ่งเป็นฐานการปรับปรุงที่แข็งแกร่งที่สุด
สรุป
มันน่าสนใจ ในระหว่างการเขียนบทความนี้ ที่ได้สังเกตไม่เพียงแต่บทความนี้ให้คะแนนแย่บนเว็บไซต์สาธิตของมันเอง แต่ยังพบอย่างน้อยหนึ่งตัวอย่างของการอ้างอิงแบบ ‘ขี้เกียจ’ หรือ ‘ตกแต่ง’ †† ซึ่งเมื่อเร็ว ๆ นี้กลายเป็นคำสาปเล็ก ๆ แต่กำลังเพิ่มขึ้นในบทความวิจัย
ในกรณีเช่นนี้ นอกเหนือจากบทความฉบับนี้ นักวิจัยดูเหมือนจะอ้างอิงความรู้ของตนเองแทนที่จะมีส่วนร่วมอย่างมีความหมายกับวรรณกรรมที่มีอยู่ อย่างไรก็ตาม เนื่องจากต้องปฏิบัติตามธรรมเนียมการ ‘แสดงงานของตน’ การอ้างอิงมักจะถูกใส่ด้วยความเร่งรีบ แม้จะดูเหมือนดูถูกกระบวนการ และมักพึ่งพาผู้อ่านให้ยอมรับการอ้างอิงจำนวนมากเป็น ‘ชั้นเคลือบ’ ของที่มาซึ่งแม้จะไม่ทนต่อการตรวจสอบอย่างละเอียด
Arxiv กำลังต่อสู้กับการอุตสาหกรรมการส่งบทความที่ขับเคลื่อนด้วย AI; ว่าจะมีข้อจำกัดคล้ายกันต่อการมีส่วนร่วมโดยตรงของ AI ในงานวิจัยหรือไม่ หากไม่มีเหตุการณ์ภัยพิบัติที่มีขนาดเพียงพอ ยังต้องรอดูต่อไป
* การเน้นของผู้เขียน ไม่ได้เป็นของฉัน – แต่การแปลงของฉันเมื่อจำเป็นจากการอ้างอิงในบรรทัดของผู้เขียนเป็นลิงก์
† ผู้เขียนไม่ได้อ้างว่าไม่มีการใช้ AI ในบทความของตนเอง, และ อธิบายการใช้ดังกล่าว.
†† อาจเป็นที่สนใจของผู้อ่านที่ทราบว่าฉันต้องค้นหาลิงก์ที่ถูกต้องด้วยตนเองสำหรับกรอบงาน NTS เนื่องจากลิงก์ที่ผู้เขียนให้ไม่เกี่ยวข้อง – หนึ่งในเมตริกที่ SciSlop ให้ความสำคัญ!
เผยแพร่ครั้งแรกวันอาทิตย์ที่ 4 ตุลาคม 2026


