
สัมภาษณ์
ดร. มาทิลด์ ปาวิส หัวหน้าฝ่ายกฎหมาย OpenOrigins – สัมภาษณ์รายการ

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
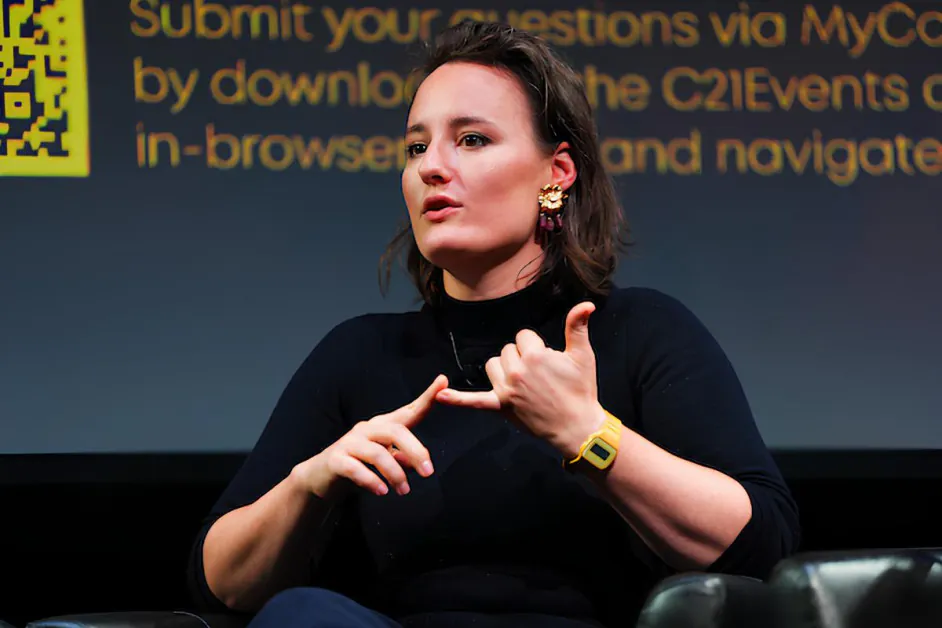
ดร. มาทิลด์ ปาวิส หัวหน้าฝ่ายกฎหมายของ OpenOrigins เป็นผู้เชี่ยวชาญชั้นนำด้านการกำกับดูแล AI และการกำกับดูแลสื่อดิจิทัล โดยเฉพาะด้าน deepfakes สื่อสังเคราะห์ และการตรวจสอบแหล่งที่มาของเนื้อหา เธอเป็นที่ปรึกษาให้กับบริษัท รัฐบาล และสหภาพแรงงานเกี่ยวกับการปฏิบัติตามกฎระเบียบ การออกใบอนุญาต และความเสี่ยงในด้าน AI ที่สร้างขึ้น และเคยทำงานร่วมกับ Microsoft (MSFT ) และ ElevenLabs ในด้านนโยบายและกลยุทธ์ AI เธอยังให้คำปรึกษากับ UNESCO เกี่ยวกับ AI และทรัพย์สินทางปัญญา และมักจะให้หลักฐานผู้เชี่ยวชาญแก่นักกำหนดนโยบายของสหราชอาณาจักร
OpenOrigins พัฒนาเทคโนโลยีเพื่อต่อต้านข้อมูลที่ผิดและ deepfakes โดยการสร้างบันทึกที่สามารถตรวจสอบและไม่สามารถเปลี่ยนแปลงได้ของเนื้อหา ดิจิทัล แพลตฟอร์มของพวกเขามุ่งเน้นไปที่การสร้างแหล่งที่มาที่ชัดเจน ซึ่งช่วยให้สามารถพิสูจน์ได้ว่าเนื้อหาถูกสร้าง เมื่อใด และโดยใคร – ความสามารถที่สำคัญมากขึ้นเมื่อสื่อสังเคราะห์กลายเป็นมากขึ้นและยากต่อการตรวจจับ
คุณได้ให้คำปรึกษากับรัฐบาล สถาบันทั่วโลก เช่น UNESCO และบริษัท เช่น Microsoft และ ElevenLabs เกี่ยวกับการกำกับดูแล AI สิ่งใดนำคุณไปสู่การเน้นไปที่ deepfakes ตัวแทนเสมือน และสื่อสังเคราะห์ และการเดินทางนั้นได้กำหนดการตัดสินใจของคุณในการก่อตั้ง Replique อย่างไร
การทำงานของฉันเกี่ยวกับ deepfakes ไม่ได้เริ่มต้นด้วยเทคโนโลยี – มันเริ่มต้นด้วยปัญหาทางกฎหมายที่เก่ากว่ามาก เมื่อฉันเริ่มทำวิจัยทรัพย์สินทางปัญญาเพื่อปริญญาเอกในปี 2013 ฉันรู้สึกประหลาดใจที่ผู้แสดงได้รับการคุ้มครองจากกฎหมายน้อยกว่าผู้แต่ง ผู้แต่งเพลง หรือผู้สร้างภาพยนตร์ ในทางปฏิบัติ หมายความว่าคำพูดหรือเพลงของคุณจะได้รับการคุ้มครองจากกฎหมายมากกว่าเสียงของคุณ หน้าของคุณ และร่างกายของคุณบนหน้าจอ ความไม่สมดุลนั้นดูแปลก และผลักดันให้ฉันตั้งคำถามที่ลึกซึ้งยิ่งขึ้น: วิธีการที่เราคุ้มครองงานของผู้ที่มีส่วนร่วมคือหน้า เสียง และร่างกายบนหน้าจอ
คำถามนั้นนำฉันเข้าสู่สิทธิของผู้แสดงและข้อมูล ในขณะนั้น มันถูกมองว่าเป็นพื้นที่เฉพาะที่มีความเกี่ยวข้องทางธุรกิจน้อย ฉันถูกแนะนำให้เปลี่ยนไปสู่สาขาอื่น เช่น สิทธิบัตรหรือลิขสิทธิ์แบบดั้งเดิม ความคิดเห็นคือปัญหาเกี่ยวกับลักษณะหรือเสียงของบุคคลถูกจัดการผ่านบรรทัดฐานอุตสาหกรรมหรือ “ข้อตกลงแบบสุภาพบุรุษในฮอลลีวูด” แต่สำหรับฉัน การขาดการคุ้มครองที่เป็นทางการส่งสัญญาณถึงช่องว่าง ไม่ใช่จุดสิ้นสุดของการวิจัยของฉัน ดังนั้นฉันจึงยังคงดำเนินการต่อ
สิ่งที่เปลี่ยนแปลงไปคือวันนี้เกือบทุกคนเป็นผู้แสดง ชีวิตของเราถูกสื่อสารผ่านกล้อง – บนโทรศัพท์มือถือ คอมพิวเตอร์ โทรศัพท์เสียงและวิดีโอ และแพลตฟอร์มโซเชียล ไม่ว่าจะเป็นสำหรับการทำงานหรือการใช้ส่วนบุคคล คนทั้งหลายต้องบันทึกและแบ่งปันรูปแบบต่างๆ ของตนเอง ปัญหาทางกฎหมายที่เคยใช้กับดาราหรือนักดนตรีเท่านั้น ตอนนี้ใช้กับทุกคนที่มีสมาร์ทโฟน
deepfakes ไม่ได้สร้างปัญหาเหล่านี้ – มันทำให้ปัญหาเหล่านี้เร่งรีบและเปิดเผยขึ้น การวิจัยที่ฉันทำตั้งแต่ปี 2013 เป็นต้นมา ได้กลายเป็นเรื่องเร่งด่วน เมื่อประมาณปี 2017 และ 2018 การพัฒนาทางเครือข่ายประสาท – โดยเฉพาะจากสถาบัน MIT และ UC Berkeley – เริ่มแสดงให้เห็นว่าหน้า เสียง และร่างกายของบุคคลสามารถถูกจัดการดิจิทัลได้อย่างน่าเชื่อถือ ในช่วงเวลาหนึ่งปี ความสามารถนี้กลายเป็นที่รู้จักกันในชื่อ “deepfakes” และได้รับความนิยมครั้งแรกในลักษณะที่เป็นอันตราย โดยเฉพาะอย่างยิ่งผ่านเนื้อหาที่ไม่สมัครใจทางเพศที่มุ่งเป้าไปที่ผู้หญิงและเด็ก
ต่อมา ผลกระทบทางการค้าได้ปรากฏขึ้น เมื่ออุตสาหกรรมสร้างสรรค์เริ่มใช้สื่อสังเคราะห์ นั่นคือเมื่อปัญหาเชิงสัญญาและเศรษฐกิจที่ฉันทำงานอยู่ได้มาถึงจุดสนใจ อีกไม่นาน สิ่งที่เคยถูกมองว่าเป็นพื้นที่ทางกฎหมายหรือหลักการทางกฎหมายได้กลายเป็นพื้นที่ที่มีความสำคัญทางปฏิบัติ มีความสำคัญทางเศรษฐกิจ และมีความสำคัญทางสังคม
ที่แก่นกลาง ความท้าทายทางกฎหมายยังคงไม่เปลี่ยนแปลง: ผู้คนต้องการแบ่งปันแง่มุมของตนเอง แต่ยังคงรักษาการควบคุมที่มีความหมาย ระบบที่มีอยู่ต้องดิ้นรนเพื่อจัดการกับความแตกต่างนั้น มันมักจะรักษาบุคคลว่าเป็นส่วนตัวหรือสาธารณะ – ทั้งการคุ้มครองหรือเป็นเกมที่ยุติธรรม แต่ส่วนใหญ่ของผู้คนอยู่ที่ไหนสักแห่งระหว่างนั้น ความตึงเครียดนั้นเป็นศูนย์กลางไม่เพียงแต่สำหรับผู้แสดงมืออาชีพเท่านั้น แต่สำหรับทุกคนที่เข้าร่วมในชีวิตดิจิทัล
ฉันกลายเป็นที่รู้จักในฐานะผู้ที่วิจัยและทำงานในพื้นที่นี้ ซึ่งนำไปสู่การทำงานร่วมกับรัฐบาลที่สนใจในการปกป้องผู้คนจาก deepfakes และบริษัทที่ต้องการทำให้ผลิตภัณฑ์โคลนดิจิทัลปลอดภัยต่อการใช้งาน เช่น ElevenLabs ที่ Replique ฉันนำทุกสิ่งที่ฉันเรียนรู้มาให้กับบุคคลและบริษัทที่ต้องการใช้เทคโนโลยีคลอนดิจิทัลหรือเทคโนโลยีตัวแทนเสมือนดิจิทัลอย่างรับผิดชอบและปลอดภัย ฉันเปลี่ยนงานวิจัยเชิงทฤษฎีของฉันให้เป็นธุรกิจที่ให้คำปรึกษาทางกฎหมายที่มีเชี่ยวชาญยิ่งให้กับอุตสาหกรรมสร้างสรรค์
ในฐานะหัวหน้าฝ่ายกฎหมายของ OpenOrigins บริษัทที่มุ่งเน้นในการสร้างบันทึกที่ไม่สามารถเปลี่ยนแปลงได้ของแหล่งที่มาของเนื้อหาเพื่อต่อต้าน deepfakes คุณมองเห็นระบบที่ใช้แหล่งที่มาแข่งขันกับหรือแทนที่วิธีการตรวจจับ deepfakes แบบดั้งเดิมอย่างไร
การเปรียบเทียบเครื่องมือตรวจจับ deepfakes สามารถกลายเป็นการจัดเรียงสิ่งที่แตกต่างกันได้อย่างรวดเร็ว เนื่องจากประสิทธิผลของมันขึ้นอยู่กับบริบทและวัตถุประสงค์ จากมุมมองของนโยบาย สิ่งที่เราต้องการคือชุดเครื่องมือที่เสริมซึ่งกันและกัน – ไม่มีวิธีแก้ปัญหา “ที่ดีที่สุด” และ OpenOrigins เป็นส่วนหนึ่งของระบบนิเวศที่กว้างขึ้น เทคโนโลยีของ OpenOrigins มีความโดดเด่นในฐานะเครื่องมือตรวจจับ deepfakes ในสถานการณ์ที่ผู้สร้างเนื้อหาหรือองค์กรข้อมูลต้องการพิสูจน์ความถูกต้องของเนื้อหาที่พวกเขาช่วยเหลือให้กับพันธมิตร ผู้ชม หรือสาธารณะ
โดยการให้แหล่งที่มาและ “ใบเสร็จ” ที่ชัดเจนที่จุดเริ่มต้น มันให้หลักฐานที่แข็งแกร่งในการป้องกันโดยการแสดงว่าเนื้อหานั้นไม่ใช่ deepfakes อย่างไรก็ตาม วิธีการนี้มีประโยชน์น้อยกว่าสำหรับผู้ใช้อินเทอร์เน็ตทั่วไปที่ต้องการประเมินเนื้อหาที่พบออนไลน์อย่างรวดเร็ว ในกรณีเหล่านั้น การตรวจจับขึ้นอยู่กับวิธีการวิเคราะห์เนื้อหาและความน่าจะเป็นมากกว่าวิธีการยืนยันโดยใช้แหล่งที่มา เราต้องการเครื่องมือที่แตกต่างกันสำหรับความต้องการที่แตกต่างกัน และเราต้องยอมรับว่าไม่มีวิธีแก้ปัญหา “กระสุนเงิน” สำหรับ deepfakes
จากมุมมองทางกฎหมาย ปัจจุบันช่องว่างที่ใหญ่ที่สุดในการจัดการความยินยอมและความเป็นเจ้าของในเนื้อหาที่สร้างหรือจำลองโดย AI คืออะไร
อุ๊ย มีเวลานานแค่ไหน ค.answers ขึ้นอยู่กับสิ่งที่เราหมายถึงเนื้อหาที่สร้างหรือจำลองโดย AI ปัญหาแตกต่างกันไปตามว่าเรากำลังมองหาภาพ AI ที่สร้างของบ้านหรือแมว หรือการสร้างดิจิทัลของหน้า เสียง หรือร่างกายของบุคคล มาให้คำตอบของคุณในบริบทของ ‘การคลอนดิจิทัล’
ในเรื่องของความยินยอม ปัญหาหลักคือสัญญาส่วนใหญ่ – ไม่ว่าจะเป็นข้อตกลงการจ้างงานหรือเงื่อนไขของแพลตฟอร์ม – มีเงื่อนไขที่กว้างและคลุมเครือซึ่งมอบสิทธิอย่างกว้างขวางเหนือเนื้อหาของผู้ใช้ สิ่งเหล่านี้สามารถตีความได้ว่าเป็น “ความยินยอมทางหลัง” โดยที่การยอมรับข้อกำหนดอาจถูกมองว่าเป็นการยินยอมในการใช้งาน เช่น การคลอน แม้ว่าผู้คนส่วนใหญ่จะไม่เห็นด้วยกับการตีความนั้น สิ่งนี้สร้างช่องว่างที่สำคัญระหว่างการตีความทางกฎหมายและความคาดหวังของผู้ใช้ ซึ่งปัจจุบันให้ประโยชน์ต่อบริษัท ในขณะที่การกำกับดูแลยังคงล้าหลัง
ในเรื่องของความเป็นเจ้าของ ไม่มีคำตอบทางกฎหมายที่ชัดเจนว่าใครเป็นเจ้าของตัวแทนเสมือนดิจิทัล เนื่องจากกรอบการทำงานที่มีอยู่ เช่น การคุ้มครองข้อมูล ลิขสิทธิ์ และสิทธิในบุคคลไม่ได้รับการออกแบบสำหรับเทคโนโลยีนี้ ปัจจุบันส่วนใหญ่ของผู้คนถูกสแกนและคลอนในที่ทำงาน ตามคำขอและเงินทุนของนายจ้างหรือลูกค้า และทั้งสองหน่วยงานมักคาดหวังการควบคุมทรัพย์สินนั้นในระดับสูง ซึ่งเข้าใจได้ แต่ปัญหาเพราะทรัพย์สินนั้นคือการจำลองดิจิทัลของหน้า เสียง หรือร่างกายของคุณ และสามารถทำให้คุณพูดสิ่งที่คุณไม่เคยพูดหรือทำสิ่งที่คุณไม่เคยทำได้
คำถาม “ใครเป็นเจ้าของตัวแทนเสมือนของคุณ?” มีความสำคัญ แต่ยังไม่ได้รับการตอบในกฎหมายปัจจุบัน
คุณได้ทำงานอย่างใกล้ชิดกับเทคโนโลยีการคลอนเสียง สิ่งเสี่ยงทางกฎหมายที่เข้าใจผิดมากที่สุดเมื่อถึงเสียงสังเคราะห์สำหรับบริษัทและบุคคลคืออะไร
ปัญหาที่เข้าใจผิดมากที่สุดในเรื่องการปฏิบัติตามกฎระเบียบคือความสมดุลระหว่างความสนใจเชิงพาณิชย์ของบริษัทในการให้ทุนและใช้ประโยชน์จากตัวแทนเสมือนดิจิทัล และสิทธิของบุคคลในการรักษาความเป็นส่วนตัวและศักดิ์ศรีดิจิทัล ความตึงเครียดระหว่างสิทธิในทรัพย์สินทางปัญญา การคุ้มครองข้อมูล และความเป็นส่วนตัวซึ่งไม่ได้รับการออกแบบให้ทำงานร่วมกันและตีความการคลอนในลักษณะที่แตกต่างกันอย่างพื้นฐาน ส่งผลให้การแปลสิ่งนี้เป็นแนวทางปฏิบัติที่ใช้ได้ในการทำงานเป็นเรื่องที่ซับซ้อนและไม่ชัดเจน บริษัทต่างๆ จึงละเลยความเสี่ยงที่สำคัญหรือต้องเสียค่าใช้จ่ายที่สำคัญเพื่อจัดการกับพวกมันอย่างเหมาะสม ซึ่งส่งผลให้เกิดผลลัพธ์ที่ผิดปกติซึ่งการปฏิบัติตามข้อกำหนดที่รับผิดชอบกลายเป็นเส้นทางที่ยากขึ้นและแพงกว่า ไม่ใช่เส้นทางเริ่มต้น
บริษัทควรคิดเกี่ยวกับการออกแบบโครงสร้างความยินยอมในระบบ AI โดยเฉพาะอย่างยิ่งเมื่อจัดการกับลักษณะ ลักษณะเฉพาะ และข้อมูลการฝึกอบรมอย่างไร
บริษัทควรออกแบบระบบของตนรอบสามความสามารถหลัก ขั้นแรก พวกเขาต้องได้รับการยินยอมที่มีข้อมูลและบริบทที่ชัดเจนในการเริ่มต้น ขั้นตอนที่สอง พวกเขาต้องทำให้ผู้ใช้สามารถถอนการยินยอมและลบข้อมูลบางส่วนหรือทั้งหมดได้อย่างง่ายดาย ซึ่งเป็นสิ่งที่ท้าทายจากด้านเทคนิคและบ่อยครั้งถูกละเลย แต่จำเป็นสำหรับการปฏิบัติตามกฎหมาย เช่น GDPR ของสหราชอาณาจักรและ สหภาพยุโรป และระบบที่คล้ายกันในสหรัฐอเมริกา การรักษาความยินยอมตลอดเวลา หมายถึงการสร้างระบบที่การถอนตัวเป็นไปอย่างราบรื่นและเป็นไปตามแบบจำลองธุรกิจ
ความยินยอมต้องเป็นแบบละเอียด และขั้นที่สาม ผู้ใช้ควรสามารถจัดการสิทธิ์ในระดับไฟล์เดียว อัปเดตข้อมูลลักษณะของตนเอง และเข้าใจว่ามันถูกใช้อย่างไร สิ่งนี้ต้องการความโปร่งใสและการควบคุม – เครื่องมือที่ช่วยให้ผู้ใช้สามารถตรวจสอบ ตรวจสอบและควบคุมการนำตัวแทนเสมือนดิจิทัลไปใช้อย่างไร ความยืดหยุ่นนี้ยังคหายาก แต่เป็นที่ที่ความได้เปรียบในการแข่งขันเพิ่มขึ้น
จากประสบการณ์ของคุณในการให้คำปรึกษาทั้งสตาร์ทอัพและรัฐบาล จุดแตกหักใหญ่ที่สุดระหว่างวิธีการสร้าง AI และการกำกับดูแล AI คืออะไร
จุดแตกหักระหว่างวิธีการสร้าง AI และการกำกับดูแล AI ลงไปสู่ภารกิจพื้นฐานที่แตกต่างกัน รัฐบาลกำกับดูแลในความสนใจของสาธารณะ ในขณะที่บริษัท AI (ซึ่งมักได้รับการสนับสนุนจากกองทุนร่วม) ขับเคลื่อนด้วยการเติบโต รายได้ และผลกำไร เป้าหมายเหล่านี้ไม่จำเป็นต้องขัดแย้งกันเสมอไป แต่บ่อยครั้งมีการดึงดูดในทิศทางที่แตกต่างกัน โดยมองว่าการกำกับดูแลเป็นอุปสรรคมากกว่าการสนับสนุน
สิ่งนี้สร้างความตึงเครียดเชิงโครงสร้าง: ผู้กำหนดนโยบายและผู้สร้างนวัตกรรมกำลังดำเนินการด้วยแรงจูงใจ ค่านิยม และภาษาที่แตกต่างกัน ซึ่งทำให้การประสานงานเป็นเรื่องที่ท้าทายในทางปฏิบัติ แม้ว่าจะไม่ใช่เรื่องที่เป็นไปไม่ได้ เราเริ่มเห็นคลื่นใหม่ของบริษัทเทคโนโลยีที่จัดตำแหน่งให้ใกล้กับเป้าหมายของสาธารณะมากขึ้น แต่พวกเขายังคงเป็นข้อยกเว้นมากกว่ากฎเกณฑ์ – โดยเฉพาะอย่างยิ่งระหว่างผู้ที่ประสบความสำเร็จในการขยายตัว
OpenOrigins มุ่งเน้นไปที่การตรวจสอบเนื้อหา ณ จุดสร้างโดยใช้แหล่งที่มาแบบเข้ารหัสลับ วิธีการ “จุดเริ่มต้นก่อน” นี้มีความสำคัญเท่าใดเมื่อเทียบกับการรักษาความปลอดภัยหลังการกระจาย
สิ่งนี้เชื่อมโยงกลับไปที่คำตอบของฉันข้างต้น การตรวจสอบเนื้อหา ณ จุดสร้าง “ขึ้นธารน้ำ” มีประสิทธิภาพมากกว่าการพยายามตรวจสอบที่จุดกระจายหรือแม้กระทั่งการบริโภค มันเหมือนกับการติดตามอาหารตั้งแต่ช่วงเวลาที่ปลูกบนฟาร์ม มากกว่าการพยายามคาดเดาโดยการดูจานอาหาร การรู้ว่าไก่ถูกเลี้ยงดูอย่างไร ถูกจัดการอย่างไร และเคลื่อนผ่านห่วงโซ่อุปทานอย่างไร คุณสามารถไว้วางใจในสิ่งที่คุณกินได้ หากคุณพยายามอนุมานทั้งหมดนั้นเพียงแค่ดูจานอาหารที่เสร็จแล้ว คุณจะพึ่งพาการเดาเท่านั้น มันเป็นเรื่องเดียวกันกับการแยกแยะระหว่างเนื้อหาที่สร้างโดยมนุษย์และเนื้อหาที่สร้างโดย AI ในออนไลน์: การตรวจสอบแหล่งที่มา ณ ที่มาให้การรับรองแบบตรวจสอบได้ ในขณะที่การตรวจจับแบบ “หลังการกระจาย” มีความไม่แน่นอนและตอบสนองมากขึ้น
คุณมองเห็นมาตรฐาน เช่น C2PA ในการสร้างอนาคตของสื่ออย่างไร และมาตรฐานเหล่านี้เพียงพอในการฟื้นฟูความไว้วางใจออนไลน์หรือไม่
C2PA เป็นความคิดที่ต้อนรับ และสนับสนุนการเคลื่อนไหวเดียวกันกับ OpenOrigins ในการรับรองความถูกต้องของเนื้อหา มันเป็นส่วนสำคัญของระบบนิเวศด้านความปลอดภัยและความถูกต้องของเนื้อหา เช่นเดียวกับเครื่องมือรักษาความปลอดภัยทางไซเบอร์อื่นๆ ไม่มีวิธีแก้ปัญหา “กระสุนเงิน”
สำหรับผู้สร้างและผู้มีพรสวรรค์ในอุตสาหกรรม เช่น ภาพยนตร์ เพลง และเกม ควรดำเนินการใดเพื่อป้องกันตัวเองจากการตอบแทนดิจิทัลที่ไม่ได้รับอนุญาต
ศิลปินในปัจจุบันต้องเผชิญกับความเสี่ยงสองประการ: การจำลองงานของพวกเขา (เช่น เพลง ภาพ หรือการเขียน) และการจำลองลักษณะของพวกเขา รวมถึงหน้า เสียง และร่างกาย ด้วยการนำเข้าข้อมูลน้อยๆ ระบบ AI สามารถทำซ้ำทั้งสองอย่างได้ด้วยความน่าเชื่อถือ ในทางปฏิบัติ การป้องกันเริ่มต้นด้วยการระมัดระวังในการแบ่งปันสิ่งใดออนไลน์ โดยตระหนักว่าเนื้อหาที่โพสต์อาจถูกสแกนและใช้ในเซตข้อมูลการฝึกอบรมโดยไม่มีการยินยอมหรือความโปร่งใสที่ชัดเจน
ความเสี่ยงที่ใกล้และควบคุมได้บ่อยครั้งกว่านั้นอยู่ในข้อตกลง สัญญาที่ศิลปินทำกับผู้ร่วมงาน ผู้จัดจำหน่าย หรือแพลตฟอร์มอาจมีเงื่อนไขที่อนุญาตให้ใช้ AI หรือการจำลองซ้ำสำหรับวัตถุประสงค์ในการฝึกอบรม – โดยไม่มีส่วนร่วมที่มีความหมายในการสร้างรายได้จากสื่อลำดับถัดไป
สำหรับศิลปิน สิ่งนี้ทำให้การตรวจสอบสัญญาเป็นสิ่งสำคัญ การเข้าใจว่างานและลักษณะของพวกเขาจะถูกใช้ ลิขสิทธิ์ หรือขายต่ออย่างไร เป็นสิ่งสำคัญไม่แพ้กับการสร้างสรรค์เอง มีการถกเถียงอย่างมาก (ทั่วทั้งสหภาพ อุตสาหกรรม และแพลตฟอร์ม) เกี่ยวกับการแก้ไขความไม่สมดุลนี้ และรับประกันว่าผู้สร้างจะรักษาการควบคุมและได้รับค่าตอบแทนที่ยุติธรรม
ดังนั้น คำแนะนำสองประการ: ระวังในการแบ่งปันสิ่งใดออนไลน์ และอ่านสัญญาและดูเงื่อนไข AI ก่อนที่จะลงนาม
เมื่อมองไปข้างหน้า 3-5 ปี คุณคิดว่าเราจะถึงจุดที่ทุกชิ้นของเนื้อหา ดิจิทัลต้องมีแหล่งที่มาแบบตรวจสอบได้หรือไม่ หรือความไว้วางใจจะยังคงกระจัดกระจายไปทั่วแพลตฟอร์มและเขตอำนาจศาล
ฉันอยากจะพูดว่าใช่ แต่จริงๆ แล้วไม่ใช่ – ไม่ใช่ภายใน 5 ปี ในด้านเทคโนโลยี 5 ปีเหมือนกับเป็นเวลานาน ในแง่ของการเปลี่ยนแปลงพฤติกรรมและนิสัยของผู้บริโภค มันสั้นมาก ผู้บริโภคส่วนใหญ่น่าจะไม่ตัดสินใจตามแหล่งที่มาของเนื้อหา แพลตฟอร์มมักจะปฏิบัติตามความต้องการของผู้ใช้ โดยให้ความสำคัญกับการมีส่วนร่วมมากกว่าแหล่งที่มา
สิ่งนี้อาจเปลี่ยนแปลงได้หากการกำกับดูแลเข้ามาแทรกแซง เราเริ่มเห็นการเคลื่อนไหวเริ่มต้นในสถานที่ เช่น แคลิฟอร์เนีย โดยที่ข้อกำหนดในการระบุและตรวจสอบกำลังปรากฏขึ้น แต่การขยายสิ่งนี้ไปทั่วโลกจะใช้เวลา – มีแนวโน้มที่จะใกล้จะ 10 ปีมากกว่า 5 ปี
พื้นที่ที่เปลี่ยนแปลงอีกแห่งคืออุตสาหกรรมเฉพาะ: อุตสาหกรรม เช่น สื่อ การเงิน ประกันภัย และการดูแลสุขภาพ อาจเริ่มต้องใช้แหล่งที่มาและความถูกต้อง เนื่องจากความไว้วางใจเป็นสิ่งสำคัญสำหรับการดำเนินงาน
สุดท้าย ผู้บริโภคอาจไม่สนใจข้อมูลแหล่งที่มาในระยะสั้น แต่พวกเขาจะสนใจคุณภาพของเนื้อหาและคุณภาพของข้อมูล หากเนื้อหาที่สร้างโดย AI กลายเป็นแบบเหมือนกันหรือ “จืด” ผู้ชมอาจเริ่มให้คุณค่ากับเนื้อหาที่สร้างโดยมนุษย์มากขึ้นโดยเฉพาะ ซึ่งอาจทำให้เกิดการแบ่งส่วนของตลาด โดยมีบางแพลตฟอร์มให้ความสำคัญกับการขยายขนาดและเนื้อหาที่สร้างโดย AI และอีกแพลตฟอร์มหนึ่งเลือกเนื้อหาที่มีความถูกต้อง แหล่งที่มา และเนื้อหาที่มีความน่าเชื่อถือและนำโดยมนุษย์ – แต่การเปลี่ยนแปลงนั้นยังคงเป็นเรื่องที่ไม่แน่นอน
ขอขอบคุณสำหรับคำตอบที่ยอดเยี่ยมของคุณ ผู้อ่านสามารถเรียนรู้เพิ่มเติมได้ที่ OpenOrigins.


