
สัมภาษณ์
เดนิส มุยโก ผู้ร่วมก่อตั้งและซีอีโอของ RAVEL – บทสัมภาษณ์

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
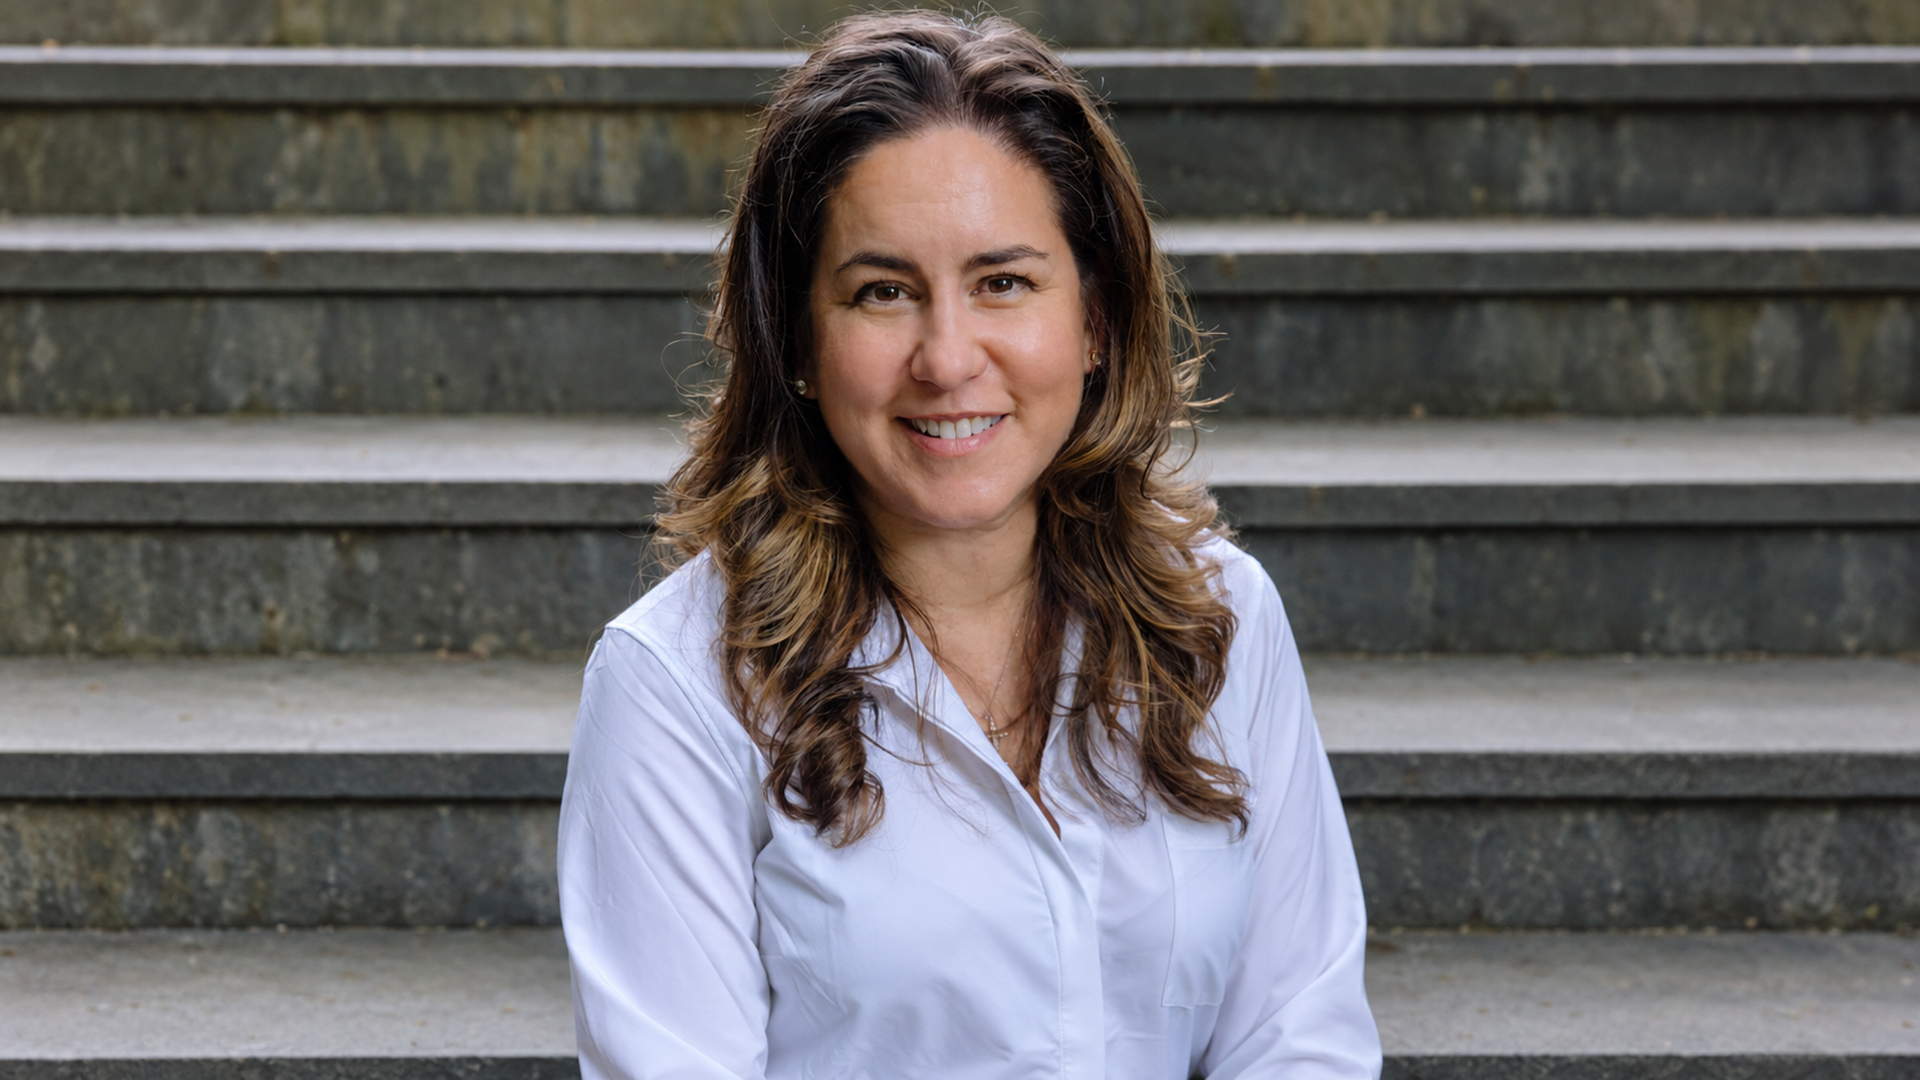
Denise Muyco เป็นผู้ร่วมก่อตั้งและซีอีโอของ RAVEL โดยเป็นผู้นำการพัฒนาซอฟต์แวร์จัดการและประสานงานโครงสร้างพื้นฐานด้านการประมวลผลและ AI ที่ซับซ้อน เธอผ่านการฝึกอบรมด้านวิศวกรรม และมีประสบการณ์การทำงานครอบคลุมโครงสร้างพื้นฐานด้านพลังงาน การปรับปรุงกระบวนการ สื่อดิจิทัล ศูนย์ข้อมูล และสตูดิโอเสมือนจริง ก่อนจะหันมาให้ความสำคัญกับ AI เธอมีส่วนช่วยพัฒนาโครงสร้างพื้นฐานการประมวลผลสมรรถนะสูงแบบใช้ร่วมกันให้กับชุมชนวิชวลเอฟเฟกต์ในแวนคูเวอร์ ซึ่งทำให้สตูดิโอประมาณ 30 แห่งเข้าถึงทรัพยากรการประมวลผลและการเชื่อมต่อที่ปลอดภัยได้ ประสบการณ์ดังกล่าวหล่อหลอมแนวทางการจัดสรรทรัพยากรราคาแพงที่มีอยู่อย่างจำกัดของเธอ ที่ RAVEL เธอนำมุมมองด้านวิศวกรรมระบบมาใช้กับการจัดวางเวิร์กโหลด การใช้ประโยชน์จากโครงสร้างพื้นฐาน การทำงานร่วมกันระหว่างระบบ ตลอดจนความต้องการที่เพิ่มขึ้นของสภาพแวดล้อม AI แบบกระจายศูนย์และ AI ที่อยู่ภายใต้อธิปไตยของแต่ละประเทศ
RAVEL พัฒนาซอฟต์แวร์ที่ช่วยให้องค์กรนำเวิร์กโหลดด้านการประมวลผลและ AI ไปใช้งาน บริหารจัดการ และขยายขนาดได้บนโครงสร้างพื้นฐานระบบคลาวด์ ภายในองค์กร และแบบไฮบริด ผลิตภัณฑ์ของบริษัทประกอบด้วย RAVEL Orchestrate สำหรับเวิร์กสเตชันเสมือนสมรรถนะสูง, RAVEL Orchestrate AI สำหรับการทำเวิร์กโหลดให้เป็นระบบอัตโนมัติและการเพิ่มประสิทธิภาพ และ Boost สำหรับการให้สิทธิ์ใช้งานซอฟต์แวร์และการวัดและส่งข้อมูลทางไกล เครื่องมือของบริษัทเชื่อมโยงโครงสร้างพื้นฐาน แอปพลิเคชัน ระบบเวอร์ชวลไลเซชัน และระบบรักษาความปลอดภัยเข้าด้วยกัน พร้อมทั้งมีระบบควบคุมจากส่วนกลางและช่วยให้เห็นภาพการดำเนินงานได้ชัดเจน RAVEL ให้บริการศูนย์ข้อมูล ผู้ให้บริการ ทีมไอทีระดับองค์กร กลุ่มวิจัย AI และสตูดิโอสร้างสรรค์ บริษัทต่อยอดจากรากฐานด้านการสร้างเนื้อหาดิจิทัล โดยมุ่งทำให้สภาพแวดล้อมที่ซับซ้อนจัดการได้ง่ายขึ้น และช่วยให้ทีมต่าง ๆ ใช้โครงสร้างพื้นฐานที่มีอยู่ได้อย่างมีประสิทธิภาพยิ่งขึ้น
คุณก่อตั้ง RAVEL หลังจากทำงานมาหลายปีในจุดบรรจบของวิศวกรรม โครงสร้างพื้นฐานด้านสื่อ และการประมวลผลแบบกระจาย อะไรคือปัจจัยสำคัญที่ทำให้คุณตัดสินใจก่อตั้งบริษัท และพันธกิจของ RAVEL เปลี่ยนแปลงไปอย่างไร เมื่อ AI เชิงสร้างสรรค์ทำให้ความต้องการทรัพยากรการประมวลผลเพิ่มขึ้นอย่างมาก
ฉันผ่านการฝึกอบรมด้านวิศวกรรม และทำงานในจุดบรรจบของพลังงาน การประมวลผล และโครงสร้างพื้นฐานมานานก่อนที่กระแส AI จะบูมอย่างทุกวันนี้ ช่วงต้นอาชีพ ฉันฝึกงานที่โรงไฟฟ้านิวเคลียร์ ต่อมางานด้านสื่อและวิชวลเอฟเฟกต์ทำให้ฉันได้รู้จักกับ GPU ความต้องการทรัพยากรการประมวลผลปริมาณมาก และข้อจำกัดของโครงสร้างพื้นฐานทางกายภาพ
เมื่อประมาณ 16 ปีก่อน อุตสาหกรรมวิชวลเอฟเฟกต์ที่กำลังเติบโตในแวนคูเวอร์เริ่มเผชิญข้อจำกัดเหล่านั้นโดยตรง สตูดิโอต้องใช้ทรัพยากรการประมวลผลสมรรถนะสูงมหาศาลเพื่อประมวลผล (หรือเรนเดอร์) เนื้อหาภาพยนตร์และโทรทัศน์ที่ซับซ้อนขึ้นเรื่อย ๆ สำหรับโครงการมูลค่าสูง แต่มีสตูดิโอเพียงไม่กี่แห่งที่สามารถให้เหตุผลรองรับการลงทุนสร้างโครงสร้างพื้นฐานเฉพาะทางให้เพียงพอต่อความต้องการสูงสุดในสภาพแวดล้อมที่ปลอดภัยได้ ขณะเดียวกัน พลังงานก็เริ่มกลายเป็นข้อจำกัดเช่นกัน เราพัฒนาโครงสร้างพื้นฐานแบบใช้ร่วมกัน ซึ่งทำให้สตูดิโอประมาณ 30 แห่งเข้าถึงการประมวลผลสมรรถนะสูงและการเชื่อมต่อที่ปลอดภัยด้วยแบนด์วิดท์สูงได้
การใช้โครงสร้างพื้นฐานร่วมกันช่วยแก้ปัญหาหนึ่ง แต่กลับก่อให้เกิดอีกปัญหาหนึ่ง นั่นคือจะจัดสรรทรัพยากรราคาแพงที่มีอยู่อย่างจำกัดให้แก่องค์กรและเวิร์กโหลดต่าง ๆ ได้อย่างมีประสิทธิภาพได้อย่างไร ประสบการณ์ดังกล่าวนำไปสู่แนวทางการประสานงานโครงสร้างพื้นฐานอย่างชาญฉลาดของ RAVEL ในที่สุด
AI เป็นความท้าทายพื้นฐานแบบเดียวกันในขนาดที่ใหญ่กว่ามาก โดยมีความซับซ้อนและเงินลงทุนที่มีความเสี่ยงสูงกว่ามาก แม้เวิร์กโหลดและโครงสร้างพื้นฐานจะเปลี่ยนไป แต่ความจำเป็นในการทำให้ทรัพยากรราคาแพงที่มีอยู่อย่างจำกัดทำงานร่วมกันได้อย่างมีประสิทธิภาพกลับยิ่งสำคัญขึ้น
ก่อนก่อตั้ง RAVEL คุณมีส่วนช่วยจัดตั้งกลุ่มความร่วมมือของสตูดิโอ ซาวด์สเตจ บริษัทผลิต และบริษัทวิชวลเอฟเฟกต์ในแวนคูเวอร์ประมาณ 30 แห่ง เพื่อให้สามารถใช้โครงสร้างพื้นฐานการประมวลผลสมรรถนะสูงร่วมกันได้ ประสบการณ์นั้นสอนอะไรคุณเกี่ยวกับการประมวลผลแบบกระจาย และคุณเห็นความคล้ายคลึงใดบ้างระหว่างความท้าทายด้านการเรนเดอร์ของฮอลลีวูดในเวลานั้น กับความท้าทายด้านโครงสร้างพื้นฐานของอุตสาหกรรม AI ในปัจจุบัน
งานของฉันกับอุตสาหกรรม VFX สอนให้รู้ว่าการสร้างและกำหนดค่าโครงสร้างพื้นฐานเป็นเพียงครึ่งหนึ่งของปัญหา ต้องแบ่งปันทรัพยากรการประมวลผลราคาแพงอย่างปลอดภัยและใช้งานให้มีประสิทธิภาพ ขณะเดียวกันโครงสร้างพื้นฐานโดยรวม ซึ่งรวมถึงเครือข่ายที่ปลอดภัยและสามารถรับส่งไฟล์ขนาดมหึมา ก็ต้องทำงานประสานกันได้ ต้องจัดตารางเวิร์กโหลด จัดสรรขีดความสามารถ และเคลื่อนย้ายข้อมูลปริมาณมหาศาล ทั้งหมดนี้ต้องทำไปพร้อมกับการที่ทีมผลิตพยายามสร้างผลงานที่ทะเยอทะยานยิ่งขึ้นภายใต้งบประมาณและกำหนดเวลาที่เข้มงวด จึงต้องปรับปรุงโครงสร้างพื้นฐานอย่างต่อเนื่องเพื่อเพิ่มประสิทธิภาพการใช้ทรัพยากรและสมรรถนะ
AI เป็นความท้าทายพื้นฐานแบบเดียวกันในขนาดที่ใหญ่กว่ามาก องค์กรต่าง ๆ ลงทุนมหาศาลในโครงสร้างพื้นฐาน แต่การเพิ่มขีดความสามารถเพียงอย่างเดียวไม่ได้รับประกันว่าจะใช้ทรัพยากรราคาแพงได้อย่างมีประสิทธิภาพ โครงสร้างพื้นฐาน AI ยังกระจายตัวมากขึ้นเรื่อย ๆ ทั้งในด้านสถานที่ ผู้ให้บริการ และสภาพแวดล้อม โดยมีปัจจัยขับเคลื่อนจากพลังงาน ขีดความสามารถ ความปลอดภัย เศรษฐศาสตร์ ภูมิศาสตร์ กฎระเบียบ และข้อกำหนดด้านอธิปไตย แม้เวิร์กโหลดด้านการเรนเดอร์และ AI จะแตกต่างกันมาก แต่ก็มีความท้าทายสำคัญร่วมกันด้านโครงสร้างพื้นฐานและระบบนิเวศ กล่าวคือทั้งสองอย่างต้องอาศัยการทำงานร่วมกันอย่างมีประสิทธิภาพของการประมวลผลสมรรถนะสูง เครือข่าย ความปลอดภัย และพื้นที่จัดเก็บข้อมูล
เมื่อโครงสร้างพื้นฐาน AI ซับซ้อนขึ้น การเพิ่มทรัพยากรการประมวลผลเพียงอย่างเดียวก็ไม่อาจแก้ความท้าทายด้านการดำเนินงานในการใช้ขีดความสามารถดังกล่าวให้เกิดประสิทธิภาพได้ นี่คือจุดที่การประสานงานและนโยบายที่กำกับดูแลระบบนิเวศโครงสร้างพื้นฐานในวงกว้างมีความสำคัญอย่างยิ่ง ทั้งสองอย่างช่วยให้องค์กรใช้ทรัพยากรราคาแพงที่มีอยู่อย่างจำกัดได้ดียิ่งขึ้น พร้อมกับประสานเวิร์กโหลดในสภาพแวดล้อมที่กระจายตัวมากขึ้นเรื่อย ๆ
RAVEL อธิบายว่าตนเป็นชั้นการประสานงานสำหรับโรงงาน AI แบบกระจายตัว ในมุมมองของคุณ “โรงงาน AI” หมายถึงอะไร และโครงสร้างพื้นฐานในปัจจุบันยังขาดอะไรไป จึงจำเป็นต้องมีชั้นการประสานงาน?
ในมุมมองของผม โรงงาน AI เป็นมากกว่า GPU และคลัสเตอร์ประสิทธิภาพสูง แต่เป็นระบบนิเวศโครงสร้างพื้นฐานแบบบูรณาการที่รวมการประมวลผล เครือข่าย พื้นที่จัดเก็บข้อมูล ความปลอดภัย พลังงาน ระบบทำความเย็น และชั้นปฏิบัติการที่จำเป็นต่อการทำงานของเวิร์กโหลด AI เข้าด้วยกัน โรงงาน AI กำลังเปลี่ยนจากคลัสเตอร์ที่แยกขาดจากกันไปสู่ระบบนิเวศของทรัพยากรที่เชื่อมโยงกัน ครอบคลุมหลายสถานที่และหลายภูมิภาค ความซับซ้อนดังกล่าวทำให้การจัดการด้วยตนเองหรือด้วยโซลูชันเฉพาะจุดที่ไม่เชื่อมโยงกันทำได้ยากขึ้นเรื่อย ๆ ชั้นการประสานงานช่วยรับมือกับปัญหานี้ โดยประสานองค์ประกอบต่าง ๆ ที่หลากหลายและซับซ้อนในสแต็กเข้าด้วยกัน พร้อมซ่อนความซับซ้อนเบื้องหลังบางส่วน ทำให้ผู้ปฏิบัติงานจัดการโครงสร้างพื้นฐานในฐานะระบบที่ประสานงานกันได้ง่ายขึ้น
ขณะที่องค์กรต่าง ๆ ปรับศูนย์ข้อมูลเดิมให้รองรับ AI สถานที่หลายแห่งไม่ได้ออกแบบมาแต่แรกเพื่อรองรับความต้องการของเวิร์กโหลด AI ในปัจจุบัน AI เผชิญกับความไม่สอดคล้องเชิงโครงสร้าง ซึ่งแบ่งออกได้เป็นปัญหาสำคัญสามประการ ประการแรกคือพลังงาน หรือการหาสถานที่ที่มีพลังงานเพียงพอและเชื่อถือได้สำหรับรองรับเวิร์กโหลดในระดับใหญ่ ประการที่สองคือระบบนิเวศที่แตกแยก เนื่องจากสแต็ก AI มักแยกอยู่ในสภาพแวดล้อมที่ไม่เชื่อมโยงกัน และไม่ได้ออกแบบมาให้ทำงานร่วมกัน ประการที่สามคือการมองเห็นต้นทุนการดำเนินงานและต้นทุนรวมในการเป็นเจ้าของที่จำกัด ซึ่งอาจบดบังต้นทุนที่แท้จริงของโครงสร้างพื้นฐาน AI ผลที่ตามมาคือเวิร์กโหลดอาจไม่ได้รับการปรับให้เหมาะสม ฮาร์ดแวร์อาจถูกใช้งานไม่เต็มประสิทธิภาพ และต้นทุนการดำเนินงานที่ไม่คาดคิดอาจทำให้ต้นทุนรวมในการเป็นเจ้าของสูงขึ้น และท้ายที่สุดส่งผลให้ต้นทุนต่อโทเคนเพิ่มขึ้น
โครงสร้างพื้นฐาน AI กระจายตัวมากขึ้นเรื่อย ๆ ทั้งในคลาวด์ระดับไฮเปอร์สเกล ศูนย์ข้อมูลเอกชน ระบบภายในองค์กร และผู้ให้บริการ GPU เฉพาะทาง องค์กรต่าง ๆ เผชิญความท้าทายสำคัญอะไรบ้างในการจัดการเวิร์กโหลด AI ข้ามสภาพแวดล้อมที่แตกต่างกันเหล่านี้?
ตลอดหลายปีที่ผ่านมา การแข่งขันด้านโครงสร้างพื้นฐาน AI ยึดแนวคิดเรียบง่ายข้อหนึ่งเป็นหลัก นั่นคือสร้างให้ใหญ่ขึ้น ศูนย์ข้อมูลใหญ่ขึ้น คลัสเตอร์ใหญ่ขึ้น GPU มากขึ้น ความจุมากขึ้น แต่แนวทางที่เน้นการสร้างให้ใหญ่ขึ้นกำลังเผชิญข้อจำกัดทางกายภาพ เศรษฐกิจ และกฎระเบียบมากขึ้นเรื่อย ๆ
พลังงานมีจำกัด การเข้าถึงโครงข่ายไฟฟ้าต้องใช้เวลา เศรษฐกิจ ภูมิศาสตร์ และอธิปไตยกำหนดมากขึ้นเรื่อย ๆ ว่าจะสร้างโครงสร้างพื้นฐานได้และควรสร้างที่ใด ความท้าทายใหม่ไม่ใช่เพียงการสร้างโครงสร้างพื้นฐาน AI ให้มากขึ้น แต่คือการสร้างโครงสร้างพื้นฐานที่เหมาะสมในสถานที่ที่เหมาะสม พร้อมทำให้สภาพแวดล้อมทั้งหมดทำงานประสานกันเป็นระบบเดียวกัน เรื่องนี้ยิ่งยากเป็นพิเศษเมื่อความจุกระจายอยู่ในคลาวด์ระดับไฮเปอร์สเกล ศูนย์ข้อมูลเอกชน โครงสร้างพื้นฐานภายในองค์กร และผู้ให้บริการเฉพาะทาง ซึ่งอาจไม่ได้ออกแบบมาให้ทำงานร่วมกัน
พลังงานเป็นข้อจำกัดที่รุนแรงที่สุดในบรรดาปัจจัยเหล่านี้ ความพร้อมใช้งานของพลังงานเป็นตัวกำหนดมากขึ้นเรื่อย ๆ ว่าจะสร้างโครงสร้างพื้นฐาน AI ที่ใดตั้งแต่แรก
นี่คือจุดที่การเชื่อมโยงโครงสร้างพื้นฐานข้ามระบบมีความสำคัญอย่างยิ่ง เพราะช่วยเชื่อมโครงสร้างพื้นฐานจากสภาพแวดล้อมต่าง ๆ เข้าสู่สภาพแวดล้อมการปฏิบัติงานร่วมกัน จากนั้น การประสานงานอย่างชาญฉลาดจะกำหนดว่าเวิร์กโหลดควรทำงานที่ใด โดยพิจารณาจากความจุ พลังงาน ประสิทธิภาพ ต้นทุน นโยบาย ความยืดหยุ่นในการรับมือกับความขัดข้อง และอธิปไตย
เมื่อโครงสร้างพื้นฐาน AI กระจายตัวออกไปมากขึ้น ไม่ว่าจะข้ามสถานที่หรือผู้ให้บริการ ความได้เปรียบในการแข่งขันจะไม่ได้มาจากการเป็นเจ้าของความจุที่มากขึ้นเพียงอย่างเดียว แต่จะมาจากการทำให้ความจุเหล่านั้นทำงานร่วมกันได้ การเชื่อมโยงโครงสร้างพื้นฐานข้ามระบบสร้างรูปแบบโครงสร้างพื้นฐานสำหรับความเป็นจริงใหม่นี้ ขณะที่การประสานงานอย่างชาญฉลาดทำให้รูปแบบดังกล่าวนำไปใช้ได้จริงในระดับใหญ่
นี่คือแนวทางที่ลูกค้ารายหนึ่งของเรา RT-One ซึ่งเป็นผู้พัฒนาอุทยานเทคโนโลยี AI และศูนย์ข้อมูลที่ใหญ่ที่สุดในลาตินอเมริกา กำลังดำเนินการขณะวางแผนโครงสร้างพื้นฐานแบบเชื่อมโยงทั่วทวีปอเมริกา โดยเชื่อมต่อความจุที่กระจายอยู่ตามพื้นที่ต่าง ๆ เพื่อให้สามารถบริหารจัดการเป็นสภาพแวดล้อมที่ประสานงานกันได้ในท้ายที่สุด
การขาดแคลน GPU ได้รับความสนใจอย่างมาก แต่การเพิ่มตัวเร่งประมวลผลไม่ได้แปลว่าจะมีทรัพยากรประมวลผล AI ที่ใช้ประโยชน์ได้เพิ่มขึ้นเสมอไป คุณเห็นว่าความไร้ประสิทธิภาพที่ใหญ่ที่สุดในโครงสร้างพื้นฐาน AI ปัจจุบันอยู่ตรงไหน และบริษัทต่าง ๆ จะปลดล็อกความจุเพิ่มเติมได้มากเพียงใดด้วยการประสานงานที่ดีขึ้น?
การแข่งขันด้านโครงสร้างพื้นฐาน AI มุ่งเน้นอย่างมากไปที่จำนวนกิกะวัตต์ของความจุใหม่ที่มีแผนจะสร้าง และเงินทุนที่ทุ่มลงไปเพื่อสร้างความจุนั้น เป็นเรื่องง่ายที่จะมองว่าปัญหาโครงสร้างพื้นฐานของ AI เป็นเพียงการขาดแคลน GPU หรือความจุ แต่กรอบคิดนี้มองข้ามจุดที่เกิดความไร้ประสิทธิภาพอย่างแท้จริง สิ่งสำคัญที่ควรทราบคือ ความจุที่วางแผนไว้ไม่ได้เท่ากับความจุที่ใช้งานได้จริง
คลัสเตอร์ GPU อาจดูเหมือนมีงานใช้งานเต็มแล้ว แต่ GPU ราคาแพงก็ยังอาจว่างอยู่ได้เมื่อเกิดคอขวดด้านประสิทธิภาพในส่วนอื่นของสแต็ก ตัวอย่างเช่น อัตราการรับส่งข้อมูลของระบบจัดเก็บข้อมูล ไปป์ไลน์ข้อมูล ความหนาแน่นของเครือข่าย ความไร้ประสิทธิภาพในการจัดตารางงาน ข้อกำหนดด้านความปลอดภัย และความไม่เข้ากันระหว่างสถาปัตยกรรม แอปพลิเคชัน ไดรเวอร์ และสิ่งที่ต้องพึ่งพา การเพิ่ม GPU ไม่ได้ทำให้ทรัพยากรประมวลผลที่ใช้งานได้เพิ่มขึ้นเสมอไป
การเพิ่มโครงสร้างพื้นฐานไม่ได้เพิ่มประสิทธิภาพโดยอัตโนมัติ ในหลายกรณี กลับทำให้เกิดระบบแยกส่วนมากขึ้นและผลักดันต้นทุนให้สูงขึ้น
องค์กรต่าง ๆ ต้องมีข้อมูลที่มองเห็นได้ชัดเจนและมีอำนาจควบคุมมากขึ้น เพื่อเพิ่มประสิทธิภาพการใช้ทรัพยากร ทำให้การตัดสินใจด้านโครงสร้างพื้นฐานเป็นไปโดยอัตโนมัติ และจัดสรรภาระงานให้สอดคล้องกับทรัพยากรที่มีอยู่และลำดับความสำคัญทางธุรกิจได้ดียิ่งขึ้น การมองเห็นและการควบคุมที่เพิ่มขึ้นช่วยเปลี่ยนทรัพยากรโครงสร้างพื้นฐานที่กระจัดกระจายให้เป็นสภาพแวดล้อมการปฏิบัติงานที่ประสานงานกันได้ดียิ่งขึ้น ไม่มีตัวเลขที่แน่นอนหรือใช้ได้กับทุกกรณีเพื่อระบุว่าการประสานงานจะช่วยปลดล็อกขีดความสามารถได้มากเพียงใด เพราะภาระงานแต่ละประเภทมีข้อกำหนดเฉพาะของตนเอง แต่มีสิ่งหนึ่งที่ชัดเจน นั่นคือ ทางออกสำหรับขีดความสามารถที่ถูกทิ้งไว้โดยไม่ได้ใช้งานหรือใช้งานไม่เต็มที่ ไม่ใช่แค่การซื้อหรือสร้างเพิ่ม
RAVEL ให้ความสำคัญกับการทำงานร่วมกันระหว่างโครงสร้างพื้นฐาน เทคโนโลยีเวอร์ชวลไลเซชัน ระบบระบุตัวตน และแอปพลิเคชัน เหตุใดการทำงานร่วมกันจึงมีความสำคัญเป็นพิเศษมากขึ้น เมื่อภาระงานด้าน AI มีความซับซ้อนและกระจายตัวมากขึ้น?
เมื่อโครงสร้างพื้นฐานมีความหลากหลายมากขึ้น องค์กรต่าง ๆ ก็ต้องการความยืดหยุ่นในการใช้เทคโนโลยีและสภาพแวดล้อมที่แตกต่างกัน โดยไม่ทำให้เกิดโครงสร้างพื้นฐานแบบแยกส่วนเพิ่มขึ้น การทำงานร่วมกันช่วยให้การประมวลผล การจัดเก็บข้อมูล เครือข่าย และแอปพลิเคชันจากผู้ให้บริการและสภาพแวดล้อมต่าง ๆ ทำงานร่วมกันได้ โดยยังคงรักษาทางเลือกไว้เมื่อโครงสร้างพื้นฐานพัฒนาไป แต่การทำงานร่วมกันเพียงอย่างเดียวไม่ได้กำหนดว่าควรใช้ทรัพยากรเหล่านั้นอย่างไร
การประสานงานเข้ามามีบทบาทตรงนี้ โดยช่วยกำหนดว่าจะให้ภาระงานทำงานที่ใด เคลื่อนย้ายอย่างไร และบังคับใช้นโยบายอย่างไรในสภาพแวดล้อมต่าง ๆ เมื่อโครงสร้างพื้นฐานด้าน AI กระจายตัวและเชื่อมโยงกันเป็นสหพันธ์มากขึ้น การทำงานร่วมกันก็ช่วยให้ดำเนินงานข้ามเทคโนโลยีต่าง ๆ ได้อย่างยืดหยุ่น ขณะที่การประสานงานเปลี่ยนทรัพยากรเหล่านั้นให้เป็นสภาพแวดล้อมการปฏิบัติงานที่ทำงานประสานกัน
RAVEL Orchestrate AI ทำหน้าที่เป็นชั้นการประสานงานร่วมกันสำหรับการประมวลผล การจัดเก็บข้อมูล เครือข่าย และเทคโนโลยีโครงสร้างพื้นฐานอื่น ๆ พร้อมประสานงานภาระงานด้าน AI ในสภาพแวดล้อมคลาวด์ ภายในองค์กร และแบบไฮบริด
อธิปไตยด้านข้อมูลกำลังกลายเป็นประเด็นสำคัญสำหรับรัฐบาลและองค์กรที่นำ AI มาใช้งาน การเติบโตของโครงสร้างพื้นฐาน AI อธิปไตยเปลี่ยนวิธีคิดขององค์กรเกี่ยวกับการจัดวางภาระงาน การเคลื่อนย้ายข้อมูล ความปลอดภัย และการประสานงานอย่างไร?
AI อธิปไตยกลายเป็นวาระสำคัญเชิงกลยุทธ์แล้ว และทำให้เกิดคำถามพื้นฐานยิ่งขึ้นว่า แท้จริงแล้วการมีอธิปไตยหมายถึงอะไร? การพูดคุยส่วนใหญ่มุ่งเน้นไปที่การจัดเก็บข้อมูลภายในเขตแดนที่กำหนด แต่ฉันเชื่อว่าคำจำกัดความดังกล่าวแคบเกินไป
ฉันนิยาม AI อธิปไตยว่าเป็นความสามารถของประเทศ องค์กร หน่วยงานรัฐบาล หรือองค์กรอื่น ๆ ในการรักษาอำนาจควบคุมภาระงานด้าน AI ตามนโยบายที่กำหนดไว้ ซึ่งครอบคลุมข้อมูล โมเดล โครงสร้างพื้นฐานสำหรับการประมวลผล การเข้าถึง ความปลอดภัย การดำเนินงาน และเขตอำนาจศาลที่กำกับดูแลภาระงานเหล่านั้น อธิปไตยไม่ได้หมายความว่าภาระงานทุกประเภทต้องอยู่ในศูนย์ข้อมูลแห่งเดียว หรือแม้แต่ต้องทำงานบนโครงสร้างพื้นฐานที่องค์กรเดียวเป็นเจ้าของเสมอไป แต่หมายความว่าองค์กรเป็นผู้กำหนดว่าภาระงานได้รับอนุญาตให้ทำงานที่ใด ข้อมูลของภาระงานนั้นจัดเก็บหรือเคลื่อนย้ายไปที่ใดได้บ้าง ใครเข้าถึงข้อมูลได้ โครงสร้างพื้นฐานใดใช้ประมวลผลข้อมูลได้ และต้องรักษานโยบายด้านความปลอดภัย กฎระเบียบ ภูมิศาสตร์ การดำเนินงาน และธุรกิจใดไว้ตลอดเวลา คำจำกัดความที่ยึดภาระงานเป็นศูนย์กลางนี้สอดคล้องกับแนวโน้มที่กว้างขึ้นในอุตสาหกรรม ซึ่งมองว่าอธิปไตยคือการควบคุมสภาพแวดล้อม AI ทั้งหมด ไม่ใช่เพียงการจัดเก็บข้อมูลภายในเขตแดนที่กำหนด
แนวทางของ RAVEL มีความโดดเด่นเป็นพิเศษเมื่อ AI อธิปไตยทำงานร่วมกับระบบสหพันธ์ RAVEL Orchestrate AI สามารถกำหนดให้ข้อกำหนดด้านอธิปไตยเป็นเงื่อนไขภายในชั้นการประสานงานและนโยบายได้ ภาระงานอาจได้รับอนุญาตให้ทำงานบนสหพันธ์ของไซต์ คลาวด์ ศูนย์ข้อมูล สถานที่ประมวลผลเอดจ์ หรือโครงสร้างพื้นฐานอื่น ๆ แต่ต้องเป็นทรัพยากรที่สอดคล้องกับนโยบายด้านอธิปไตยของภาระงานนั้นเท่านั้น ภายในขอบเขตที่ได้รับอนุมัตินี้ RAVEL สามารถกำหนดโครงสร้างพื้นฐานที่เหมาะสมได้ โดยพิจารณาจากปัจจัยต่าง ๆ เช่น พลังงาน ต้นทุน ประสิทธิภาพ ขีดความสามารถ การใช้ทรัพยากร ลักษณะของเครือข่าย ที่ตั้ง และลำดับความสำคัญ การทำงานแบบสหพันธ์ไม่ได้ลบล้างอธิปไตย แต่สามารถดำเนินงานภายใต้ขอบเขตที่อธิปไตยกำหนดไว้ได้ ตัวอย่างเช่น ภาระงานที่ละเอียดอ่อนของรัฐบาลอาจต้องอยู่ภายในสถานที่ที่ได้รับอนุมัติในสหรัฐฯ ทั้งหมด แต่ยังสามารถประสานงานแบบไดนามิกระหว่างไซต์ที่ได้รับอนุญาตหลายแห่งได้ ผลลัพธ์คือรูปแบบที่ช่วยให้องค์กรได้รับประโยชน์ด้านการใช้ทรัพยากรและความยืดหยุ่นจากโครงสร้างพื้นฐาน AI แบบกระจายตัว โดยไม่ต้องสละการควบคุมสถานที่และวิธีการดำเนินงานของภาระงานที่ละเอียดอ่อนที่สุด
RAVEL เริ่มต้นในอุตสาหกรรมต่าง ๆ เช่น สื่อ บันเทิง เกม และการออกแบบ ซึ่งภาระงานอาจต้องใช้กำลังประมวลผลมหาศาล ความต้องการด้าน AI เชิงสร้างสรรค์เปลี่ยนแพลตฟอร์มอย่างไร เมื่อเทียบกับความท้าทายด้านโครงสร้างพื้นฐานที่คุณตั้งใจแก้ไขให้ผู้เชี่ยวชาญด้านงานสร้างสรรค์ในช่วงแรก?
RAVEL เริ่มต้นจากการแก้ปัญหาโครงสร้างพื้นฐานที่ศิลปินและวิศวกรต้องเผชิญอยู่แล้ว โดยพวกเขาต้องจัดการงานเรนเดอร์ การจำลอง และการสร้างเนื้อหาขนาดใหญ่บนทรัพยากรประมวลผล การจัดเก็บข้อมูล และเครือข่ายที่มีค่าใช้จ่ายสูง ความท้าทายหลักคือการทำให้เข้าถึง แบ่งปัน และประสานงานโครงสร้างพื้นฐานที่หลากหลายได้ง่ายขึ้น พร้อมทั้งเพิ่มประสิทธิภาพการใช้ทรัพยากรและประสิทธิภาพการทำงานให้สูงสุด
AI เชิงสร้างสรรค์ทำให้ปัญหาเดิมมีขนาดใหญ่และซับซ้อนขึ้นอย่างมาก แทนที่จะประสานงานเฉพาะแอปพลิเคชันและภาระงานด้านการเรนเดอร์เป็นหลัก ตอนนี้เราต้องคำนึงถึงโมเดล AI เอ็นจิน เอเจนต์ ภาระงานสำหรับการฝึกและการอนุมาน สถาปัตยกรรม GPU ที่แตกต่างกัน ชุดซอฟต์แวร์ที่เปลี่ยนแปลงอย่างรวดเร็ว การเคลื่อนย้ายข้อมูลปริมาณมหาศาล และข้อจำกัดด้านพลังงาน ต้นทุน ความปลอดภัย และความพร้อมใช้งานที่เข้มงวดขึ้นอย่างมาก
ด้วยเหตุนี้ RAVEL จึงพัฒนาจากการมุ่งจัดการประสานงานทรัพยากรประมวลผลเป็นหลัก มาเป็นผู้ให้บริการชั้นควบคุมและเพิ่มประสิทธิภาพอัจฉริยะสำหรับโครงสร้างพื้นฐาน AI Orchestrate AI ใช้ข้อมูลเทเลเมทรีและนโยบายเพื่อพิจารณาไม่เพียงว่าโครงสร้างพื้นฐานพร้อมใช้งานหรือไม่ แต่ยังรวมถึงสถานที่และวิธีการทำงานของเวิร์กโหลด โดยพิจารณาปัจจัยต่าง ๆ เช่น ต้นทุน ความเร็ว พลังงาน ประสิทธิภาพ การใช้ทรัพยากร สถานที่ตั้ง และข้อกำหนดด้านอธิปไตยด้วย
การทำงานแบบสหพันธ์มีความสำคัญเพิ่มขึ้นเรื่อย ๆ เช่นกัน เพราะไม่อาจมองโครงสร้างพื้นฐาน AI เป็นเพียงกลุ่มศูนย์ข้อมูลที่แยกขาดจากกันได้อีกต่อไป องค์กรจำเป็นต้องสามารถใช้ทรัพยากรที่มีอยู่ในหลายสถานที่ได้อย่างชาญฉลาด พร้อมกับรักษาธรรมาภิบาลและความปลอดภัยไว้ ในหลายแง่มุม AI เชิงกำเนิดไม่ได้เปลี่ยนปัญหาพื้นฐานที่ RAVEL มุ่งแก้ไขตั้งแต่แรก แต่ทำให้ปัญหานั้นมีขนาดใหญ่และซับซ้อนขึ้นอย่างมาก ส่งผลให้การประสานงาน การเพิ่มประสิทธิภาพ และการทำงานแบบสหพันธ์อย่างชาญฉลาดมีความสำคัญยิ่งขึ้น
เส้นทางอาชีพของคุณเริ่มจากวิศวกรรมเครื่องกลและการเพิ่มประสิทธิภาพกระบวนการที่ Starbucks ต่อด้วยสื่อดิจิทัล ศูนย์ข้อมูล สตูดิโอเสมือน และปัจจุบันคือโครงสร้างพื้นฐาน AI พื้นฐานด้านวิศวกรรมส่งผลต่อแนวทางการสร้างบริษัทและการแก้ปัญหาเกี่ยวกับโครงสร้างพื้นฐานของคุณอย่างไร
พื้นฐานด้านวิศวกรรมของผมน่าจะส่งผลต่อแทบทุกแง่มุมของการสร้างบริษัท วิศวกรรมเครื่องกลสอนให้เรามองระบบทั้งระบบ ไม่ใช่แค่องค์ประกอบใดองค์ประกอบหนึ่ง แล้วตั้งคำถามว่ามีข้อจำกัดตรงไหน พลังงานหรือทรัพยากรถูกใช้ไปอย่างสูญเปล่าตรงไหน และจะทำให้ระบบโดยรวมทำงานได้ดีขึ้นอย่างไร ที่ Starbucks ผมนำแนวคิดนี้ไปใช้ปรับปรุงประสิทธิภาพกระบวนการ ต่อมาในแวดวงสื่อดิจิทัลและวิชวลเอฟเฟกต์ ระบบที่ต้องพิจารณาก็ประกอบด้วยทรัพยากรประมวลผล พื้นที่จัดเก็บข้อมูล เครือข่าย แอปพลิเคชัน และท้ายที่สุดคือศูนย์ข้อมูลทั้งแห่ง เทคโนโลยีเปลี่ยนไป แต่วิธีที่ผมใช้เข้าหาปัญหาแทบไม่เปลี่ยนเลย ผมถามตัวเองอยู่เสมอว่า คอขวดอยู่ตรงไหน ทรัพยากรใดถูกใช้งานไม่เต็มที่ มีอะไรที่เราทำให้ง่ายขึ้นได้บ้าง และจะทำให้ทั้งระบบทำงานได้ดีขึ้นได้อย่างไร แทนที่จะมุ่งเพิ่มประสิทธิภาพเพียงส่วนใดส่วนหนึ่ง
นี่คือแนวคิดที่เราใช้สร้าง RAVEL อย่างแท้จริง ผมไม่คิดว่าปัญหาโครงสร้างพื้นฐาน AI เป็นเพียงเรื่องการจัดหา GPU เพิ่มหรือสร้างศูนย์ข้อมูลเพิ่ม แต่เป็นปัญหาด้านวิศวกรรมระบบที่เกี่ยวข้องกับทรัพยากรประมวลผล พลังงาน พื้นที่จัดเก็บข้อมูล เครือข่าย ซอฟต์แวร์ เวิร์กโหลด ผู้คน และยิ่งนับวันก็ยิ่งรวมถึงภูมิศาสตร์และอธิปไตยด้วย คุณอาจมี GPU ที่เร็วที่สุดในโลก แต่หากส่วนอื่น ๆ ของระบบไม่ได้รับการปรับให้เหมาะสม ก็เท่ากับสร้างคอขวดราคาแพงมากขึ้นมาเท่านั้น ดังนั้น แนวทางของเราที่ RAVEL คือทำให้โครงสร้างพื้นฐานมีความชาญฉลาดยิ่งขึ้น โดยใช้ข้อมูลเทเลเมทรี นโยบาย การจัดการประสานงาน และการทำงานแบบสหพันธ์ เพื่อพิจารณาอย่างต่อเนื่องว่าเวิร์กโหลดควรทำงานที่ใดและอย่างไร ผมเริ่มต้นอาชีพด้วยการเพิ่มประสิทธิภาพระบบกายภาพ และวันนี้เรากำลังนำหลักการทางวิศวกรรมเดียวกันนี้มาใช้เพิ่มประสิทธิภาพโครงสร้างพื้นฐานที่ขับเคลื่อน AI
เมื่อมองไปข้างหน้า คุณคาดว่าโครงสร้างพื้นฐาน AI จะพัฒนาไปอย่างไร เมื่อโมเดล เอเจนต์ และแอปพลิเคชันต้องการทรัพยากรประมวลผลแบบกระจายมากขึ้นเรื่อย ๆ คุณคิดว่าโรงงาน AI จะกลายเป็นโครงสร้างพื้นฐานมาตรฐานขององค์กร เช่นเดียวกับที่คลาวด์คอมพิวติงเป็นมาตลอดทศวรรษที่ผ่านมาหรือไม่
ผมเชื่ออย่างยิ่งว่าโรงงาน AI จะกลายเป็นโครงสร้างพื้นฐานพื้นฐานขององค์กร เช่นเดียวกับที่คลาวด์คอมพิวติงเคยเป็น แต่ผมไม่คิดว่าโรงงานเหล่านี้จะมีหน้าตาเหมือนศูนย์ข้อมูลหรือคลาวด์มาตรฐานแห่งเดียว เมื่อโมเดล เอเจนต์ และแอปพลิเคชันใช้ทรัพยากรประมวลผลมากขึ้นเรื่อย ๆ องค์กรต่าง ๆ จะดำเนินงานบนระบบที่หลากหลาย ซึ่งประกอบด้วย GPU, CPU, โครงสร้างพื้นฐานส่วนตัว ผู้ให้บริการคลาวด์ยุคใหม่ ผู้ให้บริการคลาวด์รายใหญ่ สภาพแวดล้อมเอดจ์ และระบบ AI เฉพาะทาง
ความพร้อมใช้งานของพลังงาน ต้นทุน อธิปไตย ประสิทธิภาพ และสถานที่ตั้งจะมีความสำคัญไม่แพ้ความพร้อมใช้งานของทรัพยากรประมวลผล ความท้าทายที่แท้จริงไม่ใช่แค่การสร้างโครงสร้างพื้นฐานเพิ่ม แต่คือการทำให้โครงสร้างพื้นฐานแบบกระจายทั้งหมดทำงานเสมือนเป็นระบบอัจฉริยะเดียวกัน โรงงาน AI ในอนาคตจะไม่ใช่อาคารเพียงแห่งเดียว แต่เป็นสภาพแวดล้อมโครงสร้างพื้นฐานแบบสหพันธ์ที่ครอบคลุมทรัพยากรประมวลผล พลังงาน ข้อมูล และทรัพยากรที่จำเป็นต่อการทำงานของเวิร์กโหลด AI ในสถานที่ที่เหมาะสมที่สุด
ผมคิดว่านี่คือจุดที่โครงสร้างพื้นฐานชั้นสำคัญลำดับถัดไปจะเกิดขึ้น คลาวด์คอมพิวติงช่วยซ่อนความซับซ้อนของเซิร์ฟเวอร์และทำให้เข้าถึงทรัพยากรประมวลผลได้ง่ายขึ้น ขั้นต่อไปคือการซ่อนความซับซ้อนของโครงสร้างพื้นฐาน AI ทั้งระบบ องค์กรไม่ควรต้องคอยตัดสินใจด้วยตนเองว่าโมเดลหรือเอเจนต์แต่ละตัวควรทำงานบน GPU ศูนย์ข้อมูล คลาวด์ แหล่งพลังงาน หรือพื้นที่ใด โครงสร้างพื้นฐานควรตัดสินใจเหล่านี้ได้เองมากขึ้น โดยใช้ข้อมูลเทเลเมทรีและนโยบายเพื่อเพิ่มประสิทธิภาพด้านต้นทุน ความเร็ว พลังงาน ประสิทธิภาพ ความพร้อมใช้งาน และอธิปไตย นี่คืออนาคตที่ RAVEL กำลังสร้างขึ้น นั่นคือชั้นจัดการประสานงานอัจฉริยะที่ช่วยให้เวิร์กโหลดเคลื่อนย้ายไปมาระหว่างโครงสร้างพื้นฐาน AI แบบสหพันธ์ได้ พร้อมคงนโยบายและมาตรการควบคุมขององค์กรไว้ คลาวด์ทำให้เข้าถึงทรัพยากรประมวลผลได้ตามต้องการ ผมเชื่อว่าโครงสร้างพื้นฐาน AI รุ่นถัดไปจะทำให้การเพิ่มประสิทธิภาพพร้อมใช้งานได้ตามต้องการ
ขอบคุณสำหรับบทสัมภาษณ์ที่ยอดเยี่ยมนี้ ผู้อ่านที่ต้องการเรียนรู้เพิ่มเติมเกี่ยวกับการจัดการประสานงานเวิร์กโหลด AI บนโครงสร้างพื้นฐานแบบกระจาย สามารถเยี่ยมชม RAVEL ได้



