
สัมภาษณ์
ดานี เชิร์คาสกี้ ซีอีโอและผู้ร่วมก่อตั้ง Kardome – ซีรีส์สัมภาษณ์

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
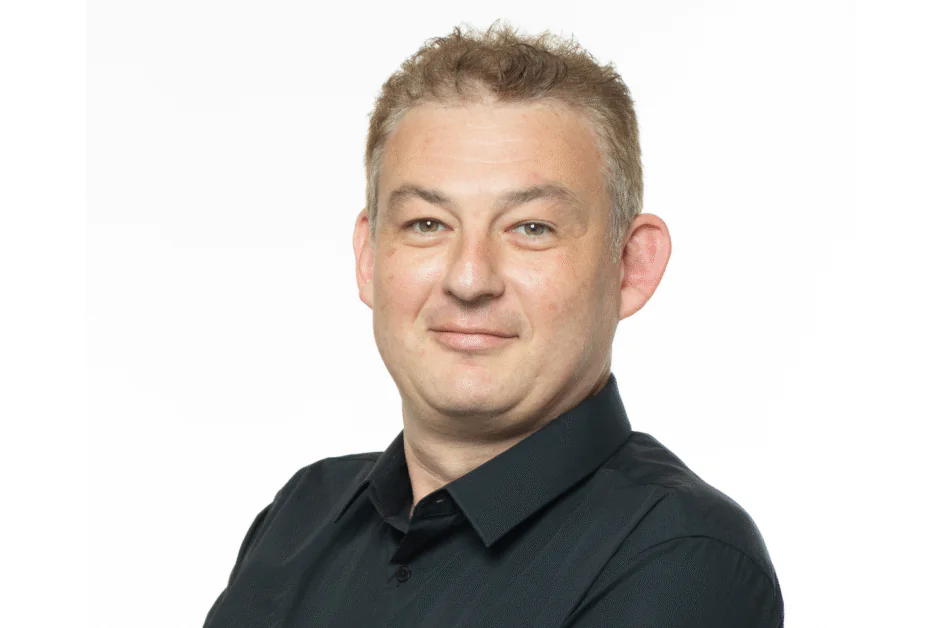
Dani Cherkassky ซีอีโอและผู้ร่วมก่อตั้ง Kardome มีประสบการณ์ด้านเสียง การประมวลผลสัญญาณ และการพัฒนาอัลกอริทึมมากกว่าสองทศวรรษ ก่อนก่อตั้ง Kardome เขาเป็น CTO ของ Silentium Ltd. และนำความร่วมมือด้านวิจัยและพัฒนากับบริษัท Tier 1 และสถาบันวิจัย Cherkassky สำเร็จปริญญาเอกด้านการประมวลผลอาร์เรย์ไมโครโฟนจากมหาวิทยาลัย Bar-Ilan และมุ่งขจัดความติดขัดของการสื่อสารด้วยเสียงสมัยใหม่ ด้วยเทคโนโลยีที่ฟังผู้คนจริง ๆ แทนที่จะฟังเสียงรบกวนรอบตัว
Kardome บุกเบิกโซลูชันการได้ยินเชิงพื้นที่ด้วย AI เพื่อให้การโต้ตอบด้วยเสียงชัดเจนและเฉพาะบุคคลในทุกสภาพแวดล้อม ตั้งแต่รถยนต์ ห้องประชุม บ้านอัจฉริยะ ไปจนถึงพื้นที่สาธารณะ เทคโนโลยีจัดกลุ่มเสียงพูดที่เป็นกรรมสิทธิ์จะแยกเสียงตามตำแหน่ง ทำให้อุปกรณ์เข้าใจผู้พูดแต่ละคนเสมือนมีเพียงคนเดียวกำลังพูด แพลตฟอร์มไม่ผูกกับฮาร์ดแวร์และพร้อมทำงานบนอุปกรณ์ปลายทาง ช่วยเพิ่มความแม่นยำ ความปลอดภัย และประสบการณ์ผู้ใช้สำหรับการสื่อสารระหว่างมนุษย์กับเครื่องจักรรุ่นใหม่
อะไรเป็นแรงบันดาลใจให้คุณกับ Dr. Alon Slapak ร่วมก่อตั้ง Kardome?
แรงบันดาลใจเกิดจากทั้งความหลงใหลและความผิดหวัง ด้วยพื้นฐานด้านคำพูดและเสียงทั้งในวงวิชาการและอุตสาหกรรม เราตื่นเต้นกับความก้าวหน้าของการรู้จำเสียง โดยเฉพาะเมื่อโครงข่ายประสาทเทียมเชิงลึกเข้ามามีบทบาท
เทคโนโลยีทำงานยอดเยี่ยมในห้องทดลองที่เงียบ แต่ทันทีที่ออกสู่โลกจริง ความมหัศจรรย์นั้นก็หายไป ในรถที่มีเสียงดัง สำนักงานที่วุ่นวาย หรือบ้านที่มีเสียงสับสน ระบบล้ำสมัยแทบไม่ดีกว่าเทคโนโลยีในทศวรรษ 1990 นี่คืออุปสรรคใหญ่ต่อความก้าวหน้า
เสียงคือวิธีสื่อสารกับอุปกรณ์ที่เป็นธรรมชาติที่สุด และเป็นผู้สืบทอดที่แท้จริงของหน้าจอสัมผัส แต่เทคโนโลยีต้องรับมือกับความวุ่นวายในชีวิตจริงได้ เราจึงตั้งสิ่งนี้เป็นภารกิจและใช้เวลาหนึ่งปีในโรงรถ แก้สมการการแพร่กระจายคลื่นเสียงและทดสอบแนวคิดใหม่ จนเกิดความก้าวหน้าครั้งสำคัญ คือการสาธิตครั้งแรกของสิ่งที่ปัจจุบันเรียกว่า Spatial Hearing Technology ของ Kardome
ตอนนั้นเรารู้ว่าเราพบกุญแจสำคัญ เราก่อตั้ง Kardome เพื่อเริ่มการปฏิวัติวิธีที่คนและเครื่องจักรสื่อสารกัน ไม่ใช่เพียงสร้างผลิตภัณฑ์
ผู้ช่วยเสียงจำนวนมากทำงานได้ไม่ดีเมื่อเสียงพูดทับกันหรือมีเสียงรบกวน เหตุใดวิธีแบบเดิมจึงล้มเหลวในโลกจริง?
ส่วนติดต่อผู้ใช้ด้วยเสียงแบบเดิมใช้วิธีเข้าใจเสียงที่เรียบง่ายเกินไป ระบบส่วนใหญ่ใช้ไมโครโฟนหลายตัวระบุทิศทางที่เสียงเดินทางมา จึงสนใจเพียงมุมและละเลยข้อมูลเชิงพื้นที่สามมิติอื่น ๆ วิธีนี้ล้มเหลวในรถ สำนักงาน หรือห้องนั่งเล่น เพราะสภาพแวดล้อมเหล่านี้เต็มไปด้วยเสียงก้องจากคลื่นเสียงที่สะท้อนทุกพื้นผิว สำหรับระบบที่เข้าใจเพียงทิศทาง เสียงสะท้อนแต่ละครั้งดูเหมือนเป็นเสียงใหม่จากตำแหน่งอื่น
จึงเกิดผลราวกับอุปกรณ์อยู่ในห้อง “กระจกสะท้อนเสียง” ซึ่งเสียงเดียวดูเหมือนมาจากหลายร้อยทิศพร้อมกัน ระบบแยกเสียงผู้พูดออกจากพายุเสียงสะท้อนไม่ได้และถอดรหัสสภาพแวดล้อมทางเสียงไม่สำเร็จ ข้อจำกัดพื้นฐานนี้ทำให้เทคโนโลยีเสียงปัจจุบันรับรู้เสียงในสถานการณ์จริงที่วุ่นวายได้ไม่ดีและทำงานไม่น่าเชื่อถือ
เทคโนโลยีของ Kardome ปฏิบัติต่อแต่ละคนเสมือนเป็นผู้พูดเพียงคนเดียวในห้อง ความก้าวหน้าทางเทคนิคใดทำให้ทำได้ และต่างจากการรู้จำเสียงระยะไกลทั่วไปอย่างไร?
ความก้าวหน้าของเราคือ Spatial Hearing AI ซึ่งก้าวพ้นวิธีที่ตรวจเพียงทิศทางของเสียงไปสู่การระบุตำแหน่งที่แม่นยำในพื้นที่สามมิติ ระบบวิเคราะห์รูปแบบการสะท้อนทั้งหมดที่เสียงหนึ่งสร้างภายในห้อง และมองวิธีที่เสียงสะท้อนจากพื้นผิวเป็น “ลายนิ้วมือทางเสียง” เฉพาะตำแหน่ง AI อนุมานลายนิ้วมือนี้ให้ทุกแหล่งเสียงทันทีโดยไม่ต้องมีการกระตุ้น และสร้างแผนที่สภาพแวดล้อม วิธีอิงตำแหน่งนี้ต่างจากระบบที่อิงทิศทางซึ่งสับสนกับเสียงสะท้อน ขณะที่ระบบเดิมได้ยินผู้พูดคนเดียวเป็นฝูงเสียงสะท้อน เทคโนโลยีของเราใช้รูปแบบสะท้อนทั้งหมดเพื่อระบุแหล่งจริง อุปกรณ์ที่ใช้ Kardome จึงเลือกฟังคนหนึ่งในสภาพแวดล้อมที่มีเสียงดังได้เสมือนเขาพูดคนเดียวในห้องเงียบ นอกจากนี้ Cognition AI ยังช่วยให้ระบบเข้าใจว่าใครพูดและคำพูดนั้นหมายถึงอะไรในบริบท ไม่ใช่เพียงได้ยินถ้อยคำ
มีผู้กล่าวว่า Voice AI กำลังมาถึง “ช่วงเวลา iPhone” สำหรับคุณหมายถึงอะไร และเราใกล้การใช้งานในวงกว้างเพียงใด?
สำหรับผม หมายถึงเสียงพร้อมจะเป็นวิธีหลักที่เราใช้โต้ตอบกับอุปกรณ์คอมพิวเตอร์ ผู้ผลิตกำลังเร่งนำ Voice AI ไปใช้ในสายผลิตภัณฑ์ทั้งหมด รถยนต์เปลี่ยนเป็นส่วนติดต่อที่ใช้เสียงเป็นหลักเพื่อความปลอดภัย บ้านอัจฉริยะต้องใช้เสียงเพราะติดหน้าจอสัมผัสทุกแห่งไม่ได้ และอุปกรณ์อิเล็กทรอนิกส์ทั่วไปก็เพิ่มเสียงเพราะรวดเร็วกว่าการไล่เมนู แต่การปฏิวัติที่แท้จริงจะมาจากหุ่นยนต์ เมื่อหุ่นยนต์เข้ามาอยู่ในบ้านและที่ทำงาน เสียงจะเป็นส่วนติดต่อที่มีประสิทธิภาพและเป็นธรรมชาติอย่างแท้จริงเพียงอย่างเดียว
เพื่ออยู่ร่วมกันอย่างราบรื่น หุ่นยนต์ต้องเข้าใจเราในระดับมนุษย์ ทั้งบริบทและนัยของภาษาธรรมชาติ ไม่ใช่เพียงคำสำคัญ ต้องรับรู้พื้นที่แม่นยำจนดูเหมือนเวทมนตร์ โดยรู้เองว่า คุณ กำลังพูดกับ มัน แม้อยู่ในห้องเสียงดัง และความฉลาดนี้ต้องทำงานบนอุปกรณ์เพื่อการสื่อสารที่ทันที เป็นส่วนตัว และเชื่อถือได้
นี่คือการเปลี่ยนแปลงพื้นฐานของปฏิสัมพันธ์ระหว่างมนุษย์กับเครื่องจักร ผมคิดว่าเราอยู่ห่างจากจุดเปลี่ยนที่เสียงกลายเป็นส่วนติดต่อที่ทุกคนคาดหวัง แทนที่จะเป็นเพียงคุณสมบัติเสริม ราว 24 เดือน
ในทางปฏิบัติ Spatial Hearing และ Cognition AI จะเปลี่ยนอุปกรณ์ประจำวันอย่างรถยนต์ บ้านอัจฉริยะ อุปกรณ์สวมใส่ และพื้นที่สาธารณะอย่างไร?
เป้าหมายคือทำให้โต้ตอบได้อย่างเป็นธรรมชาติทุกที่โดยไม่ต้องปรับพฤติกรรมให้เข้ากับเทคโนโลยี ในรถ หมายถึงการควบคุมแบบไม่ใช้มือที่ทำงานได้ขณะวิ่งบนทางหลวง เปิดเพลง และมีผู้โดยสารคุยกัน บ้านอัจฉริยะจะฉลาดจริงเมื่อรู้ว่าใครพูดและพูดจากที่ใด พร้อมรับคำขอหลายรายการโดยไม่สับสน
Spatial Hearing AI ไม่เพียงปรับปรุงการรู้จำเสียง แต่เปิดรูปแบบปฏิสัมพันธ์ใหม่ เมื่ออุปกรณ์เข้าใจฉากเสียงทั้งหมด มันเข้าร่วมการสื่อสารตามธรรมชาติของมนุษย์ได้โดยไม่ต้องพึ่งข้อจำกัดที่สร้างขึ้น อุปกรณ์สวมใส่จะมีประโยชน์ขึ้นเมื่อแยกเสียงของคุณจากบทสนทนารอบข้าง และพื้นที่สาธารณะให้ความช่วยเหลือด้วยเสียงที่เฉพาะบุคคลแต่เป็นส่วนตัวได้ เช่นเดียวกับหุ่นยนต์ นี่คือการเปลี่ยนแปลงพื้นฐานของปฏิสัมพันธ์กับเครื่องจักรที่เข้ามาในชีวิตเรา
ความเป็นส่วนตัวเป็นข้อกังวลของอุปกรณ์ที่ฟังตลอดเวลา Kardome สร้างสมดุลระหว่างการประมวลผลบนอุปกรณ์กับประสิทธิภาพและความแม่นยำอย่างไร?
โซลูชัน Voice AI ส่วนใหญ่ใช้โมเดลผสมระหว่างส่วนที่ทำงานบนอุปกรณ์ (edge) กับส่วนบนคลาวด์ การประมวลผลบนอุปกรณ์ไม่สร้างปัญหาความเป็นส่วนตัวเพราะข้อมูลไม่ออกจากอุปกรณ์ แต่การประมวลผลบนคลาวด์เป็นความท้าทายใหญ่ Kardome ขยายความสามารถของส่วน edge อย่างมาก ประมวลผลข้อมูลในเครื่องมากขึ้นและพึ่งคลาวด์น้อยลง ทำให้ข้อมูลเสียงอ่อนไหวไม่ออกจากอุปกรณ์ และปกป้องความเป็นส่วนตัวได้เหนือกว่าระบบอื่น
ความเสี่ยงของอุปกรณ์ “ฟังตลอดเวลา” ไม่ใช่ไมโครโฟนรับเสียง แต่คือเสียงอาจถูกอัปโหลดไปวิเคราะห์บนคลาวด์ ในทางปฏิบัติ ค่าใช้จ่ายของการประมวลผลบนคลาวด์ต่อเนื่องสูงจนระบบเชิงพาณิชย์ส่วนใหญ่หลีกเลี่ยง แต่ต้องแลกด้วยส่วนติดต่อเสียงที่คุณภาพต่ำและตอบสนองช้า
Kardome แก้ข้อแลกเปลี่ยนนี้ด้วยโมเดลภาษาทรงพลังที่เปิดทำงานตลอดบนอุปกรณ์ ฉากเสียง ภาษาธรรมชาติ และบริบททั้งหมดถูกวิเคราะห์แบบเรียลไทม์ในอุปกรณ์ โดยไม่มีข้อมูลเสียงถูกอัปโหลดหรือบันทึก จึงมอบทั้งความเป็นส่วนตัวที่แข็งแกร่งและส่วนติดต่อเสียงที่มีประสิทธิภาพสูง
เมื่อมองทั้งอุตสาหกรรม อุปสรรคใหญ่ที่สุดก่อน Voice AI จะเป็นส่วนติดต่อหลักในสินค้าอิเล็กทรอนิกส์คืออะไร?
อุปสรรคใหญ่คือ Voice AI ยังสื่อสารไม่เหมือนมนุษย์ ตราบใดที่มันยังฟังและเข้าใจแบบมนุษย์ไม่ได้ ทั้งการรับรู้บริบทและลำดับบทสนทนา มันจะยังไม่เป็นส่วนติดต่อหลัก อีกอุปสรรคคือเทคโนโลยีส่วนใหญ่ทำงานบนคลาวด์ จึงฟังอย่างต่อเนื่องไม่ได้และไม่อาจเข้าใจการไหลของบทสนทนา จุดเปลี่ยนจะเกิดเมื่อระบบเสียงเข้าใจบริบทการสนทนาอย่างแท้จริงและตอบสนองด้วยความเข้าใจโดยสัญชาตญาณแบบมนุษย์ เมื่อนั้นเสียงจะเป็นส่วนติดต่อหลักของสินค้าอิเล็กทรอนิกส์ทั้งหมด
ความสัมพันธ์ของผู้บริโภคกับผู้ช่วยเสียงจะเปลี่ยนอย่างไรเมื่อแก้ปัญหาความแม่นยำและความน่าเชื่อถือในสภาพแวดล้อมที่มีเสียงดังแล้ว?
เมื่อระบบน่าเชื่อถือและสนทนาเป็นธรรมชาติ ผู้ช่วยเสียงจะเปลี่ยนจากลูกเล่นเป็นส่วนติดต่อจำเป็นที่ผู้คนพึ่งพาตลอดวัน เมื่อรู้ว่า Voice AI จะเข้าใจถูกตั้งแต่ครั้งแรกแม้ในสภาพแวดล้อมยาก ผู้ใช้จะหยุดปรับตัวเข้าหาเทคโนโลยีและใช้มันโดยสัญชาตญาณ ด้วยภาษาธรรมชาติและบทสนทนาที่มีบริบท
อนาคตของการโต้ตอบด้วยเสียงจะคาดการณ์และลงมือเชิงรุกได้ ลองนึกว่าอุปกรณ์เข้าใจทั้งคำพูด น้ำเสียง สัญญาณอารมณ์ และความหมายแฝง ระบบปัจจุบันรับมือจังหวะธรรมชาติของบทสนทนา การขัดจังหวะ การสลับผู้พูด และบริบทได้ไม่ดี มนุษย์ปรับตัวเมื่อถูกขัดจังหวะ แต่ Voice AI มักสับสน สำหรับผู้ผลิต ความท้าทายคือผสาน Voice AI ที่มอบประสบการณ์อนาคตนี้ได้โดยไม่มีความซับซ้อนและข้อกำหนดฮาร์ดแวร์แบบโซลูชันปัจจุบัน
สุดท้าย คุณมอง Kardome และระบบนิเวศ Voice AI ในอีกห้าปีอย่างไร และหมุดหมายใดจะบอกว่าเราเข้าสู่ยุคคอมพิวเตอร์ที่ใช้เสียงเป็นหลักจริงแล้ว?
อีกห้าปี Voice AI จะแพร่หลายเท่าหน้าจอสัมผัสและแป้นพิมพ์ในวันนี้ และจะเป็นสิ่งที่คาดหวังในอุปกรณ์คอมพิวเตอร์แทบทุกชนิด Kardome จะเป็นระบบปฏิบัติการที่ทำให้ผู้ใช้ควบคุมอุปกรณ์ด้วยเสียง และโต้ตอบตามธรรมชาติกับอุปกรณ์ทุกชนิดในทุกสภาพแวดล้อม ตั้งแต่หุ่นยนต์ แว่นตาอัจฉริยะ ไปจนถึงรถยนต์
หมุดหมายสำคัญจะเป็นด้านพฤติกรรมมากกว่าเทคโนโลยี เราจะรู้ว่าเข้าสู่ยุคเสียงเป็นหลักเมื่อผู้คนเลิกคิดถึง “คำสั่งเสียง” และเริ่มสนทนากับสภาพแวดล้อมอย่างเป็นธรรมชาติ เมื่อพื้นที่ที่มีผู้ใช้หลายคนทำงานได้ราบรื่น และเมื่อเด็กเติบโตโดยคาดหวังว่าจะพูดกับอุปกรณ์ใดก็ได้ ตัววัดสูงสุดไม่ใช่ว่าเทคโนโลยีซับซ้อนเพียงใด แต่คือมนุษย์โต้ตอบกับโลกดิจิทัลได้เป็นธรรมชาติเพียงใด
ขอบคุณสำหรับบทสัมภาษณ์ที่ยอดเยี่ยม ผู้อ่านที่ต้องการเรียนรู้เพิ่มเติมสามารถเยี่ยมชม Kardome




