
ที่ดีที่สุด
10 เครื่องมือขูดข้อมูลเว็บด้วย AI ที่ดีที่สุด (พฤศจิกายน 2026)

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
Unite.AI อาจได้รับค่าตอบแทนเมื่อคุณใช้ลิงก์ไปยังผลิตภัณฑ์ที่เรารีวิว ทั้งนี้ไม่ส่งผลต่อการประเมินของกองบรรณาธิการ อ่าน การเปิดเผยข้อมูลพันธมิตรของเรา.
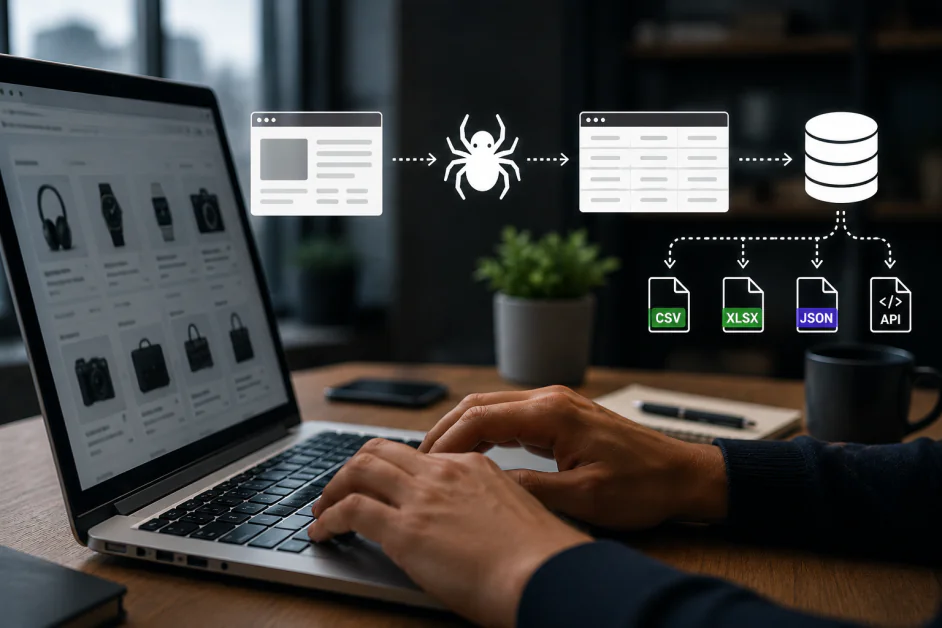
เครื่องมือขูดข้อมูลเว็บด้วย AI ที่ดีที่สุดขึ้นอยู่กับว่าคุณต้องการทำอะไรหลังจากหน้าเว็บโหลดแล้ว ผู้ช่วยวิจัยต้องการเนื้อหาที่อ่านเข้าใจง่ายและลิงก์ไปยังแหล่งที่มา ส่วนระบบวิเคราะห์ข้อมูลตลาดต้องการระเบียนที่สม่ำเสมอในปริมาณมาก ขณะที่เอเจนต์แบบโต้ตอบอาจต้องใช้เบราว์เซอร์ที่คลิกผ่านหลายขั้นตอนได้และคงเซสชันไว้ต่อเนื่อง
คู่มือนี้ครอบคลุมเครื่องมือ 10 รายการที่ตอบโจทย์งานเหล่านี้ ตั้งแต่แพลตฟอร์มรวบรวมข้อมูลสำหรับองค์กร, API ด้านเนื้อหา, เครื่องมือขูดข้อมูลแบบไม่ต้องเขียนโค้ด, บริการข้อมูลจากการค้นหา ไปจนถึงเบราว์เซอร์ที่มีบริการจัดการให้ เราประเมินวิธีที่ผลิตภัณฑ์แต่ละรายการใช้รวบรวมข้อมูล ผู้ที่สามารถดูแลเวิร์กโฟลว์ และข้อแลกเปลี่ยนที่ควรคำนึงถึงเมื่อเปลี่ยนต้นแบบให้เป็นกระบวนการที่ทำซ้ำเป็นประจำ
ทีมงานของเราประเมินโซลูชันทุกตัวในคู่มือนี้อย่างเป็นอิสระ โดยพิจารณาความสามารถ จุดเด่นในการใช้งานจริง ข้อจำกัด และความเหมาะสมกับกรณีการใช้งานที่สะท้อนอยู่ในอันดับของเรา
เปรียบเทียบเครื่องมือขูดข้อมูลเว็บด้วย AI ที่ดีที่สุด
| เครื่องมือ AI | เหมาะที่สุดสำหรับ | จุดเด่นสำคัญ |
|---|---|---|
| Bright Data | การรวบรวมข้อมูลระดับองค์กรและไปป์ไลน์ข้อมูลที่หลากหลาย | API สำหรับขูดข้อมูล, Browser API, Scraper Studio, ชุดข้อมูล, พร็อกซี |
| Firecrawl | เนื้อหาเว็บสำหรับแอปพลิเคชัน AI | ค้นหา, ขูดข้อมูล, ทำแผนที่, รวบรวมข้อมูล, Markdown, JSON, โต้ตอบ, MCP |
| Apify | งานขูดข้อมูลที่นำกลับมาใช้ซ้ำได้และการจัดการระบบบนคลาวด์ | Actors, Crawlee, กำหนดเวลา, พื้นที่จัดเก็บ, พร็อกซี, API, MCP |
| Browse AI | การรวบรวมข้อมูลแบบไม่ต้องเขียนโค้ดและการติดตามการเปลี่ยนแปลง | การตั้งค่าด้วย AI, หุ่นยนต์, การแจ้งเตือน, กำหนดเวลา, การผสานการทำงาน |
| SearchAPI | ผลการค้นหาแบบมีโครงสร้างและการวิจัยเฉพาะพื้นที่ | Google, Maps, การช็อปปิง, วิดีโอ, แพลตฟอร์มค้นหาด้วย AI, JSON |
| Octoparse | การขูดข้อมูลด้วยเครื่องมือภาพและการทำงานบนคลาวด์ที่ทำซ้ำได้ | เทมเพลต, ผู้ช่วย AI, การตรวจจับอัตโนมัติ, การทำงานบนคลาวด์, การส่งออก |
| Browserless | เบราว์เซอร์ที่มีบริการจัดการให้สำหรับ Puppeteer และ Playwright | เบราว์เซอร์ที่ให้บริการบนคลาวด์, เซสชันต่อเนื่อง, REST API, MCP |
| ScrapingBee | การดึงข้อมูลที่มีบริการจัดการให้ผ่าน API ของแอปพลิเคชัน | การดึงข้อมูลด้วย AI, CSS/XPath, Markdown, สถานการณ์การทำงานด้วย JS, MCP |
| Oxylabs | บริการดึงข้อมูลจากเว็บไซต์สาธารณะที่มีข้อกำหนดซับซ้อน | Web API /Scrape, การเรนเดอร์, ผลลัพธ์แบบมีโครงสร้าง, MCP |
| Diffbot | การดึงข้อมูลอัตโนมัติและการวิเคราะห์ข้อมูลเอนทิตี | ดึงข้อมูล, สคีมามาตรฐาน, รวบรวมข้อมูล, กราฟความรู้ |
วิธีเลือกเครื่องมือขูดข้อมูลเว็บด้วย AI
เลือกเครื่องมือให้เหมาะกับงาน
หากสร้างฐานความรู้ AI ให้เน้นข้อความที่อ่านเข้าใจง่าย ผลลัพธ์แบบมีโครงสร้าง และการเก็บ URL ของแหล่งที่มาไว้ หากทำวิจัยทางธุรกิจซ้ำเป็นประจำ หุ่นยนต์ที่ควบคุมด้วยภาพและการแจ้งเตือนเมื่อมีการเปลี่ยนแปลงอาจสำคัญกว่าอินเทอร์เฟซสำหรับเขียนโปรแกรม ส่วนเอเจนต์แบบโต้ตอบควรพิจารณาความต่อเนื่องของเซสชันและการควบคุมเบราว์เซอร์ API ผลการค้นหาแก้ปัญหาอีกแบบหนึ่ง โดยให้ข้อมูลการค้นหา ส่วนการรวบรวมข้อมูลจากหน้าเว็บที่ลิงก์ไปถึงเป็นขั้นตอนแยกต่างหาก
กำหนดว่าใครเป็นผู้ดูแลเวิร์กโฟลว์
แพลตฟอร์มแบบไม่ต้องเขียนโค้ดช่วยให้นักวิเคราะห์ปรับขั้นตอนการดึงข้อมูลได้โดยตรง ส่วน API มีอินเทอร์เฟซที่ใช้งานง่ายสำหรับนักพัฒนาในการผสานการรวบรวมข้อมูลเข้ากับแอปพลิเคชัน แพลตฟอร์มงานบนคลาวด์เพิ่มความสามารถในการตั้งเวลาและจัดเก็บข้อมูล ขณะที่เบราว์เซอร์ที่มีบริการจัดการให้ทำให้ทีมของคุณต้องรับผิดชอบตรรกะการทำงานอัตโนมัติมากขึ้น ตัวเลือกที่เหมาะสมจะมอบหมายการดูแลรักษาให้กับผู้ที่เข้าใจทั้งเว็บไซต์ต้นทางและรูปแบบผลลัพธ์ที่ต้องการ
ตั้งงบประมาณตามระเบียนที่นำไปใช้ได้ ไม่ใช่จำนวนคำขอที่ใช้พาดหัว
เปรียบเทียบค่าใช้จ่ายของงานที่เสร็จสมบูรณ์กับฟิลด์ข้อมูลที่คุณต้องการ การเรนเดอร์ พร็อกซีพรีเมียม ระยะเวลาการใช้เบราว์เซอร์ การดึงข้อมูลด้วย AI พื้นที่จัดเก็บ และการลองซ้ำ ล้วนส่งผลต่อต้นทุนรวม เครดิตใช้ฟรี หน่วยการใช้งานเบราว์เซอร์ และคำขอค้นหาเป็นหน่วยวัดคนละแบบ สำหรับงานที่ทำซ้ำเป็นประจำ ให้ติดตามความครบถ้วน ข้อมูลซ้ำ ความใหม่ของข้อมูล และต้นทุนต่อระเบียนที่นำไปใช้ได้ ควบคู่ไปกับจำนวนการตอบกลับที่สำเร็จ
10 เครื่องมือขูดข้อมูลเว็บด้วย AI ที่ดีที่สุด
1. Bright Data
Bright Data เป็นตัวเลือกแนะนำโดยรวมของเราสำหรับองค์กรที่ต้องการช่องทางหลากหลายในการรวบรวมข้อมูลเว็บผ่านแพลตฟอร์มเดียว โดยมีทั้ง API สำหรับขูดข้อมูลที่พร้อมใช้งาน ชุดข้อมูลที่รวบรวมไว้ล่วงหน้า Scraper Studio, Web Unlocker และบริการพร็อกซี ตัวอย่างเช่น ทีมวิเคราะห์ข้อมูลอีคอมเมิร์ซอาจใช้ฟีดข้อมูลแบบมีโครงสร้างกับร้านค้าปลีกที่คุ้นเคย พร้อมกับสร้างระบบรวบรวมข้อมูลแบบกำหนดเองสำหรับมาร์เก็ตเพลสเฉพาะทาง ความครอบคลุมนี้ทำให้แพลตฟอร์มมีประโยชน์เป็นพิเศษเมื่อโครงการด้านข้อมูลขยายไปไกลกว่าเว็บไซต์เดียวหรือแผนกเดียว
สำหรับหน้าเว็บที่มีการโต้ตอบ Browser API จะเปิดเบราว์เซอร์ที่นักพัฒนาควบคุมได้ด้วย Puppeteer, Playwright หรือ Selenium โดยผสานการทำงานของเบราว์เซอร์เข้ากับการจัดการพร็อกซีและการรับมือ CAPTCHA ขณะที่รองรับ Chrome DevTools เพื่อช่วยให้วิศวกรตรวจสอบเซสชันที่มีปัญหาได้ ฟีเจอร์นี้มีประโยชน์เมื่อเวิร์กโฟลว์ต้องนำทางหรือโต้ตอบกับหน้าเว็บก่อนที่ข้อมูลที่ต้องการจะปรากฏ แทนที่จะดาวน์โหลดชุดข้อมูลที่มีอยู่แล้วเพียงอย่างเดียว
ข้อแลกเปลี่ยนหลักอยู่ที่การเลือกผลิตภัณฑ์และการจัดการค่าใช้จ่าย ปริมาณการใช้งานเบราว์เซอร์ ผลลัพธ์จากการดึงข้อมูลเว็บ และการซื้อชุดข้อมูลเป็นภาระงานคนละประเภท จึงไม่อาจใช้ราคาแรกเห็นเพียงราคาเดียวอธิบายแพลตฟอร์มทั้งหมดได้ Bright Data เหมาะกับทีมที่มีผู้รับผิดชอบคุณภาพการเก็บข้อมูล ขอบเขตของแหล่งข้อมูลเป้าหมาย และงบประมาณ ส่วนโครงการที่มีขอบเขตแคบอาจนำระบบขึ้นใช้งานจริงได้เร็วกว่าโดยใช้ API สำหรับดึงข้อมูลที่เรียบง่ายกว่า
ข้อดีและข้อเสีย
- มีตัวเลือกการเก็บข้อมูลหลากหลายในแพลตฟอร์มเดียว
- เบราว์เซอร์ที่ให้บริการบนคลาวด์รองรับไลบรารีระบบอัตโนมัติที่ใช้กันแพร่หลาย
- API และชุดข้อมูลที่พร้อมใช้งานช่วยลดเวลาในการตั้งค่า
- ผลิตภัณฑ์แต่ละประเภทต้องวางแผนค่าใช้จ่ายแยกกัน
- ไปป์ไลน์แบบกำหนดเองยังต้องมีวิศวกรรับผิดชอบ
2. Firecrawl
Firecrawl คือตัวเลือกที่เราแนะนำสำหรับนักพัฒนาที่ต้องการเปลี่ยนเนื้อหาบนเว็บให้เป็นบริบทที่มีประโยชน์สำหรับแอปพลิเคชัน AI เครื่องมือค้นหา ดึงข้อมูล ทำแผนที่ และรวบรวมข้อมูลเว็บไซต์ครอบคลุมตั้งแต่การค้นหาหน้าเว็บไปจนถึงการเก็บข้อมูลทั้งเว็บไซต์ ขณะที่ Markdown และ JSON แบบมีโครงสร้างช่วยลดงานทำความสะอาดข้อมูลหลังดึงมาได้ ผู้ช่วยวิจัยหรือผลิตภัณฑ์ฐานความรู้จึงทุ่มเทกับการตอบคำถามได้มากขึ้น และใช้เวลาน้อยลงในการลบเมนูนำทางออกจาก HTML ดิบ
ฟีเจอร์ Interact ซึ่งปัจจุบันมีให้ใช้งานช่วยขยายแพลตฟอร์มไปสู่การทำงานกับเบราว์เซอร์แบบเรียลไทม์ เอเจนต์สามารถอธิบายการกระทำด้วยภาษาธรรมชาติหรือเรียกใช้โค้ดในเบราว์เซอร์ รักษาสถานะระหว่างการเรียกใช้งานแต่ละครั้ง และนำโปรไฟล์ที่ผ่านการยืนยันตัวตนแล้วกลับมาใช้ซ้ำได้ นี่เป็นส่วนเสริมที่สำคัญสำหรับหน้าเว็บที่ต้องคลิก ใช้ตัวกรอง หรือเข้าสู่ระบบก่อนดึงข้อมูล นอกจากนี้ การเข้าถึงผ่าน MCP และบรรทัดคำสั่งยังทำให้ Firecrawl ใช้งานได้สะดวกในเวิร์กโฟลว์การพัฒนาเอเจนต์ ไม่ได้จำกัดอยู่แค่ API สำหรับแอปพลิเคชันทั่วไป
Firecrawl เหมาะที่สุดเมื่อโจทย์เร่งด่วนคือการรวบรวมเนื้อหา และแอปพลิเคชันมีระบบจัดเก็บและเรียกค้นข้อมูลอยู่แล้ว ทีมยังต้องกำหนดขอบเขตการรวบรวมข้อมูล เก็บ URL ของแหล่งที่มาไว้ และแยกให้ออกระหว่างฟิลด์ที่ไม่มีข้อมูลกับฟิลด์ที่มีค่าว่าง โค้ดโอเพนซอร์สยังเปิดทางเลือกในการติดตั้งใช้งานอีกแบบหนึ่ง แต่ทีมควรประเมินฟีเจอร์และข้อกำหนดด้านการปฏิบัติงานของรูปแบบการติดตั้งที่เลือกโดยเฉพาะ แทนที่จะคิดว่ารุ่นที่ให้บริการบนคลาวด์กับรุ่นที่จัดการเองเหมือนกันทุกประการ
ข้อดีและข้อเสีย
- Markdown และ JSON เหมาะกับไปป์ไลน์ AI
- Interact รองรับงานกับเบราว์เซอร์ที่ต้องรักษาสถานะ
- เข้าถึงได้ผ่าน API, MCP และ CLI
- เนื้อหาที่ดึงมายังต้องผ่านการตรวจสอบ
- การติดตั้งใช้งานที่จัดการเองต้องอาศัยการดูแลระบบ
3. Apify
Apify เป็นตัวเลือกที่โดดเด่นที่สุดในบรรดาเครื่องมือที่กล่าวถึงสำหรับทีมที่ต้องการเครื่องมือดึงข้อมูลเว็บซึ่งนำกลับมาใช้ซ้ำได้ พร้อมแพลตฟอร์มสำหรับจัดการและเรียกใช้เครื่องมือเหล่านั้น ตลาดของ Apify มี Actors ซึ่งเป็นโปรแกรมสำเร็จรูปที่รับข้อมูลนำเข้า ทำงานบนคลาวด์ และส่งผลลัพธ์กลับมา Actors ที่มีอยู่แล้วช่วยเร่งงานเก็บข้อมูลทั่วไปได้ ส่วน Actors แบบกำหนดเองเปิดโอกาสให้นักพัฒนานำตรรกะการดึงข้อมูลของตนมาใช้ต่อได้ Apify จึงเป็นตัวเชื่อมที่มีประโยชน์ระหว่างการทดลองกับงานที่เรียกใช้ซ้ำได้ในระบบจริง
แพลตฟอร์มยังจัดการองค์ประกอบสำคัญในการปฏิบัติงาน เช่น การตั้งเวลา การจัดเก็บผลลัพธ์ การเข้าถึงพร็อกซี การติดตามตรวจสอบ และการเชื่อมต่อกับระบบอื่น นักพัฒนายังสร้างเครื่องมือด้วย Crawlee ซึ่งเป็นไลบรารีโอเพนซอร์สสำหรับรวบรวมข้อมูลเว็บและควบคุมเบราว์เซอร์แบบอัตโนมัติได้ด้วย เซิร์ฟเวอร์ MCP ของ Apify เปิดให้เอเจนต์ AI เรียกใช้ Actors ได้ ดังนั้นเครื่องมือสำเร็จรูปตัวเดียวกันจึงใช้ได้กับแอปพลิเคชัน ไปป์ไลน์ที่ตั้งเวลาไว้ หรือผู้ช่วย โดยไม่ต้องพัฒนาตัวดึงข้อมูลแยกสำหรับแต่ละช่องทาง
การเลือก Actor สำคัญพอ ๆ กับการเลือกแพลตฟอร์ม ผู้เผยแพร่แต่ละรายอาจมีราคา การบำรุงรักษา ตัวเลือกข้อมูลนำเข้า และคุณภาพของผลลัพธ์แตกต่างกัน การทำงานสำเร็จหนึ่งครั้งก็ไม่ได้ยืนยันว่าเก็บระเบียนที่คาดหวังไว้ได้ครบทุกระเบียน Apify เหมาะอย่างยิ่งเมื่อมีผู้รับผิดชอบสคีมาของงาน คอยติดตามการเปลี่ยนแปลง และจัดสรรงบประมาณสำหรับ Actor ที่เลือกกับการใช้งานโครงสร้างพื้นฐาน ส่วนการดึงข้อมูลจากหน้าเดียวด้วยตนเองแทบไม่จำเป็นต้องใช้ระบบจัดการที่ซับซ้อนเช่นนี้
ข้อดีและข้อเสีย
- ใช้ Actors สำเร็จรูปและแบบกำหนดเองร่วมกันบนแพลตฟอร์มเดียว
- การตั้งเวลา การจัดเก็บ และการติดตามตรวจสอบช่วยรองรับงานที่เรียกใช้ซ้ำได้
- MCP ช่วยให้ใช้ Actors ในเวิร์กโฟลว์ของเอเจนต์ได้
- การบำรุงรักษาและคุณภาพของ Actors แตกต่างกันไป
- ต้องจัดทำงบประมาณสำหรับค่าใช้งานและค่า Actor
4. Browse AI
Browse AI เป็นตัวเลือกที่เราแนะนำสำหรับผู้ใช้ในภาคธุรกิจที่ต้องการรวบรวมข้อมูลจากเว็บเป็นประจำ โดยไม่ต้องสร้างโปรเจกต์ซอฟต์แวร์ การตั้งค่าปัจจุบันสามารถอ่านหน้าเว็บที่ระบุ เสนอโครงสร้างข้อมูล และให้ผู้ใช้ตรวจสอบหรือปรับฟิลด์ได้ การฝึกโรบอตยังคงเป็นหัวใจสำคัญของการดึงข้อมูลที่ทำซ้ำได้ วิธีนี้เหมาะสำหรับทีมปฏิบัติการและการตลาดที่รวบรวมรายการสินค้า รายการในไดเรกทอรี หรือข้อมูลคู่แข่งลงในตารางที่คุ้นเคย
การติดตามตรวจสอบเป็นจุดแข็งอย่างหนึ่ง โรบอตสามารถตรวจสอบหน้าเว็บตามกำหนดเวลา ระบุรายการที่เพิ่มเข้ามาหรือการเปลี่ยนแปลง และส่งการแจ้งเตือนพร้อมอธิบายสิ่งที่เปลี่ยนไปได้ เวิร์กโฟลว์ช่วยเชื่อมโยงการรวบรวมข้อมูลจากหลายหน้า ส่วนการเชื่อมต่อกับ API เว็บฮุก และสเปรดชีตช่วยส่งผลลัพธ์ไปยังเครื่องมือที่ทีมใช้อยู่แล้วได้ ดังนั้น เวิร์กโฟลว์ติดตามราคาจึงพัฒนาเป็นกระบวนการทางธุรกิจที่ดำเนินต่อเนื่องได้ แทนที่จะเป็นการตรวจสอบผ่านเบราว์เซอร์ด้วยตนเองซ้ำ ๆ
แม้จะใช้งานได้สะดวก ก็ยังต้องกำหนดข้อมูลให้ชัดเจน ผู้ใช้ควรตัดสินใจว่าการเปลี่ยนแปลงใดควรได้รับการแจ้งเตือน และตรวจสอบว่าการแบ่งหน้า ขั้นตอนการเข้าสู่ระบบ และกรณีที่ไม่พบผลลัพธ์ทำงานได้ถูกต้อง การปรับโฉมเว็บไซต์ครั้งใหญ่ก็ยังอาจต้องมีผู้เข้าไปจัดการ Browse AI เหมาะที่สุดเมื่อทีมธุรกิจสามารถตรวจสอบแถวข้อมูลที่ดึงมาและดูแลโรบอตได้ ส่วนผู้พัฒนาที่ต้องการตรรกะการทำงานของเบราว์เซอร์ซึ่งควบคุมเวอร์ชันอย่างเข้มงวดอาจเลือกใช้บริการที่อาศัยโค้ด
ข้อดีและข้อเสีย
- การตั้งค่าฟิลด์โดยมี AI ช่วยลดอุปสรรคในการเริ่มต้นใช้งาน
- การติดตามตามกำหนดเวลาช่วยเน้นการเปลี่ยนแปลงที่สำคัญ
- เชื่อมต่อกับสเปรดชีต, API และเว็บฮุกได้
- การเปลี่ยนแปลงเว็บไซต์ครั้งใหญ่อาจต้องฝึกโรบอตใหม่
- ตรรกะที่ซับซ้อนต้องออกแบบเวิร์กโฟลว์อย่างรอบคอบ
5. SearchAPI
SearchAPI เป็นตัวเลือกเฉพาะทางที่เราแนะนำสำหรับการรวบรวมผลการค้นหาในรูปแบบข้อมูลที่มีโครงสร้าง Google API สามารถส่งลิงก์ผลการค้นหาและฟีเจอร์การค้นหาในรูปแบบ JSON จึงไม่จำเป็นต้องดูแลตัวแยกวิเคราะห์สำหรับหน้าผลการค้นหาที่เปลี่ยนแปลงอยู่เสมอ แค็ตตาล็อกที่ครอบคลุมยิ่งขึ้นมีแหล่งข้อมูลอย่างแผนที่ การช็อปปิง ข่าว วิดีโอ และประสบการณ์การค้นหาด้วย AI ที่รองรับ เครื่องมือนี้มีประโยชน์เป็นพิเศษเมื่อการค้นหาแหล่งข้อมูลและการมองเห็นบนหน้าค้นหาเป็นผลิตภัณฑ์ข้อมูลโดยตรง ไม่ใช่เพียงขั้นตอนก่อนเริ่มรวบรวมข้อมูลจากเว็บไซต์อื่น
การปรับให้เหมาะกับท้องถิ่นเป็นส่วนสำคัญที่ทำให้เครื่องมือนี้เหมาะกับการใช้งาน พารามิเตอร์ด้านสถานที่ ประเทศ ภาษา และอุปกรณ์ช่วยให้ทีมศึกษาตลาดจากบริบทการค้นหาที่กำหนดไว้ได้ แอปพลิเคชันด้าน SEO สามารถติดตามคำค้นหาในเมืองหนึ่ง ขณะที่ผู้ช่วยวิจัยสามารถค้นหาแหล่งข้อมูลที่เกี่ยวข้องและเก็บลิงก์ที่ได้รับไว้เพื่อเรียกใช้ภายหลังได้ เอกสารประกอบเฉพาะของแต่ละเอนจินมีความสำคัญ เพราะพารามิเตอร์และฟิลด์ผลลัพธ์ที่ใช้ได้แตกต่างกันไปตามผลิตภัณฑ์ค้นหา
ควรเลือก SearchAPI ให้ตรงกับเอนจินและฟิลด์ที่เวิร์กโฟลว์ต้องใช้จริง ผลการค้นหาไม่ได้แสดงเนื้อหาทั้งหมดของหน้าเว็บปลายทาง และหน้าผลลัพธ์ที่มีข้อมูลหลากหลายก็ไม่ได้ใช้โครงสร้างข้อมูลแบบเดียวกันทั้งหมด ทีมควรวางงบประมาณตามปริมาณคำขอ ตรวจสอบความต้องการด้านอัตราการประมวลผล และจัดการกรณีที่บางส่วนของผลลัพธ์ขาดหายไปอย่างเหมาะสม หากต้องการดึงข้อมูลจากเว็บไซต์ทั่วไปหรือใช้งานเบราว์เซอร์แบบโต้ตอบ เครื่องมืออื่นในคู่มือนี้จะเป็นจุดเริ่มต้นที่เหมาะกว่า
ข้อดีและข้อเสีย
- ผลลัพธ์แบบมีโครงสร้างช่วยลดภาระการดูแลตัวแยกวิเคราะห์ SERP
- แค็ตตาล็อกครอบคลุมเอนจินค้นหาและเอนจินที่เกี่ยวข้องอย่างหลากหลาย
- ควบคุมการปรับให้เหมาะกับท้องถิ่นได้อย่างละเอียด
- ผลการค้นหาใช้แทนการดึงข้อมูลจากหน้าเว็บปลายทางไม่ได้
- ฟิลด์และพารามิเตอร์แตกต่างกันไปตามเอนจิน
6. Octoparse
Octoparse แสดงให้เห็นการทำงานของ AI Copilot และระบบอัตโนมัติที่มีมนุษย์ร่วมตรวจสอบ วิดีโอ: Octoparse
Octoparse เหมาะสำหรับนักวิเคราะห์ที่ต้องการออกแบบตัวดึงข้อมูลผ่านหน้าจอภาพ แล้วเรียกใช้งานซ้ำได้ แพลตฟอร์มปัจจุบันมีเทมเพลตสำเร็จรูป การตั้งค่าด้วย AI Assistant และระบบตรวจจับหน้าเว็บอัตโนมัติในแอปพลิเคชันเดสก์ท็อป ผู้ใช้สามารถปรับแต่งงานที่สร้างขึ้นได้โดยไม่ต้องเริ่มจากการเขียนโค้ดเบราว์เซอร์ ความยืดหยุ่นนี้มีประโยชน์ในการรวบรวมแค็ตตาล็อกสินค้า ไดเรกทอรี หรือรายการต่าง ๆ ซึ่งลำดับของหน้ามีความสำคัญพอ ๆ กับฟิลด์ข้อมูลในแต่ละหน้า
การประมวลผลบนคลาวด์เปลี่ยนงานที่เตรียมไว้ให้เป็นกระบวนการรวบรวมข้อมูลที่ทำซ้ำได้ โดยไม่ต้องเปิดคอมพิวเตอร์ส่วนตัวทิ้งไว้ตลอดเวลา การตั้งเวลา การทำงานแบบขนาน การหมุนเวียน IP และการเชื่อมต่อเพื่อส่งออกข้อมูลช่วยให้งานขนาดใหญ่ก้าวไปไกลกว่าต้นแบบบนเดสก์ท็อป แนวทางแบบภาพนี้ดึงดูดทีมที่เข้าใจเว็บไซต์ต้นทางและข้อกำหนดด้านข้อมูลของตน แต่ไม่ต้องการดูแลบริการระบบอัตโนมัติสำหรับเบราว์เซอร์ที่พัฒนาขึ้นเอง
การใช้งาน Octoparse ยังต้องอาศัยการออกแบบงานอย่างรอบคอบ การแบ่งหน้า การเลื่อนหน้าแบบไม่สิ้นสุด ขั้นตอนของแบบฟอร์ม และระเบียนที่ซ้ำกันอาจทำให้ความหมายของการทำงานที่ดูเหมือนสำเร็จเปลี่ยนไป โควตาการใช้งานบนคลาวด์และฟีเจอร์ในแต่ละแพ็กเกจควรสอดคล้องกับกำหนดเวลาและปริมาณงานที่ตั้งใจไว้ เราแนะนำเครื่องมือนี้เมื่อทีมต้องการควบคุมขั้นตอนการดึงข้อมูลได้มากกว่าเครื่องมือแบบคลิกเดียวที่ใช้งานรวดเร็ว โดยควรกำหนดผู้รับผิดชอบไว้ชัดเจนเพื่อปรับงานเมื่อหน้าเว็บต้นทางเปลี่ยนแปลง
ข้อดีและข้อเสีย
- เทมเพลตและ AI ช่วยให้ตั้งค่าได้ง่ายขึ้น
- การแก้ไขผ่านหน้าจอภาพรองรับงานดึงข้อมูลที่มีรายละเอียด
- การทำงานบนคลาวด์รองรับการรวบรวมข้อมูลตามกำหนดเวลา
- เว็บไซต์ที่ซับซ้อนต้องปรับแต่งงานให้เหมาะสม
- ฟีเจอร์บนคลาวด์ขึ้นอยู่กับแพ็กเกจที่เลือก
7. Browserless
เราแนะนำ Browserless สำหรับนักพัฒนาที่ต้องการควบคุมเบราว์เซอร์ โดยมอบหมายให้บริการที่มีการจัดการดูแลการโฮสต์และการปรับขนาดสเกล สคริปต์ Puppeteer หรือ Playwright ที่มีอยู่สามารถเชื่อมต่อกับเบราว์เซอร์ระยะไกลได้ จึงเป็นตัวเลือกที่น่าสนใจสำหรับโปรเจกต์ที่มีโค้ดระบบอัตโนมัติซึ่งใช้งานได้อยู่แล้ว บริการนี้มีประโยชน์เป็นพิเศษเมื่อต้องเก็บข้อมูลผ่านการโต้ตอบหลายขั้นตอน ใช้หน้าเว็บที่พึ่งพา JavaScript อย่างมาก หรือจัดการเซสชันที่ต้องดำเนินต่อเนื่องนานกว่าคำขอทั่วไปเพียงครั้งเดียว
บริการนี้ยังมี REST API สำหรับการดึงข้อมูลจากเว็บ การจับภาพหน้าจอ การสร้าง PDF และฟังก์ชันเบราว์เซอร์แบบกำหนดเอง เซิร์ฟเวอร์ MCP ที่โฮสต์ไว้ช่วยให้เอเจนต์ AI ใช้เครื่องมือเบราว์เซอร์ได้ ขณะที่ฟีเจอร์เซสชันและโปรไฟล์ที่ผ่านการยืนยันตัวตนรองรับเวิร์กโฟลว์ที่ต้องดำเนินต่อเนื่อง ดังนั้น Browserless จึงเหมาะทั้งสำหรับนักพัฒนาที่สร้างเครื่องมือเก็บข้อมูลแบบกำหนดเอง และเอเจนต์ที่ต้องท่องเว็บและรวบรวมข้อมูลผ่านเบราว์เซอร์จริง
ประเด็นสำคัญในการพิจารณาซื้อคือการคิดหน่วยการใช้งานสำหรับงานเบราว์เซอร์ ปัจจุบันแพ็กเกจฟรีมี 1,000 หน่วยต่อเดือนและใช้เบราว์เซอร์พร้อมกันได้สองตัว ไม่ได้หมายความว่าจะดึงข้อมูลได้ 1,000 ครั้งอย่างแน่นอน เวลาที่ใช้เบราว์เซอร์จะถูกหักจากหน่วย และมีค่าใช้จ่ายเพิ่มเติมสำหรับปริมาณการใช้งานพร็อกซีและการแก้ CAPTCHA สำเร็จ ส่วนข้อจำกัดของเซสชันจะแตกต่างกันไปตามแพ็กเกจ ทีมงานยังคงต้องรับผิดชอบการกำหนดตรรกะการดึงข้อมูลและตรวจสอบผลลัพธ์ ดังนั้น Browserless จึงเหมาะเป็นพิเศษเมื่อการควบคุมเบราว์เซอร์สำคัญกว่าการใช้เครื่องมือสร้างหุ่นยนต์แบบภาพ
ข้อดีและข้อเสีย
- รองรับเวิร์กโฟลว์ Puppeteer และ Playwright ที่คุ้นเคย
- REST API รองรับการดึงข้อมูลและส่งออกหน้าเว็บ
- ฟีเจอร์เซสชันและ MCP เหมาะกับเอเจนต์ที่โต้ตอบกับเว็บ
- เวลาใช้งานเบราว์เซอร์และส่วนเสริมมีผลต่อการใช้หน่วย
- การดึงข้อมูลแบบกำหนดเองยังต้องอาศัยตรรกะของแอปพลิเคชัน
8. ScrapingBee
ScrapingBee เป็นตัวเลือกที่น่าสนใจสำหรับนักพัฒนาที่ต้องการส่งคำขอเก็บข้อมูลจากเว็บผ่านบริการที่มีการจัดการ แทนการควบคุมเบราว์เซอร์ที่ทำงานต่อเนื่องโดยตรง API ของบริการนี้ผสานการเรียกดูหน้าเว็บและการเรนเดอร์ JavaScript เข้ากับการจัดการพร็อกซี ส่วนการดึงข้อมูลสามารถใช้กฎ CSS หรือ XPath หรือคำสั่งจาก AI ได้ การผสานความสามารถเหล่านี้มีประโยชน์เมื่อโปรเจกต์ต้องการข้อมูลที่จัดโครงสร้างจากเว็บไซต์หลายแห่ง แต่ไม่ต้องการดูแลระบบเบราว์เซอร์ของตนเอง
สถานการณ์การทำงานด้วย JavaScript สามารถคลิก เลื่อนหน้าเว็บ พิมพ์ หรือรอก่อนเก็บข้อมูลได้ เอาต์พุตรูปแบบ Markdown รองรับเวิร์กโฟลว์ด้านเนื้อหา AI ส่วนภาพหน้าจอช่วยบันทึกหน้าเว็บที่เรนเดอร์แล้ว ผลิตภัณฑ์รุ่นปัจจุบันยังมี API เฉพาะสำหรับเว็บไซต์เป้าหมายบางแห่ง พร้อมช่องทางใช้งานผ่าน CLI และ MCP นักพัฒนาสามารถใช้กฎการดึงข้อมูลที่ระบุไว้อย่างชัดเจนกับฟิลด์ที่มีรูปแบบคงที่ และใช้การดึงข้อมูลด้วยภาษาธรรมชาติเมื่อโครงสร้างหน้าเว็บหรือคำถามคาดเดาได้ยากกว่า
ความแตกต่างจากแพลตฟอร์มเบราว์เซอร์ที่โฮสต์ไว้เห็นได้ชัดในทางปฏิบัติ กล่าวคือ ScrapingBee ให้ความสำคัญกับคำขอและผลลัพธ์ที่ส่งกลับมา ส่วนแอปพลิเคชันแบบกำหนดเองจะรับผิดชอบงานในภาพรวม การประสานงานระหว่างหลายหน้าเว็บ การลบข้อมูลซ้ำ การกำหนดเวลารีเฟรช และการตรวจสอบความถูกต้องของระเบียนยังต้องมีระบบรองรับเป็นของตนเอง การใช้เครดิตยังเปลี่ยนแปลงตามฟีเจอร์ที่เลือกใช้ รวมถึงการเรนเดอร์และตัวเลือกพร็อกซี เราแนะนำบริการนี้สำหรับทีมพัฒนาแอปพลิเคชันที่ให้ความสำคัญกับอินเทอร์เฟซ HTTP ที่ใช้งานตรงไปตรงมา และต้องการจัดการการประสานงานในไปป์ไลน์ข้อมูลด้วยโค้ดของตนเอง
ข้อดีและข้อเสีย
- กฎตัวเลือกและการดึงข้อมูลด้วย AI ให้ความยืดหยุ่น
- การเรนเดอร์และสถานการณ์การทำงานรองรับหน้าเว็บแบบโต้ตอบ
- Markdown, CLI และ MCP รองรับเวิร์กโฟลว์ AI
- ตัวเลือกคำขอขั้นสูงเพิ่มการใช้เครดิต
- งานที่ครอบคลุมหลายหน้ายังต้องมีระบบประสานงาน
9. Oxylabs
Oxylabs เป็นตัวเลือกที่น่าสนใจสำหรับทีมที่ต้องการเข้าถึงเว็บไซต์สาธารณะที่เข้าถึงได้ยากผ่านบริการที่มีการจัดการ และต้องการรองรับการเก็บข้อมูลในปริมาณที่มากขึ้น Web API รุ่นปัจจุบันมีบริการ /Scrape สำหรับเรียกดูและจัดโครงสร้างข้อมูลเว็บ โดยผสานการเรนเดอร์ JavaScript และการจัดการการเข้าถึงไว้ในบริการ ชุดผลิตภัณฑ์ยังมี /Search และโครงสร้างพื้นฐานสำหรับเบราว์เซอร์ ทำให้ทีมเลือกใช้แนวทางได้หลายแบบตามว่างานเริ่มจากการค้นหา การดึงข้อมูล หรือการโต้ตอบ
ตัวเลือกเฉพาะสำหรับเว็บไซต์เป้าหมายช่วยให้แหล่งข้อมูลด้านการค้นหาและการค้าออนไลน์ที่ใช้กันทั่วไปส่งคืนฟิลด์ที่นำไปใช้ได้ ขณะที่การเชื่อมต่อเอเจนต์ผ่าน MCP และ Agent Skills ช่วยนำการเก็บข้อมูลเข้าสู่เวิร์กโฟลว์ AI นอกจากนี้ Oxylabs ยังคงจัดทำเอกสารสำหรับ Classic Web Scraper API แยกต่างหาก ความแตกต่างนี้สำคัญสำหรับการเชื่อมต่อที่มีอยู่ กล่าวคือ ทีมที่ดูแล Classic API ควรใช้เอกสารที่เกี่ยวข้องกับ API ดังกล่าว แทนที่จะคิดว่าตัวอย่างสำหรับ Web API รุ่นใหม่สามารถใช้แทนกันได้
Oxylabs เหมาะที่สุดเมื่อความยากในการเข้าถึงเว็บไซต์เป้าหมาย ปริมาณงาน หรือค่าใช้จ่ายในการดูแลโครงสร้างพื้นฐานสำหรับการเข้าถึง ทำให้การใช้แพลตฟอร์มที่มีการจัดการคุ้มค่า แอปพลิเคชันยังต้องกำหนดโครงสร้างข้อมูลที่ต้องการ ช่วงเวลาที่ข้อมูลยังถือว่าใหม่ และวิธีจัดการระเบียนที่ไม่สมบูรณ์ ก่อนเริ่มใช้งาน ควรตรวจสอบให้แน่ใจว่ารุ่น API ตัวเลือกสำหรับเว็บไซต์เป้าหมาย และรูปแบบการคิดค่าบริการสอดคล้องกับงานจริง สำหรับการดึงข้อมูลด้วยตนเองในปริมาณเล็กน้อย เครื่องมือดึงข้อมูลแบบภาพอาจตอบโจทย์ได้ตรงกว่า
ข้อดีและข้อเสีย
- โครงสร้างพื้นฐานสำหรับจัดการการเรนเดอร์และการเข้าถึง
- ตัวเลือกการดึงข้อมูลแบบมีโครงสร้างที่ปรับให้เหมาะกับเป้าหมาย
- Web API รุ่นปัจจุบันรองรับการผสานรวมกับเอเจนต์
- API รุ่นคลาสสิกและรุ่นปัจจุบันต้องตั้งค่าแยกกัน
- ยังต้องตรวจสอบคุณภาพผลลัพธ์ในระดับแอปพลิเคชัน
10. Diffbot
เราเลือก Diffbot เมื่อต้องการทำความเข้าใจข้อมูลบนหน้าเว็บมากกว่าจำลองรูปแบบการจัดวาง Extract ใช้คอมพิวเตอร์วิทัศน์และการประมวลผลภาษาธรรมชาติเพื่อจัดประเภทหน้าเว็บ แล้วสร้าง JSON ที่มีโครงสร้างตามสคีมามาตรฐาน สำหรับทีมที่รวบรวมบทความหรือผลิตภัณฑ์จากหลายแหล่ง วิธีนี้อาจช่วยลดปริมาณโค้ดแยกวิเคราะห์เฉพาะเว็บไซต์ที่ต้องใช้เพื่อแปลงหน้าเว็บให้เป็นระเบียนที่นำมาเปรียบเทียบกันได้
Knowledge Graph ของ Diffbot ตอบโจทย์ที่เกี่ยวข้องกันแต่แยกต่างหาก นั่นคือการทำงานกับเอนทิตีอย่างองค์กร บุคคล และบทความ ซึ่งรวบรวมมาจากเว็บสาธารณะแล้ว ระเบียนสามารถผสานข้อมูลจากหลายแหล่งที่มาและเชื่อมโยงเอนทิตีด้วยความสัมพันธ์ที่มีความหมาย จึงทำให้ Diffbot มีประโยชน์ต่อการเพิ่มข้อมูล การวิจัยบริษัท และแอปพลิเคชันด้านข่าวกรองที่ต้องการบริบทนอกเหนือจากฟิลด์ที่มองเห็นได้บนหน้าเว็บเพียงหน้าเดียว
ข้อแลกเปลี่ยนคือการต้องปรับให้เข้ากับโมเดลข้อมูลของ Diffbot การดึงข้อมูลแบบมาตรฐานมีประโยชน์เมื่อประเภทหน้าเว็บและฟิลด์ตรงกับงาน แต่หากต้องการฟิลด์ที่ไม่เหมือนใครหรือการโต้ตอบเฉพาะทาง ก็อาจต้องใช้แนวทางอื่น ทีมควรแยกให้ออกระหว่างการดึงข้อมูลจาก URL ที่เลือกไว้กับการค้นหาในกราฟความรู้ที่มีอยู่แล้ว จากนั้นจึงประเมินความครอบคลุมและความใหม่ของแหล่งข้อมูลให้เหมาะสม Diffbot เหมาะกับทีมเทคนิคที่สร้างผลิตภัณฑ์ข้อมูลแบบปรับมาตรฐาน มากกว่าผู้ใช้ที่เพียงต้องการคัดลอกข้อมูลไม่กี่แถวลงในสเปรดชีต
ข้อดีและข้อเสีย
- การจัดประเภทอัตโนมัติช่วยลดงานเขียนตัวแยกวิเคราะห์
- สคีมามาตรฐานช่วยปรับข้อมูลจากหน้าเว็บที่คล้ายกันให้อยู่ในรูปแบบเดียวกัน
- Knowledge Graph เพิ่มบริบทเกี่ยวกับเอนทิตี
- ฟิลด์มาตรฐานอาจไม่รองรับข้อกำหนดเฉพาะทาง
- การดึงข้อมูลและการเข้าถึงกราฟตอบโจทย์เวิร์กโฟลว์ที่แตกต่างกัน
คำถามที่พบบ่อย
อะไรทำให้เครื่องมือดึงข้อมูลจากเว็บขับเคลื่อนด้วย AI
AI ช่วยระบุฟิลด์ ตีความเนื้อหาบนหน้าเว็บ สร้างขั้นตอนการดึงข้อมูล หรือควบคุมการทำงานของเบราว์เซอร์ได้ เครื่องมือบางตัวใช้ AI ในขั้นตอนตั้งค่า ส่วนบางตัวใช้ AI ในการดึงข้อมูลแต่ละครั้ง บริการยังอาจรองรับแอปพลิเคชัน AI ด้วยการจัดหาเนื้อหาที่สะอาด โดยไม่ต้องใช้โมเดลภาษาในทุกคำขอ เลือกความสามารถที่ช่วยแก้ปัญหาการรวบรวมข้อมูลของคุณ แทนที่จะยึดติดกับคำเรียก
การดึงข้อมูลจากเว็บแตกต่างจากระบบอัตโนมัติของเบราว์เซอร์อย่างไร
การดึงข้อมูลจากเว็บคือการรวบรวมข้อมูล ส่วนระบบอัตโนมัติของเบราว์เซอร์จะทำงานบนหน้าเว็บ เช่น เปิดเมนู ป้อนคำค้น หรือดำเนินการตามเวิร์กโฟลว์หลายขั้นตอน ทั้งสองอย่างมักทำงานร่วมกัน โดยเบราว์เซอร์อัตโนมัติจะไปยังสถานะของหน้าที่ต้องการ แล้วขั้นตอนการดึงข้อมูลจึงรวบรวมฟิลด์ต่าง ๆ หากไม่จำเป็นต้องโต้ตอบเหล่านั้น การส่งคำขอไปยัง API โดยตรงมักง่ายกว่า
เครื่องมือใดเหมาะกับทีมที่ไม่มีความรู้ด้านเทคนิค
เราแนะนำ Browse AI เป็นอันดับแรกสำหรับการรวบรวมข้อมูลตามรอบและการติดตามการเปลี่ยนแปลงที่ไม่ซับซ้อน Octoparse เป็นอีกทางเลือกที่ดีเมื่อทีมต้องการควบคุมขั้นตอนของงานด้วยภาพมากขึ้น ทั้งสองเครื่องมือเหมาะที่สุดเมื่อมีคนตรวจสอบระเบียนที่ได้ และเข้าใจว่าเมื่อใดเว็บไซต์ต้นทางมีการเปลี่ยนแปลง
ไปป์ไลน์ AI หรือ RAG ควรเก็บข้อมูลใดจากการดึงข้อมูล
เก็บ URL ต้นทาง เวลาที่รวบรวมข้อมูล ชื่อหน้าเว็บ และข้อความหรือฟิลด์แบบมีโครงสร้างที่แอปพลิเคชันต้องใช้ Markdown ช่วยรักษาโครงสร้างเอกสารให้อ่านง่าย ส่วน JSON รองรับระเบียนที่กำหนดรูปแบบไว้แล้ว ลบเนื้อหาที่ซ้ำกันและหลีกเลี่ยงการปะปนข้อความนำทางกับเนื้อหาหลัก การเก็บข้อมูลแหล่งที่มาช่วยให้ตรวจสอบย้อนกลับและปรับปรุงคำตอบในภายหลังได้ง่ายขึ้น
ควรใช้เบราว์เซอร์ที่มีผู้ให้บริการจัดการเมื่อใด
เบราว์เซอร์ที่มีผู้ให้บริการจัดการมีประโยชน์เมื่อการรวบรวมข้อมูลต้องใช้การทำงานของ JavaScript การโต้ตอบหลายขั้นตอน หรือการรักษาสถานะเซสชัน และทีมของคุณต้องการหลีกเลี่ยงการโฮสต์โปรเซสของเบราว์เซอร์ Browserless เป็นตัวเลือกเฉพาะทางสำหรับโค้ด Puppeteer หรือ Playwright ที่มีอยู่แล้ว สำหรับหน้าเว็บแบบคงที่เพียงหน้าเดียว การใช้ API ดึงข้อมูลหรือ API สำหรับดึงเนื้อหาที่เรียบง่ายกว่าอาจใช้ทรัพยากรน้อยกว่า
โควตาฟรี 1,000 หน่วยเท่ากับการดึงข้อมูล 1,000 ครั้งหรือไม่
ไม่ใช่ หน่วยและเครดิตมีหลักเกณฑ์แตกต่างกันไปตามผู้ให้บริการ Browserless คิดค่าการเชื่อมต่อเบราว์เซอร์เป็นช่วง ๆ สูงสุดช่วงละ 30 วินาที โดยการรับส่งข้อมูลผ่านพร็อกซีและการแก้ CAPTCHA จะใช้หน่วยเพิ่มเติม ส่วนบริการอื่นคิดค่าบริการตามตัวเลือกของคำขอ จำนวนระเบียน หรือการประมวลผล ควรประเมินเวิร์กโฟลว์ทั้งหมด แทนการถือว่าโควตาฟรีของแต่ละบริการเทียบเท่ากัน
เชื่อถือผลการดึงข้อมูลด้วย AI ได้โดยไม่ต้องตรวจสอบหรือไม่
แม้การตอบกลับ JSON จะถูกต้อง แต่ก็ยังอาจตกหล่นระเบียนหรือตีความฟิลด์ผิดได้ กำหนดฟิลด์ที่จำเป็น ตรวจสอบชนิดข้อมูลและช่วงค่า สุ่มตรวจหน้าเว็บต้นทาง และติดตามการเปลี่ยนแปลงของจำนวนระเบียน สำหรับงานที่ทำซ้ำเป็นประจำ การระบุสถานะความล้มเหลวและผลลัพธ์ว่างไว้อย่างชัดเจนมีประโยชน์กว่าการถือว่าการตอบกลับทุกครั้งเป็นชุดข้อมูลที่สมบูรณ์
ข้อคิดส่งท้ายเกี่ยวกับเครื่องมือดึงข้อมูลจากเว็บด้วย AI
Bright Data เป็นตัวเลือกโดยรวมที่ดีที่สุดสำหรับโครงการรวบรวมข้อมูลจากเว็บในวงกว้าง ส่วน Firecrawl เหมาะที่สุดสำหรับการเริ่มต้นแปลงหน้าเว็บให้เป็นเนื้อหาที่พร้อมใช้งานกับ AI เลือก Apify เมื่อเครื่องมือที่นำกลับมาใช้ซ้ำได้ งานที่ตั้งเวลาไว้ และการดำเนินงานบนคลาวด์เป็นหัวใจสำคัญของโครงการ
สำหรับทีมธุรกิจ Browse AI ช่วยให้การติดตามข้อมูลที่ต้องทำซ้ำเป็นเรื่องง่าย ขณะที่ Octoparse มอบวิธีปรับแต่งงานดึงข้อมูลที่ซับซ้อนขึ้นผ่านเครื่องมือแบบภาพ ส่วน SearchAPI เป็นตัวเลือกเฉพาะทางเมื่อผลลัพธ์ที่ต้องการคือข้อมูลการค้นหาที่มีโครงสร้าง
Browserless เป็นตัวเลือกที่เหมาะสำหรับนักพัฒนาที่ต้องการเรียกใช้เบราว์เซอร์ผ่านบริการจัดการ พร้อมใช้ไลบรารีระบบอัตโนมัติที่คุ้นเคย ScrapingBee เป็นทางเลือกที่น่าสนใจเมื่อคำขอดึงข้อมูลแบบจัดการให้เหมาะกับแอปพลิเคชันมากกว่า Oxylabs เหมาะกับการดึงข้อมูลจากเว็บสาธารณะที่มีความต้องการสูง ส่วน Diffbot โดดเด่นด้านการดึงข้อมูลตามมาตรฐานและการวิเคราะห์ข้อมูลเอนทิตี
ตัวเลือกที่ดีที่สุดในระยะยาวคือเครื่องมือที่ให้ข้อมูลตามต้องการผ่านเวิร์กโฟลว์ที่ทีมของคุณดูแลต่อได้ เลือกวิธีรวบรวมข้อมูลให้เหมาะกับงาน รักษาบริบทของแหล่งข้อมูลไว้ และประเมินความคุ้มค่าจากผลลัพธ์ที่นำไปใช้ได้จริง ไม่ใช่จำนวนหน้าที่ร้องขอ




