โมเดลและแพลตฟอร์ม AI
AudioSep : แยกสิ่งใดๆ ที่คุณอธิบาย

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
ประเด็นสำคัญAudioSep เป็นโมเดลพื้นฐานที่ใช้แยกแยะเสียงโดยใช้คำสั่งภาษาธรรมชาติในขอบเขตเปิด
ดูเพิ่มเติม
- AudioSep เป็นโมเดลพื้นฐานที่ใช้แยกแยะเสียงโดยใช้คำสั่งภาษาธรรมชาติในขอบเขตเปิด
- โมเดลนี้ใช้ประโยชน์จากชุดข้อมูลขนาดใหญ่หลายรูปแบบ เพื่อก้าวข้ามข้อจำกัดด้านข้อมูลที่ถูกติดป้ายกำกับของกรอบงาน LASS รุ่นก่อนหน้า
- โครงสร้างของโมเดลรวมเอาเครื่องเข้ารหัสข้อความ CLIP หรือ CLAP ที่ถูกแช่แข็ง กับโครงสร้างหลักการแยกเสียงแบบ ResUNet เพื่อประสิทธิภาพแบบซีโร่ช็อต
LASS หรือ Language-queried Audio Source Separation เป็นแนวทางใหม่ของการวิเคราะห์ฉากเสียงด้วยคอมพิวเตอร์ (CASA) ที่ใช้คำค้นภาษาธรรมชาติเพื่อแยกเสียงเป้าหมายจากเสียงผสม เป็นส่วนติดต่อที่เป็นธรรมชาติและขยายขอบเขตได้สำหรับงานเสียงดิจิทัล แม้แนวทางเดิมจะพัฒนาการแยกแหล่งเสียงเฉพาะ เช่น เครื่องดนตรี แต่ยังมีข้อจำกัดในการแยกเสียงทั่วไปในโดเมนเปิด
AudioSep เป็นโมเดลพื้นฐานที่มุ่งแก้ข้อจำกัดนี้โดยแยกเสียงตามคำค้นภาษาธรรมชาติ ทีมพัฒนาฝึกด้วยชุดข้อมูลหลายโมดัลขนาดใหญ่และประเมินการแยกเครื่องดนตรี เหตุการณ์เสียง และการปรับปรุงคุณภาพเสียงพูด ผลเบื้องต้นแสดงการแยกเสียงที่แข็งแกร่งและความสามารถแบบ zero-shot บทความนี้อธิบายสถาปัตยกรรม ข้อมูลฝึกและประเมิน รวมถึงแนวคิดสำคัญ
CASA, USS, QSS และ LASS: พื้นฐานของ AudioSep
CASA ใช้ออกแบบระบบการฟังของเครื่องให้รับรู้สภาพแวดล้อมเสียงซับซ้อนคล้ายการฟังของมนุษย์ งานแยกเสียงเป้าหมายเกี่ยวข้องกับ “ปัญหาค็อกเทลปาร์ตี้” คือการแยกแยะเสียงแต่ละแหล่งในเสียงบันทึกที่มีหลายเสียงปนกัน การใช้งานครอบคลุมแยกเสียงดนตรีและเสียงทั่วไป ปรับปรุงเสียงพูด และระบุเสียงเป้าหมาย
งานเดิมมักแยกแหล่งเฉพาะอย่างดนตรีหรือคำพูด ส่วน USS หรือ Universal Sound Separation มุ่งแยกเสียงใดๆ ในบันทึกจริง แต่การแยกทุกแหล่งเป็นงานยากเนื่องจากเสียงในโลกมีหลากหลาย จึงมีข้อจำกัดสำหรับงานจริงแบบเวลาจริง
QSS หรือ Query-based Sound Separation เป็นทางเลือกที่แยกเฉพาะเสียงที่ต้องการตามคำค้น ทำให้ผู้ใช้เลือกแหล่งเสียงตามความต้องการได้ และเหมาะกับงานอย่างการแก้ไขมัลติมีเดียหรือเสียง
LASS ขยาย QSS โดยใช้คำอธิบายภาษาธรรมชาติของเสียงเป้าหมาย เมื่อเทียบกับการใช้เสียงหรือภาพเป็นคำค้น ภาษาธรรมชาติยืดหยุ่นและจัดหาข้อมูลคำค้นได้สะดวกกว่า อีกทั้งไม่ถูกจำกัดด้วยชุดป้ายกำกับที่กำหนดไว้ จึงมีโอกาสทั่วไปสู่โดเมนเปิด
เดิม LASS ใช้การเรียนรู้แบบมีผู้สอนจากคู่เสียงและข้อความที่ติดป้ายกำกับ แต่ ข้อมูลเสียง–ข้อความที่มีคำอธิบาย มีจำกัด จึงใช้การกำกับดูแลแบบหลายโมดัล โดยนำโมเดลที่ฝึกล่วงหน้าแบบเปรียบต่าง เช่น CLIP มาเป็นตัวเข้ารหัสคำค้น การจัดแนวเวกเตอร์ข้อความกับภาพหรือโมดัลอื่นช่วยให้ฝึกจากข้อมูลที่มีมาก และอนุมานจากข้อความแบบ zero-shot ได้ อย่างไรก็ตามชุดข้อมูลของระบบเดิมยังเล็กและยังไม่ได้สำรวจการใช้งานในหลายร้อยโดเมนอย่างเพียงพอ
AudioSep จึงมุ่งสร้างโมเดลแยกเสียงที่ฝึกล่วงหน้าจากข้อมูลเสียงและหลายโมดัลขนาดใหญ่ที่มีอยู่ เพื่อให้แยกเสียงทั่วไปในโดเมนเปิดด้วยคำค้นหรือคำอธิบายภาษาธรรมชาติได้
องค์ประกอบและสถาปัตยกรรม AudioSep
มีองค์ประกอบหลักสองส่วนคือตัวเข้ารหัสข้อความและโมเดลแยกเสียง
ตัวเข้ารหัสข้อความ
ใช้ตัวเข้ารหัสของ CLIP (Contrastive Language-Image Pre-training) หรือ CLAP (Contrastive Language-Audio Pre-training) คำค้นที่มี N โทเคนผ่านบล็อกทรานส์ฟอร์เมอร์ จากนั้นรวมผลเป็นเวกเตอร์ขนาดคงที่ D มิติ โดย D ขึ้นอยู่กับโมเดล CLIP หรือ CLAP และตรึงตัวเข้ารหัสข้อความระหว่างฝึก
CLIP ฝึกแบบเปรียบต่างด้วยคู่ภาพและข้อความขนาดใหญ่ จึงแมปคำอธิบายกับภาพไปยังพื้นที่ความหมายร่วมกันได้ เมื่อนำเวกเตอร์ภาพมาใช้แทนคำค้น ก็ฝึก LASS จากข้อมูลภาพและเสียงที่ไม่มีคำบรรยายได้ โดยไม่จำเป็นต้องมีคู่เสียง–ข้อความที่ติดป้ายกำกับ CLAP ใช้หลักการคล้ายกัน โดยเชื่อมตัวเข้ารหัสเสียงและข้อความด้วยวัตถุประสงค์แบบเปรียบต่างในพื้นที่แฝงร่วม
โมเดลแยกเสียง
ใช้ ResUNet ในโดเมนความถี่เป็นโครงหลัก เริ่มจากแปลงฟูเรียร์ช่วงเวลาสั้น (STFT) ของรูปคลื่นเพื่อได้สเปกโทรแกรมเชิงซ้อน X ขนาด และเฟส จากนั้นเครือข่ายตัวเข้ารหัส–ถอดรหัสประมวลผลสเปกโทรแกรมขนาด
เครือข่ายมีบล็อกเข้ารหัส 6 บล็อก บล็อกถอดรหัส 6 บล็อก และบล็อกคอขวด 4 บล็อก ฝั่งเข้ารหัสใช้บล็อกคอนโวลูชันแบบ residual 4 บล็อกเพื่อลดขนาด ส่วนถอดรหัสใช้บล็อกคอนโวลูชันทรานสโพสแบบ residual 4 บล็อกเพื่อเพิ่มขนาด มีการเชื่อมข้ามระหว่างระดับที่มีความละเอียดตรงกัน บล็อก residual ประกอบด้วย Leaky-ReLU สองชั้น batch normalization สองชั้น และ CNN สองชั้น พร้อมทางลัดเชื่อมอินพุตกับเอาต์พุต
โมเดลรับ X และทำนายมาสก์ขนาด M กับค่าคงเหลือของเฟสที่มีเวกเตอร์ข้อความเป็นเงื่อนไข เพื่อควบคุมการปรับขนาดและหมุนมุมของสเปกโทรแกรม นำค่าที่ทำนายไปใช้กับ STFT ของเสียงผสมเพื่อสร้างสเปกโทรแกรมเชิงซ้อนของเสียงที่แยกแล้ว

ชั้น FiLM (Feature-wise Linear Modulation) หลังบล็อกคอนโวลูชันของ ResUNet เชื่อมโมเดลแยกเสียงกับตัวเข้ารหัสข้อความ
การฝึกและฟังก์ชันสูญเสีย
ใช้การเพิ่มความหลากหลายด้านความดัง และฝึกแบบ end-to-end ด้วยค่าการสูญเสีย L1 ระหว่างรูปคลื่นจริงกับรูปคลื่นที่ทำนาย
ชุดข้อมูลและเกณฑ์ประเมิน
การฝึกใช้หลายชุดข้อมูลเพื่อให้เรียนรู้หลายโมดัลและลดการพึ่งพาคู่เสียง–ข้อความที่ติดป้ายกำกับ
AudioSet
ข้อมูลเสียงที่มีป้ายกำกับอย่างอ่อนมากกว่า 2 ล้านคลิป คลิปละ 10 วินาทีจาก YouTube ระบุว่ามีหรือไม่มีเสียงแต่ละประเภทโดยไม่บอกเวลาที่เกิดอย่างละเอียด มีมากกว่า 500 ประเภท เช่น ธรรมชาติ มนุษย์ และยานพาหนะ
VGGSound
ข้อมูลภาพและเสียงจาก YouTube มากกว่า 200,000 คลิป คลิปละ 10 วินาที มีมากกว่า 300 ประเภท เช่น เสียงคน ธรรมชาติ และนก โดยวัตถุที่ทำเสียงเป้าหมายปรากฏให้เห็นในวิดีโอด้วย
AudioCaps
ชุดคำบรรยายเสียงสาธารณะมากกว่า 50,000 คลิป คลิปละ 10 วินาทีที่ดึงจาก AudioSet แบ่งเป็นชุดฝึก ทดสอบ และตรวจสอบ มนุษย์เขียนคำบรรยายผ่าน Amazon Mechanical Turk คลิปฝึกมีคำบรรยายหนึ่งชุด ส่วนคลิปทดสอบและตรวจสอบมีคำบรรยายอ้างอิงอย่างละห้าชุด
ClothoV2
ชุดคำบรรยายเสียงจาก FreeSound โดยมนุษย์เขียนคำอธิบายภาษาธรรมชาติผ่าน Amazon Mechanical Turk เช่นเดียวกับ AudioCaps
WavCaps
ชุดเสียงที่มีป้ายกำกับอย่างอ่อนมากกว่า 400,000 คลิปพร้อมคำบรรยาย รวมระยะเวลาฝึกราว 7,568 ชั่วโมง มาจาก BBC Sound Effects, AudioSet, FreeSound, SoundBible และแหล่งอื่น

รายละเอียดการฝึก
สุ่มช่วงเสียงประมาณ 5 วินาทีจากสองคลิปต่างกันแล้วผสมเป็นตัวอย่างฝึก สร้างสเปกโทรแกรมเชิงซ้อนด้วยหน้าต่าง Hann ขนาด 1024 และระยะเลื่อน 320
ตัวเข้ารหัส CLIP/CLAP สกัดเวกเตอร์ข้อความ โดยค่าเริ่มต้นใช้ข้อความเป็นข้อมูลกำกับ โมเดลแยกเสียงเป็น ResUNet 30 ชั้น มีบล็อกเข้ารหัส 6 และถอดรหัส 6 บล็อก แต่ละบล็อกเข้ารหัสมีคอนโวลูชันสองชั้นขนาดเคอร์เนล 3×3 และจำนวนแผนที่คุณลักษณะเป็น 32, 64, 128, 256, 512 และ 1024 ตามลำดับ ฝั่งถอดรหัสสมมาตรกัน ใช้ตัวปรับ Adam และขนาดแบตช์ 96
ผลการประเมิน
ชุดข้อมูลที่เคยพบในการฝึก
ภาพต่อไปเปรียบเทียบกับ โมเดลปรับปรุงคุณภาพเสียงพูด, LASS และ CLIP รวมถึงระบบฐานอื่น ตัวแปรที่ใช้ตัวเข้ารหัสข้อความ CLIP เรียก AudioSep-CLIP ส่วนที่ใช้ CLAP เรียก AudioSep-CLAP

เมื่อใช้คำบรรยายเสียงหรือป้ายข้อความเป็นคำค้น โมเดลทำได้ดีและเหนือกว่า LASS เดิมกับโมเดลแยกเสียงที่ใช้เสียงเป็นคำค้น
ชุดข้อมูลที่ไม่เคยพบในการฝึก
ทีมประเมินข้อมูลใหม่เพื่อตรวจความสามารถ zero-shot และพบผลการแยกเสียงที่แข็งแกร่งดังภาพ

ภาพต่อไปเป็นการประเมินการปรับปรุงเสียงพูดบน Voicebank-DEMAND

ผลเหล่านี้ชี้ถึงศักยภาพในการจัดการเสียงจากการกระจายข้อมูลใหม่โดยไม่ต้องฝึกเฉพาะงานนั้น
การแสดงผลการแยกเสียง
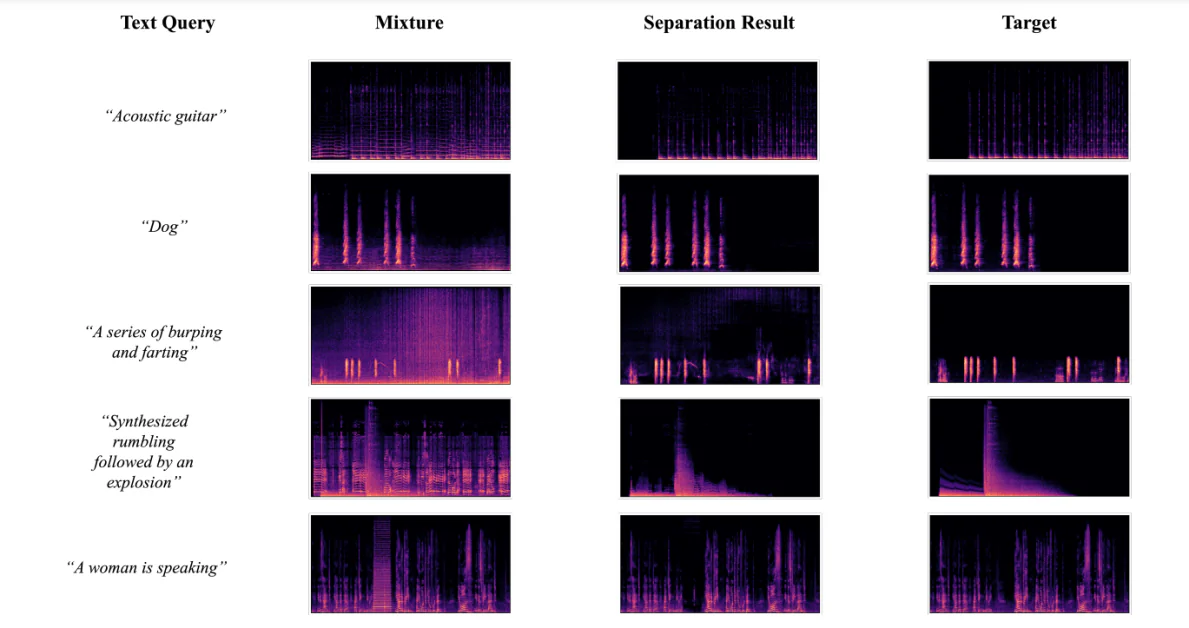
ใช้ AudioSep-CLAP และคำค้นข้อความหลายแบบเปรียบเทียบสเปกโทรแกรมของเสียงเป้าหมายจริง เสียงผสม และเสียงที่แยกแล้ว รูปแบบที่แยกได้ใกล้เคียงเสียงอ้างอิง จึงสนับสนุนผลประเมินเชิงปริมาณ
การเปรียบเทียบคำค้นข้อความ
ประเมิน AudioSep-CLAP และ AudioSep-CLIP บน AudioCaps Mini โดยใช้ป้ายเหตุการณ์ AudioSet คำบรรยาย AudioCaps และคำอธิบายภาษาธรรมชาติที่เขียนใหม่ เพื่อศึกษาผลของประเภทคำค้น ภาพแสดงตัวอย่าง AudioCaps Mini

สรุป
AudioSep เป็นโมเดลพื้นฐานสำหรับแยกเสียงทั่วไปในโดเมนเปิดตามคำอธิบายภาษาธรรมชาติ ผลประเมินแสดงประสิทธิภาพที่แข็งแกร่งในเงื่อนไข zero-shot และไม่มีผู้สอนโดยใช้คำบรรยายหรือป้ายข้อความเป็นคำค้น เหนือกว่าเฟรมเวิร์กอย่าง LASS เดิม และมีโอกาสช่วยแก้ข้อจำกัดของการแยกเสียงที่ใช้อยู่