
โมเดลและแพลตฟอร์ม AI
ASUS เปิดตัวเซิร์ฟเวอร์ XA P2N-E2 พร้อมซีพียู NVIDIA Vera แบบคู่ที่ OCP

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
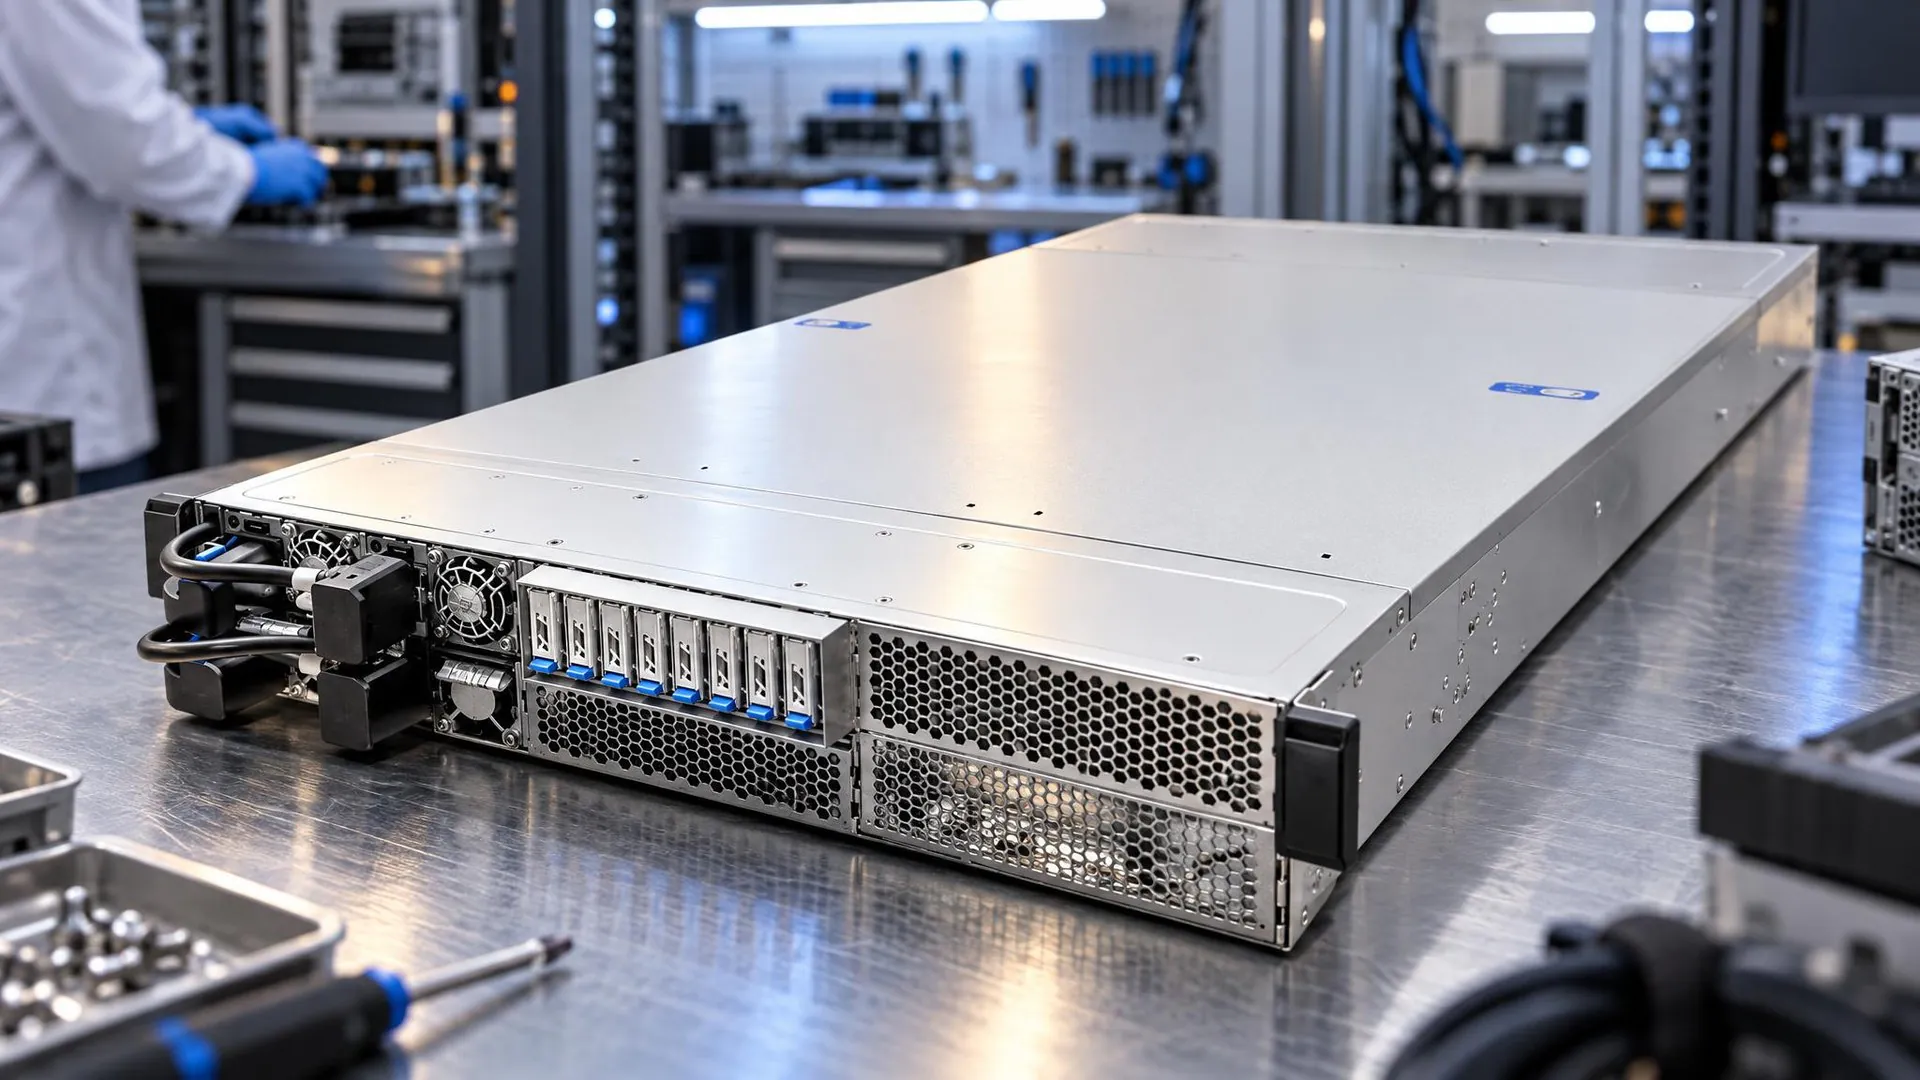
ASUS เปิดตัว XA P2N-E2 เซิร์ฟเวอร์ขนาด 2U ที่พัฒนาบนสถาปัตยกรรม NVIDIA MGX และขับเคลื่อนด้วยซีพียู NVIDIA Vera สองตัว ในงาน OCP Global Summit 2026 ณ เมืองซานโฮเซ รัฐแคลิฟอร์เนีย เมื่อวันที่ 12 ตุลาคม 2026 ในข่าวประชาสัมพันธ์ บริษัทระบุว่าระบบนี้ออกแบบมาสำหรับเวิร์กโหลด AI แบบเอเจนต์และการเรียนรู้แบบเสริมกำลัง
ข่าวประชาสัมพันธ์ระบุว่า เซิร์ฟเวอร์นี้มุ่งรองรับชั้นการทำงานของแอปพลิเคชัน AI โดยจัดการการเรียกใช้โค้ด การใช้เครื่องมือ การทำงานในแซนด์บ็อกซ์ การประมวลผลข้อมูล และการประสานงาน ซึ่งเป็นงานที่ครอบคลุมมากกว่าตัวโมเดล AI เอง XA P2N-E2 รองรับ GPU NVIDIA RTX PRO 6000 Blackwell Server Edition แบบ 2 สล็อตได้สูงสุด 2 ตัว โดยผสานการประมวลผลของ CPU เข้ากับการเร่งความเร็วด้วย GPU ในแพลตฟอร์มขนาด 2U ASUS ระบุว่า ประสิทธิภาพการประมวลผลแบบเธรดเดียวของ CPU และหน่วยความจำแบนด์วิดท์สูงที่ประหยัดพลังงานของระบบนี้ มีเป้าหมายเพื่อให้เอเจนต์ AI ตอบสนองได้รวดเร็วระหว่างการทำงานและการประเมินผลที่ต้องใช้ทรัพยากรสูง
ซีพียู Vera คู่ในแชสซี 2U ระบายความร้อนด้วยอากาศ
หน้าผลิตภัณฑ์ XA P2N-E2 ซึ่งระบุสถานะว่า “ใหม่” แสดงข้อมูลซีพียู NVIDIA Vera สองตัว โดยแต่ละตัวผสานคอร์ Olympus ที่ออกแบบเฉพาะจำนวน 88 คอร์เข้ากับ Spatial Multithreading รองรับทั้งหมด 176 เธรด และมีค่า TDP สูงสุด 480W ต่อซ็อกเก็ต ASUS อธิบายว่า Vera เป็น CPU ตัวแรกที่ออกแบบมาโดยเฉพาะสำหรับเอเจนต์ AI ตามเวิร์กโฟลว์ที่ ASUS ระบุ CPU จะจัดการการเรียกใช้โค้ดในแซนด์บ็อกซ์ การใช้เครื่องมือ การประสานงาน และการประมวลผลข้อมูล ขณะที่ GPU จะทำงานด้านการฝึกและการอนุมานโดยเฉพาะ
NVIDIA NVLink-C2C รุ่นที่สองรองรับการสื่อสารแบบสอดคล้องกันระหว่าง CPU สูงสุด 1.8TB/s และมีแบนด์วิดท์ระหว่างคอร์สูงสุด 3.4TB/s ตามข้อมูลในหน้าผลิตภัณฑ์ หน่วยความจำประกอบด้วยโมดูล SOCAMM2 จำนวน 16 โมดูล ซึ่งใช้ LPDDR5X ที่ความเร็ว 9600MT/s และมีความจุสูงสุด 1.5TB ASUS ระบุว่าการกำหนดค่านี้ให้ประสิทธิภาพด้านพลังงานสูงกว่าหน่วยความจำ RDIMM แบบดั้งเดิมสูงสุด 2 เท่า และลดการใช้พลังงานของหน่วยความจำลง 50%
พื้นที่จัดเก็บข้อมูลประกอบด้วยช่องใส่ไดรฟ์ E1.S แบบถอดเปลี่ยนขณะทำงานได้ 8 ช่อง ส่วนการขยายระบบมีสล็อต PCIe Gen6 x16 จำนวน 2 สล็อต และสล็อต DPU/NIC แบบ 2 สล็อตที่จัดไว้โดยเฉพาะ แชสซีระบายความร้อนด้วยอากาศทั้งหมด โดยมีลมไหลจากด้านหน้าไปด้านหลังผ่านโซนโปรเซสเซอร์ หน่วยความจำ และ GPU พร้อมชุดจ่ายไฟสำรองแบบ 2+2 กำลังไฟ 2000W มาตรฐาน 80 PLUS Titanium และไม่ต้องใช้โครงสร้างพื้นฐานสำหรับระบายความร้อนด้วยของเหลว ภายใต้การออกแบบแบบโมดูลาร์ MGX โมดูลโปรเซสเซอร์โฮสต์และช่องใส่ GPU ซึ่งรองรับ GPU RTX PRO 6000 Blackwell Server Edition แบบ 2 สล็อตได้สูงสุด 2 ตัว โดยแต่ละตัวใช้พลังงานได้สูงสุด 600W สามารถถอดซ่อมบำรุงแยกจากกันได้
ข้อจำกัดด้านฮาร์ดแวร์ 4 ประการของ AI แบบเอเจนต์ที่ ASUS ระบุ
ในบทวิเคราะห์เมื่อวันที่ 10 สิงหาคม 2026 ASUS ระบุข้อจำกัดด้านฮาร์ดแวร์ 4 ประการที่บริษัทกล่าวว่าเป็นอุปสรรคต่อการใช้งาน AI แบบเอเจนต์ ได้แก่ ประสิทธิภาพแบบเธรดเดียวที่ไม่เพียงพอเมื่อขยายขนาด แบนด์วิดท์หน่วยความจำต่อคอร์ที่ไม่เพียงพอ ความหน่วงในการเข้าถึงข้อมูลข้ามได และการขาดการแยกแซนด์บ็อกซ์ในระดับฮาร์ดแวร์ บริษัทระบุว่า XA P2N-E2 แก้ไขข้อจำกัดข้อสุดท้ายด้วยการแยกแซนด์บ็อกซ์ในระดับฮาร์ดแวร์สำหรับการเรียกใช้โค้ดของเอเจนต์ และระบุว่า CPU Vera มีประสิทธิภาพการประมวลผลแบบเธรดเดียวสูงกว่า CPU x86 แบบดั้งเดิมได้สูงสุด 1.8 เท่า เรียกใช้โค้ดในแซนด์บ็อกซ์ได้เร็วกว่าโครงสร้างพื้นฐาน x86 แบบดั้งเดิม 1.8 เท่า และทำให้เวิร์กโฟลว์การเขียนโค้ดเร็วขึ้นได้สูงสุด 1.5 เท่า ASUS เชื่อมโยงตัวเลขเหล่านี้กับการออกแบบ CPU Vera ที่มี 88 คอร์ แบนด์วิดท์หน่วยความจำ LPDDR5X สูงสุด 1.2TB/s และแบนด์วิดท์การเชื่อมต่อภายใน 3.4TB/s
บทวิเคราะห์เมื่อเดือนสิงหาคมดังกล่าวได้ระบุไว้ก่อนแล้วว่า XA P2N-E2 เปิดตัวพร้อมกับเซิร์ฟเวอร์ ASUS ที่ใช้โปรเซสเซอร์ AMD EPYC 9006 ได้แก่ ซีรีส์ RS700A-E14B, RS720A-E14B และ XA P8A-E14A สำหรับระบบเหล่านี้ ASUS ระบุว่ารองรับได้สูงสุด 256 คอร์ต่อซ็อกเก็ต และมีประสิทธิภาพโดยรวมสูงกว่ารุ่นก่อนหน้าประมาณ 70% โดยหน่วยความจำ DDR5 แบบ 16 แชนเนลให้แบนด์วิดท์ประมาณ 1.6TB/s
ระบบระดับแร็กและเทคโนโลยีแพลตฟอร์ม NVIDIA
นอกเหนือจากเซิร์ฟเวอร์ขนาด 2U แล้ว ASUS ยังจัดแสดงระบบระดับแร็กที่ OCP ด้วย XA VR721-E3 ASUS AI POD ผสาน CPU NVIDIA Vera 36 ตัวและ GPU NVIDIA Rubin 72 ตัวผ่านแพลตฟอร์ม NVIDIA Vera Rubin NVL72 ในสถาปัตยกรรมที่ระบายความร้อนด้วยของเหลวทั้งหมด สำหรับการฝึก AI การฝึกต่อยอด และการอนุมานในขนาดใหญ่ XR R1I12B-M1BHFS ผสาน NVIDIA HGX Rubin NVL8 เข้ากับระบบระบายความร้อนด้วยของเหลวโดยตรงถึงชิปสำหรับบอร์ดหลักของ GPU และระบบระบายความร้อนด้วยอากาศสำหรับโปรเซสเซอร์ Intel Xeon 6
ASUS ยังกล่าวถึงดีไซน์อ้างอิง NVIDIA DSX และ NVIDIA Omniverse DSX Blueprint ซึ่งบริษัทระบุว่าผสานสถาปัตยกรรมที่ผ่านการตรวจสอบความถูกต้องเข้ากับการจำลองความเที่ยงตรงสูง เพื่อสร้างดิจิทัลทวินที่สะท้อนสภาพทางกายภาพได้อย่างแม่นยำ สำหรับปรับปรุงการออกแบบและการดำเนินงานของโรงงาน AI ก่อนนำไปใช้งาน ที่บูธ ASUS มีการนำเสนอเทคโนโลยี NVIDIA 4 รายการ ได้แก่ การประมวลผลแบบเร่งความเร็ว HGX Rubin NVL8 ระบบสวิตช์อีเทอร์เน็ต Spectrum-X ที่ใช้ Spectrum-6 แพลตฟอร์มจัดเก็บข้อมูลหน่วยความจำบริบท CMX และตัวเร่งการอนุมาน Groq 3 LPX สำหรับ Vera Rubin NVL72 ซึ่งข่าวประชาสัมพันธ์ระบุว่าช่วยต่อยอดแพลตฟอร์ม NVL72 ด้วยการสร้างโทเค็นความเร็วสูงเป็นพิเศษ เพื่อให้การอนุมานตอบสนองได้รวดเร็วยิ่งขึ้น
ระบบที่จัดแสดงโดย Intel และ AMD
การจัดแสดงของ Intel มี RS700-E12-RS4U และ RS720-E12-RS12U ซึ่งเป็นเซิร์ฟเวอร์แบบ 1U และ 2U ที่ใช้ซ็อกเก็ตคู่ ขับเคลื่อนด้วยโปรเซสเซอร์ Intel Xeon 6 มาพร้อมดีไซน์ DC-MHS และออกแบบให้ซ่อมบำรุงได้โดยไม่ต้องใช้เครื่องมือ โดยมุ่งรองรับ AI แบบเอเจนต์ เวอร์ชวลไลเซชัน และเวิร์กโหลดที่ใช้ข้อมูลจำนวนมาก ส่วนการจัดแสดงของ AMD เปิดตัว RS700A-E14B-R16U ระบบขนาด 1U แบบซ็อกเก็ตคู่ที่พัฒนาบนโปรเซสเซอร์ AMD EPYC 9006-series รุ่นที่ 6 ซึ่งมีชื่อรหัสว่า “Venice” โดยผสานสถาปัตยกรรม DC-MHS เข้ากับการเชื่อมต่อ PCIe 6.0 และรองรับไดรฟ์ E3.S ได้สูงสุด 16 ตัว พร้อมใช้ ASUS Thermal Radar 3.0 สำหรับตรวจสอบและจัดการอุณหภูมิ
สำหรับงาน AI ที่ต้องการการเร่งประมวลผล ESC8000A-E13P รองรับตัวเร่งประมวลผล AMD Instinct MI350P แบบ PCIe ส่วน XA AM3A-E13 ผสานตัวเร่งประมวลผล AMD Instinct MI355X จำนวน 8 ตัวไว้ในระบบระบายความร้อนด้วยอากาศขนาด 10U ซึ่ง ASUS ระบุว่าช่วยให้ติดตั้งระบบความหนาแน่นสูงได้โดยไม่ต้องมีโครงสร้างพื้นฐานระบบน้ำเย็นโดยเฉพาะ ASUS จัดแสดงผลิตภัณฑ์ทั้งหมดที่บูธ #B9 ในงาน OCP Global Summit 2026 และระบุว่าเซิร์ฟเวอร์ของบริษัทมีจำหน่ายทั่วโลก ทั้งนี้ ความพร้อมจำหน่ายของผลิตภัณฑ์และการกำหนดค่าแต่ละรายการอาจแตกต่างกันไปตามภูมิภาค


