
มุมมองของ Anderson
งานวิจัยของ Adobe ขยายการแก้ไขใบหน้าด้วย GAN ที่แยกคุณลักษณะออกจากกัน

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
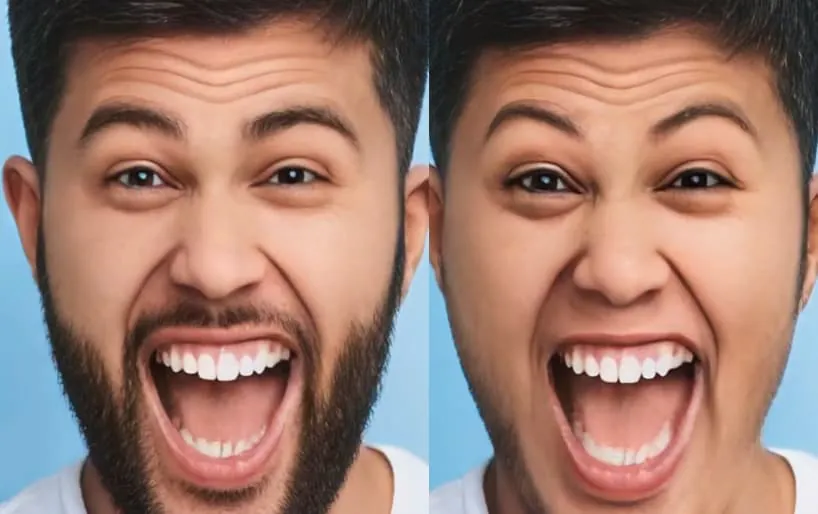
ประเด็นสำคัญAdobe's latent-to-latent mapper แช่แข็งเอกลักษณ์ในขณะที่แก้ไขลักษณะใบหน้า 35…
ดูเพิ่มเติม
- Adobe's latent-to-latent mapper แช่แข็งเอกลักษณ์ในขณะที่แก้ไขลักษณะใบหน้า 35 อย่างโดยไม่ต้องฝึกใหม่
- ระบบใช้ FaceNet เป็นตัวแยกแยะเพื่อป้องกันการเสื่อมของเอกลักษณ์ระหว่างการแปลงลักษณะ
- กรอบงานคู่แข่งอย่าง InterFaceGAN ทำให้อายุพันกับเพศหรือแว่นตา แต่แนวทางของ Adobe หลีกเลี่ยงผลข้างเคียงเหล่านี้
ไม่ยากที่จะเข้าใจว่าทำไม การผสมผสาน จึงเป็นปัญหาในการสังเคราะห์ภาพ เนื่องจากมักเป็นปัญหาในด้านอื่นๆ ของชีวิต เช่น การเอาขมิ้นออกจากแกงนั้นยากกว่าการเอาแตงกวาดองออกจากเบอร์เกอร์ และแทบจะเป็นไปไม่ได้ที่จะลดความหวานของกาแฟ นั่นเป็นเพราะบางสิ่งมาถึงพร้อมกัน
ในทำนองเดียวกัน การผสมผสานก็เป็นอุปสรรคต่อสถาปัตยกรรมการสังเคราะห์ภาพที่ต้องการแยกคุณลักษณะและแนวคิดที่แตกต่างกันเมื่อใช้การเรียนรู้ของเครื่องจักรในการสร้างหรือแก้ไขใบหน้า (หรือ สุนัข, เรือ, หรือด้านอื่นๆ)
หากคุณสามารถแยกเส้นเช่น อายุ, เพศ, สีผม, สีผิว, อารมณ์ และอื่นๆ คุณจะมีเครื่องมือที่แท้จริงและความยืดหยุ่นในเฟรมเวิร์กที่สามารถสร้างและแก้ไขภาพใบหน้าได้ที่ระดับที่ละเอียดมาก โดยไม่ต้องมีผู้โดยสารที่ไม่พึงประสงค์เข้ามาในกระบวนการแปลงเหล่านี้

ที่การผสมผสานสูงสุด (ด้านซ้ายบน) คุณสามารถเปลี่ยนภาพของเครือข่าย GAN ที่เรียนรู้มาเป็นภาพของบุคคลอื่นได้เท่านั้น
สิ่งนี้เทียบเท่ากับการใช้เทคโนโลยี AI การมองเห็นล่าสุดเพื่อให้บรรลุผลลัพธ์ที่แก้ไขได้ด้วยวิธีอื่น มากกว่าสามสิบปีที่แล้ว
ด้วยการแยกออกจากกันบางส่วน (‘การแยกออกจากกันระดับกลาง’ ในรูปด้านบน) คุณสามารถทำการเปลี่ยนแปลงตามสไตล์ เช่น สีผม การแสดงออก การใช้เครื่องสำอาง และการหมุนหัวแบบจำกัด เป็นต้น

ที่มา: FEAT: Face Editing with Attention, กุมภาพันธ์ 2022, https://arxiv.org/pdf/2202.02713.pdf
มีการพยายามสร้างสภาพแวดล้อมการแก้ไขใบหน้าที่โต้ตอบได้หลายครั้งในช่วงสองปีที่ผ่านมา ซึ่งช่วยให้ผู้ใช้สามารถเปลี่ยนคุณลักษณะใบหน้าได้ด้วยสไลด์และการโต้ตอบ UI แบบดั้งเดิม ในขณะเดียวกันก็รักษาคุณลักษณะหลักของใบหน้าเป้าหมายไว้เมื่อทำการเพิ่มหรือเปลี่ยนแปลง อย่างไรก็ตาม สิ่งนี้ได้พิสูจน์แล้วว่าเป็นความท้าทายเนื่องจากการผสมผสานคุณลักษณะ/สไตล์ในปริภูมิแฝงของ GAN
ตัวอย่างเช่น ลักษณะ แว่นตา มักจะผสมผสานกับลักษณะ อายุ ซึ่งหมายความว่าการเพิ่มแว่นตาอาจ “ทำให้อายุมากขึ้น” ใบหน้า ในขณะที่การทำให้อายุมากขึ้นอาจเพิ่มแว่นตาได้ ขึ้นอยู่กับระดับการแยกคุณลักษณะระดับสูง (ดู ‘การทดสอบ’ ด้านล่างสำหรับตัวอย่าง)
โดยเฉพาะอย่างยิ่ง มันเป็นเรื่องที่แทบจะเป็นไปไม่ได้ที่จะเปลี่ยนสีผมและด้านผมอื่นๆ โดยไม่ต้องคำนวณเส้นผมและทิศทางใหม่ ซึ่งให้เอฟเฟกต์กระพริบระหว่างการเปลี่ยนแปลง

ที่มา: วิดีโอสาธิต InterFaceGAN (CVPR 2020), https://www.youtube.com/watch?v=uoftpl3Bj6w
การเดินทาง Latent-to-Latent ของ GAN
เอกสารวิจัยใหม่ที่นำโดย Adobe (ADBE ) ที่ส่งเข้าร่วม WACV 2022 นำเสนอแนวทางใหม่ในการแก้ไขปัญหาที่ซ่อนอยู่เหล่านี้ใน เอกสาร ที่มีชื่อเรื่องว่า Latent to Latent: A Learned Mapper for Identity Preserving Editing of Multiple Face Attributes in StyleGAN-generated Images
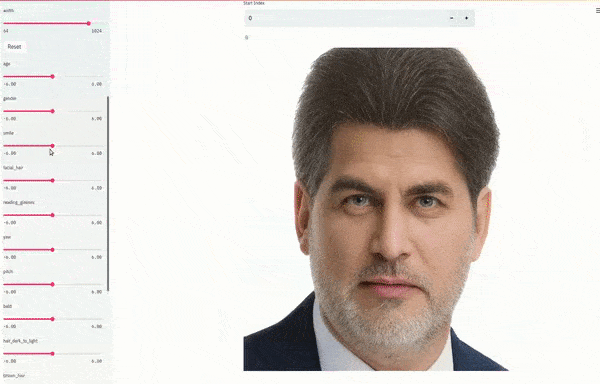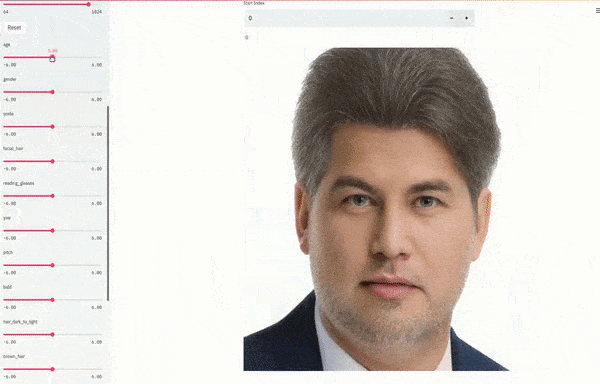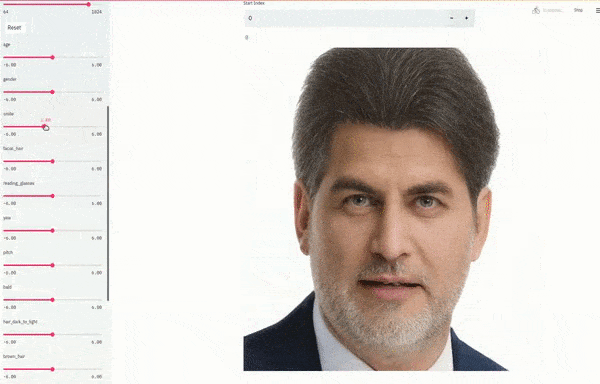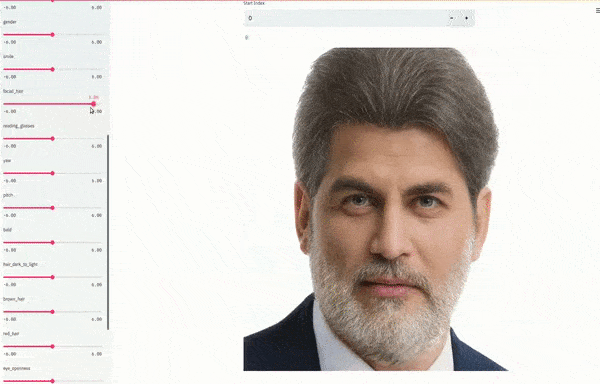
เนื้อหาเสริมจากบทความ Latent to Latent: A Learned Mapper for Identity Preserving Editing of Multiple Face Attributes in StyleGAN-generated Images. ภาพนี้แสดงว่าคุณลักษณะพื้นฐานของใบหน้าที่เรียนรู้มาไม่ถูกเปลี่ยนตามการแก้ไขที่ไม่เกี่ยวข้อง ดูวิดีโอฉบับเต็มที่ฝังไว้ท้ายบทความเพื่อดูรายละเอียดและความละเอียดที่ดีกว่า ที่มา: https://www.youtube.com/watch?v=rf_61llRH0Q
เอกสารถูกนำโดย Siavash Khodadadeh นักวิทยาศาสตร์ประยุกต์ของ Adobe ร่วมกับนักวิจัยอีกสี่คนจาก Adobe และนักวิจัยจาก ภาควิชาวิทยาการคอมพิวเตอร์ มหาวิทยาลัยเซ็นทรัลฟลอริดา
เอกสารถือเป็นเรื่องที่น่าสนใจส่วนหนึ่งเพราะ Adobe ได้ดำเนินงานในพื้นที่นี้มาระยะหนึ่งแล้ว และน่าสนใจที่จะเห็นฟังก์ชันนี้เข้ามาในโครงการ Creative Suite ในช่วงไม่กี่ปีข้างหน้า แต่ส่วนใหญ่เพราะสถาปัตยกรรมที่สร้างขึ้นสำหรับโครงการนี้ใช้แนวทางที่แตกต่างในการรักษาความสมบูรณ์ของภาพในตัวแก้ไขใบหน้า GAN ในขณะที่การเปลี่ยนแปลงกำลังถูกนำไปใช้
ผู้เขียนประกาศว่า:
‘[เรา] ฝึกเครือข่ายประสาทเพื่อทำการแปลง latent-to-latent ซึ่งพบการเข้ารหัส latent ที่สอดคล้องกับภาพที่มีลักษณะที่เปลี่ยนแปลงไป เนื่องจากเทคนิคนี้ทำงานในขั้นตอนเดียว จึงไม่ต้องอาศัยเส้นทางเชิงเส้นหรือไม่เชิงเส้นของการเปลี่ยนคุณลักษณะอย่างค่อยเป็นค่อยไป’
‘เมื่อฝึกเครือข่ายตั้งแต่ต้นจนจบตลอดกระบวนการสร้างภาพ ระบบสามารถปรับเข้ากับปริภูมิแฝงของสถาปัตยกรรมตัวสร้างสำเร็จรูปได้ คุณสมบัติที่ต้องการรักษา เช่น อัตลักษณ์ของบุคคล สามารถเข้ารหัสเป็นฟังก์ชันความสูญเสียในการฝึกได้ ‘
‘เมื่อฝึกเครือข่าย latent-to-latent แล้ว สามารถนำไปใช้กับภาพใดก็ได้โดยไม่ต้องฝึกใหม่’
สิ่งนี้หมายความว่าสถาปัตยกรรมที่เสนอมาถึงมาพร้อมกับผู้ใช้ในสถานะที่เสร็จสมบูรณ์ มันจำเป็นต้องรันเครือข่ายประสาทด้วยทรัพยากรประมวลผลในเครื่อง แต่ภาพใหม่สามารถ “ถูกวาง” และพร้อมสำหรับการเปลี่ยนแปลงเกือบในทันที เนื่องจากเฟรมเวิร์กแยกการทำงานได้เพียงพอในการไม่ต้องการการฝึกอบรมเฉพาะภาพอีกต่อไป
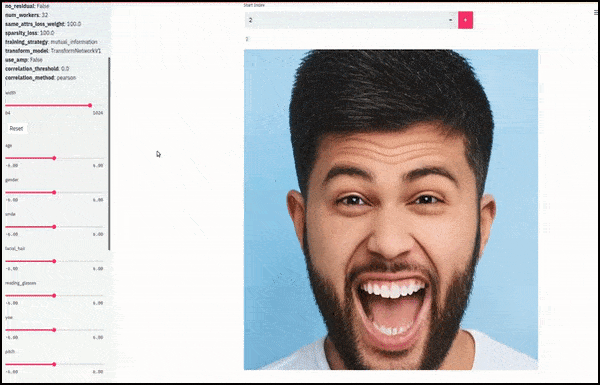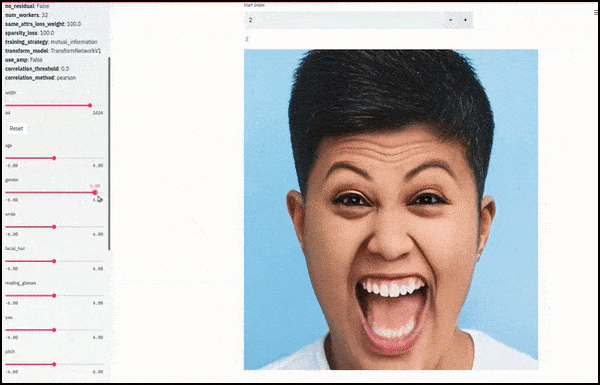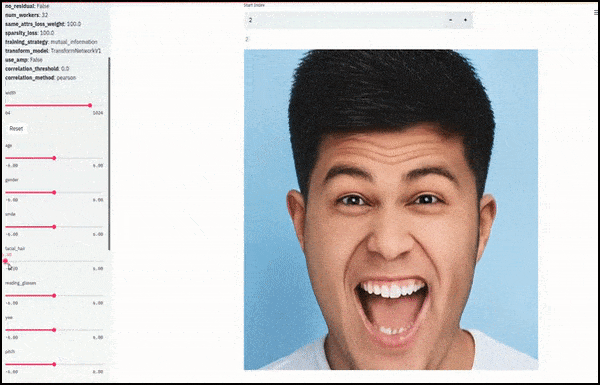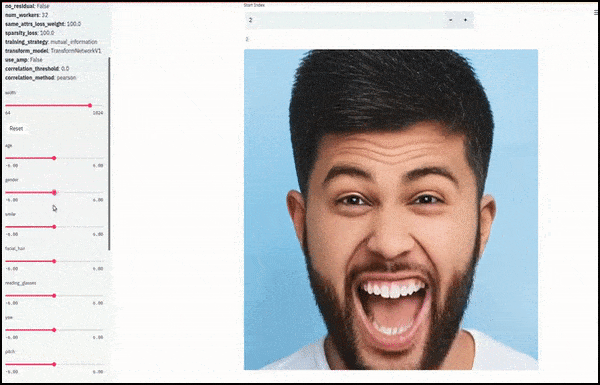
เพศและขนบนใบหน้าเปลี่ยนไปขณะที่ตัวเลื่อนกำหนดเส้นทางแบบสุ่มและอิสระผ่านปริภูมิแฝง ไม่ใช่เพียงการเลื่อนไปมาระหว่างจุดปลาย ดูวิดีโอท้ายบทความสำหรับตัวอย่างเพิ่มเติมที่มีความละเอียดสูงกว่า
ในบรรดาการบรรลุผลที่สำคัญในงานนี้คือความสามารถของเครือข่ายในการ “แช่แข็ง” อัตลักษณ์ในพื้นที่ latent โดยการเปลี่ยนแปลงเฉพาะคุณลักษณะในเวกเตอร์เป้าหมาย และให้ “เงื่อนไขการแก้ไข” ที่อนุรักษ์อัตลักษณ์ที่ถูกเปลี่ยนแปลง
โดยพื้นฐานแล้ว เครือข่ายที่เสนอถูกฝังอยู่ในสถาปัตยกรรมที่กว้างขึ้นซึ่งจัดการองค์ประกอบที่ประมวลผลทั้งหมด ซึ่งผ่านส่วนประกอบที่มีน้ำหนักถูกแช่แข็งซึ่งจะไม่สร้างผลกระทบด้านข้างที่ไม่พึงประสงค์ต่อการเปลี่ยนแปลง
เนื่องจากกระบวนการฝึกอบรมขึ้นอยู่กับ triplets ที่สามารถสร้างได้โดยภาพตั้งต้น (ภายใต้ GAN inversion) หรือการเข้ารหัส latent เริ่มต้น ระบบการฝึกอบรมทั้งหมดจึงไม่มีการดูแล และการกระทำที่ไม่พูดถึงของระบบการระบุและจัดระเบียบแบบดั้งเดิมในระบบเหล่านี้ถูกกำหนดไว้ในสถาปัตยกรรมโดยตรง ในความเป็นจริง ระบบใหม่นี้ใช้เครื่องมือระบุคุณลักษณะที่มีอยู่แล้ว:
‘[จำนวน] คุณลักษณะที่เครือข่ายของเราสามารถควบคุมได้อย่างอิสระถูกจำกัดเฉพาะความสามารถของตัวระบุ (s) – หากคุณมีตัวระบุสำหรับคุณลักษณะหนึ่งๆ เราสามารถเพิ่มมันให้กับใบหน้าได้โดยไม่จำกัด ในการทดลองของเรา เราได้ฝึกเครือข่าย latent-to-latent เพื่ออนุญาตให้ปรับเปลี่ยนคุณลักษณะใบหน้า 35 รายการ ซึ่งมากกว่าแนวทางก่อนหน้านี้’
ระบบรวมถึงการป้องกันเพิ่มเติมเพื่อป้องกันการเปลี่ยนแปลง “ผลกระทบด้านข้าง” ที่ไม่พึงประสงค์: ในการไม่มีการร้องขอคุณลักษณะการเปลี่ยนแปลง เครือข่าย latent-to-latent จะทำการแมปกับเวกเตอร์ latent ถึงตัวมันเอง ซึ่งเพิ่มความยั่งยืนของอัตลักษณ์เป้าหมาย
การรู้จำใบหน้า
ปัญหาหนึ่งที่เกิดขึ้นซ้ำๆ กับเครื่องแก้ไขใบหน้า GAN และตัวเข้ารหัส/ตัวถอดรหัสในหลายปีที่ผ่านมาคือการเปลี่ยนแปลงที่ใช้จะเสื่อมลงไปในด้านความเหมือนของบุคคล ในการรับมือกับสิ่งนี้ โครงการ Adobe ใช้เครือข่ายการรู้จำใบหน้าที่ฝังอยู่เรียกว่า FaceNet ในฐานะตัวแบ่งแยก

สถาปัตยกรรมโครงการ ดูบริเวณกลางล่างด้านซ้ายสำหรับส่วนที่รวม FaceNet ที่มา: Latent to Latent: A Learned Mapper for Identity Preserving Editing of Multiple Face Attributes in StyleGAN-generated Images, OpenAccess.
(ในเชิงส่วนตัว นี่ดูเหมือนเป็นขั้นตอนที่น่าสนใจในการรวมระบบการรู้จำใบหน้ามาตรฐานและแม้กระทั่งการรู้จำอารมณ์เข้ากับเครือข่ายสร้างสรรค์ ซึ่งอาจเป็นวิธีที่ดีที่สุดในการเอาชนะการ การแมปพิกเซลต่อพิกเซลแบบไม่เข้าใจเนื้อหา ที่ครอบงำสถาปัตยกรรม deepfake ปัจจุบัน โดยสูญเสียความเที่ยงตรงของการแสดงออกและโดเมินอื่นๆ ที่สำคัญในภาคการสร้างใบหน้า)
เข้าถึงทุกพื้นที่ ในพื้นที่ Latent
คุณลักษณะที่น่าประทับใจอีกอย่างหนึ่งของเฟรมเวิร์คคือความสามารถในการเดินทางระหว่างการเปลี่ยนแปลงที่เป็นไปได้ในพื้นที่ latent ตามความประสงค์ของผู้ใช้ ระบบก่อนหน้าหลายระบบที่ให้อินเทอร์เฟซการสำรวจมักจะปล่อยให้ผู้ใช้ “สครับ” ระหว่างเส้นทางการเปลี่ยนแปลงคุณลักษณะที่ถูกกำหนดไว้ล่วงหน้า – น่าประทับใจ แต่บ่อยครั้งเป็นประสบการณ์ที่เชื่องและจำกัด
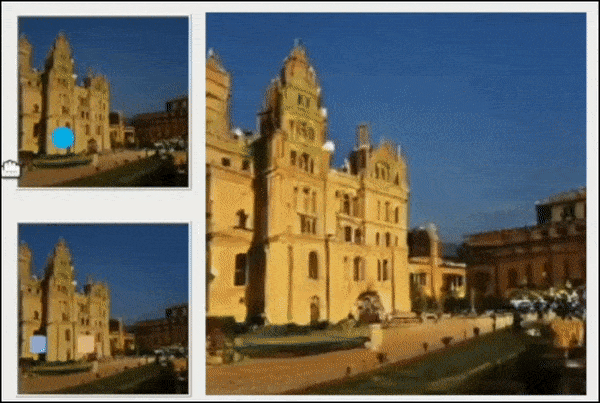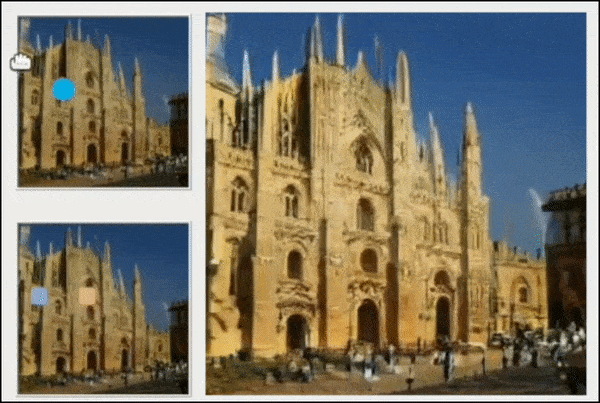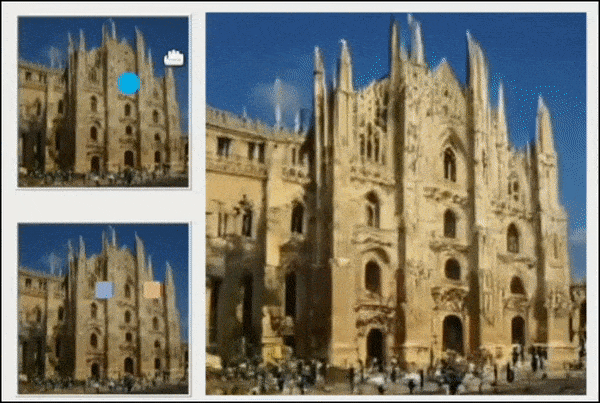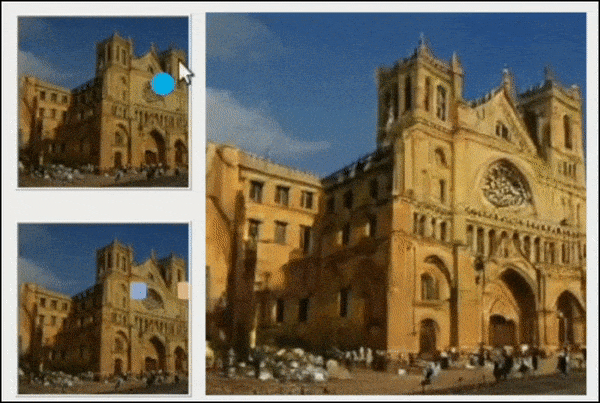
จาก Improving GAN Equilibrium by Raising Spatial Awareness: ผู้ใช้เลื่อนผ่านจุดเปลี่ยนที่เป็นไปได้ระหว่างตำแหน่งสองจุดในปริภูมิแฝง แต่ยังจำกัดอยู่ภายในตำแหน่งที่ฝึกไว้ การแปลงรูปแบบอื่นจากข้อมูลเดียวกันต้องกำหนดค่าใหม่หรือฝึกใหม่ ที่มา: https://genforce.github.io/eqgan/
นอกจากจะสามารถตอบสนองต่อภาพผู้ใช้ใหม่ๆ แล้ว ผู้ใช้ยังสามารถ “แช่แข็ง” องค์ประกอบที่ต้องการจะอนุรักษ์ระหว่างกระบวนการเปลี่ยนแปลงได้ ด้วยวิธีนี้ ผู้ใช้สามารถรับรองได้ว่า (ตัวอย่างเช่น) พื้นหลังจะไม่เปลี่ยนแปลง หรือว่าดวงตาจะถูกเก็บไว้แบบเปิดหรือปิด
ข้อมูล
เครือข่ายการถดถอยคุณลักษณะถูกฝึกด้วยชุดข้อมูลสามชุด: FFHQ, CelebAMask-HQ, และชุดข้อมูลท้องถิ่นที่สร้างโดย GAN ที่ได้รับมาจากการสุ่มเวกเตอร์ 400,000 ตัวจากพื้นที่ Z ของ StyleGAN-V2
ภาพที่อยู่นอกการกระจายถูกกรองออกไป และคุณลักษณะถูกถอดรหัสโดยใช้ Face API ของ Microsoft โดยที่ชุดภาพที่ได้รับถูกแบ่งออกเป็น 90/10 ซึ่งเหลือภาพฝึกอบรม 721,218 ภาพและภาพทดสอบ 72,172 ภาพเพื่อเปรียบเทียบ
การทดสอบ
แม้ว่าเครือข่ายทดลองจะถูกกำหนดค่าเริ่มต้นเพื่อรองรับการเปลี่ยนแปลงที่เป็นไปได้ 35 รายการ แต่ก็ถูกทำให้เล็กลงเหลือเพียงแปดรายการเพื่อดำเนินการการทดสอบที่คล้ายกันกับเฟรมเวิร์กที่เทียบเท่า InterFaceGAN, GANSpace, และ StyleFlow
คุณลักษณะที่เลือกแปดรายการคือ อายุ, ศีรษะล้าน, เครา, อารมณ์, เพศ, แว่นตา, มุมก้มเงย (pitch), และ มุมหันซ้ายขวา (yaw) จำเป็นต้องปรับเฟรมเวิร์กที่แข่งขันกันสำหรับคุณลักษณะบางอย่างที่ไม่ได้กำหนดไว้ในการกระจายต้นฉบับ เช่น การเพิ่ม ศีรษะล้าน และ เครา ให้กับ InterFaceGAN
ตามที่คาดไว้ การผสมผสานที่มากขึ้นเกิดขึ้นในสถาปัตยกรรมที่แข่งขันกัน ตัวอย่างเช่น ในการทดสอบหนึ่ง InterFaceGAN และ StyleFlow ทั้งสองเปลี่ยนเพศของวัตถุเมื่อถูกขอให้ใช้ อายุ:

เฟรมเวิร์กคู่แข่งสองระบบเปลี่ยนเพศพร้อมกับการเปลี่ยนอายุ และเปลี่ยนสีผมโดยที่ผู้ใช้ไม่ได้ร้องขอโดยตรง
นอกจากนี้ สองในสามเฟรมเวิร์กที่แข่งขันกันพบว่าคุณลักษณะแว่นตาและอายุเป็นคุณลักษณะที่แยกไม่ออก:

แถมการเปลี่ยนแว่นตาและสีผมให้โดยไม่ต้องร้องขอ!
ไม่ใช่ชัยชนะที่สม่ำเสมอสำหรับการวิจัย: ตามที่เห็นได้ในวิดีโอที่ฝังไว้ที่สิ้นสุดของบทความ เฟรมเวิร์กนี้มีประสิทธิภาพน้อยที่สุดเมื่อพยายามextrapolate มุมที่หลากหลาย (การหมุน) ในขณะที่ GANSpace มีผลลัพธ์ที่ดีกว่าสำหรับ อายุ และการวาง แว่นตา เครือข่าย latent-to-latent เสมอกับ GANSpace และ StyleFlow ในด้านการเพิ่มมุม (มุมของหัว)

ผลลัพธ์คำนวณจากการปรับเทียบตัวตรวจจับใบหน้า MTCNN ค่ายิ่งต่ำยิ่งดี
สำหรับรายละเอียดเพิ่มเติมและความละเอียดที่ดีขึ้นของตัวอย่าง โปรดดูวิดีโอที่ฝังไว้ที่สิ้นสุดของบทความ
เผยแพร่ครั้งแรกเมื่อวันที่ 16 กุมภาพันธ์ 2022





