
Grunderna i AI
Vad är en NPU? Neural Processing Units förklarade

 Lägg till Unite.AI bland dina föredragna källor på Google
En neural processing unit (NPU) är en specialiserad accelerator som är utformad för att effektivt utföra vanliga neurala nätverksoperationer. I telefoner, PC‑datorer, fordon, kameror och inbäddade system kan den köra stödda AI‑arbetsbelastningar med lägre energiförbrukning eller frigöra CPU och GPU för andra uppgifter.
NPU är en bred branschterm snarare än en enskild universell arkitektur. Prestanda beror på vilka operatorer som stöds, numeriska format, minne, kompilator och körtid, termiska begränsningar samt hur stor del av en applikation som kan ligga kvar på acceleratorn.
Viktiga slutsatser
- NPUs fokuserar på matris-, vektor- och tensoroperationer med hög dataåteranvändning och låg strömförbrukning.
- Peak‑TOPS är inte ett end‑to‑end‑applikationsbenchmark och kan anta en viss precision eller sparsitet.
- En modell kan behöva konverteras, kvantiseras, delas upp i grafdelar och ha fallback för operationer som inte stöds.
- Jämför latens, genomströmning, energi, minne, kvalitet, integritet och portabilitet på den faktiska arbetsbelastningen.
CPU-, GPU- och NPU‑roller
CPU:er utmärker sig i generell kontrollflöde och bred kompatibilitet. GPU:er erbjuder programmerbar parallell genomströmning och stora mjukvaruekosystem. NPU:er är specialiserade på återkommande tensoroperationer och kan innehålla lokalt minne, multiplikations‑ackumuleringsarrayer samt dataflöde optimerat för inferens.
Heterogena system schemalägger olika delar där de passar bäst. Detta är viktigt för edge‑AI, där uthållig effekt och svarstid kan vara viktigare än peak‑genomströmning i datacenter.
Modellkompilering och exekvering
Ett ramverks‑graf omvandlas till en mellanhandsrepresentation, optimeras, kvantiseras där det är lämpligt och kompileras för de stödda operatorerna. Körtiden kan partitionera grafen så att icke‑stödda lager körs på CPU eller GPU.
Överföringar mellan processorer kan sudda ut acceleratorns fördelar. Statisk form, layout, precision, batchning och minnesåteranvändning påverkar prestanda. Testa den kompilerade artefakten eftersom deep‑learning-modells kvalitet kan förändras efter konvertering.
Förstå TOPS‑ och effektivitetsanspråk
TOPS rapporterar biljoner operationer per sekund under definierade antaganden. Leverantörer kan räkna multiplikation och addition separat, använda låg‑bit‑heltalsprecision eller anta sparsitet. Ett högre tal garanterar inte lägre latens för en specifik modell.
Mät kall och varm start, per‑fråga‑latens, genomströmning, energi, maxminne, termisk strypning, stöd för kontext‑ eller bildstorlek samt andelen av grafen som accelereras. Använd motsvarande noggrannhet och mjukvaruversioner.
AI på enheten – avvägningar
Lokal exekvering kan minska nätverksberoendet och hålla rådata på enheten, men nedladdade modeller, loggar, säkerhetskopior och moln‑fallback‑lösningar skapar fortfarande dataflöden. Säker modellleverans och plattformsuppdateringar är fortfarande nödvändiga.
NPU:er kan stödja vision, audio, språk och sensortillämpningar, inklusive arbetsbelastningar som är nära TinyML. Utvecklare bör designa eleganta fallback‑mekanismer och informera när bearbetning lämnar enheten.
NPU‑arkitektur och stödda operationer
En NPU accelererar tensoroperationer genom att använda arrayer av multiplikations‑ackumuleringsenheter, lokalt minne, dataflödes‑schemaläggning och specialiserade numeriska format. Att hålla vikter och aktiveringar nära beräkningen minskar dyr datatransport. Faktiska enheter skiljer sig åt i stöd för operatorer, minneshierarki, precision, sparsitet, programmerbarhet och hur arbete delas med CPU och GPU.
Peak‑prestanda annonseras ofta i TOPS, men TOPS specificerar inte precision, utnyttjandegrad, minnesgränser, operator‑täckning eller end‑to‑end‑latens. Två processorer med samma rubriknummer kan prestera olika på samma modell. Benchmarka den kompilerade modellen med realistiska batch‑ och sekvensstorlekar, förbehandling, överföringar och strömförsörjningsläge.
NPU:er är effektiva för stödda neurala arbetsbelastningar såsom vision, tal, brusreducering, bakgrundseffekter och kompakta språkmodeller. Icke‑stödda operatorer kan falla tillbaka till CPU eller GPU, vilket skapar överföringar och oförutsägbar latens. Granska kompilatorrapporter och körtidsspår för att bekräfta placeringen istället för att anta att hela grafen använder acceleratorn.
Modellkonvertering, kvantisering och distribution
Distribution sker vanligtvis genom att gå från ett träningsramverk via export, grafoptimering, kvantisering, leverantörskompilering och körtidintegration. Statisk form och vanliga operatorer är enklast att accelerera. Dynamisk kontrollflöde, anpassade kärnor, stora mellantensorer samt icke‑stödd normalisering eller uppmärksamhetsmönster kan kräva grafändringar eller hybridexekvering.
Heltal och lägre precisionsformat minskar modellstorlek, bandbredd, energi och latens, men kalibreringsdata måste representera verkliga indata. Jämför post‑training‑kvantisering med kvantisering‑med‑medveten träning när kvaliteten är känslig. Utvärdera per‑klass‑ och värsta‑fall‑beteende eftersom genomsnittlig noggrannhet kan dölja försämring i sällsynta eller säkerhetskritiska fall.
Inferens på enheten förbättrar latens, offline‑drift och integritet genom att begränsa datatransfer, men enheten behöver fortfarande säkra modeller, behörighets‑medveten dataåtkomst och uppdateringsmekanismer. Skydda modellfiler där det är lämpligt, signera uppdateringar, avslöja moln‑fallback och säkerställ att telemetri inte återinför den integritetsrisk som den lokala arkitekturen avsåg att minska.
Prestandautvärdering och systemnivåavvägningar
Mät kallstart‑ och stabil‑latens, genomströmning, energi per inferens, minne, termiskt beteende, noggrannhet och batteripåverkan. Långa tester avslöjar strypning som korta benchmark‑tester missar. Inkludera för‑ och efterbehandling eftersom om‑skalning, tokenisering, avkodning eller datakopiering kan dominera en annars snabb accelerator.
Schemaläggning är ett systemproblem. CPU:n hanterar applikationslogik, GPU:n kan rendera eller köra icke‑stödda lager, och NPU:n kör kompatibla grafer. Samtidiga kamera‑, audio‑, display‑ och AI‑arbetsbelastningar konkurrerar om minnesbandbredd och ström. Testa hela användarscenariot snarare än en isolerad modell i ett leverantörsverktyg.
Portabiliteten är fortfarande begränsad mellan kompilatorer och körtider. Föredra standardmodellrepresentationer där de fungerar, isolera leverantörsspecifik kod bakom gränssnitt, bevara referensutdata och upprätthålla enhetstesttäckning. Välj hårdvara baserat på validerade arbetsbelastningar, mjukvarustöd, uppdateringshorisont och total systemkostnad – inte en enskild accelerator‑specifikation.
Praktiskt exempel: distribuera en vision‑modell till en NPU‑laptop
Ett team tränar en segmenteringsmodell för bakgrundseffekter, exporterar den till ett stödd utbytesformat, ersätter icke‑stödda operatorer och kalibrerar heltals‑kvantisering med representativa kameror, belysning, hudtoner, kläder och bakgrunder. Leverantörens kompilator rapporterar vilka noder som körs på NPU:n och vilka som faller tillbaka. Teamet betraktar varje fallback‑översättning som en systemkostnad, eftersom tensor‑överföringar kan dominera en snabb enskild kernel.
Benchmarking mäter kameraförbehandling, modellkörning, sammanslagning, minne, kallstart, stabil‑latens, bildstabilitet, ström och termisk strypning under ett verkligt videosamtal. Resultaten jämförs med CPU‑ och GPU‑vägar vid lika utdatakvalitet. Applikationen använder kapabilitet‑detektering och en testad fallback istället för att anta att acceleratorn finns eller stödjer samma graf efter en drivrutinsuppdatering.
Release‑testning omfattar enhetsmodeller, operativsystem‑ och drivrutinsversioner, samtidiga arbetsbelastningar, batterilägen och felaktig indata. Modellpaket signeras och versioneras; telemetri registrerar prestanda och fel utan att samla in onödig video. Produkten förklarar när bearbetning sker på enheten och när molnfunktioner används. NPU:n förtjänar sin plats genom att förbättra hela upplevelsen under realistiska begränsningar, inte genom att uppnå ett isolerat TOPS‑ eller kernel‑benchmark.
Praktisk implementeringschecklista
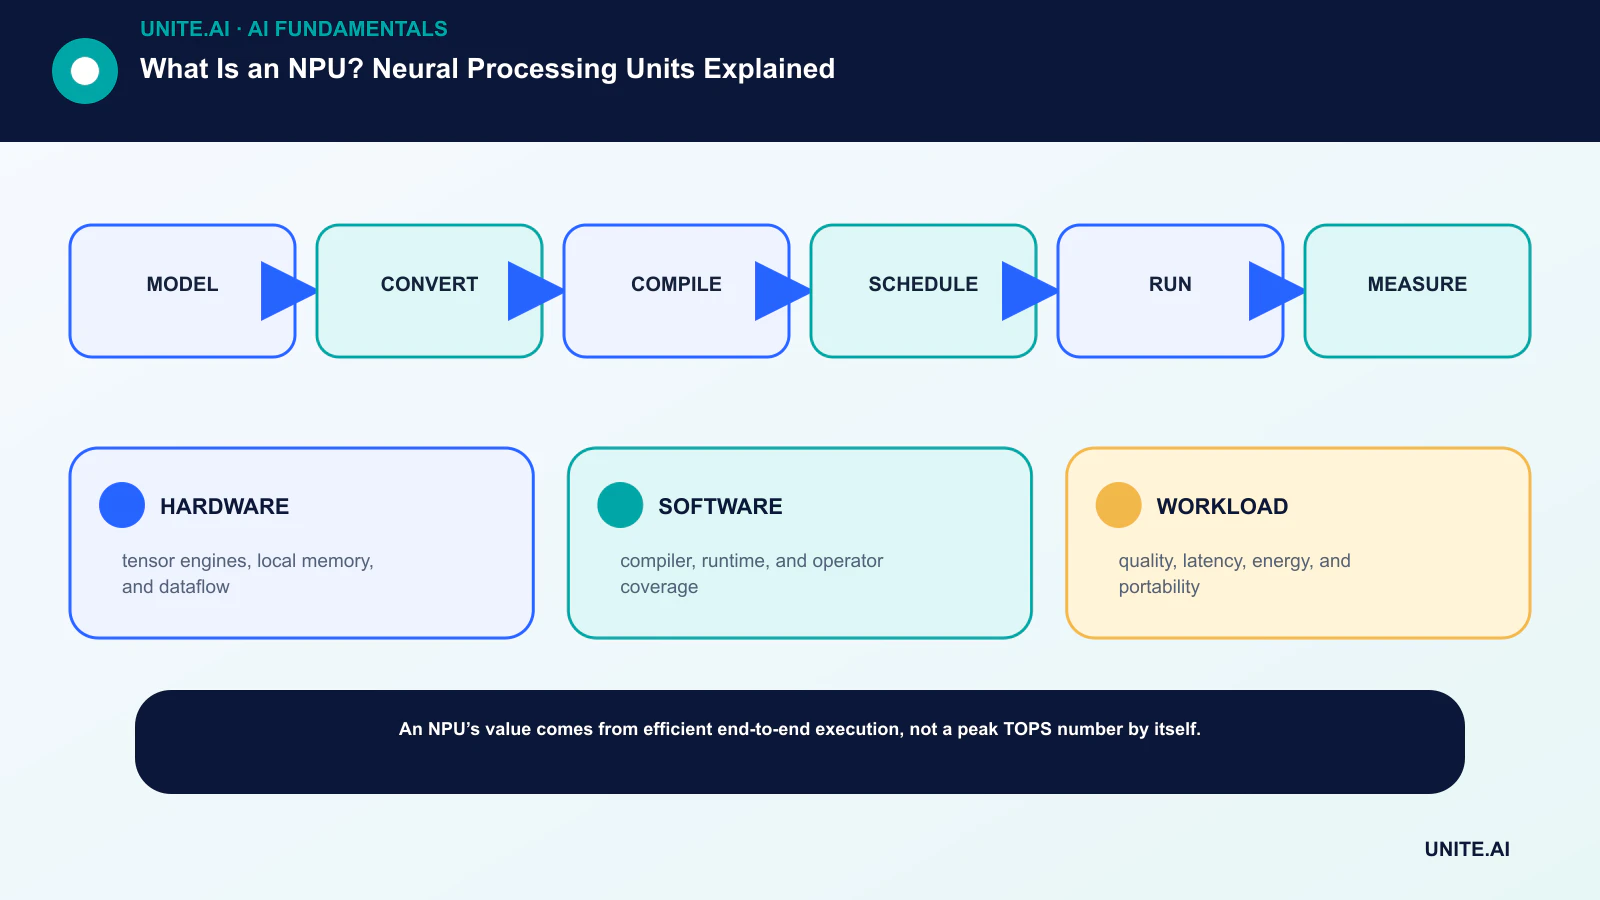
Omvandla konceptet till ett avgränsat, testbart arbetsflöde: modell → konvertera → kompilera → schemalägga → köra → mäta. Utse en ansvarig ägare, dokumentera data och beroenden, etablera en enkel referens, sätt acceptans‑ och stoppkriterier, testa representativa fel och definiera övervakning, återställning och granskning innan omfattningen utökas. Registrera versioner och antaganden så att ett annat team kan reproducera resultatet och förstå vad som förändrats.
Före lansering, genomför en dokumenterad beredskapsgranskning med de personer som bygger, driver, säkrar och påverkas av systemet. Testa normala fall, gränsvillkor, beroendefel och missbruk; bevara bevis och olösta risker. Definiera vem som kan godkänna en release, ändra ett tröskelvärde, åsidosätta en utdata eller stoppa driften. Ompröva beslutet när verkliga data kommer, eftersom ett tekniskt lyckat pilotprojekt inte garanterar pålitlig prestanda i större skala.
- HARDWARE: tensor‑motorer, lokalt minne och dataflöde.
- SOFTWARE: kompilator, körtid och operator‑täckning.
- WORKLOAD: kvalitet, latens, energi och portabilitet.
Vanliga frågor
Är en NPU snabbare än en GPU?
Det beror på modellen, precisionen, operatorstöd, batch‑storlek, strömgräns och mjukvara. En NPU kan vara mer effektiv för en stödd arbetsbelastning på enheten, medan en GPU är snabbare eller mer flexibel i andra situationer.
Behåller en NPU all AI‑data privat?
Nej. Den möjliggör lokal bearbetning, men applikationen kan fortfarande skicka data eller utdata till molntjänster. Integriteten beror på den fullständiga arkitekturen och policyn.
Primära referenser












