
Grunderna i AI
Vad är TinyML? Maskininlärning på mikrokontroller

 Lägg till Unite.AI bland dina föredragna källor på Google
TinyML möjliggör maskininlärningsinferens på starkt begränsade enheter såsom mikrokontroller, små digitala signalprocessorer och lågströmsensorer. Dessa system kan ha kilobyte eller megabyte minne, strikta energibudgetar, ingen kontinuerlig nätverksanslutning och realtidsdeadlines.
Värdet ligger inte bara i en mindre modell. Bearbetning nära sensorn kan minska latens, bandbredd och exponering av rådata samtidigt som den möjliggör produkter som kan fungera under långa perioder på batterier eller insamlad energi.
Viktiga slutsatser
- TinyML definieras av hela hård- och mjukvarubudgeten, inte av ett enda modellstorleksgränsvärde.
- Kvantisering, kompakta arkitekturer, optimerade kärnor och noggrann buffring möjliggör implementering.
- Inferens på enheten kan förbättra integriteten, men säkra uppdateringar och datastyrning är fortfarande viktiga.
- Utvärdera noggrannhet tillsammans med latens, maxminne, energi, driftscykel och robusthet.
TinyML‑stacken
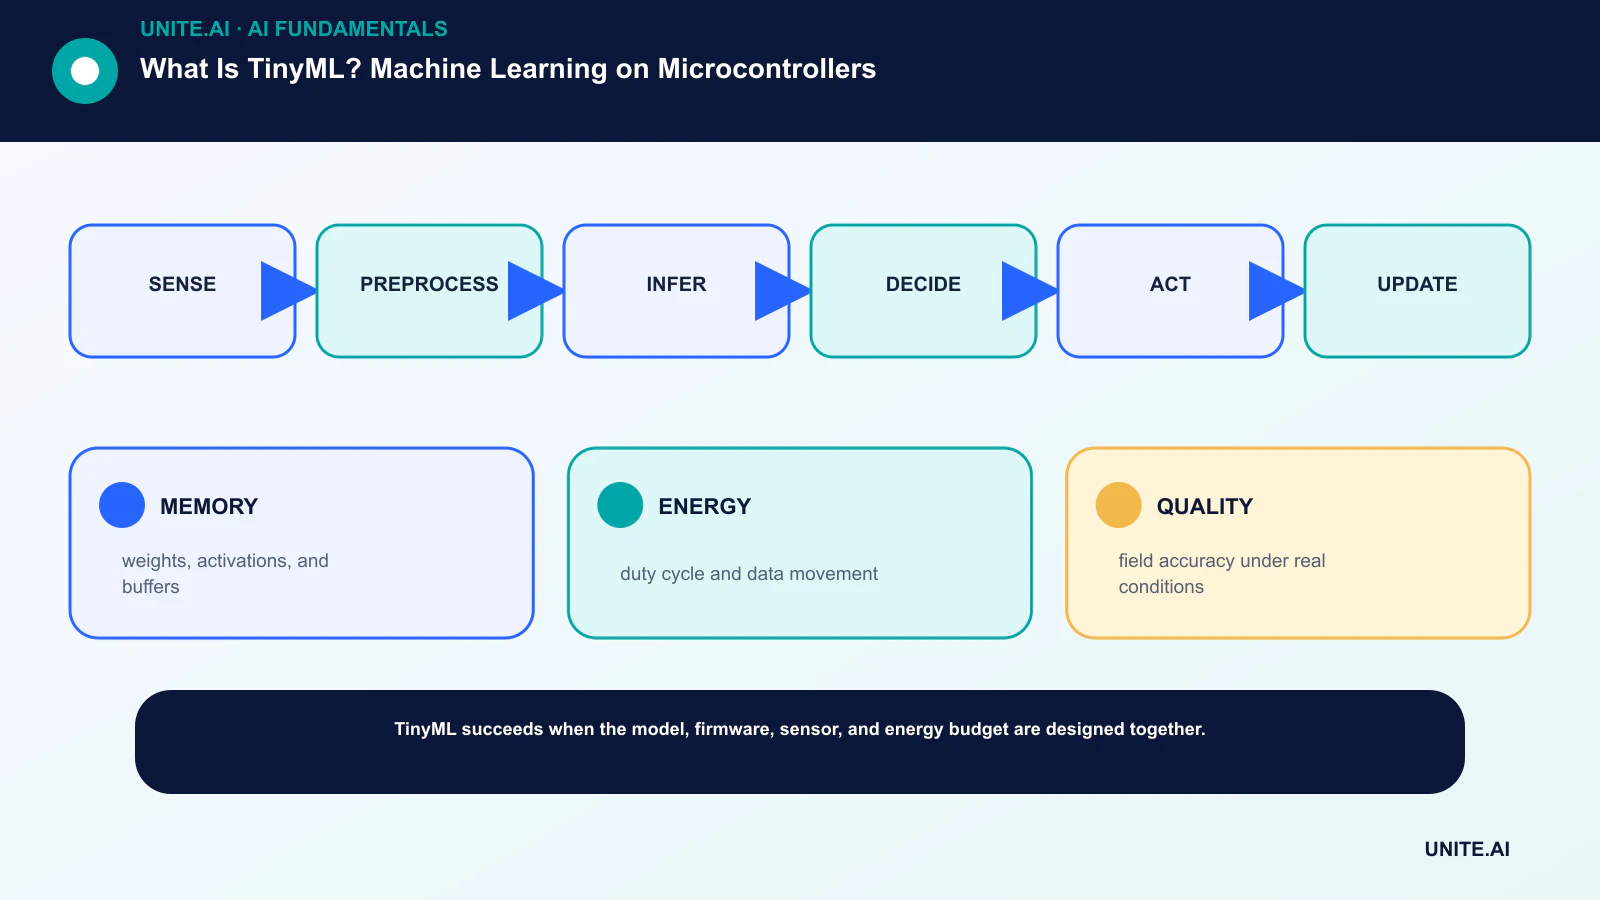
En sensor fångar ljud, rörelse, vibration, bild eller annan signal. Firmware förbehandlar den till funktioner eller tensorer; en kompakt modell körs genom en inbäddad runtime; applikationslogik avgör om ett större system ska väckas eller om åtgärden ska ske lokalt.
Detta är en begränsad form av edge AI. Hårdvaran kan bestå av en MCU, minne, sensorgränssnitt och ibland en neuralaccelerator. Varje buffer, operator och kopiering konkurrerar om begränsade resurser.
Få modellen att passa
Kvantisering ersätter högprecisionsvärden med mindre heltalsrepresentationer. Beskärning, destillation, funktionsutformning och arkitektursökning kan minska beräkning eller lagring. Stöd för operatorer i mål‑runtime begränsar vilka modeller som är praktiska.
Träning sker ofta på kraftfullare hårdvara, varefter modellen konverteras och kompileras för enheten. Transfer‑learning kan minska datakrav, men den slutgiltiga artefakten måste utvärderas efter konvertering eftersom numeriska förändringar kan påverka noggrannheten.
Data‑ och miljöskift
Laboratorieinspelningar representerar sällan varje mikrofon, monteringsposition, temperatur, vibrationsmönster, accent eller bakgrundsförhållande. Samla in data från representativa enheter och miljöer, håll tränings‑ och testkällor oberoende och inkludera ‘inget av ovanstående’-fall.
En falsk utlösning kan slösa energi eller irritera en användare; en missad avvikelse kan bli kostsam. Välj trösklar utifrån de faktiska felkostnaderna och övervaka fältprestanda via integritetsskyddande sammanfattningar eller provdiagnostik där det är lämpligt.
Mät hela enheten
Modellens operationer motsvarar inte produktens prestanda. Rapportera väckningsfrekvens, förbehandlingstid, inferenslatens, max RAM, flash‑användning, genomsnittlig och maximal effekt, termiskt beteende och batteripåverkan under en tydlig driftscykel.
Planera signerade firmware‑ och modelluppdateringar, återgång, enhetsidentitet och sårbarhetsrespons. Små enheter kan vara i drift i åratal, så underhållbarhet är en del av modellens kvalitet. Säkerhetskontroller kan inte skjutas upp bara för att enheten är liten.
Minnes‑ och beräkningsbudgetering
Flash lagrar firmware, modellvikter och konstanter; RAM rymmer sensorbuffertar, mellansteg av aktiveringar och runtime‑tillstånd. Maximal aktiveringsminne kan överstiga viktstorleken, särskilt i tidiga konvolutionella lager. Minnesplanerare återanvänder buffertar vars livstider inte överlappar, medan strömmande funktioner undviker att lagra ett helt signalfönster.
Operationsantal är en initial uppskattning, men kernel‑effektivitet beror på tensorform, justering, instruktionstöd och minnesåtkomst. En depthwise‑konvolution kan minska aritmetik men kör dåligt på hårdvara utan en optimerad kernel. Benchmarka den kompilerade modellen på mål‑kortet, inte bara i en desktop‑profilerare.
Driftscykling dominerar många produkter. Sensorn och MCU:n kan sova, väckas för en billig utlösning, köra en liten modell och aktivera en radio eller större processor endast vid behov. Mät hela driftscykeln, inklusive sensor, konvertering, förbehandling, uppvaknande, inferens, kommunikation och viloläckage.
Modellutveckling och konvertering
Börja med implementeringsbegränsningarna och samla in representativ sensor data. Förbehandling som används vid träning måste exakt matcha fast‑punkt‑ eller inbäddad implementation. Skillnader i samplingsfrekvens, fönster, färgkonvertering, normalisering eller funktionsutvinning kan få en modell att misslyckas även när konverteringen lyckas.
Eftertränings‑kvantisering kalibrerar intervall från representativa prover; kvantiserings‑medveten träning simulerar lägre precision under inlärning. Per‑kanal‑vikt‑skalor bevarar ofta konvolutionell kvalitet bättre än en enda skala. Operationer som inte stöds kan skrivas om, approximeras eller flyttas till en långsammare reserv, vilket alla kräver ny utvärdering.
Komprimering bör vara hypotesdriven. Beskärning av ostrukturerade vikter kanske inte snabbar upp en tät inbäddad kernel; strukturerad kanalborttagning är enklare för hårdvara att utnyttja. Destillation överför beteende från en större lärare men kan även föra över dess bias och misstag. Jämför med signalbehandling och tröskel‑baslinjer.
Tillämpningar, fälttestning och underhåll
Vanliga TinyML‑uppgifter inkluderar nyckelordsdetektering, väckningsorddetektering, gestigenkänning, vibrationsavvikelser, beläggning, akustiska händelser och enkel bildbehandling. Modellen kan fungera som en grind snarare än det slutgiltiga beslutet, vilket sparar bandbredd genom att skicka osäkra eller viktiga fall till ett mer kapabelt system.
Fälttester bör omfatta enhetens toleranser, sensoråldrande, montering, batteristatus, temperatur, väder, användare och bakgrundsstörningar. Följ falska utlösningar per timme eller missade händelser per driftcykel, inte bara balanserad testnoggrannhet. En tröskel som valts i laboratoriet kan behöva produkt‑specifik kalibrering.
Planera för signerade over‑the‑air‑uppdateringar, återgång, modell‑versions‑telemetri och långa supportperioder. Om uppdateringar är omöjliga, använd konservativa modeller och dokumentera förväntad miljödrift. Avveckling måste återkalla enhetsuppgifter och hantera lagrad data, inte bara sluta sälja produkten.
Arbetsexempel: en TinyML‑vibrationsmonitor
En liten accelerometer på en motor samplar vibration under normala belastningar och kända felvillkor. Enheten fönsterar signalen, tar bort offset, beräknar kompakta tids‑ eller frekvensdomän‑funktioner och kör en avvikelse‑detektor eller klassificerare. Samplingsfrekvensen måste fånga relevanta lager‑ och axelfrekvenser utan att överbelasta minne eller energi. Etiketter bör hämtas från verifierade inspektioner, inte bara från ett larm som själv kan vara felaktigt.
Träning sker på en arbetsstation, följt av kvantisering, konvertering och kompilering för mål‑mikrokontrollern. Mät modellens flash, max RAM, exekveringstid, energi och noggrannhet på den fysiska enheten. Heltalsaritmetik och tillgängliga operatorer kan förändra utdata från träningsmodellen. Testa sensororientering, montering, temperatur, spänning, komponentvariation och verklig bakgrundsvibration, inte bara kuraterade laboratoriefiler.
Den implementerade enheten kräver kalibrering, säkra firmware‑uppdateringar, versionsrapportering, felsäker funktion och en plan för drift. Den kan bara överföra ett hälsopoäng eller utvalda funktioner för att spara energi och skydda rådata, men lokala falska larm skapar ändå underhållskostnader. Använd en stegvis tröskel, kräva beständighet och kombinera modellens bevis med driftstillståndet. TinyML är mest värdefull när lokal latens, integritet, anslutning eller energibegränsningar motiverar dess ingenjörsmässiga gränser.
Produktionsprovning bör inkludera återhämtning efter strömcykel, klockdrift, sensoravbrott, korrupt indata, minnesutarmning och avbrutna uppdateringar. Definiera vad som händer när modellen inte kan köras eller förtroendet kollapsar: ett säkert standardvärde, en explicit felindikator eller en konventionell regel kan vara att föredra framför en tyst gissning. Följ flotta hård- och firmware‑versioner så att ett nyupptäckt fel kan isoleras till en enhetsrevision, miljö eller modellutgåva.
Praktisk implementeringschecklista
Omvandla konceptet till ett avgränsat, testbart arbetsflöde: upptäck → förbehandla → infer → besluta → agera → uppdatera. Utse en ansvarig ägare, dokumentera data och beroenden, etablera en enkel baslinje, sätt acceptans‑ och stoppkriterier, testa representativa fel och definiera övervakning, återgång och granskning innan omfattningen utökas. Registrera versioner och antaganden så att ett annat team kan reproducera resultatet och förstå vad som förändrats.
Innan lansering, genomför en dokumenterad beredskapsgranskning med de personer som bygger, driver, säkrar och påverkas av systemet. Testa normala fall, gränsvillkor, beroendefel och missbruk; bevara bevisen och olösta risker. Definiera vem som kan godkänna en release, ändra en tröskel, åsidosätta ett resultat eller stoppa driften. Ompröva beslutet när verkliga data anländer, eftersom ett tekniskt lyckat pilotprojekt inte garanterar pålitlig prestanda i större skala.
- MINNE: vikter, aktiveringar och buffertar.
- ENERGI: driftscykel och datatransfer.
- KVALITET: fält‑noggrannhet under verkliga förhållanden.
Vanliga frågor
Är TinyML samma som mobil‑AI?
Inte riktigt. Mobila enheter är edge‑system med relativt stora processorer och minne. TinyML fokuserar på mycket strängare inbäddade och mikrokontroller‑klassens begränsningar.
Kan TinyML‑modeller lära sig på enheten?
De flesta implementeringar tränas någon annanstans och infereras på enheten. Begränsad anpassning är möjlig, men minne, energi, stabilitet, integritet och återgång gör träning på enheten svårare.
Primära referenser












