
Grunderna i AI
Vad är datorseende?

 Lägg till Unite.AI bland dina föredragna källor på Google
Datorseende är området som bygger system som extraherar användbar information från bilder och video. En visionsmodell kan klassificera en hel bild, lokalisera objekt, märka varje pixel, läsa text, uppskatta pose, spåra rörelse eller koppla visuellt innehåll till språk.
Moderna visionssystem reproducerar inte bara den tidiga kantdetekteringsprocessen i mänsklig perception. De lär sig uppgiftspecifika representationer från data, ofta med hjälp av konvolutionella neurala nätverk, visiontransformers eller multimodala grundmodeller.
Viktiga punkter
- Klassificering, detektering, segmentering, OCR, spårning och generering är olika visionsuppgifter.
- CNN:er bygger in lokalitet och viktdelning; visiontransformers använder uppmärksamhet över bildpatchar.
- Etiketter kan komma från människor, svag övervakning, syntetisk data eller självövervakade mål.
- Noggrannhet ensam är otillräckligt: robusthet, latens, integritet, bias och felkostnader är viktiga.
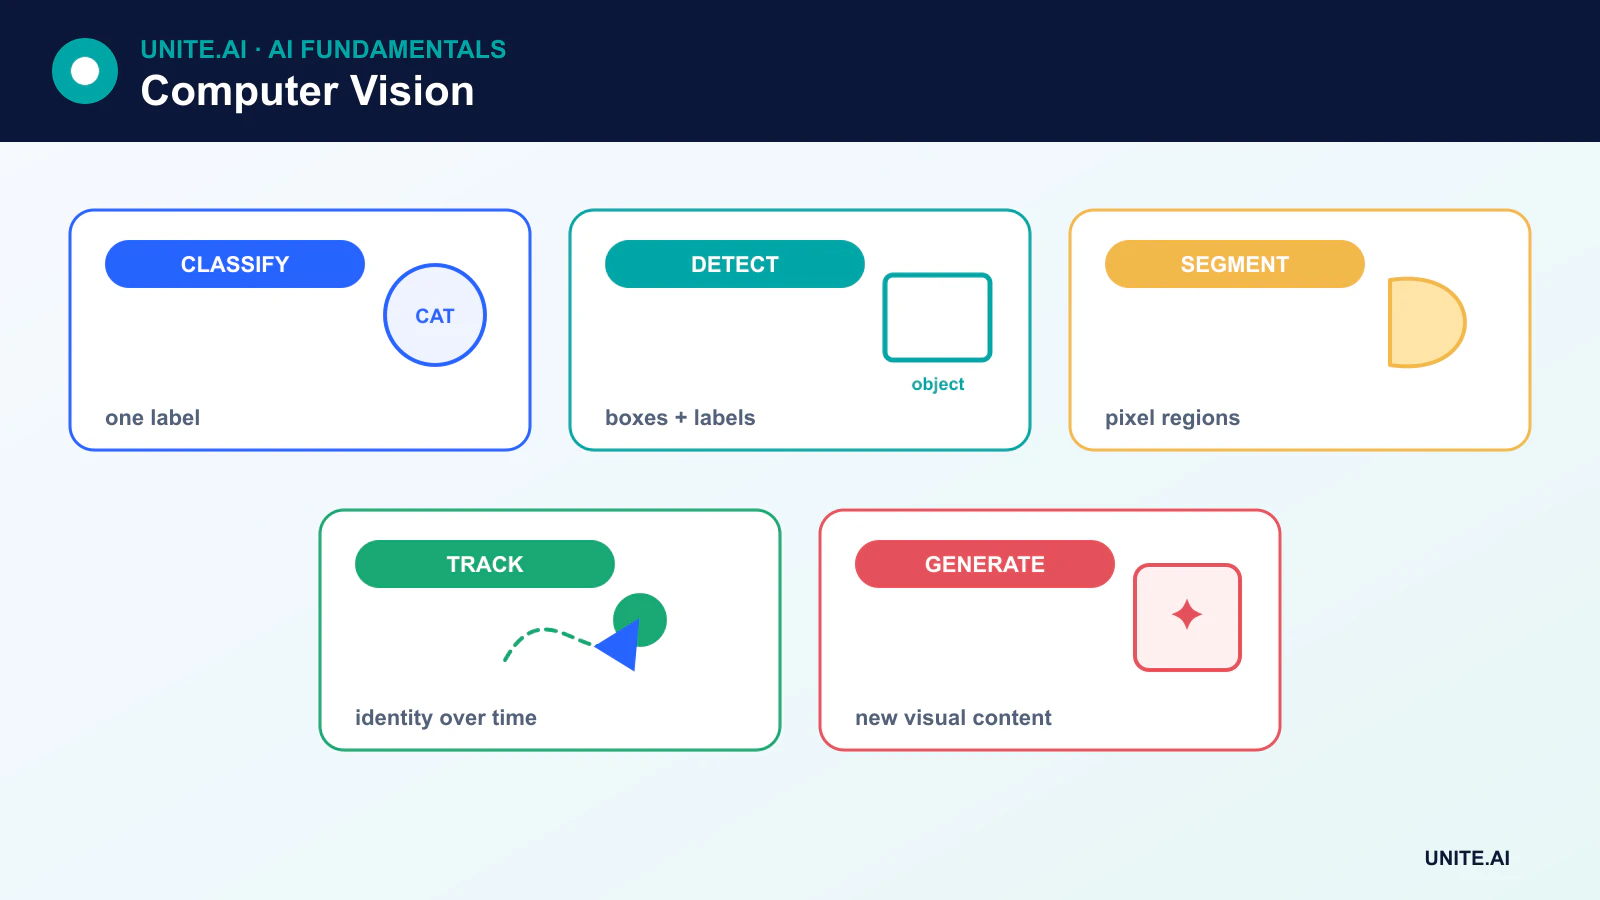
De viktigaste datorseende-uppgifterna
- Bildklassificering tilldelar en eller flera etiketter till en bild. Se hur bildklassificering fungerar.
- Objektdetektering förutsäger kategorier och begränsningsrutor för flera objekt.
- Semantisk segmentering märker varje pixel efter klass, medan instanssegmentering separerar enskilda objekt.
- Optisk teckenigenkänning (OCR) upptäcker och transkriberar text.
- Pose‑estimering förutsäger kroppens eller objektets nyckelpunkter.
- Spårning associerar detektioner över videoramar.
- Bildgenerering och -redigering skapar eller omvandlar visuellt innehåll, ofta med diffusion‑modeller.
Hur bilder blir modellens indata
En digital bild är redan numerisk data: en tensor som innehåller pixelvärden över rumsliga dimensioner och kanaler. Förbehandling kan ändra storlek, normalisera, beskära eller förstärka bilden. Video lägger till en tidsdimension, medan medicinsk och vetenskaplig avbildning kan lägga till djup, våglängd eller andra modaliteter.
Klassisk datorseende använde handgjorda kant-, hörn- och texturfunktioner. Moderna djupa modeller lär vanligtvis funktioner gemensamt med uppgiften, men klassiska metoder är fortfarande användbara när data är begränsad, regler är väl förstådda eller beräkning måste vara minimal.
CNN:er och inlärda lokala funktioner
En CNN tillämpar inlärda kärnor över lokala grannskap. Tidiga lager kan svara på lokala mönster, medan senare block kombinerar dem till uppgiftsrelevanta representationer. Poolning eller stegvisa operationer minskar den rumsliga upplösningen, och residualanslutningar gör djupa nätverk enklare att optimera.
En modern CNN‑klassificerare använder ofta global poolning istället för en stor stapel av fullt anslutna lager. Detektorer och segmenteringsnätverk lägger till specialiserade huvuden eller avkodningsvägar som bevarar rumlig information.
Visiontransformers och grundmodeller
En visiontransformer delar en bild i patchar, inbäddar dem och använder uppmärksamhet för att modellera deras relationer. Transformers kan skala effektivt med stora datamängder och förträning, medan CNN:er ofta ger starkare inbyggda antaganden och effektivitet i mindre skala.
Multimodala modeller anpassar bilder med text så att användare kan söka, skapa bildtexter, svara på frågor eller styra segmentering med språk. Dessa modeller utökar funktionaliteten men är ocksåvervda av svagheter från bred webbskala‑data, inklusive stereotyper, upphovsrättsskyddat material och ojämn täckning av befolkningar och miljöer.
Etiketter, självövervakning och syntetisk data
Begränsningsrutor, masker, nyckelpunkter och bildtexter kan vara dyra att skapa. Självövervakad inlärning härleder mål från bilderna själva, medan svag övervakning använder brusiga eller indirekta etiketter. Syntetisk data kan lägga till sällsynta scenarier, men simuleringsgap kan hindra syntetisk prestanda från att överföras till den verkliga världen.
Annoteringskvalitet måste mätas. Otydliga etiketter, inkonsekventa gränser och saknade objekt sätter ett tak för prestanda och kan dölja misslyckanden i undergrupper.
Hur visionssystem utvärderas
Klassificering använder mått som noggrannhet, precision, återkallelse, F1 och kalibrering. Detektering använder vanligtvis intersection over union och medelvärde av precision. Segmentering använder intersection over union eller Dice‑liknande mått. Spårning lägger till identitets‑ och trajektoriemått.
Måttet måste matcha implementeringen. En modell kan prestera bra på ett kuraterat benchmark men ändå misslyckas i regn, svagt ljus, ovanliga kameravinklar, nya enheter eller okända befolkningar. Utvärdering bör inkludera fördelningsskift, adversariella förhållanden och operativ latens.
Integritet, bias och implementering
Ansikten, registreringsskyltar, hem, medicinska skanningar och arbetsplatsvideo kan avslöja känslig information. Insamling och lagring bör följa en definierad juridisk och etisk grund, med åtkomstkontroller och dataminimering. Ansiktsanalys och biometrisk identifiering förtjänar särskild granskning eftersom fel och övervakning kan medföra ojämlika skador.
Edge‑implementering kan minska latens och datatransfer. Edge AI, kvantisering, beskärning och specialiserade acceleratorer kan göra visionssystem praktiska på kameror, fordon, robotar och mobila enheter, men komprimering måste omvärderas för noggrannhet och bias.
Från pixlar till visuella uppgifter
Datorseende omvandlar bilder eller video till uppgiftsutdata såsom klassificering, detektering, segmentering, spårning, pose, djup, optiskt flöde eller textigenkänning. Uppgiftsdefinitionen bestämmer annoteringen: en bildetikett kan inte träna exakt lokalisering, och en begränsningsruta kan inte fullt beskriva en segmenteringsmask. Kamerageometri, linser, exponering, belysning, rörelse, komprimering och synvinkel formar datafördelningen. Definiera driftsmiljön och felkonsekvensen innan du väljer en modell, eftersom en benchmark‑bildsamling kanske inte representerar den implementerade sensorn eller scenen.
En pipeline avkodar och orienterar media, ändrar storlek eller delar den i rutor, normaliserar värden, tillämpar etikettbevarande förstärkning, kör en modell och efterbehandlar logits, rutor, masker eller spår. Objektdetektorer använder förtroendetrösklar och undertryckning; spårare associerar detektioner över tid; segmentering kan kräva morfologisk rengöring. Bevara koordinattransformeringar så att utdata stämmer överens med originalbilden. Dela upp data efter person, kamera, plats eller inspelningssession för att undvika att nästan identiska ramar förekommer i både tränings‑ och testset.
Utvärdering, bias, integritet och drift
Mått måste matcha uppgift och användning. Klassificering kräver klassspecifik precision och återkallelse; detektering använder intersection‑over‑union och medelprecision över trösklar; segmentering använder IoU eller Dice; spårning lägger till identitetsbyten; latens och missade händelsevaraktigheter är viktiga för video. Rapportera resultat efter belysning, avstånd, enhet, ocklusion, hudton, ålder och andra relevanta förhållanden. Inspektera kalibrering och fel med hög förtroende. Syntetisk eller förstärkt data kan fylla luckor men kräver jämförelse med verklig driftsdata och får inte läcka testscener.
Vision kan samla in förbipasserande, platser, biometrik och känsligt beteende. Minimera inspelning och lagring, säkra strömmar, begränsa sekundär användning och ge meddelande eller samtycke där det krävs. Testa adversariella lappar, återuppspelning, ocklusion, kamerafel och domänskifte. Övervaka sensors hälsa, indata‑statistik, utdatafrekvens och bekräftade resultat; behåll mänsklig granskning för avgörande beslut. Oskärpa eller beskärning kan minska exponering men kan också ta bort bevis. En hög laboratoriescore rättfärdigar inte påståenden om identitet, känsla eller avsikt utöver den validerade uppgiften.
Arbetsexempel: fotgängardetektering vid ett lagerkorsning
Kameror övervakar en begränsad fordonspassage, och modellen detekterar personer snarare än att identifiera dem. Data täcker dag och natt, väder, klädsel, ocklusion, rullstolsanvändare, kamerapositioner och tomma scener, uppdelade efter inspelningssession. Detektorn utvärderas för händelseåterkallelse, falsklarm, lokalisering, varningsfördröjning och prestanda på avstånd. Säkerhetsingenjörskonst definierar den maximalt tolererade latensen och oberoende fysiska kontroller.
Visuell varning kan bromsa ett fordon, men nödstopp och barriärer är inte beroende av den inlärda modellen. Kamerablockering, frusna ramar, nätverksförlust och modellens tidsgräns ger explicita fel. Råvideolagring minimeras och åtkomst loggas. Övervakning spårar sensors hälsa, varningsfrekvens, granskade incidenter och nära missar per förhållande. Varje omplacering av kamera eller layoutändring utlöser en omvalidering eftersom uppenbar bildlikhet inte garanterar samma geometri eller risk.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftsmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig fel. Etablera en reproducerbar grundlinje och ett versionerat utvärderingsset innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskift, beroendeavbrott, missbruk och de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela myndighet för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker reserv och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata kvalitet, utdata beteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla onödig känslig data. Definiera varningströsklar och en ansvarig för respons, granska sedan verkliga bevis efter implementering snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver också dokumenterad återställning, incidentlärande, raderings‑ och lagringsprocedurer samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Är datorseende detsamma som bildigenkänning?
Nej. Bildigenkänning avser vanligtvis klassificering eller identifiering. Datorseende inkluderar också lokalisering, segmentering, mätning, spårning, rekonstruktion, generering och resonemang kring visuell information.
Ser ett visionssystem som en människa?
Nej. En modell bearbetar numeriska indata enligt sin arkitektur och träningsmål. Den kan överträffa människor på ett smalt benchmark men misslyckas vid små förändringar som en person hanterar enkelt.
Primära referenser












