AI-modeller och plattformar
Vad är Moores lag, och hur påverkar den AI?

 Lägg till Unite.AI bland dina föredragna källor på Google
Moores lag är den historiska observationen att ekonomiskt användbara integrerade kretsar tenderade att öka antalet komponenter i en exponentiell takt. Det är ingen fysiklag och säger inte att datorer automatiskt blir dubbelt så snabba enligt ett fast schema.
För AI är transistordensitet viktig eftersom den möjliggör fler aritmetiska enheter, minne och interconnects. Men den praktiska utvecklingen beror också på arkitektur, numerisk precision, förpackning, minnesbandbredd, algoritmer, mjukvara, energi, tillverkningsutbyte och mängden användbar data.
Viktiga slutsatser
- Moores ursprungliga artikel från 1965 beskrev en ekonomisk och ingenjörsmässig trend, inte en fysisk garanti.
- Skalning av klockfrekvensen har avtagit; moderna förbättringar kommer i allt högre grad från parallellism och specialiserade acceleratorer.
- AI‑prestanda begränsas ofta av minnesförflyttning och energi, inte bara aritmetik.
- Jämför system med latens, genomströmning, kvalitet, energiförbrukning och total kostnad på arbetsbelastningsnivå – inte med transistorantal.
Vad Moore faktiskt observerade
Gordon Moore ritade antalet komponenter i ledande integrerade kretsar och förutsåg fortsatt snabb tillväxt med minimal kostnad per komponent. Tidsintervallet sammanfattades senare ofta som en fördubbling ungefär varannan år, men formuleringar och mätta storheter har varierat.
Mindre strukturer kan öka densiteten och minska vissa växlingskostnader, men tillverkningskomplexitet och ekonomi avgör om trenden förblir användbar. Nodnamn är marknadsföringsetiketter och bör därför inte behandlas som en direkt fysisk jämförelse mellan olika tillverkningsprocesser.
Från snabbare kärnor till heterogen beräkning
Spänningstskalning i Dennard‑stil möjliggjorde en gång högre klockfrekvenser utan proportionell effektökning, men den relationen försvagades. Designerna övergick till flerkärniga CPU:er, GPU:er, tensorenheter, chiplets, avancerad förpackning och domänspecifika acceleratorer.
Denna heterogenitet är central för djupinlärning. Tät matrisberäkning kan köras effektivt på parallell hårdvara, medan CPU:er samordnar oregelbunden logik och datarörelser. Den snabbaste komponenten hjälper inte om pipeline inte kan hålla den försörjd.
Minne, precision och algoritmer
Träning och inferens flyttar upprepade gånger vikter, aktiveringar och cachedata genom en hierarki av minne på chipet och utanför chipet. Bandbredd, kapacitet, lokalkänsla och kommunikation kan dominera kostnaden. Lägre numerisk precision och kvantisering minskar förflyttning när kvaliteten förblir acceptabel.
Algoritmiska förbättringar kan minska den beräkning som krävs för att nå ett målresultat. Glesa modeller, transformer-effektivitetsmetoder, bättre optimerare och data av högre kvalitet påverkar alla den faktiska framsteg som användarna upplever.
Hur man jämför AI‑hårdvara
Toppantal operationer per sekund är teoretiska. Använd en representativ modell, batch‑storlek, sekvenslängd, precision, mjukvarustack och kvalitetsgräns. Rapportera end‑to‑end‑latens, genomströmning, energi, minnesavtryck, utnyttjandegrad och kostnad.
Edge‑system kan värdera integritet och låg effekt mer än maximal genomströmning; datacenter kan prioritera totala token eller prover per watt. Edge AI visar tydligt varför ett enda rubriknummer inte kan beskriva alla användbara system.
Varför halvledarskalning förändrades
Tidigt framsteg inom integrerade kretsar kombinerade mindre enheter, bättre tillverkning, lägre kostnad per komponent och designförbättringar. I flera år stödde minskade transistordimensioner också snabbare växling och lägre energi per operation. Så småningom försvagade läckage, spänningsgränser, värmetäthet, interconnect‑fördröjning och tillverkningskostnad den enkla relationen mellan en ny processnod och snabbare allmänna kärnor.
Modern utveckling är därför multidimensionell. FinFET‑ och gate‑all‑around‑enheter förbättrar elektrostatiskt kontroll; extrem‑ultraviolett litografi möjliggör mindre mönster; chiplets låter designerna kombinera die‑er tillverkade med olika processer; avancerad förpackning placerar beräkning och minne närmare varandra. Utbyte och förpackning avgör om en tekniskt imponerande design är ekonomisk i volym.
Avmattningen av en skalningsmekanism betyder inte att hårdvaran slutade förbättras. Det innebär att arkitekterna måste använda transistorer mer medvetet. Specialiserade enheter byter flexibilitet mot genomströmning eller effektivitet för utvalda arbetsbelastningar, medan större cacheminnen och interconnects försöker hålla dessa enheter försedda.
Hur AI‑arbetsbelastningar belastar hårdvara
Träning växlar mellan framåtriktad beräkning, bakåtriktad spridning, optimeraruppdateringar och kommunikation mellan acceleratorer. Inferens sträcker sig från batch‑betygning till interaktiv token‑generering. Matris‑multiplikation är viktig, men inbäddningar, normalisering, aktiveringsfunktioner, attention, routing, cache‑åtkomst och värd‑orkestrering bidrar alla till den faktiska prestandan.
Aritmetisk intensitet – mängden beräkning per flyttad byte – hjälper att förklara om en arbetsbelastning är beräknings‑ eller bandbreddsbegränsad. Små batch‑storlekar och autoregressiv avkodning lämnar ofta aritmetiska enheter underutnyttjade eftersom vikter eller cache‑data måste hämtas upprepade gånger. Större batch‑storlekar förbättrar utnyttjandet men ökar latens och minnesbehov.
Numeriskt format förändrar avvägningen. FP32, BF16, FP16, FP8 och heltalsformat skiljer sig åt i intervall, precision, hårdvarustöd och fel. Träning med blandad precision bevarar känsliga operationer i högre precision; kvantiserad inferens kräver kalibrering och kvalitetstestning snarare än ett löfte om att varje modell tolererar samma bitbredd.
Systemekonomi och framtida riktningar
Den totala AI‑kostnaden inkluderar inköp eller hyra av acceleratorer, strömförsörjning, kylning, nätverk, lagring, mjukvaruutveckling, overksam kapacitet och misslyckade experiment. En snabbare chip kan bli dyrare totalt om utnyttjandet är lågt eller om modellen kräver en dyr distribuerad topologi. Mät användbart resultat vid en definierad kvalitetsgräns.
Skalning begränsas också av data och algoritmer. Mer beräkningskraft kan inte reparera felmärkta data eller en utvärdering som belönar genvägar. Effektiv attention, bättre optimerare, gleshet, återhämtning, destillation och algoritmiska upptäckter kan förbättra resultat utan en proportionell hårdvaruökning, även om de kan flytta kostnaderna någon annanstans.
Framtida system kommer att kombinera processförbättringar med tredimensionell stapling, högbandbreddsminne, optiska eller avancerade elektriska interconnects, domänspecifik dataflöde och samdesignad mjukvara. Moores lag är fortfarande ett värdefullt historiskt sammanhang, men planering bör baseras på uppmätta arbetsbelastningskurvor samt realistiska leverans-, energ- och implementeringsbegränsningar.
Att läsa Moores lag korrekt i en AI‑systemdesign
En användbar analys separerar transistordensitet, allmän CPU‑prestanda, accelerator‑genomströmning, minneskapacitet, minnesbandbredd, interconnect, energi, tillverkningsutbyte och kostnad. Dessa förbättras inte i samma takt. En AI‑arbetsbelastning som domineras av förflyttning av modellvikter kan få liten nytta av fler aritmetiska enheter, medan en liten on‑chip‑modell kan dra stor nytta av specialiserad låg‑precision‑hårdvara. Ange exakt metrik, precision, arbetsbelastning och effektomfång istället för att behandla en processnod som prestanda.
Skalning av en AI‑modell förändrar också mjukvaru‑ och systemkrav. Större träningskörningar kräver parallella algoritmer, pålitlig checkpoint‑hantering, hög hastighets‑nätverk, lagrings‑pipelines och tillräckligt med data för att utnyttja den ökade kapaciteten. Vid inferens beror latensen på prompt‑längd, genererade token, batchning, cacheminne och servicenivåmål. Algoritmiska förbättringar, gleshet, kvantisering, återhämtning och bättre data kan ge vinster som är oberoende av transistortrender och ibland överstiger en hårdvarugeneration.
För planering, benchmarka representativa modeller på potentiella system och modellera total kostnad över systemets livslängd: anskaffnings‑ eller molnpris, energi, kylning, utnyttjande, ingenjörsarbete, migration och leveransrisk. Använd scenarier snarare än en enda exponentiell prognos. Moores lag är fortfarande en värdefull historisk observation om integrations‑ekonomi, men den garanterar inte att AI blir proportionellt snabbare, billigare, mer kapabelt eller mer hållbart enligt ett fast schema.
Praktisk implementeringschecklista
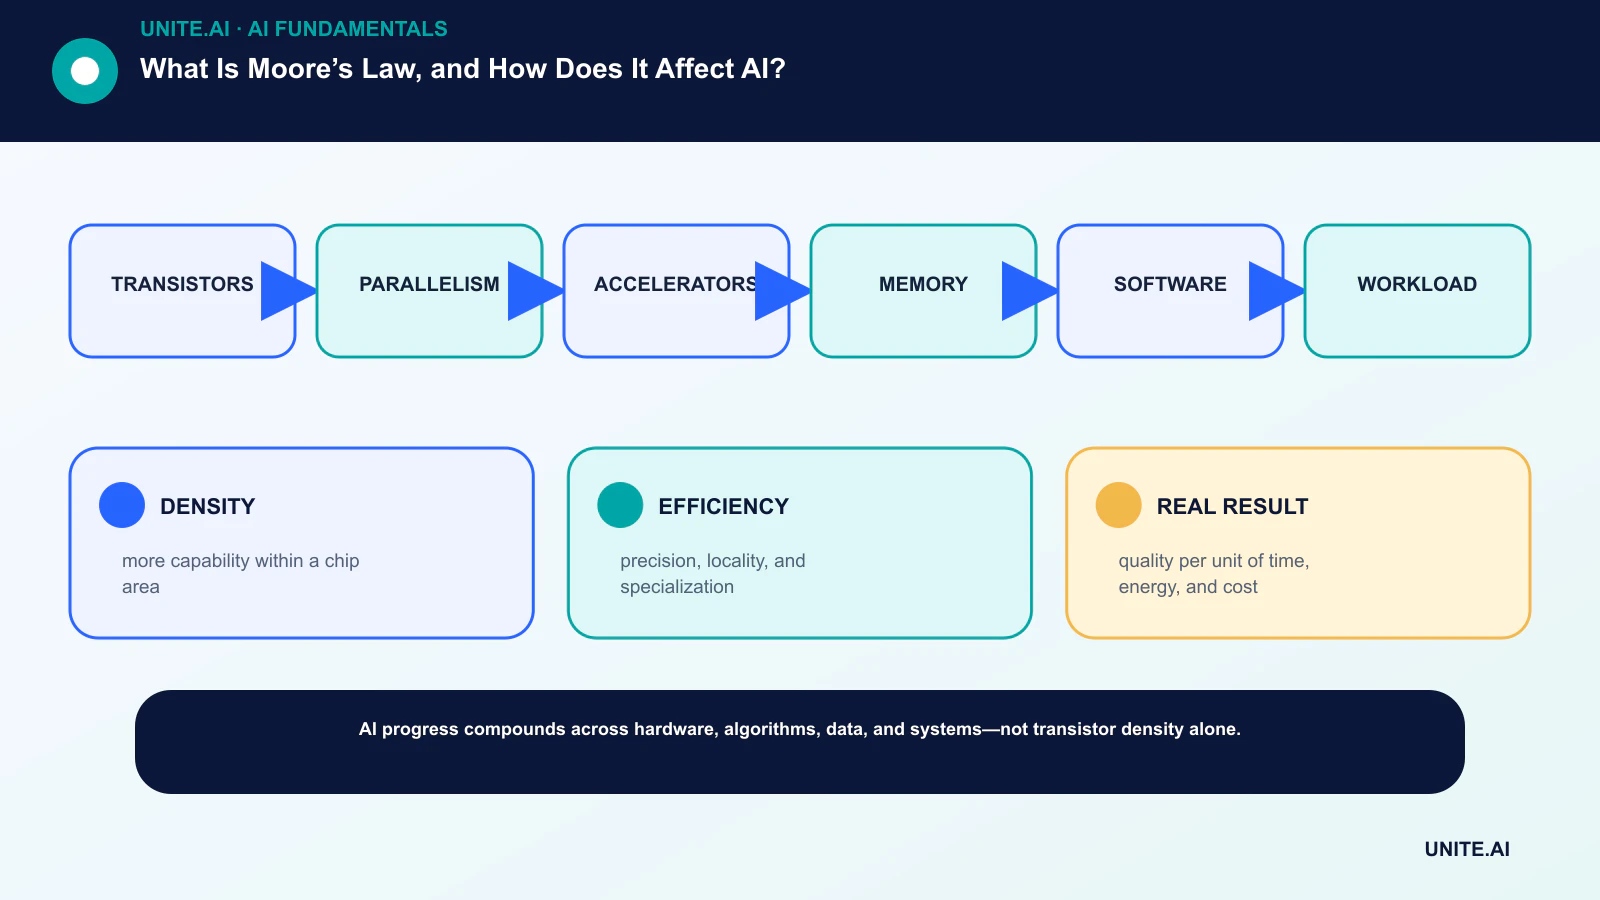
Omvandla konceptet till ett avgränsat, testbart arbetsflöde: transistorer → parallellism → acceleratorer → minne → mjukvara → arbetsbelastning. Utse en ansvarig ägare, dokumentera data och beroenden, etablera en enkel baslinje, sätt godkännande‑ och stoppkriterier, testa representativa fel och definiera övervakning, återställning och granskning innan omfattningen utökas. Registrera versioner och antaganden så att ett annat team kan reproducera resultatet och förstå vad som förändrats.
Innan lansering, genomför en dokumenterad beredskapsgranskning med de som bygger, driver, säkrar och påverkas av systemet. Testa normala fall, gränsvillkor, beroendefel och missbruk; bevara bevisen och olösta risker. Definiera vem som kan godkänna en release, ändra ett tröskelvärde, åsidosätta ett resultat eller stoppa driften. Ompröva beslutet när verkliga data kommer, eftersom ett tekniskt framgångsrikt pilotprojekt inte garanterar pålitlig prestanda i större skala.
- DENSITET: mer kapacitet inom ett chip‑område.
- EFFICIENS: precision, lokalkänsla och specialisering.
- VERKLIGT RESULTAT: kvalitet per tidsenhet, energi och kostnad.
Vanliga frågor
Är Moores lag slut?
Den enkla historiska trenden har avtagit och förändrat karaktär, men halvledarutvecklingen fortsätter via enheter, arkitektur, förpackning, minne och mjukvara. Om uttrycket fortfarande är lämpligt beror på vilken metrik som används.
Betyder dubbelt så många transistorer dubbelt AI‑prestanda?
Nej. Prestanda beror på hur transistorer används samt på bandbredd, precision, modellstruktur, mjukvarueffektivitet, effekt och arbetsbelastningsbegränsningar.
Primära referenser