
Grunderna i AI
Vad är mekanistisk tolkbarhet? Hur forskare analyserar AI-modeller

 Lägg till Unite.AI bland dina föredragna källor på Google
Mekaniskt tolkbarhet studerar hur inlärda komponenter i ett neuralt nätverk kausalt genererar beteende. Istället för att endast korrelera indata med utdata bildar forskare hypoteser om funktioner, uppmärksamhetshuvuden, neuroner och kretsar och ingriper för att testa dessa hypoteser.
Fältet har levererat detaljerade förklaringar för utvalda beteenden i små och medelstora modeller, men en komplett, trogen redogörelse för en frontlinjemodell är fortfarande oåtkomlig. Automatiserade förklaringar och tilltalande visualiseringar kan vara användbara utgångspunkter, men är inte bevis.
Viktiga slutsatser
- Funktioner är representerade mönster; kretsar är interagerande komponenter som föreslås implementera en beräkning.
- Aktiverings‑patchning, ablation och kausal spårning testar om en komponent förändrar ett beteende.
- Superposition innebär att en neuron kan delta i många funktioner; sparsa autoenkodare försöker en annan funktionsbas.
- Tolkbarhetsmetoder kräver sanningsgrund, falsifierbara tester, täckning och utvärdering mot alternativa förklaringar.
Från representation till mekanism
Undersökning frågar om information kan avkodas från en aktivering. Attribution uppskattar vilka indata eller komponenter som är betydelsefulla. Mekanistiskt arbete går längre genom att föreslå en intern beräkning och kontrollera om interventioner förändrar det förväntade mellansteg‑ och slutbeteendet.
Det gör det relaterat till men snävare än förklarlig AI. En efterhandsförklaring för ett beslut är inte nödvändigtvis en omvänd‑konstruerad algoritm i modellen.
Kretsar och kausala interventioner
Forskare kan identifiera ett uppmärksamhetshuvud eller en funktion kopplad till en uppgift, avlägsna det, patcha aktiveringar från en annan körning eller spåra hur information rör sig över lager. En bra hypotes förutsäger beteende på nya exempel och klarar kontroller.
Interventioner kan skapa tillstånd utanför distributionen, så en beteendeförändring avslöjar inte automatiskt den naturliga beräkningen. Använd flera metoder, matchade kontroller och kvantitativa effekter istället för ett enstaka illustrativt prompt.
Superposition och sparsa funktioner
Neurala nätverk kan representera fler funktioner än enskilda dimensioner genom att superimponera dem. En neuron kan därför aktiveras för flera orelaterade mönster, vilket gör neuron‑nivå‑etiketter missvisande.
Sparsa autoenkodare lär sig ett större ordförråd av funktioner från modellens aktiveringar. De kan göra mönster mer separerbara, men den valda sparsamheten, träningsdata, återkonstrueringsfel och automatiserade etiketter påverkar vad som återfås. Neurala‑nätverk-funktioner kräver fortfarande kausal validering.
Säkerhet, felsökning och begränsningar
Mekaniskt verktyg kan hjälpa att hitta memorerade fakta, bias, vilseledande strategier eller felkretsar och kan stödja redigering eller övervakning. Samma verktyg kan missa distribuerade, sällsynta eller kontextberoende beräkningar.
Behandla fynd som avgränsad evidens: modellversion, uppgift, dataset, lager, intervention, effekt och osäkerhet. Koppla tolkning till beteendeutvärderingar, red‑teamning och ansvarsfull‑AI-styrning snarare än att använda den som ett generellt säkerhetscertifikat.
Representationer, kretsar och kausal evidens
Mekaniskt tolkbarhet studerar hur interna beräkningar genererar modellens beteende. Forskare granskar aktiveringar, vikter, uppmärksamhet och mellanfunktioner och bildar hypoteser om representationer och kretsar. En representation lagras inte nödvändigtvis i en enda neuron; den kan vara fördelad över riktningar, lager, token och kontextberoende kombinationer.
Sparsa autoenkodare försöker dekomponera täta aktiveringar till en större uppsättning funktioner som aktiveras selektivt. Funktionsetiketter är mänskliga tolkningar av observerade exempel, inte sanningsgrund. Återkonstrueringsfel, sparsamhet, funktionsdelning, absorption och döda funktioner påverkar vad dekompositionen avslöjar och vad den missar.
Korrelation är otillräcklig för ett mekanistiskt påstående. Aktiverings‑patchning, ablation, kausal spårning, styrning och riktade viktinterventioner testar om en komponent förändrar beteendet enligt förutsägelse. Interventioner kan också skapa tillstånd utanför distributionen, så resultat kräver kontroller, dos‑respons‑analys, alternativa förklaringar och replikation över promptar och modeller.
Ett rigoröst tolkbarhetsarbetsflöde
Börja med ett exakt mätt beteende och ett dataset som skiljer konkurrerande hypoteser. Lokalisera relevanta lager, positioner, komponenter eller funktioner; granska kandidatmekanismer; ingripa; och testa om den föreslagna kretsen förutsäger nya fall. Håll utforskande exempel separata från bekräftande utvärdering för att minska urvalsbias.
Automatiserade verktyg kan rangordna neuroner, funktioner, huvuden eller vägar, medan språkmodeller kan föreslå beskrivningar. Automation ökar täckning men kan konstruera plausibla berättelser. Betygsätt förklaringar på håll‑ut‑aktiverings‑exempel och kausala förutsägelser, registrera osäkerhet och gör artefakter reproducerbara med modellversion, tokeniserare, promptar och kod.
Mekanismer kan vara polysemantiska, redundanta, icke‑linjära och distribuerade. Att ta bort en komponent kan kompenseras av andra, medan en funktion kan delta i flera beteenden. Negativa fynd är informativa: en uppenbar krets som misslyckas utanför kuraterade exempel bör begränsas eller förkastas snarare än räddas med en alltmer vag förklaring.
Tillämpningar, begränsningar och säkerhetspåståenden
Tolkbarhet kan hjälpa att felsöka hallucinationer, bias, memorering, jailbreak‑beteende eller oväntad generalisering; jämföra modeller; och generera vetenskapliga hypoteser. Den kan också identifiera funktioner för övervakning eller intervention. Dessa användningar kräver uppgifts‑specifik validering eftersom en användbar forskningsvisualisering inte automatiskt är en pålitlig produktionskontroll.
Avsaknad av en upptäckt funktion bevisar inte avsaknad av en förmåga eller avsikt, och en läsbar funktion bevisar inte att modellen använder den i ett givet svar. Verktyg observerar en projektion av beräkningen med begränsad täckning. Säkerhetspåståenden måste specificera detekteringskänslighet, falska positiva, distribution, motståndare och kända blinda fläckar.
Använd tolkbarhet tillsammans med beteendeutvärderingar, red‑teamning, datastyrning, åtkomstkontroller, övervakning och incidentrespons. Publicera metoder och motexempel när det är möjligt. Fältet utvecklas snabbt, men nuvarande tekniker ger ingen komplett, trogen förklaring av frontlinjemodells resonemang eller någon generell garanti för anpassning.
Arbetsexempel: testa en föreslagen modellkrets
Anta att en modell verkar använda ett antal uppmärksamhetshuvuden och funktioner för att lösa ett indirekt objekt i en mening. Forskare definierar ett kontrollerat dataset med varierande namn, positioner, distraktioner och motexempel och mäter sedan beteendet. Aktiveringsgranskning identifierar kandidatkomponenter, men hypotesen skrivs innan intervention: vilken information varje komponent bär, var den rör sig och hur en förändring ska påverka utdata.
Aktiverings‑patchning och ablation testar nödvändighet och tillräcklighet över håll‑ut‑exempel. En riktad redigering som förändrar den förutsagda tokenen i förväntad riktning stödjer mekanismen; bred prestandaskada gör det inte. Kontroller patchar orelaterade positioner och komponenter, varierar interventionsstorlek och jämför alternativa kretsar. Teamet publicerar negativa fall där förklaringen misslyckas och undviker att tillskriva ett mänskligt läsbart syfte enbart baserat på korrelation.
För att påstå en säkerhetstillämpning måste metoden upptäcka det relevanta beteendet med känd känslighet under realistiska promptar och motståndaranpassning. Funktionsmonitorer utvärderas för falska positiva, undvikande, modelluppdateringar och kausal relevans. Tolkbarhetsbevis kan vägleda felsökning och ytterligare tester, men verkställighet förblir i externa kontroller och beteendeövervakning. Ett övertygande kretsdiagram är en vetenskaplig hypotes med bevis — inte en komplett förklaring av en modell eller en garanti för osedd beteende.
Praktisk implementeringschecklista
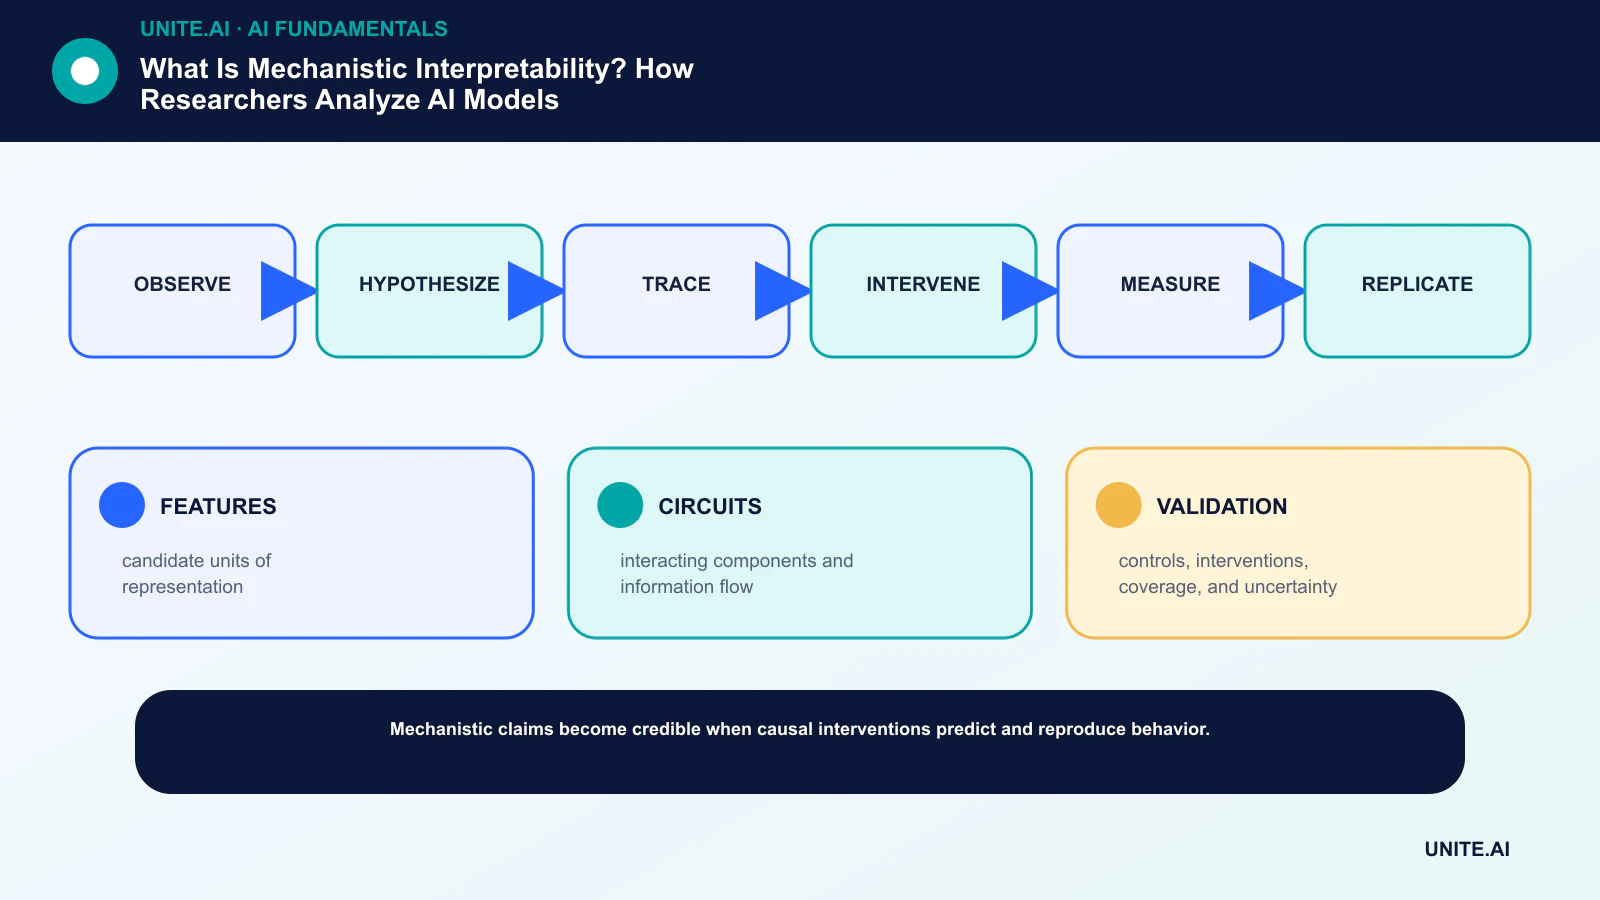
Omvandla konceptet till ett avgränsat, testbart arbetsflöde: observera → hypothisera → spåra → ingripa → mäta → replikera. Ange en ansvarig ägare, dokumentera data och beroenden, etablera en enkel baslinje, sätt godkännande‑ och stoppkriterier, testa representativa fel och definiera övervakning, återgång och granskning innan omfattningen utökas. Registrera versioner och antaganden så att ett annat team kan reproducera resultatet och förstå vad som förändrats.
Före lansering, genomför en dokumenterad beredskapsgranskning med de personer som bygger, driver, säkrar och påverkas av systemet. Testa normala fall, randvillkor, beroendefel och missbruk; bevara bevisen och olösta risker. Definiera vem som kan godkänna releasen, ändra ett tröskelvärde, åsidosätta en utdata eller stoppa driften. Gå tillbaka till beslutet när verkliga data anländer, eftersom ett tekniskt framgångsrikt pilotprojekt inte garanterar pålitlig prestanda i större skala.
- FUNKTIONER: kandidat‑enheter för representation.
- KRETSAR: interagerande komponenter och informationsflöde.
- VALIDERING: kontroller, interventioner, täckning och osäkerhet.
Vanliga frågor
Är mekanistisk tolkbarhet detsamma som att läsa modellvikter?
Nej. Råa vikter är inte självförklarande. Forskare analyserar aktiveringar, funktioner, komponenter och interventioner för att bygga och testa kausala hypoteser.
Kan sparsa autoenkodare helt förklara en LLM?
Nej. De erbjuder en kandidat‑funktionsbas och kan stödja kretsanalys, men täckning, trohet, återkonstruering, märkning och skalbarhet är fortfarande öppna problem.
Primära referenser












