
Andersons vinkel
En anmärkningsvärd framsteg inom människo-styrd AI-video

 Lägg till Unite.AI bland dina föredragna källor på Google
Notera: Projektets sidor för detta arbete innehåller 33 autospelande högupplösta videor som sammanlagt är en halv gigabyte, vilket destabiliserade mitt system när jag laddade dem. Av den anledningen kommer jag inte att länka direkt till dem. Läsarna kan hitta URL:en i abstracten eller PDF:en om de vill.
En av de primära målen inom nuvarande videosyntesforskning är att generera en fullständig AI-styrd videoprestation från en enda bild. I veckan publicerades en ny artikel från Bytedance Intelligent Creation som kan vara den mest omfattande systemet av detta slag hittills, kapabelt att producera full- och halvkroppsanimationer som kombinerar uttrycksfulla ansiktsdetaljer med exakta storskaliga rörelser, samtidigt som den uppnår förbättrad identitetskonsekvens – ett område där även ledande kommersiella system ofta brister.
I exemplet nedan ser vi en prestation som drivs av en skådespelare (överst till vänster) och som härrör från en enda bild (överst till höger), som ger en anmärkningsvärt flexibel och smidig rendering, utan de vanliga problemen med att skapa stora rörelser eller “gissa” om dolda områden (dvs. delar av kläder och ansiktsvinklar som måste antas eller uppfinnas eftersom de inte är synliga i den enda källbilden):
LJUDINNEHÅLL. Klicka för att spela. En prestation föds ur två källor, inklusive lip-sync, som vanligtvis är dedikerade tilläggsmoduler. Detta är en reducerad version från källsidan (se noten i början av artikeln – gäller alla andra inbäddade videor här).
Även om vi kan se några kvarstående utmaningar när det gäller att behålla identitet när varje klipp fortskrider, är detta det första system jag har sett som generellt (även om inte alltid) behåller ID under en längre period utan att använda LoRAs:
LJUDINNEHÅLL. Klicka för att spela. Ytterligare exempel från DreamActor-projektet.
Det nya systemet, med titeln DreamActor, använder ett treskiktat hybridkontrollsystem som ger särskild uppmärksamhet åt ansiktsuttryck, huvudrotation och kärnskelettdesign, vilket möjliggör AI-styrda prestationer där varken ansikts- eller kroppsdelen lider på bekostnad av den andra – en sällsynt, möjligen okänd förmåga bland liknande system.
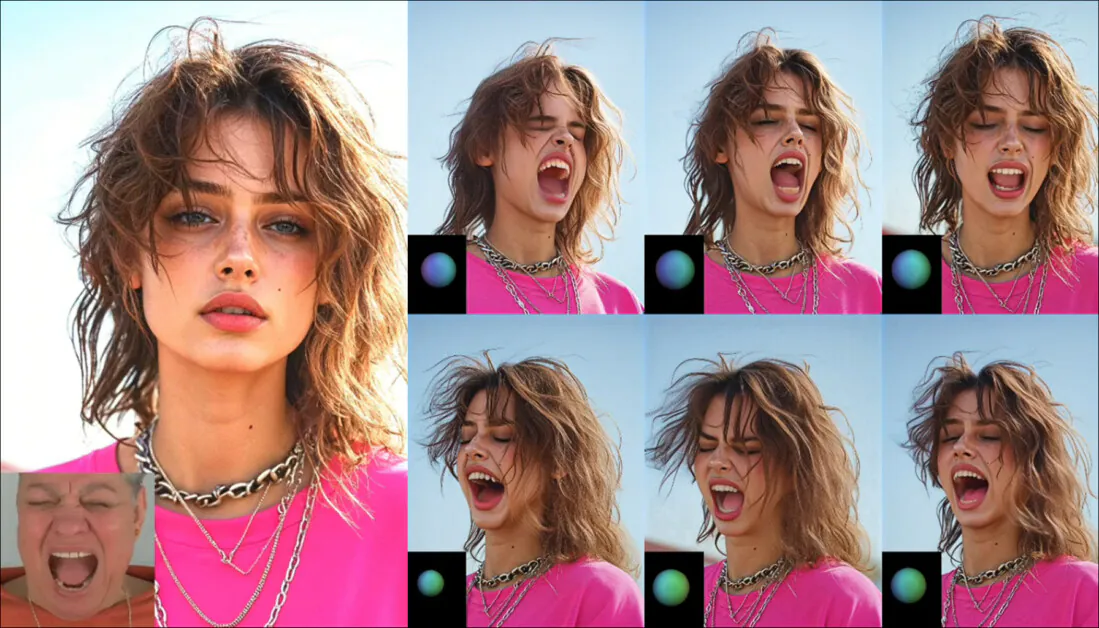
Längre ner ser vi en av dessa aspekter, huvudrotation, i aktion. Den färgade bollen i hörnet av varje miniatyrbild till höger indikerar en slags virtuell gimbal som definierar huvudorientering oberoende av ansiktsrörelse och uttryck, som här drivs av en skådespelare (nedre vänster).
Klicka för att spela. Den färgade bollen som visualiseras här representerar rotationsaxeln för avatarhuvudet, medan uttrycket drivs av en separat modul och informeras av en skådespelares prestation (synlig här nedre vänster).
En av projektets mest intressanta funktioner, som inte ens ingår ordentligt i papperets tester, är dess förmåga att hämta lip-sync-rörelse direkt från ljud – en förmåga som fungerar ovanligt bra även utan en drivande skådespelare-video.
Forskarna har tagit på sig de bästa etablerade systemen i detta företag, inklusive det mycket berömda Runway Act-One och LivePortrait, och rapporterar att DreamActor kunde uppnå bättre kvantitativa resultat.
Eftersom forskare kan ställa in sina egna kriterier är kvantitativa resultat inte nödvändigtvis en empirisk standard; men de tillhörande kvalitativa testerna verkar stödja författarnas slutsatser.
Tyvärr är detta system inte avsett för allmän utgivning, och den enda värde som samhället kan potentiellt hämta från arbetet är i att potentiellt reproducera metoderna som beskrivs i artikeln (såsom det gjordes med stor effekt för den lika stängda Google Dreambooth 2022 ).
Artikeln säger*:
‘Människo-bildanimation har möjliga sociala risker, som att missbrukas för att skapa falska videor. Den föreslagna tekniken kunde användas för att skapa falska videor av människor, men befintliga upptäcktsverktyg [Demamba, Dormant] kan upptäcka dessa falska videor.
‘För att minska dessa risker är tydliga etiska regler och ansvarsfulla användningsriktlinjer nödvändiga. Vi kommer att strikt begränsa tillgång till våra kärnmodeller och koder för att förhindra missbruk.’
Naturligtvis är etiska överväganden av detta slag bekväma ur ett kommersiellt perspektiv, eftersom det ger en motivering för API-endast-åtkomst till modellen, som sedan kan kommersialiseras. ByteDance har redan gjort detta en gång 2025, genom att göra den mycket berömda OmniHuman tillgänglig för betalda poäng på Dreamina-webbplatsen. Därför, eftersom DreamActor möjligen är en ännu starkare produkt, verkar detta vara det sannolika resultatet. Vad som återstår att se är i vilken utsträckning dess principer, så långt de förklaras i artikeln, kan hjälpa den öppna källkodsgemenskapen.
Den nya artikeln heter DreamActor-M1: Holistisk, Uttrycksfull och Robust Människo-Bildanimation med Hybridstyrning, och kommer från sex Bytedance-forskare.
Metod
DreamActor-systemet som föreslås i artikeln syftar till att generera människoanimation från en referensbild och en drivande video, med hjälp av en Diffusion Transformer (DiT) ramverk anpassat för latent utrymme (tycks vara någon smak av Stable Diffusion, även om artikeln endast citerar 2022 års landmärkepublikation).
I stället för att förlita sig på externa moduler för att hantera referensbetingning, kombinerar författarna utseende- och rörelsefunktioner direkt inuti DiT-ryggraden, vilket möjliggör interaktion över tid och rum genom uppmärksamhet:

Schema för det nya systemet: DreamActor kodar pose, ansiktsrörelse och utseende i separata latenter, kombinerar dem med brusiga videolatenter producerade av en 3D VAE. Dessa signaler kombineras inom en Diffusion Transformer med hjälp av själv- och korsuppmärksamhet, med delade vikter över grenar. Modellen övervakas genom att jämföra avbrusade utdata med rena videolatenter. Källa: https://arxiv.org/pdf/2504.01724
För att göra detta använder modellen en förtränad 3D variational autoencoder för att koda både indata-videon och referensbilden. Dessa latenter patchificeras, konkateneras och matas in i DiT, som bearbetar dem gemensamt.
Denna arkitektur avviker från den vanliga metoden att fästa en sekundär nätverk för referensinjektion, som var tillvägagångssättet för de inflytelserika Animate Anyone och Animate Anyone 2 projekt.
I stället bygger DreamActor fusionen in i huvudmodellen själv, vilket förenklar designen samtidigt som det förbättrar informationsflödet mellan utseende- och rörelsekoder. Modellen tränas sedan med hjälp av flödesmatchning snarare än den standardmässiga diffusionssyftet (Flödesmatchning tränar diffusionmodeller genom att direkt förutsäga hastighetsfält mellan data och brus, och hoppar över score-estimering).
Hybrid Rörelsestyrning
Hybrid Rörelsestyrningsmetoden som informerar de neurala renderingarna kombinerar pose-tokens som härrör från 3D-kroppskelett och huvudskelett; implicita ansiktsrepresentationer extraherade av en förtränad ansiktskodare; och referensutseenderepresentationer som sampas från källbilden.
Dessa element kombineras inom Diffusion Transformer med hjälp av olika uppmärksamhetsmekanismer, vilket möjliggör för systemet att koordinera global rörelse, ansiktsuttryck och visuell identitet under genereringsprocessen.
För det första av dessa, i stället för att förlita sig på ansiktslandmärken, använder DreamActor implicita ansiktsrepresentationer för att styra uttrycksgenerering, vilket tycks möjliggöra en finare kontroll över ansiktsdynamik samtidigt som det frikopplar identitet och huvudpose från uttryck.
För att skapa dessa representationer, bearbetar pipelinen först ansiktsområdet i varje ram av den drivande videon, återstorar det till 224×224 och bearbetar de beskurna ansiktena med en ansiktsrörelsekodare som är förtränad på PD-FGC datamängden, som sedan villkorsstyrs av en MLP lager.

PD-FGC, som används i DreamActor, genererar en talarhuvud från en referensbild med frikopplad kontroll av lip-sync (från ljud), huvudpose, ögonrörelse och uttryck (från separata videor), vilket möjliggör exakt, oberoende manipulation av var och en. Källa: https://arxiv.org/pdf/2211.14506
Resultatet är en sekvens av ansiktsrörelsetoken, som injiceras i Diffusion Transformer genom en korsuppmärksamhetslager.
Samma ramverk stöder också en ljud-styrd variant, där en separat kodare tränas som kartar talinmatning direkt till ansiktsrörelsetoken. Detta möjliggör generering av synkroniserad ansiktsanimation – inklusive läpprörelser – utan en drivande video.
LJUDINNEHÅLL. Klicka för att spela. Lip-sync hämtad direkt från ljud, utan en drivande skådespelare-video. Den enda karaktärinmatningen är den statiska bilden som syns övre höger.
Andra, för att kontrollera huvudpose oberoende av ansiktsuttryck, introducerar systemet en 3D-huvudskelettrepresentation (se video som är inbäddad tidigare i denna artikel), som frikopplar ansiktsdynamik från global huvudrörelse, vilket förbättrar precision och flexibilitet under animation.
Huvudskelett genereras genom att extrahera 3D-ansiktsparametrar – såsom rotation och kameraposition – från den drivande videon med hjälp av FaceVerse spårningsmetoden.

Schema för FaceVerse-projektet. Källa: https://www.liuyebin.com/faceverse/faceverse.html
Dessa parametrar används för att rendera en färgsfär som projiceras på 2D-bildplanet, rumsligt justerad med den drivande huvudet. Färgsfärens storlek matchar referenshuvudet, och dess färg återspeglar huvudets orientering. Denna abstraktion minskar komplexiteten i att lära 3D-huvudrörelse, vilket hjälper till att bevara stiliserade eller överdrivna huvudformer i tecknade figurer.

Visualisering av kontrollsfären som påverkar huvudorientering.
Slutligen, för att styra fullkropps-rörelse, använder systemet 3D-kroppskelett med adaptiv benlängdsnormalisering. Kropps- och handparametrar uppskattas med hjälp av 4DHumans och den handfokuserade HaMeR, som båda opererar på SMPL-X kroppmodellen.

SMPL-X applicerar en parametrisk mesh på hela kroppen i en bild, justerad med uppskattad pose och uttryck för att möjliggöra pose-medveten manipulation med hjälp av meshen som en volymetrisk guide. Källa: https://arxiv.org/pdf/1904.05866
Från dessa utdata väljs nyckel-leder ut, projiceras till 2D och kopplas till linjebaserade skelett-kartor. Till skillnad från metoder som Champ, som renderar fullkropps-mesh, undviker detta tillvägagångssätt att påtvinga fördefinierade form-prioriteter, och genom att förlita sig enbart på skelett-struktur, uppmuntras modellen att härleda kroppsform och utseende direkt från referensbilderna, vilket minskar partiskhet mot fasta kroppstyper och förbättrar generalisering över en rad poser och kroppsbyggnader.
Under träning kombineras 3D-kroppskelett med huvudskelett och skickas genom en pose-kodare, som producerar funktioner som sedan kombineras med brusiga videolatenter för att producera brus-token som används av Diffusion Transformer.
Vid inferens tar systemet hänsyn till skelett-skillnader mellan ämnen genom att normalisera benlängder. Den SeedEdit förtränade bild-redigeringsmodellen omvandlar både referens- och drivande bilder till en standard kanonisk konfiguration. RTMPose används sedan för att extrahera skelett-proportioner, som används för att justera den drivande skelettet för att matcha anatomin hos referens-ämnet.

Översikt av inferens-pipelinen. Pseudo-referenser kan genereras för att berika utseende-koder, medan hybrid-kontrollsignaler – implicit ansiktsrörelse och explicit pose från huvudskelett och kroppsskelett – extraheras från den drivande videon. Dessa matas sedan in i en DiT-modell för att producera animerad utdata, med ansiktsrörelse frikopplad från kroppspose, vilket möjliggör användning av ljud som drivare.
Utseende-styrning
För att förbättra utseende-trogenhet, särskilt i dolda eller sällan synliga områden, kompletterar systemet den primära referensbilden med pseudo-referenser sampade från indata-videon.
Klicka för att spela . Systemet förutser behovet av att återge dolda områden exakt och konsekvent. Detta är så nära en CGI-stil bitmap-textur-approach som jag har sett i ett projekt av detta slag.
Dessa ytterligare ramar väljs ut för pose-mångfald med hjälp av RTMPose, och filtreras med hjälp av CLIP-baserad likhet för att säkerställa att de förblir konsekventa med ämnes identitet.
Alla referens-ramar (primära och pseudo) kodas av samma visuell kodare och kombineras genom en själv-uppmärksamhetsmekanism, vilket möjliggör för modellen att komma åt kompletterande utseende-koder. Detta setup förbättrar täckning av detaljer som profilvyer eller lem-texturer. Pseudo-referenser används alltid under träning och valfritt under inferens.
Träning
DreamActor tränades i tre steg för att gradvis introducera komplexitet och förbättra stabilitet.
I det första steget användes endast 3D-kroppskelett och 3D-huvudskelett som kontrollsignaler, exklusive ansiktsrepresentationer. Detta möjliggjorde för den basala videogenereringsmodellen, initierad från MMDiT, att anpassa sig till människo-animation utan att överväldigas av fina kontroller.
I det andra steget lades implicita ansiktsrepresentationer till, men alla andra parametrar frystes. Endast ansiktsrörelse-kodaren och ansikts-uppmärksamhets-lagren tränades vid denna punkt, vilket möjliggjorde för modellen att lära sig uttrycksfulla detaljer i isolering.
I det sista steget frystes alla parametrar för gemensam optimering över utseende, pose och ansiktsdynamik.
Data och Tester
För testfasen initieras modellen från en förtränad bild-till-video DiT-checkpoint† och tränas i tre steg: 20 000 steg för var och en av de första två stegen och 30 000 steg för det tredje.
För att förbättra generalisering över olika varaktigheter och upplösningar sampas videoklipp slumpmässigt med längder mellan 25 och 121 ramar. Dessa återstoras sedan till 960x640px, med bibehållen aspekt-förhållande.
Träning utfördes på åtta (Kina-fokuserade) NVIDIA H20 GPU:er, var och en med 96GB VRAM, med AdamW optimeraren och en (acceptabelt hög) inlärningshastighet på 5e−6.
Vid inferens innehåller varje videosegment 73 ramar. För att upprätthålla konsekvens över segment återanvänds den sista latenten från ett segment som den initiala latenten för nästa segment, vilket kontextualiserar uppgiften som sekventiell bild-till-video-generering.
Klassificeringsfri styrning applicerades med en vikt på 2,5 för både referensbilder och rörelse-kontrollsignaler.
Författarna konstruerade en träningsdatamängd (ingen källa anges i artikeln) bestående av 500 timmar video från olika domäner, som innehåller exempel på (bland annat) dans, sport, film och offentliga tal. Datamängden designades för att fånga en bred spektrum av mänsklig rörelse och uttryck, med en jämn fördelning mellan fullkropps- och halvkropps-shots.
För att förbättra ansikts-syntes-kvalitet inkorporerades Nersemble i datamängdsberedningsprocessen.

Exempel från Nersemble-datamängden, som används för att förbättra datamängden för DreamActor. Källa: https://www.youtube.com/watch?v=a-OAWqBzldU
För utvärdering använde forskarna sin datamängd också som en benchmark för att bedöma generalisering över olika scenarier.
Modellens prestation mättes med standard-mått från tidigare arbete: Fréchet Inception Distance (FID); Strukturell likhetsindex (SSIM); Lärd perceptuell bild-patch-likhet (LPIPS); och Peak Signal-till-Brus-förhållande (PSNR) för ram-nivå-kvalitet. Fréchet Video Distance (FVD) användes för att bedöma tidsmässig samstämmighet och övergripande video-trogenhet.
Författarna genomförde experiment på både kroppsanimering och porträtt-animering-uppgifter, alla med en enda (mål) referensbild.
För kroppsanimering jämfördes DreamActor-M1 med Animate Anyone; Champ; MimicMotion; och DisPose.

Kvantitativa jämförelser mot rivaliserande ramverk.
Även om PDF:en tillhandahåller en statisk bild som en visuell jämförelse, kan en av videorna från projektwebbplatsen bättre belysa skillnaderna:
LJUDINNEHÅLL. Klicka för att spela. En visuell jämförelse över rivaliserande ramverk. Den drivande videon syns övre vänster, och författarnas slutsats att DreamActor producerar de bästa resultaten verkar rimlig.
För porträtt-animeringstester utvärderades modellen mot LivePortrait; X-Portrait; SkyReels-A1; och Act-One.

Kvantitativa jämförelser för porträtt-animering.
Författarna påpekar att deras metod vinner i kvantitativa tester, och hävdar att den också är överlägsen kvalitativt.
LJUDINNEHÅLL. Klicka för att spela. Exempel på porträtt-animeringsjämförelser.
Troligen är det tredje och sista av klippen som visas i videon ovan mindre övertygande lip-sync jämfört med några av de rivaliserande ramverken, även om den allmänna kvaliteten är anmärkningsvärt hög.
Slutsats
Genom att förutse behovet av texturer som antyds men inte faktiskt närvarande i den enda målbilden som driver dessa rekreationsförsök, har Bytedance hanterat en av de största utmaningarna som står inför diffusion-baserad videogenerering – konsekventa, bestående texturer. Nästa logiska steg efter att ha perfektionerat ett sådant tillvägagångssätt vore att på något sätt skapa en referens-atlas från den initiala genererade klippen som kunde appliceras på efterföljande, olika generationer, för att upprätthålla utseende utan LoRAs.
Även om ett sådant tillvägagångssätt i praktiken fortfarande skulle vara en extern referens, skiljer det sig inte från texture-mapping i traditionella CGI-tekniker, och realism- och trovärdighetskvaliteten är avsevärt högre än vad dessa äldre metoder kan uppnå.
Sagt och gjort, den mest imponerande aspekten av DreamActor är det kombinerade tre-delade styrningssystemet, som brottar den traditionella klyftan mellan ansikts-fokuserad och kroppsfokuserad människo-syntes på ett genialt sätt.
Det återstår att se om några av dessa grundläggande principer kan utnyttjas i mer tillgängliga erbjudanden; så som det är, verkar DreamActor vara dömt att bli ännu ett syntes-tjänst-erbjudande, allvarligt begränsat av restriktioner på användning, och av det praktiska problemet med att experimentera omfattande med en kommersiell arkitektur.
* Min substitution av hyperlänkar för författarna; inline-citationer
† Som nämnts tidigare, är det inte klart vilken smak av Stable Diffusion som användes i detta projekt.
Publicerad första gången fredag, 4 april 2025


