
Andersons vinkel
Utom Syns Räckvidd, Utom Minnet: Att Hantera Det Största Problemet i AI-Video

 Lägg till Unite.AI bland dina föredragna källor på Google
Viktiga punkterEtt nytt hybridminnessystem löser AI-videors kroniska minnesförlust genom att hålla…
Visa mer
- Ett nytt hybridminnessystem löser AI-videors kroniska minnesförlust genom att hålla karaktärer utanför skärmen konsekventa.
- Metoden använder minnestokenisering och dynamisk återhämtning för att bevara utseende och rörelse under avbrott.
- HyDRA överträffar tidigare metoder genom att separera dynamiska subjekt från statiska bakgrunder i latent rum.
Det största problemet med till och med de bästa AI-videogeneratorerna är att de lider av kronisk minnesförlust – en utmaning som ny forskning från Kina nu tar sig an.
Det största problemet med till och med de bästa AI-videogenererings-systemen är att de alla har kronisk glömska: om kameran panorerar bort från det den fokuserar på och sedan panorerar tillbaka, kommer den aldrig att hitta vad som fanns där från början – karaktärer kommer att ha försvunnit, förändrat utseende och/eller rörelse, och bakgrunden kommer troligen också att ha förändrats.
Detta beror på att det diffusion-baserade genereringssystemet har ett begränsat rullande fönster av uppmärksamhet, och eftersom det alltid hanterar vad det kan se i det ögonblicket; i en sann tolkning av solipsism, är vad som är utanför ramen icke-existerande för generativ AI – det blir bokstavligen dumpat från minnet.
Detta har aldrig varit ett problem i traditionell CGI, som alltid kan hänvisa till och exakt återskapa ett motiv, inklusive utseende och rörelse, vid vilken punkt som helst i en renderad video där de kan behövas igen:

Traditionella CGI-nät och bitmappade texturer kan alltid ritas tillbaka i en render, vilket ger ett konsekvent utseende – ett knep som är mycket svårare att uppnå i AI-metoder, eftersom det inte finns någon motsvarande ‘platt referens’ fil, eller samling av relaterade filer.
Detta beror på att CGI-komponenterna, såsom nätet och texturerna (se bild ovan), samt rörelsefiler och andra dynamiska beteenden, kan lagras som separata filer på disk och ritas in i en komposition när som helst.
Det finns ingen sådan ‘platt repository’ i generativ video-AI; det närmaste den kan komma till denna funktion är LoRAs – särskilt tränade tilläggsfiler som kan tränas på konsumentutrustning, vilket möjliggör att nya karaktärer och specifika kläder kan “tvingas” in i videon:
Klicka för att spela. AI-videons solipsism-problem kan mildras till viss del genom att använda LoRAs – men resultaten kan vara överväldigande.
Detta är inte en idealisk lösning, dock. För det första är LoRAs bundna till en exakt specifik version av en grundmodell (såsom Wan2+, eller Hunyuan Video), och behöver skapas om varje gång grundmodellen ändras. För det andra tenderar LoRAs att förvränga vikterna i grundmodellen, så att LoRAs tränade identitet påverkar alla karaktärer i en scen. Dessutom är finjusteringsmetoder av detta slag mycket känsliga för dåligt kuraterade datamängder.
Exakta Återkomster
Nu erbjuder ett nytt akademiskt/industriellt samarbete från Kina den första betydande lösningen som har kommit till min kännedom under de senaste tre åren av rapportering om detta problem. Metoden använder vad forskarna kallar hybridminne för att hålla den karaktären utanför bild och dess direkta omgivningar aktiva och exakta i latentrummet i modellen, så att när vår vy återvänder till dem, är effekten konsekvent:
Klicka för att spela. Från projektets webbplats för den nya artikeln, två exempel på AI-genererade (WAN) karaktärer som lämnar ramen och återkommer exakt. Källa
Det bör betonas att detta inte är samma sak som att uppnå karaktärskonsekvens över olika tagningar – något som påstods ha uppnåtts ett år sedan i Runways Gen 4-utgåva, och som förblir en pågående jakt i forskningslitteraturen.
Istället är vad som är löst här något som ingen kommersiell eller experimentell ram jag har sett har kunnat uppnå – den visuellt konsekventa återkomsten av en karaktär utanför bild och dess tidigare utseende, rörelse och sammanhang:
Klicka för att spela. De andra två huvudexemplen som ges på det nya initiativets webbplats.
Det är uppenbart att principerna som fungerar här kan appliceras lika på andra områden, såsom urban utforskning, POV-körning eller andra typer av icke-karaktär-renderingar.
Det bör också betonas att denna nya metod inte löser eller hanterar problemet som Runway Gen4 och andra slutna plattformar påstår sig ha löst, genom att återskapa karaktärer över olika tagningar; istället gör den vad ingen av dem har lyckats med – att behålla en karaktär och miljö i minnet, utan att behöva vara synlig för åskådaren hela tiden.
Det nya arbetet består av en dedikerad datamängd som genererats genom Unreal Engine, samt anpassade mått för solipsism-problemet*, och ett specialbyggt genereringsramverk byggt över WAN. I tester mot de få analoga system som finns tillgängliga, hävdar författarna state-of-the-art-resultat, och de kommenterar:
‘[Minne] mekanismer har uppstått som en kritisk gräns för att främja världsmodeller, eftersom minneskapacitet bestämmer den rumsliga och temporala konsekvensen av genererat innehåll.
‘Specifikt är det det kognitiva ankaret som tillåter modellen att behålla historisk kontext under vyförändringar eller långsiktig extrapolering.
‘Utan robust minne, faller en simulerad värld snabbt samman i frånkopplade, kaotiska bildrutor.’
Den nya artikeln heter Utanför synfältet men inte bortglömd: Hybridminne för dynamiska videovärldsmodeller, och kommer från sju forskare över Huazhong University of Science and Technology, och Kling Team på Kuaishou Technology.
Metod
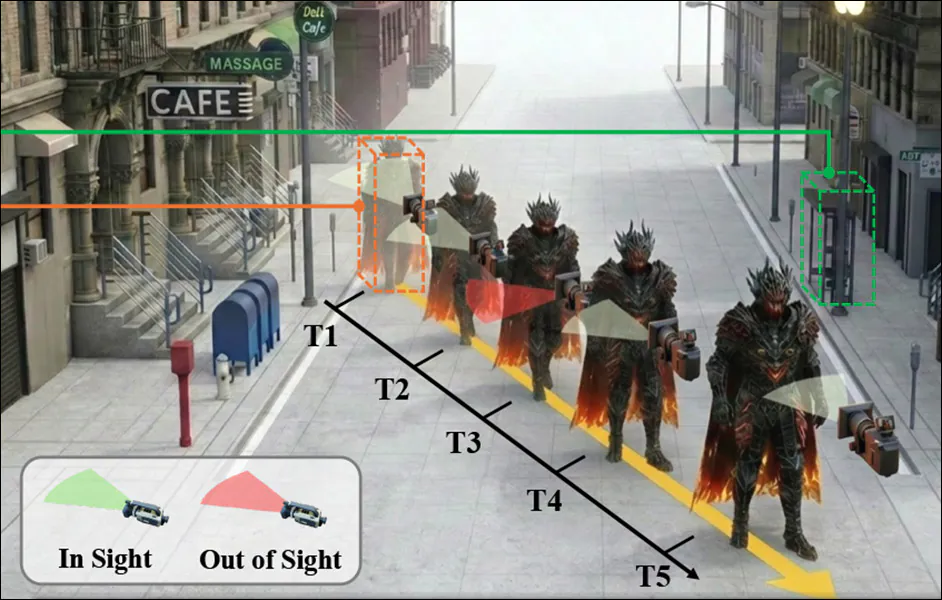
Den centrala delen av det nya arbetet är hybridminne, som möjliggör ‘ut-ur-vy-extrapolering’ – behållandet av karaktärer och deras sammanhang medan åskådaren ‘tittar bort’ (eller medan karaktären själv lämnar vyerna). I detta scenario, krävs ramverket för att utföra rumslig och tidslig frikoppling, där det samtidigt fokuserar på åskådar-synlig generering, och den karaktären utanför bilds existens.

Exempel på kamerarörelse vid in- och utgång. I dessa fall är det kamerarörelsen som orsakar att karaktären lämnar ramen, men i olika prover kan vi också observera att karaktären själv tillfälligt förflyttar sig utanför bild. Källa
Författarna noterar att i diffusion-latenta inbäddningar, är de funktioner som behöver extraheras och användas starkt sammanflätade med andra funktioner och egenskaper; och att försöka extrahera dem ofta orsakar att motivet “fryser” in i bakgrunden. Därför utvecklade och kuraterade de HM-World datamängden**, som specifikt riktar sig till att träna hybridminne:

Från artikeln, prover från de fyra kategorierna som ingår i HM-World datamängden.
Samlingen är konstruerad utmed fyra dimensioner: karaktärstrajektorier, kameratrajektorier, scener, och karaktärer.
Den syntetiska datan i HM-World består av 17 scener och 49 karaktärer, inklusive människor med olika utseende, samt djur av flera arter. Kombinationer av dessa placeras proceduralt i en scen via Unreal Engine, var och en med en distinkt rörelseanimation, och sedan sätts på en slumpmässigt vald bana.
Författarna påstår att en varierad uppsättning in- och utgångshändelser återges i datamängden, med 28 olika kamerabanor inkluderade, var och en med flera startpunkter.
Den slutliga samlingen består av 59 225 videoklipp, var och en annoterad av MiniCPM-V Multimodal Large Language Model (MLLM).
Forskarna påpekar de statistiska fördelarna med deras samling mot tidigare datamängder WorldScore; Context-As-Memory; Multi-Cam Video; och 360° Motion:

Jämförelse mellan befintliga datamängder och HM-World datamängden, där ‘Dynamisk Karaktär’ indikerar närvaron av rörliga entiteter, ‘Karaktär In- och Utgång’ betecknar klipp som innehåller karaktärer som lämnar och återkommer i ramen, och ‘Karaktär Pose’ hänvisar till inkluderingen av annoterade 3D-poser.
Den Mindre Använda Vägen
Givet flera tidigare bildrutor och en känd kamerabana, är uppgiften att förutsäga framtida vyer när åskådarens perspektiv förändras, samtidigt som man tar hänsyn till karaktärer som rör sig oberoende och kan lämna ramen innan de återkommer. Detta kräver mer än att behålla en stabil bakgrund, eftersom modellen också måste behålla en sammanhängande intern post om hur varje rörlig karaktär ser ut och beter sig, även under perioder när den inte är synlig.
Författarnas Hybrid Dynamisk Hämtning Uppmärksamhet (HyDRA) metod hanterar detta genom att införa en dedikerad minnesväg som separerar dynamiska karaktärer från den statiska scenrepresentationen, vilket tillåter dem att bestå över tid och återkomma med konsekvent utseende och rörelse:

Konceptuellt schema för HyDRA-modellen.
HyDRA är byggd över Wan2.1-T2V-1.3B, med den centrala diffusion-pipelinen lämnad i stort sett intakt, medan ett modifierat transformer-block introduceras som inkorporerar dynamisk hämtning uppmärksamhet. Detta tillåter modellen att selektivt återkalla rörelse- och utseendehinvisningar från tidigare bildrutor, snarare än att förlita sig på fasta eller lokala sammanhang.
Denna process använder ett anpassat träningsmål för flödesmatchning i stället för standard diffusionsförlust.
För att hålla scener i linje med kamerarörelse, injiceras kamerabanor som en explicit villkorsignal, med varje bildrutas pose definierad av rotation och translation, och sedan omvandlas till en komprimerad representation som fångar hur vyutvecklingen utvecklas över tid.
I linje med den tidigare (Kling) ReCamMaster initiativ, är resultatet sedan parsat av kamera-encoder, implementerad som en Multi-Layer Perceptron, sedan sänds och läggs till Diffusion Transformer funktioner, vilket tillåter modellen att behålla konsekvent objektplacering när kameran rör sig.
Tokenisering
Råa latenta diffusionsrepresentationer blandar karaktär-rörelse, utseende och bakgrund i en enda sammanflätad representation, och att försöka hämta direkt från detta utrymme riskerar att introducera irrelevant sammanhang, eller orsaka att rörliga karaktärer “blandar sig” in i bakgrunden.
HyDRA hanterar detta med en 3D-convolutionsbaserad Minnes-Tokenisator som bearbetar rum och tid tillsammans – snarare än att vidarebefordra fullständiga latenta historier, komprimerar den dem till kompakta, rörelse-medvetna minnestoken som bevarar hur karaktärer ser ut och rör sig:

Översikt av HyDRA. Vänster, Minnes-Tokenisatorn omvandlar tidigare bildrutor till kompakta, rörelse-medvetna minnestoken; höger, Dynamisk Hämtning Uppmärksamhet utvärderar den aktuella frågan mot dessa token, hämtar de mest relevanta och använder dem för att återställa konsekvent utseende och rörelse i den genererade bildrutan.
Dessa token bildar ett strukturerat hybridminne som filtrerar brus medan det behåller dynamik över långa tidsperioder. Överförd till Dynamisk Hämtning Uppmärksamhetsmodulen, tillåter dessa modellen att selektivt återkalla karaktärer utanför bild, så att de återkommer med konsekvent utseende, rörelse och sammanhang.
Dynamisk Hämtning Uppmärksamhet
HyDRAs dubbla minnesmekanism använder också dynamisk hämtning uppmärksamhet i en distinkt men kompletterande roll inom ramverket.
Minnes-Tokenisering komprimerar tidigare latenta representationer till strukturerade, rörelse-medvetna token som separerar dynamiska karaktärer från statiskt sceninnehåll, reducerar sammanflätningen som ofta orsakar att karaktärer “blandar sig” in i bakgrunden. Dessa token bildar en bestående minnesbank snarare än en fullständig bildrutehistorik.
Dynamisk Hämtning Uppmärksamhet fungerar sedan över denna bank under generering, utvärderar den aktuella frågan mot lagrade token och selektivt återkallar de som är mest relevanta för den framväxande bildrutan. Detta tillåter karaktärer utanför bild att fortsätta sin latenta utveckling (dvs. att fortsätta gå, springa, när du inte kan se dem), och återkomma med konsekvent utseende och rörelse när de återvänder till vyerna, snarare än att återställa eller försämras.
Data och Tester
I tester, kodade Wan-baserade HyDRA-systemet och nedsamplede 77 kontextbildrutor innan de parsades med en 3D Variational Autoencoder (VAE), medan den ovannämnda minnes-tokenisatorn använde 3D-convolution med en kernel-storlek på 2x4x4.
Modellen tränades på HW-World i 10 000 iterationer på 32 (ospecificerade) GPU:er, med en batch-storlek på 32.
Ett ovanligt stort antal mått användes i testerna: förutom de sedvanliga Peak Signal-to-Noise Ratio (PSNR), Structural Similarity Index (SSIM), och Learned Perceptual Similarity Metrics (LPIPS), använde författarna också karaktärskonsekvens och bakgrunds-konsekvens från VBench sviten, för att utvärdera sammanhang på bildrutenivå.
De utvecklade också ett anpassat mått med namnet Dynamisk Karaktär-Konsekvens (DSC), som använder begränsningsrutor från YOLO V11, för att skapa beskurna regioner som innehåller rörliga karaktärer, från vilka semantiska funktioner extraherades och deras likheter sedan beräknades.
HyDRA jämfördes med Diffusion Forcing Transformer (DFoT), och Context-As-Memory, mot en baslinje Wan2.1-T2V-1.3B modell utrustad med en kamera-encoder (för att representera den subjektiva vy som är gemensam för alla klippen). Alla modeller tränades på HW-World, och WorldPlay användes också som en nollskotts, sekundär test-samling:
I initiala kvantitativa jämförelser, överträffade HyDRA alla baslinjer, ökade PSNR från 18.696 till 20.357, och SSIM från 0.517 till 0.606. Den uppnådde också den högsta kontextrefererade och ground-truth-refererade Dice-poängen, 0.827 och 0.849, med Karaktär- och Bakgrunds-Konsekvens som nådde 0.926 och 0.932:

Resultat från den initiala kvantitativa jämförelsen mot tidigare tillvägagångssätt.
DFoT nådde 17.693 PSNR och Context-as-Memory 18.921, med vinsterna tillskrivna minnes-tokenisering kombinerad med dynamisk hämtning uppmärksamhet:

Kvantitativ jämförelse som pitchar HyDRA mot den nuvarande state-of-the-art.
Med avseende på testerna mot WorldPlay, påstår författarna:
‘Vår metod överträffar WorldPlay över alla mått, med ett anmärkningsvärt PSNR-gap på 5.502. Även om WorldPlay visar lägre prestanda på GT-refererade mått (t.ex. PSNR på 14.855, DSCGT på 0.832) på grund av skillnader i domänfördelning och brist på specifik finjustering, visar den ändå imponerande robusthet på kontext-refererade mått genom att uppnå en DSCctx på 0.822.
‘Denna observation bekräftar inte bara att omfattande tränade modeller besitter godtagbar hybridkonsekvens, utan validerar också indirekt rationaliteten i våra föreslagna DSC-mått i att reflektera dynamisk karaktär-konsekvens.
‘Slutligen, dessa imponerande resultat lyfter fram de exceptionella förmågorna hos vår modell, och visar dess överlägsenhet, till och med över etablerade kommersiella modeller.’
Artikeln erbjuder en statisk representation av kvalitativa jämförelser som utfördes för testerna:

Kvalitativ jämförelse av in- och utgång under kamerarörelse. Författarna hävdar att HyDRA bevarar karaktär-identitet, pose och rörelse-kontinuitet efter att ha lämnat och återvänt till ramen, nära matchande grund-sanning, medan konkurrerande metoder visar avvikelse, inkonsekvent rörelse eller karaktär-försämring, markerad i rött (konsekventa återhämtningar är markerade i grönt).
Om dessa resultat, kommenterar författarna:
‘I fallet med komplexa in- och utgångshändelser, visar baslinjen och Context-as-Memory allvarlig karaktär-försämring och rörelse-inkonsekvens. DFoT misslyckas med att behålla karaktär-integritet, vilket leder till fullständigt försvinnande. Medan WorldPlay lyckas behålla karaktärens utseende-konsekvens, lider den av hackiga rörelser och onaturliga handlingar.
‘I kontrast, vår metod lyckas behålla hybrid-konsekvens, bevarande både karaktär-identitet och rörelse-konsekvens efter att karaktären återkommer i ramen.’
Ytterligare resultat kan ses i videoformat på den kompletterande webbplatsen, av vilka de första fyra exemplen har satts samman (av oss) i videon nedan:
Klicka för att spela. Fyra av de sex testresultat som presenteras på projektwebbplatsen. Källa
Slutsats
Medan varje försök att hantera ett av de största problemen med AI-videogenerering är välkommet, verkar det oundvikligt för mig att den optimala lösningen för in- och utgångsproblem av detta slag kommer att bevisas vara, som det var med CGI, i form av distinkta referensmaterial som kan redigeras separat och föras in i en kompositionsmiljö.
Detta arbete med att försöka behålla en inbäddning levande på ett ad hoc-sätt och i farten verkar utmattande, och erbjuder också ingen tydlig väg framåt till den konsekvens inom en tagning som nu erbjuds på olika svarta-låda-portaler som Runway. Om det visar sig att en efterföljande tagning kommer att kräva tillgång till det latenta rummet i den föregående tagningen, varför inte ha båda instanser placera en avgränsad och separat karaktärsinbäddning?
* Ingen annan har namngivit det, och diskussion är svår utan gemensamma termer.
** Rapporterat att vara ‘kommande snart’, på projektwebbplatsen.
Publicerad första gången fredag, 27 mars 2026


