
Fundamentele AI
Cum funcționează clasificarea imaginilor?

 Adaugă Unite.AI la sursele tale preferate pe Google
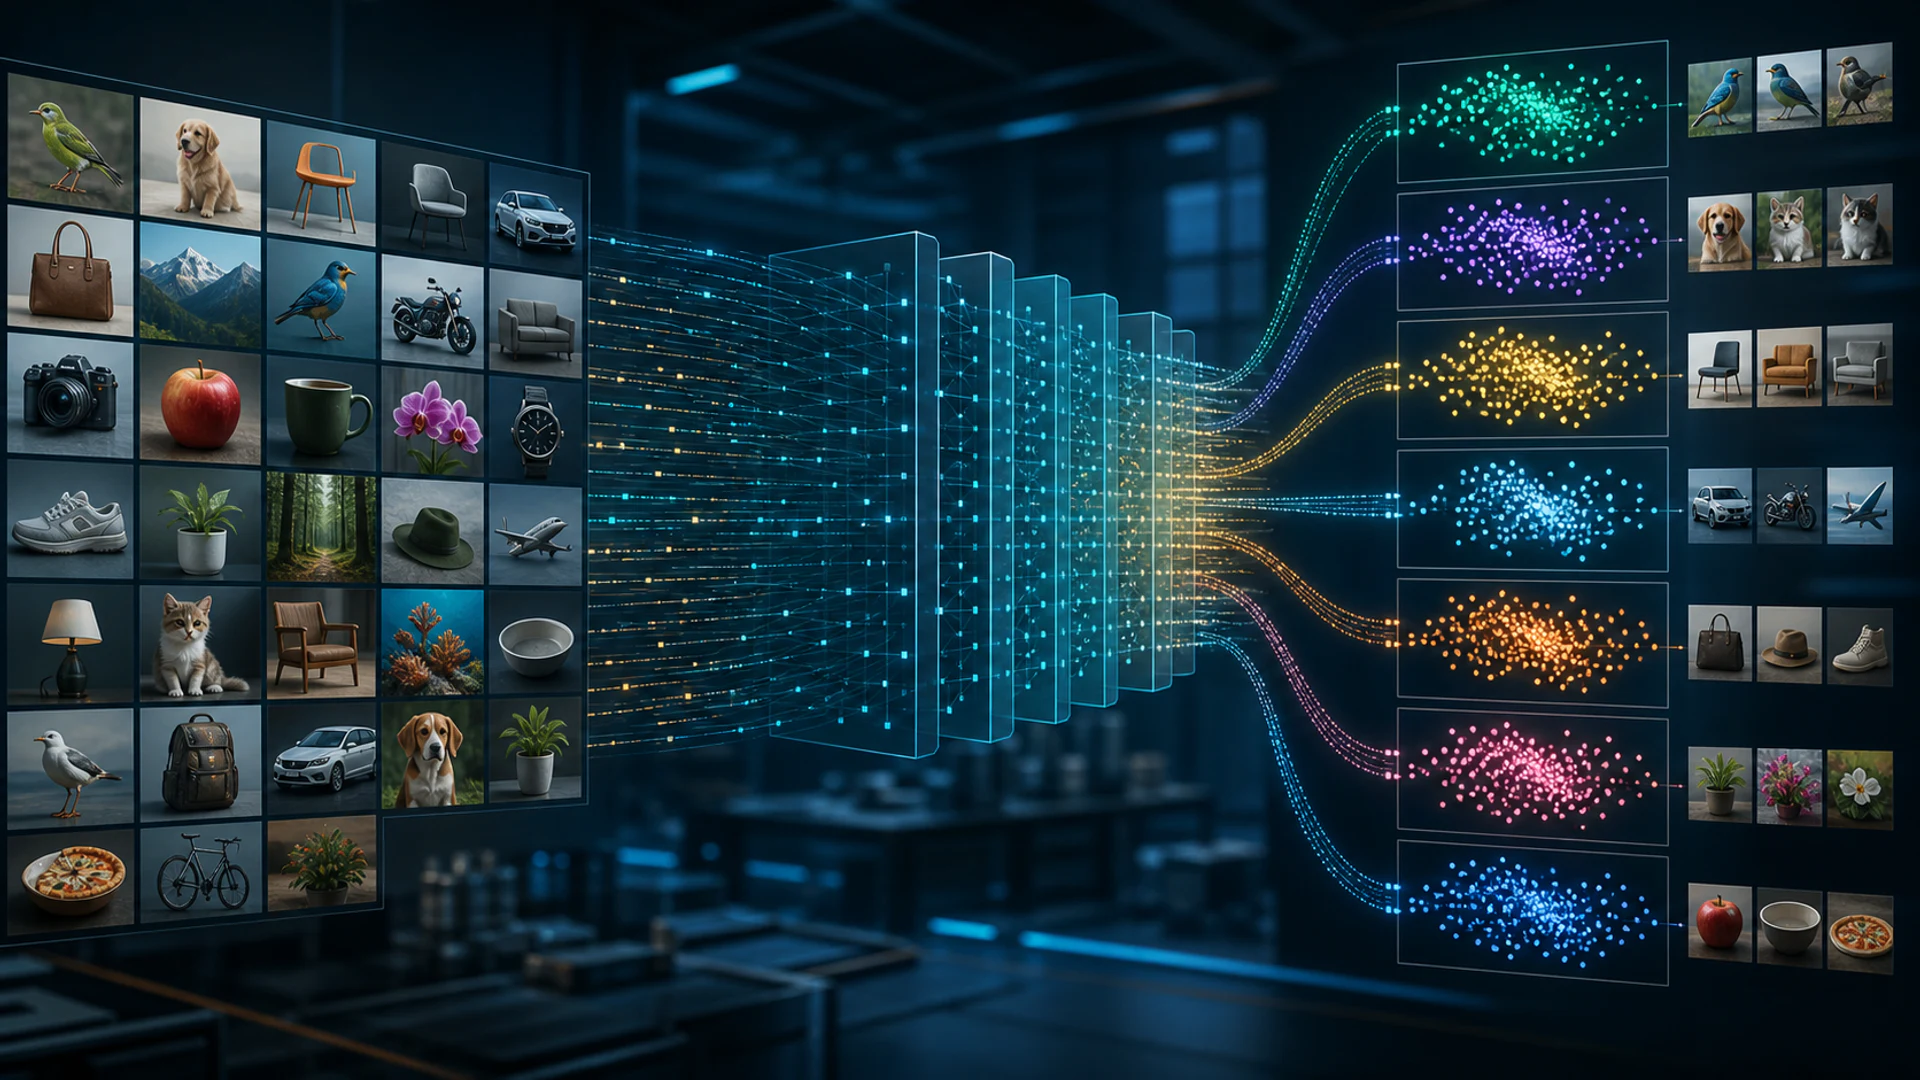
Clasificarea imaginilor prezice o etichetă pentru întreaga imagine. Răspunde la întrebări precum „Ce categorie de produs este afișată?” sau „Această scanare conține o descoperire țintă?” Nu localizează fiecare obiect sau conturează pixelii în mod independent.
Sistemele moderne utilizează în mod obișnuit rețele neuronale convoluționale sau transformatoare de vedere, adesea inițializate cu greutăți pre-antrenate. Performanța fiabilă depinde în continuare de etichete, eșantionare, augmentare, calibrare și testare în condiții reale de implementare.
Aspecte cheie
- Clasificarea etichetează întreaga imagine; detectarea trasează cutii pentru obiecte, iar segmentarea atribuie regiuni la nivel de pixel.
- Pre-antrenarea și învățarea prin transfer pot reduce cerințele de date, dar nepotrivirea domeniului poate anula beneficiul.
- Acuratețea de ansamblu poate ascunde dezechilibrul claselor, scurtăturile spurioase și calibrarea slabă.
- Calitatea imaginii, dispozitivul de captare, geografia și modificările fluxului de lucru pot genera toate o schimbare a distribuției.
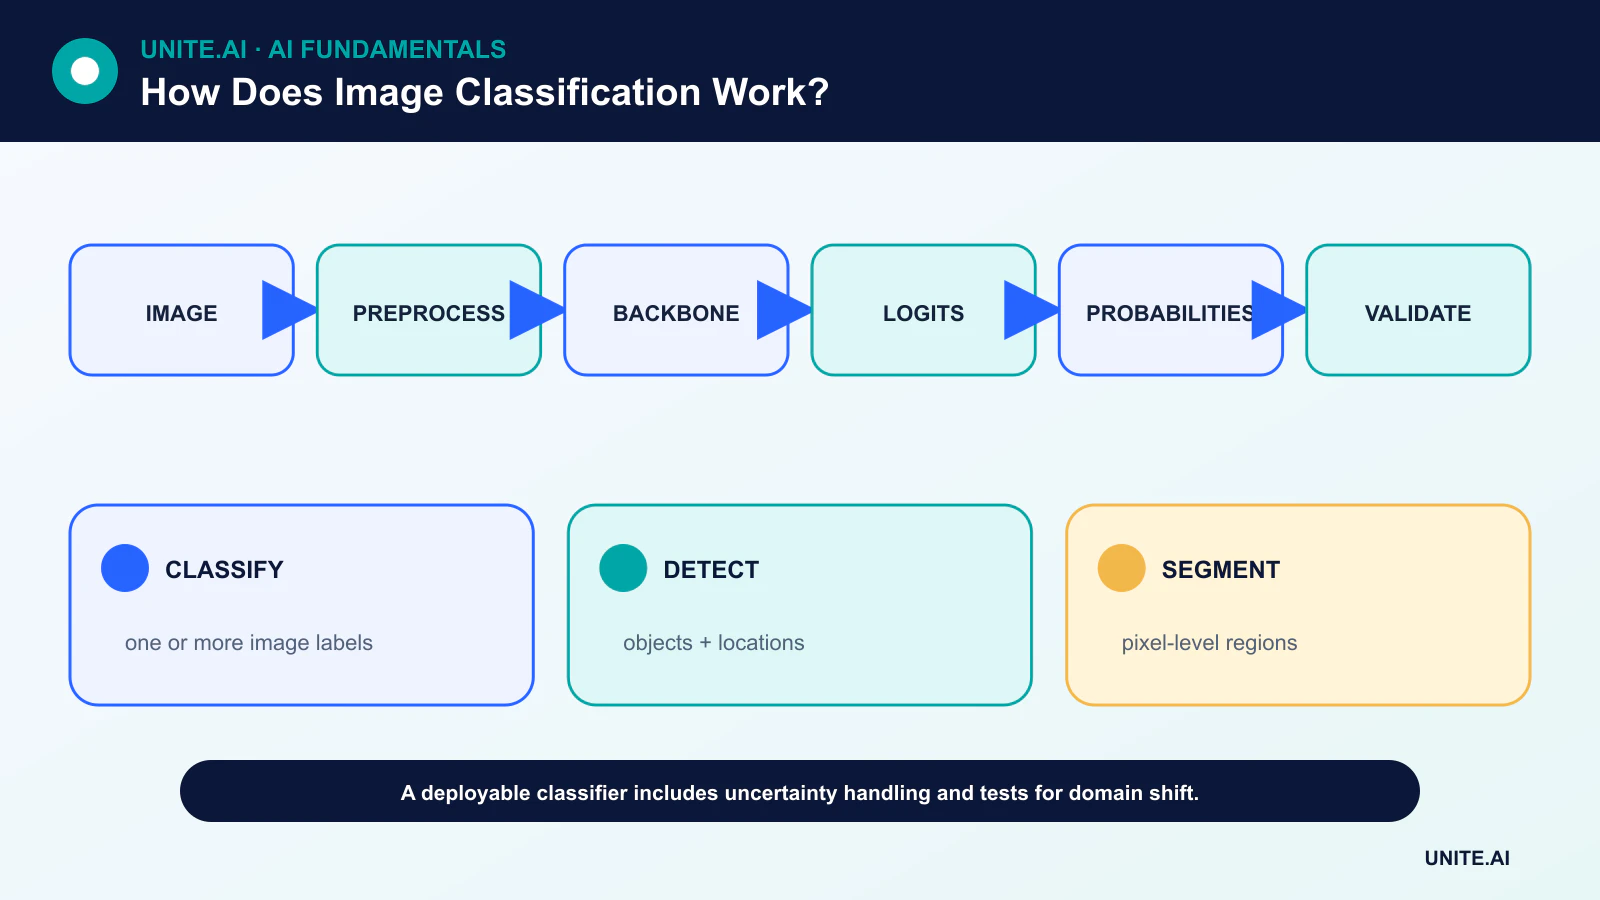
De la pixeli la scoruri
Imaginile sunt redimensionate sau decupate, normalizate și convertite în tensori. Augmentarea datelor poate aplica transformări care păstrează eticheta, cum ar fi răsturnări, decupări sau modificări de culoare. Un backbone transformă pixelii în caracteristici; o componentă de clasificare produce logituri care sunt convertite în scoruri relative pentru clase.
Preprocesarea aleasă trebuie să corespundă implementării. O decupare centrală care elimină obiectul relevant sau o nepotrivire de normalizare poate afecta performanța chiar și atunci când greutățile antrenate rămân neschimbate.
Rețele neuronale convoluționale și transformatoare de vedere
Rețelele neuronale convoluționale utilizează filtre locale și greutăți partajate pentru a construi caracteristici spațiale. Conexiunile reziduale au făcut ca rețelele CNN foarte adânci să fie mai ușor de optimizat. Transformatoarele de vedere împarte o imagine în patch-uri și folosește atenția pentru a modela relațiile dintre ele.
Comparațiile de arhitecturi ar trebui să controleze datele de antrenament, augmentarea, calculul și rezoluția. Cel mai bun model pe un benchmark public poate să nu fie cea mai potrivită alegere pentru un dispozitiv edge, un set de date mic sau o cerință de explicabilitate.
Învățarea prin transfer și proiectarea datelor
Învățarea prin transfer pornește de la greutăți antrenate pe un set de date sursă mai mare. O echipă poate îngheța backbone-ul, ajusta fin straturile ulterioare sau actualiza întregul model. Ajustarea fină necesită de obicei o rată de învățare mai mică și un set de validare sigur împotriva scurgerilor.
Etichetele ar trebui să descrie ceea ce este inferabil vizual. Dacă un diagnostic depinde de istoricul pacientului indisponibil în imagine, clasificatorul nu poate învăța decizia clinică completă. Duplicatele, cadrele dintr-un singur video și imaginile de la același subiect trebuie să rămână în aceeași împărțire.
Metrice, incertitudine și scurtături
Acuratețea Top-1 necesită ca clasa cu cel mai mare scor să fie corectă; acuratețea top-k acceptă clasa corectă printre cele k clase cu cele mai mari scoruri. Precizia, recall-ul și o matrice de confuzie pe clasă expun erori inegale.
Modelele pot exploata fundaluri, filigrane, echipamente de achiziție sau încadrare în locul obiectului vizat. Testele contrafactuale, analiza subgrupurilor și instrumentele de saliență pot ajuta la descoperirea scurtăturilor, dar o hartă termică de explicație nu este dovada unui raționament cauzal.
Monitorizarea implementării
Verificările în producție ar trebui să acopere fișiere corupte, dimensiuni neașteptate, blur, iluminare, modele de camere și clase noi. Încrederea trebuie calibrată pe date similare cu cele de implementare, iar intrările în afara domeniului trebuie respinse sau revizuite.
Monitorizarea etichetelor întârziate și a modificărilor costului erorii este esențială. Un model care pare stabil din perspectiva statisticilor de intrare poate totuși să eșueze dacă relația dintre pixeli și etichete se modifică.
Construirea unui set de date pentru clasificarea imaginilor
Clasificarea imaginilor atribuie una sau mai multe etichete unei imagini întregi. Diferențiază de detectare, care localizează obiectele, și de segmentare, care etichetează pixelii. Definiți domeniul clasei, ierarhia, regulile multi-etichetă, categoriile de fundal sau necunoscute și ce dovezi trebuie să fie vizibile. Colectați camere, locații, iluminare, unghiuri de vizualizare, distanțe și subiecte reprezentative pentru implementare. Împărțiți pe subiect, scenă, sesiune sau sursă înainte de augmentare; cadrele video adiacente sau imaginile de produs duplicate în diferite partiții cauzează scurgeri severe.
Instrucțiunile de adnotare ar trebui să acopere obstrucția, obiectele ambigue, clase multiple, calitatea scăzută și abstinența. Măsurați acordul și revizuiți neînțelegerile sistematice. Echilibrul claselor singur nu garantează acoperirea: o clasă de boală poate include un singur dispozitiv sau o clasă de faună un singur fundal. Inspectați metadatele și duplicatele apropiate și păstrați un set de testare protejat din achiziție independentă. Datele sintetice și scraping-ul web pot extinde varietatea, dar introduc probleme de licențiere, proveniență, stil și etichetare care trebuie evaluate pe imagini reale.
Modele, antrenament și evaluare
Metodele clasice combină descriptorii proiectați cu un clasificator; sistemele moderne folosesc rețele convoluționale sau transformatoare de vedere, adesea prin învățare prin transfer. Alegerile de redimensionare și decupare determină ce informație supraviețuiește. Augmentarea ar trebui să reflecte variații valide și să păstreze etichetele. Optimizați o funcție de pierdere adecvată sarcinii, gestionați dezechilibrul prin ponderare sau eșantionare cu atenție și selectați puncte de control pe datele de validare. Comparați cu un punct de referință simplu și eliminați augmentarea, rezoluția și inițializarea pre-antrenată pentru a înțelege de unde provin îmbunătățirile.
Raportați precizia, recall-ul, F1, confuzia pe clasă, acuratețea top-k când este relevantă, calibrarea și performanța pe condiție. Testați blur, compresie, iluminare, decupare, obstrucție, dispozitiv și intrări fără clasă suportată. Pragurile de încredere pot direcționa cazurile incert spre revizuire; probabilitatea softmax nu garantează încredere, în special în condiții de schimbare. Fundalurile contrafactuale și testele de obstrucție dezvăluie învățarea prin scurtături. Pentru utilizări legate de siguranță, evaluați eșecurile în cel mai rău caz și consecințele falselor pozitive și negative.
Implementare și monitorizare
Împachetați decodarea, conversia culorii, orientarea, normalizarea, modelul și harta de etichete împreună. Validați artefactul exportat sau cuantificat pe dispozitivele țintă și măsurați latența end-to-end, memoria, consumul de energie și debitul. Monitorizați calitatea imaginii, distribuțiile de intrare și ieșire, calibrarea, etichetele confirmate și starea senzorilor. Reduceți și securizați păstrarea imaginilor, în special pentru fețe, locații și persoane din fundal. Oferiți o soluție de rezervă pentru intrări corupte sau în afara domeniului și reveniți la versiuni anterioare ale modelului. Clasificarea răspunde la întrebarea la nivel de imagine definită; nu ar trebui extinsă la localizare, identitate sau revendicări de intenție neacceptate.
Exemplu practic: clasificarea materialelor reciclabile
O unitate fotografiază obiectele pe o bandă transportoare și etichetează clasa materialului, contaminarea și necunoscutul. Imaginile sunt împărțite pe zi de colectare și lot de obiecte, acoperind iluminarea, suprafețele umede, zdrobirea, suprapunerea și benzile goale. Un mic CNN și un model pre-antrenat sunt comparate cu reguli de culoare și formă. Recall-ul pe clasă, sortarea incorectă, calibrarea, debitul și rezultatele pe cameră și condiția materialului conduc la selecție.
Linia de producție verifică expunerea camerei și sincronizarea benzii, apoi trimite elementele incert spre un flux general în loc să forțeze o clasă. Inferența cuantificată este validată pe hardware exact. Monitorizarea urmărește calitatea intrării, ratele de clasă, respingerile și audituri manuale eșantionate; ambalajul nou declanșează o actualizare revizuită a datelor. Modelul controlează un sortator limitat cu protecții fizice, iar o defecțiune a senzorului sau a modelului readuce mecanismul într-o stare sigură în loc să redirecționeze materialul în tăcere.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație reușită. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o bază reproductibilă și un set de evaluare versionat înainte de ajustare. Testați cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbarea distribuției, întreruperea dependențelor, utilizarea greșită și grupurile sau mediile cel mai probabil subreprezentate. Măsurați calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un evaluator independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Folosiți o implementare etapizată, păstrați o soluție de rezervă sigură și verificați monitorizarea cu defecțiuni injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrării, comportamentul ieșirii, versiunea modelului sau a regulii, starea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți pragurile de alertă și responsabilul de răspuns, apoi revizuiți dovezile din viața reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware-ul sau obiectivele se modifică. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar în care să fie dezactivat sau înlocuit.
Întrebări frecvente
Poate un clasificator de imagini să identifice mai multe obiecte?
Un clasificator multi-etichetă poate indica care categorii sunt prezente, dar nu localizează fiecare instanță. Detectarea obiectelor este necesară pentru cutii sau numărări.
De ce poate un model să eșueze pe fotografii care par normale pentru o persoană?
Poate să se bazeze pe artefacte de captare, texturi sau corelații care s-au modificat. Diferențele mici în preprocesare și schimbarea domeniului pot afecta, de asemenea, caracteristicile învățate.
Referințe principale












