
AGI i przyszłość AI
Czym jest test Turinga i dlaczego ma znaczenie?

 Dodaj Unite.AI do preferowanych źródeł w Google
Test Turinga wywodzi się z artykułu Alana Turinga z 1950 roku “Computing Machinery and Intelligence”. Zamiast próbować definiować myślenie, Turing zaproponował grę imitacyjną: ludzki przesłuchujący wymienia pisemne wiadomości z niewidocznymi uczestnikami i ocenia, który z nich jest człowiekiem, a który maszyną.
Test pozostaje wpływowy, ponieważ przekształca abstrakcyjne pytanie filozoficzne w obserwowalną interakcję. Ma jednak ograniczenia: wyglądanie jak człowiek w rozmowie nie jest tym samym, co bycie prawdomównym, kompetentnym, bezpiecznym, świadomym czy ogólnie inteligentnym.
Kluczowe wnioski
- Oryginalna gra imitacyjna Turinga to test zachowań oparty na tekście, a nie lista kontrolna wewnętrznych właściwości poznawczych.
- Wyniki zależą od oceniającego, podpowiedzi, czasu trwania, instrukcji dla uczestników oraz reguły punktacji.
- Model może naśladować ludzką konwersację, jednocześnie wymyślając fakty lub nie radząc sobie z prostymi testami odporności.
- Współczesna ocena wymaga metryk zadaniowych, testów adwersarialnych, przeglądu ludzkiego oraz dowodów specyficznych dla ryzyka, oprócz samej rozmowy.
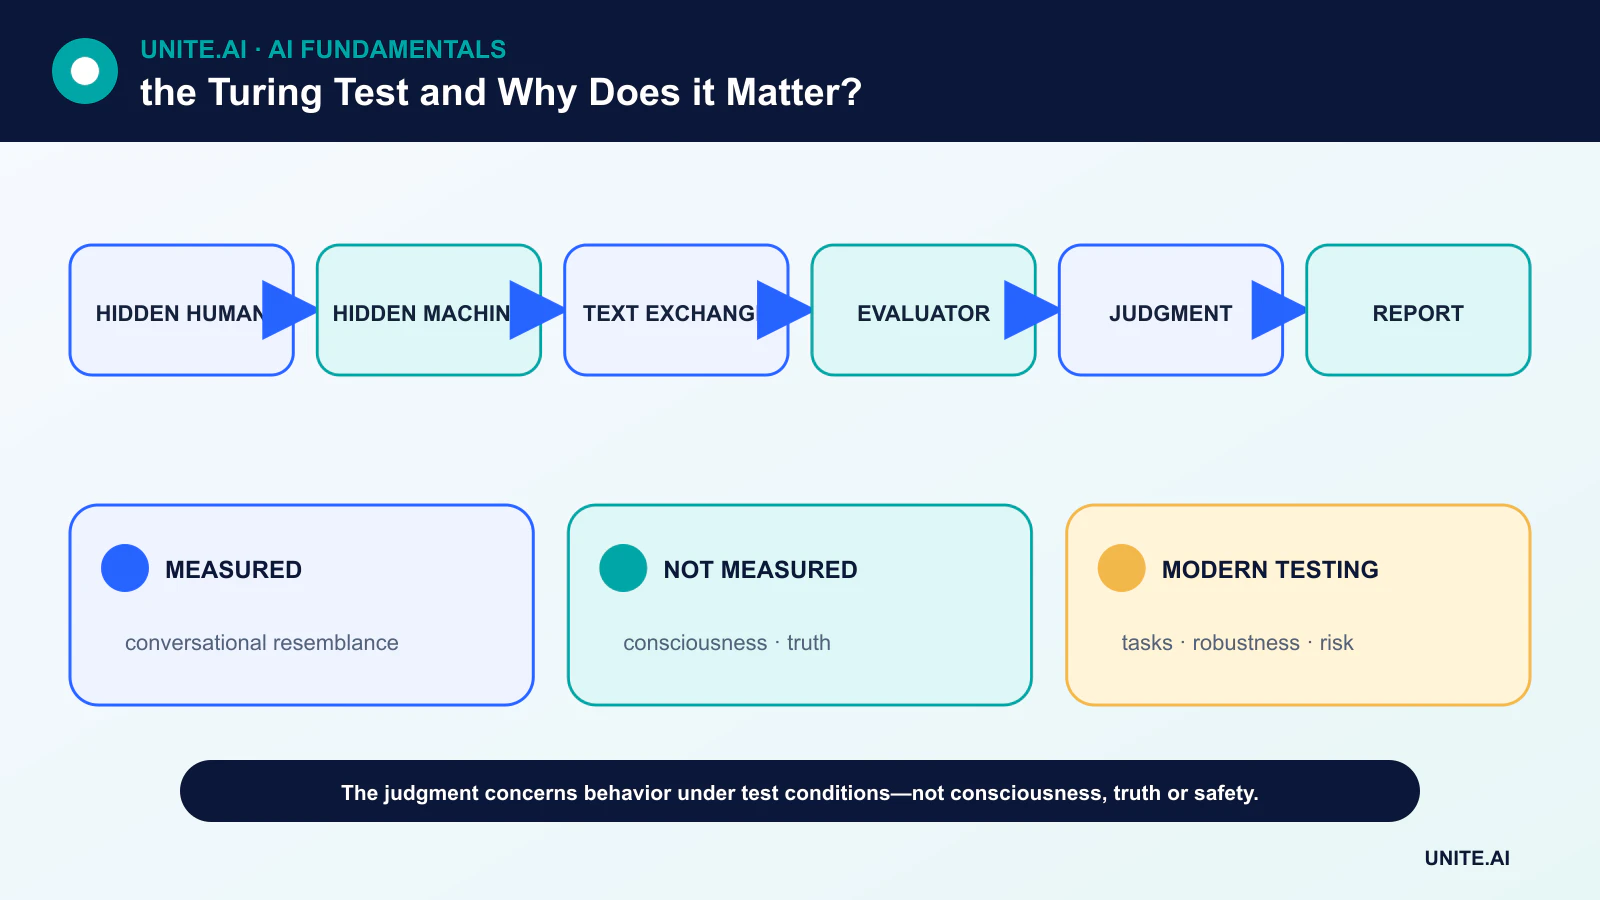
Gra imitacyjna Turinga
W pierwotnym układzie przesłuchujący komunikował się z daleka, aby głos i wygląd nie ujawniały tożsamości. Turing zapytał, czy maszyna może wystąpić wystarczająco dobrze w grze, aby oceniający nie mógł jej wiarygodnie odróżnić od człowieka.
Takie ujęcie operacyjne uniknęło konieczności ustalenia jednej definicji myślenia. Nie twierdziło, że każde przekonujące wymienianie się dowodzi inteligencji, ani nie określało uniwersalnego progu zaliczenia, który miałby zastosowanie do późniejszych demonstracji chatbotów.
Co właściwie mierzy wynik
Test mierzy nieodróżnialność zachowań w określonych warunkach. Krótkie rozmowy, niedoświadczeni sędziowie lub podpowiedzi wybrane przez twórcę systemu mogą ułatwić zadanie. Rygorystyczny raport powinien ujawnić sposób wyboru transkryptów, liczbę i tło sędziów, grupę porównawczą ludzi, limit czasu oraz metodę statystyczną.
System może także wykorzystywać oczekiwania: unikanie odpowiedzi, humor, błędy typograficzne i odgrywanie ról mogą sprawiać wrażenie ludzkiego zachowania bez wykazywania rzetelnego rozumowania. Z drugiej strony, niezwykle formalna ludzka odpowiedź może zostać błędnie zaklasyfikowana jako wygenerowana przez maszynę.
Czego test Turinga nie ustala
Test nie mierzy bezpośrednio świadomości, subiektywnego doświadczenia, dokładności faktów, rozumienia przyczynowego ani moralnej agencji. Nie ujawnia danych treningowych, architektury modelu ani trybów awarii poza rozmową. Nie mówi również wiele o inteligencji nielingwistycznej, takiej jak manipulacja fizyczna.
Współczesne systemy językowe są budowane przy użyciu sieci neuronowych typu transformer i głębokiego uczenia, ale ich płynne odpowiedzi mogą nadal być generowane na podstawie wyuczonej struktury statystycznej, a nie zweryfikowanego modelu świata.
Jak współczesna ocena AI rozwija pytanie
Współczesna ocena wykorzystuje odrębne zestawy zadań, skalowaną niepewność, testy odporności, red teaming, weryfikacje faktualności oraz badania preferencji ludzkich. Metryka klasyfikacji tekstu może testować określone zachowanie, natomiast ocena oparta na scenariuszach może sprawdzić, czy system przestrzega zasad pod presją.
Żaden pojedynczy benchmark nie obejmuje wszystkich zastosowań. Zanieczyszczenie testu może zawyżać wyniki, a statyczne benchmarki zachęcają do przeuczenia. Ocena powinna być powtarzana w miarę zmian modeli, danych, podpowiedzi, narzędzi i grup użytkowników.
Dlaczego test wciąż ma znaczenie
Test Turinga przewidział kluczową lekcję oceny AI: oceniaj obserwowalne możliwości, zamiast polegać na twierdzeniach o wewnętrznej istocie. Zmusza także do pytania, które ludzkie zachowania liczą się jako dowód i w jaki sposób układ eksperymentalny kształtuje wniosek.
Najlepsze współczesne zastosowanie to traktowanie go jako historycznej i koncepcyjnej bazy odniesienia. Zaliczenie gry imitacyjnej może być interesujące, ale decyzje o wdrożeniu wymagają dowodów powiązanych z rzeczywistym zadaniem, dotkniętymi użytkownikami i przewidywanymi szkodami.
Co mierzy test Turinga
Gra imitacyjna Alana Turinga pytała, czy przesłuchujący komunikujący się tekstowo może wiarygodnie odróżnić maszynę od człowieka. Przekształciła abstrakcyjną debatę o tym, czy maszyny myślą, w obserwowalny eksperyment konwersacyjny. Test zależy od uczestników, czasu trwania, protokołu, tematów i reguły oceniania; nie istnieje jeden uniwersalny wynik. Zaliczenie oznacza generowanie odpowiedzi przypominających ludzkie w tym układzie. Nie mierzy bezpośrednio dokładności faktów, rozumowania, świadomości, autonomii, percepcji, ucieleśnienia, niezawodności ani korzystnego zachowania w rzeczywistym świecie.
Naśladowanie człowieka może nagradzać unikanie, przyjmowanie roli, błędy, humor lub manipulację. Sędzia może pomylić człowieka z maszyną lub być pod wpływem oczekiwań, języka i kontekstu kulturowego. Krótkie rozmowy umożliwiają sztuczki, które zawodzą przy dłuższej interakcji. Z drugiej strony, wysoce użyteczny system do matematyki, tłumaczeń lub modelowania białek może nie zaliczyć testu, ponieważ nie udaje człowieka. Test więc mierzy społeczną i językową zdolność kształtowaną przez oceniającego, a nie pełną hierarchię inteligencji.
Nowoczesne modele językowe i silniejsza ocena
Duże modele językowe potrafią utrzymać płynną dialogę, przewidując sekwencje na podstawie szerokich danych treningowych i późniejszego dostrajania, ale płynność jest słabym dowodem prawdy lub zrozumienia. Zapamiętane wzorce, dostęp do narzędzi, ukryte podpowiedzi, opóźnienia i ustawienia próbkowania wpływają na wyniki. Kontrolowane oceny powinny ujawnić model i protokół, zapobiegać wyciekom informacji, zawierać pytania adwersarialne i dziedzinowe oraz oceniać niepewność i cytowanie. Demonstracja wybrana spośród udanych rozmów nie może oszacować niezawodności w całym zakresie użycia.
Współczesna ocena jest wielowymiarowa: dokładność zadania, kalibracja, odporność, spójność w długim horyzoncie, bezpieczeństwo, uprzedzenia, prywatność, bezpieczeństwo, efektywność i wyniki dla ludzi. Testy zachowań powinny być uzupełniane dowodami procesowymi, red teamingiem, powtarzalnymi benchmarkami oraz monitorowaniem w rzeczywistym świecie. Benchmarki mogą się nasycać lub wchodzić w dane treningowe, dlatego potrzebne są prywatne i odświeżane zestawy testowe. Dla systemów działających, należy oceniać uprawnienia narzędzi, odzyskiwanie i konsekwencje oddzielnie od jakości konwersacji.
Dlaczego test wciąż ma znaczenie
Test Turinga pozostaje ważny historycznie, ponieważ koncentruje się na zachowaniu i trudności definiowania inteligencji. Porusza także ciągłe pytania o antropomorfizm i oszustwo. Interfejsy powinny identyfikować syntetyczne agenty, a nie traktować pomyłki tożsamości jako sukces, szczególnie w sytuacjach o istotnych konsekwencjach. Należy używać testu jako filozoficznej soczewki i jednej oceny konwersacyjnej, a nie certyfikacji ogólnej inteligencji czy osobowości. Kluczowe pytanie przy wdrożeniu brzmi, co system może wiarygodnie zrobić, na jakich dowodach i ograniczeniach, oraz kto jest odpowiedzialny w razie niepowodzenia.
Przykład praktyczny: kontrolowana ocena konwersacyjna
Oceniacze porównują ludzi i kilka systemów AI w tekstowych rozmowach o stałym czasie trwania, tematach, języku i ukrytych tożsamościach. Sędziowie zapisują, czy uważają, że dany uczestnik jest człowiekiem, oraz oceniają faktualność, spójność, użyteczność, niepewność i manipulację. Wielu sędziów i rozmów pozwala oszacować zmienność, a protokół zapobiega wybieraniu korzystnych transkryptów przez twórców modeli. Błędna klasyfikacja człowieka zapewnia niezbędną bazę odniesienia do interpretacji wyniku.
System, który oszukuje sędziów, ale wymyśla fakty, nie jest uznawany za ogólnie inteligentny, podczas gdy wyraźnie ujawniony model specjalistyczny może być bardzo użyteczny, mimo że nie zalicza imitacji. Wyniki zawierają podpowiedź, model, sampler, dostęp do narzędzi oraz cechy sędziów. Eksperyment jest przedstawiony jako jeden test konwersacji przypominającej ludzką. Decyzje wdrożeniowe wykorzystują odrębne dowody dotyczące poprawności zadania, bezpieczeństwa, prywatności i odzyskiwania, a interfejs identyfikuje agenta zamiast zamieniać oszustwo w cel produktu.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja o produkcji wymaga czegoś więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal powtarzalną bazę i wersjonowany zestaw oceny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące dane wejściowe, zmianę rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsługiwane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zarejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie produktu. Stosuj etapowe wdrażanie, zachowaj bezpieczną alternatywę i weryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjścia, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych wrażliwych danych. Określ progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline’owa wydajność będzie trwała. Przeprowadzaj ponowną ocenę przy zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy jakikolwiek AI definitywnie przeszedł test Turinga?
Nie istnieje jedna oficjalna władza testowa ani powszechnie akceptowany protokół. Publiczne demonstracje stosują różne zasady, więc twierdzenia o „zaliczeniu” nie są bezpośrednio porównywalne.
Czy niezdanie testu dowodzi, że system jest nieinteligentny?
Nie. Specjalistyczny system może być wysoce zdolny, nie naśladując ludzkiego stylu konwersacji.
Podstawowe źródła












