
Podstawy AI
Jak działa klasyfikacja tekstu?

 Dodaj Unite.AI do preferowanych źródeł w Google
Klasyfikacja tekstu przydziela jedną lub więcej etykiet dokumentowi, wiadomości lub fragmentowi tekstu. Przykłady obejmują wykrywanie spamu, kierowanie intencji, analizę sentymentu, tagowanie tematów, moderację oraz priorytetyzację zgłoszeń wsparcia.
Klasyfikator produkcyjny to nie tylko model. Zależy od precyzyjnej taksonomii etykiet, reprezentatywnych anotacji, podziałów zabezpieczonych przed wyciekiem, skalibrowanej reguły decyzyjnej oraz monitorowania zmieniającego się języka i częstości klas.
Kluczowe wnioski
- Zdefiniuj etykiety i przypadki niejednoznaczne przed wyborem architektury.
- Proste baseline’y oparte na worku słów pozostają wartościowe; wstępnie wytrenowane enkodery dodają kontekst i uczenie transferowe.
- Dokładność może ukrywać słabą wydajność klas mniejszościowych, dlatego używaj metryk uwzględniających klasy oraz analizy błędów.
- Kalibracja prawdopodobieństwa, abstencja i przegląd ludzki przekształcają wyniki w bezpieczniejsze decyzje.
Zdefiniuj taksonomię i politykę anotacji
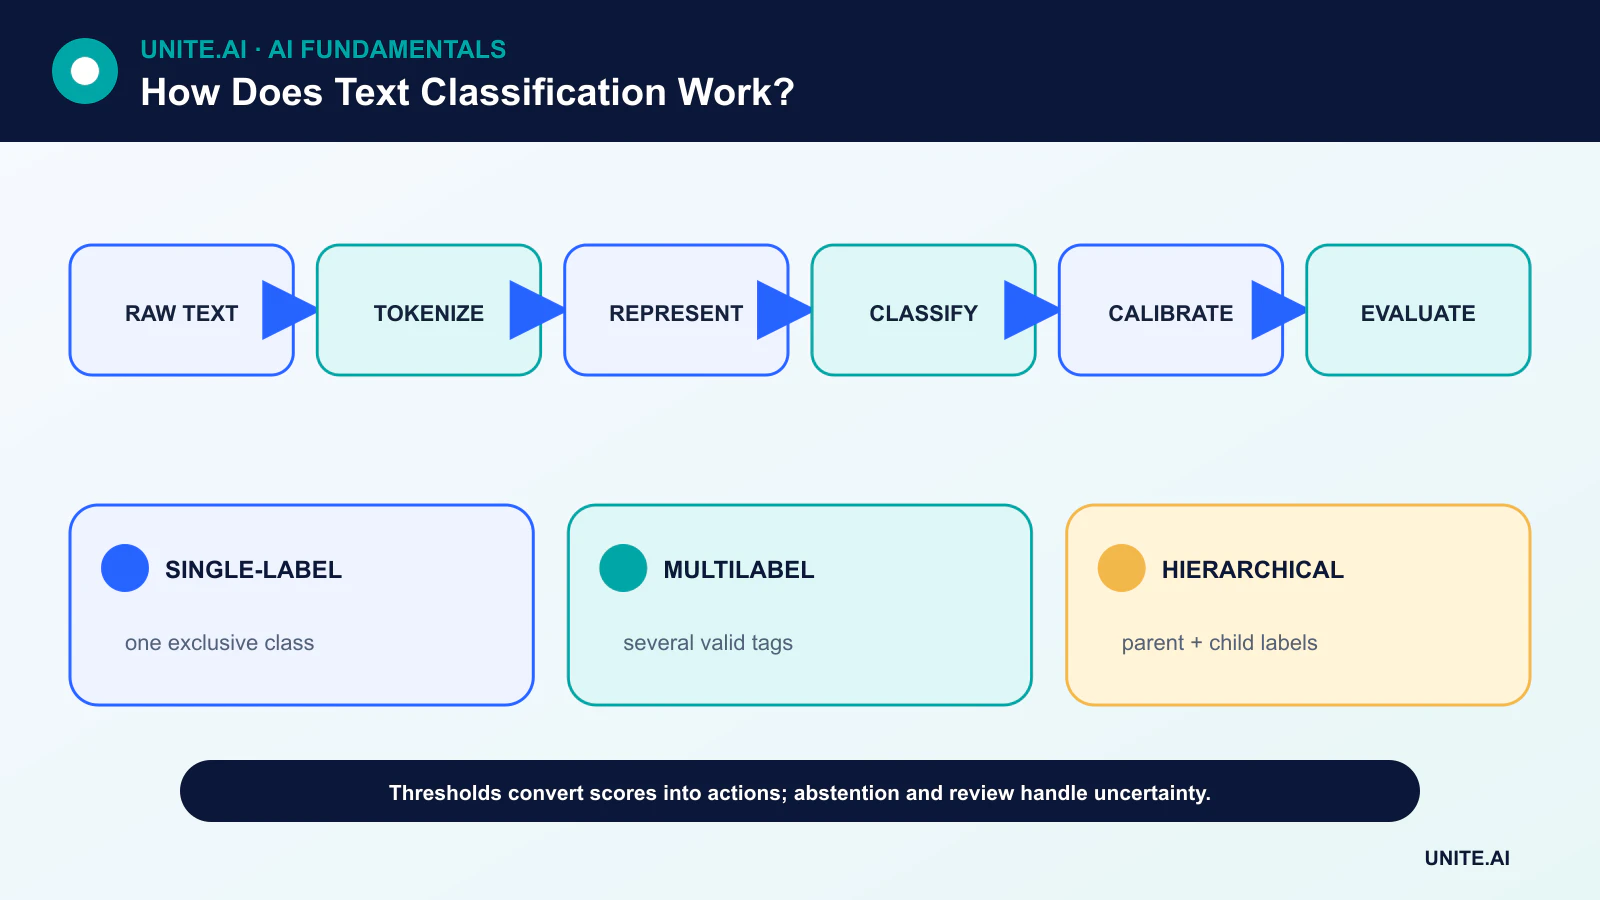
Zadanie jednoklasowe wybiera jedną wzajemnie wykluczającą się klasę. Zadanie wieloklasowe może przypisywać kilka niezależnych tagów. Hierarchiczne taksonomie zawierają etykiety nadrzędne i podrzędne. Są to różne problemy uczenia i wymagają odmiennych wyników oraz metryk.
Anotatorzy potrzebują definicji, przykładów pozytywnych i negatywnych, reguł dotyczących brakującego kontekstu oraz ścieżki eskalacji. Statystyki zgodności mogą ujawnić niejasne zadanie, ale niezgodność może również odzwierciedlać rzeczywistą niejednoznaczność, którą system powinien zachować.
Reprezentacja tekstu
Tradycyjne pipeline’y wykorzystują liczbę tokenów, n-gramy i TF‑IDF z klasyfikatorami liniowymi lub maszynami wektorów nośnych. Trenują szybko, ujawniają istotne terminy i stanowią solidną bazę.
Systemy neuronowe mapują tokeny na osadzenia. Wstępnie wytrenowane enkodery transformerów wykorzystują uwagę do tworzenia kontekstowych reprezentacji i mogą być dostrajane przy użyciu oznakowanych przykładów. Klasyfikatory oparte na podpowiedziach lub zero-shot mogą zmniejszyć początkowe etykietowanie, lecz ich sformułowanie etykiet, wersja modelu i kalibracja muszą być oceniane w rzeczywistej dziedzinie.
Trening bez wycieków
Zbiór danych jest podzielony na dane treningowe, walidacyjne i końcowy zestaw testowy. Dokumenty będące prawie duplikatami, wiadomości z tej samej konwersacji lub szablony z tego samego źródła powinny pozostać w jednym podziale. W zastosowaniach zależnych od czasu, podział chronologiczny lepiej odzwierciedla wdrożenie.
Nierównowaga klas może być rozwiązana poprzez ważenie, ponowne próbkowanie, wybór progów lub dodatkowe dane. Syntetyczne przykłady nie powinny zastępować przeglądu rzeczywistych błędów klas mniejszościowych i mogą wprowadzać artefakty, które model uczy się zbyt łatwo.
Metryki i skalibrowane decyzje
Macierz pomyłek pokazuje, które etykiety są mylone. Precyzja mierzy, ile przewidzianych pozytywów jest poprawnych; czułość mierzy, ile prawdziwych pozytywów zostało znalezionych. Średnie makro ważą klasy równo, podczas gdy średnie mikro ważą poszczególne przykłady.
Surowy wynik softmax nie jest automatycznie wiarygodnym prawdopodobieństwem. Kalibracja porównuje pewność z obserwowaną poprawnością. Zespoły mogą ustawiać progi specyficzne dla klasy, abstynować, gdy pewność jest niska, i kierować wrażliwe przypadki do recenzenta.
Wdrożenie, użycie wielojęzyczne i dryf
Tekst zmienia się wraz z produktami, wydarzeniami, slangiem i zachowaniami adwersarialnymi. Monitorowanie powinno śledzić język wejściowy, długość, wzorce spoza słownika, częstość klas, pewność oraz opóźnione wyniki. Ponowne trenowanie wymaga wersjonowanych danych i zestawu regresyjnego ważnych przykładów.
Wydajność wielojęzyczna musi być testowana dla każdego języka i dialektu. Tłumaczenie wszystkiego na jeden język może zmienić sentyment lub jednostki; wielojęzyczny enkoder może nadal działać nierównomiernie, ponieważ jego wstępne wytrenowanie i etykiety nie są równomiernie reprezentatywne.
Reprezentacje i rodziny klasyfikatorów
Klasyfikacja tekstu mapuje dokument, zdanie lub sekwencję tokenów na jedną lub więcej etykiet. Zdefiniuj, czy etykiety są wzajemnie wykluczające się, wieloklasowe, hierarchiczne, uporządkowane czy otwarte. Tradycyjne pipeline’y tokenizują tekst, budują cechy typu bag‑of‑words lub TF‑IDF i trenują regresję logistyczną, naiwny Bayes lub liniowy SVM. Systemy neuronowe uczą osadzeń przy użyciu konwolucji, rekurencji lub transformerów. Modele językowe z podpowiedziami mogą klasyfikować bez specyficznego treningu zadania, lecz ograniczenia wyjścia, koszt, dryf i dowody nadal wymagają oceny w porównaniu do prostszych baseline’ów.
Wstępne przetwarzanie zależy od reprezentacji. Zamiana na małe litery lub usuwanie interpunkcji może zniszczyć sygnały dla nazw, sentymentu, kodu lub języka; stemming może łączyć odrębne znaczenia. Tokenizery transformerów operują na podsłowach i mają limity długości, więc strategia przycinania ma znaczenie. Długie dokumenty mogą wymagać podziału na fragmenty i agregacji. Zachowaj surowy tekst i wersję transformacji oraz podziel według autora, konwersacji, źródła lub czasu, aby zapobiec przenikaniu prawie duplikatów i powtarzających się szablonów między treningiem a testem.
Etykiety, metryki i analiza błędów
Przewodnik anotacji powinien definiować zakres, przykłady, przypadki niejednoznaczne oraz opcję nieznane lub abstynencja. Mierz zgodność i rozstrzygaj niezgodności zamiast ukrywać je głosowaniem większościowym. Dla niezrównoważonych klas, dokładność jest niewystarczająca; raportuj precyzję, czułość, F1, macierz pomyłek, kalibrację oraz obciążenie specyficzne dla progów według klasy. Zadania wieloklasowe potrzebują metryk mikro, makro i na poziomie etykiety. Oceń języki, dialekty, domeny, długość wiadomości i czas. Losowy podział może przeszacować jakość, gdy słownictwo lub szablony dryfują.
Analiza błędów powinna rozdzielać awarię reprezentacji, niewystarczający kontekst, niejednoznaczność etykiet, rzadkie słownictwo, negację, sarkazm i fałszywe wskazówki. Używaj testów kontrfaktycznych, które zmieniają nazwy, znaczniki dialektu lub nieistotne metadane, zachowując znaczenie. Analizuj błędy o wysokiej pewności i odrzucone przypadki. Model może nauczyć się, że kanał klienta lub podpis przewiduje etykietę zamiast interpretować treść. Usuń wycieki i popraw dane przed prostym zwiększaniem pojemności modelu.
Projektowanie produkcyjne
Udostępniaj stały tokenizator i model z walidacją schematu, limitami długości, batchowaniem oraz mechanizmem awaryjnym dla nieobsługiwanych języków lub niskiej pewności. Monitoruj rozkład wejść, częstość etykiet, kalibrację, opóźnienia i wyniki po przeglądzie. Chroń tekst, ponieważ może zawierać dane osobowe, poufne lub adwersarialne instrukcje. W przypadku automatycznej moderacji, kwalifikacji lub kierowania, zapewnij możliwość odwołania i mierz nierówne błędy. Wersjonuj etykiety i progi zgodnie z polityką biznesową. Klasyfikacja tekstu jest wiarygodna wyłącznie w obrębie zdefiniowanego systemu etykiet i rozkładu danych; płynne wyjaśnienia modelu nie dowodzą, że klasyfikacja jest poprawna.
Przykładowe zastosowanie: klasyfikacja przychodzących zgłoszeń wsparcia
Zespół wsparcia definiuje wzajemnie wykluczające się etykiety routingu oraz flagi pilne, wielojęzyczne i nieznane. Anotatorzy oznaczają zanonimizowane wiadomości zgodnie z wytycznymi dla mieszanych problemów i mierzą zgodność. Baseline logistyczny TF‑IDF, dostrojony enkoder i model z podpowiedzią używają tego samego testu opartego na czasie. Raport z oceny zawiera precyzję i czułość klasy, fałszywe negatywy w pilnych przypadkach, kalibrację, poprawność schematu, opóźnienia i koszty, przy czym szablony będące prawie duplikatami są grupowane, aby uniknąć wycieków.
Wdrożony klasyfikator weryfikuje język i długość, abstynuje przy słabych dowodach i pozwala agentom korygować trasy. Podpowiedzi i wiadomości traktowane są jako niepewne; dostęp do narzędzi jest nieobecny. Monitorowanie śledzi częstość etykiet, pewność, korekty, czas odpowiedzi i pojawiające się tematy. Zmiana polityki lub produktu aktualizuje taksonomię i dane do ponownego treningu poprzez przegląd. System poprawia pozycjonowanie w kolejce, ale nigdy nie wyciąga wniosków o emocjach lub roszczeniach klienta poza zwalidowanymi etykietami.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal powtarzalną bazę i wersjonowany zestaw oceny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące dane wejściowe, zmianę rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniami, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zarejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, wycofania i wycofania. Stosuj etapowe wdrożenie, zachowaj bezpieczną alternatywę i weryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość wejść, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie i potwierdzone wyniki bez zbierania niepotrzebnych danych wrażliwych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline’owa wydajność będzie trwała. Przeprowadzaj ponowną ocenę, gdy zmieniają się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy analiza sentymentu jest zadaniem klasyfikacji tekstu?
Zazwyczaj tak, ale sentyment może być wieloklasowy, oparty na aspektach lub ciągły, zamiast jednej etykiety pozytywna/neutralna/negatywna.
Kiedy klasyfikator tekstu powinien abstynować?
Gdy pewność jest niska, tekst jest poza zakresem, brak wymaganego kontekstu lub koszt nieprawidłowej automatycznej akcji przewyższa koszt przeglądu.
Podstawowe źródła












