Podstawy AI
Czym jest Emotion AI (obliczenia afektywne) i dlaczego ma to znaczenie?

 Dodaj Unite.AI do preferowanych źródeł w Google
Emotion AI, często określany jako obliczenia afektywne, stosuje przetwarzanie danych do sygnałów związanych z afektem, takich jak język, prosodia głosu, ruchy twarzy, postura, fizjologia lub wzorce interakcji. System może klasyfikować etykietę, szacować wymiary takie jak walencja i pobudzenie, lub dostosowywać interfejs.
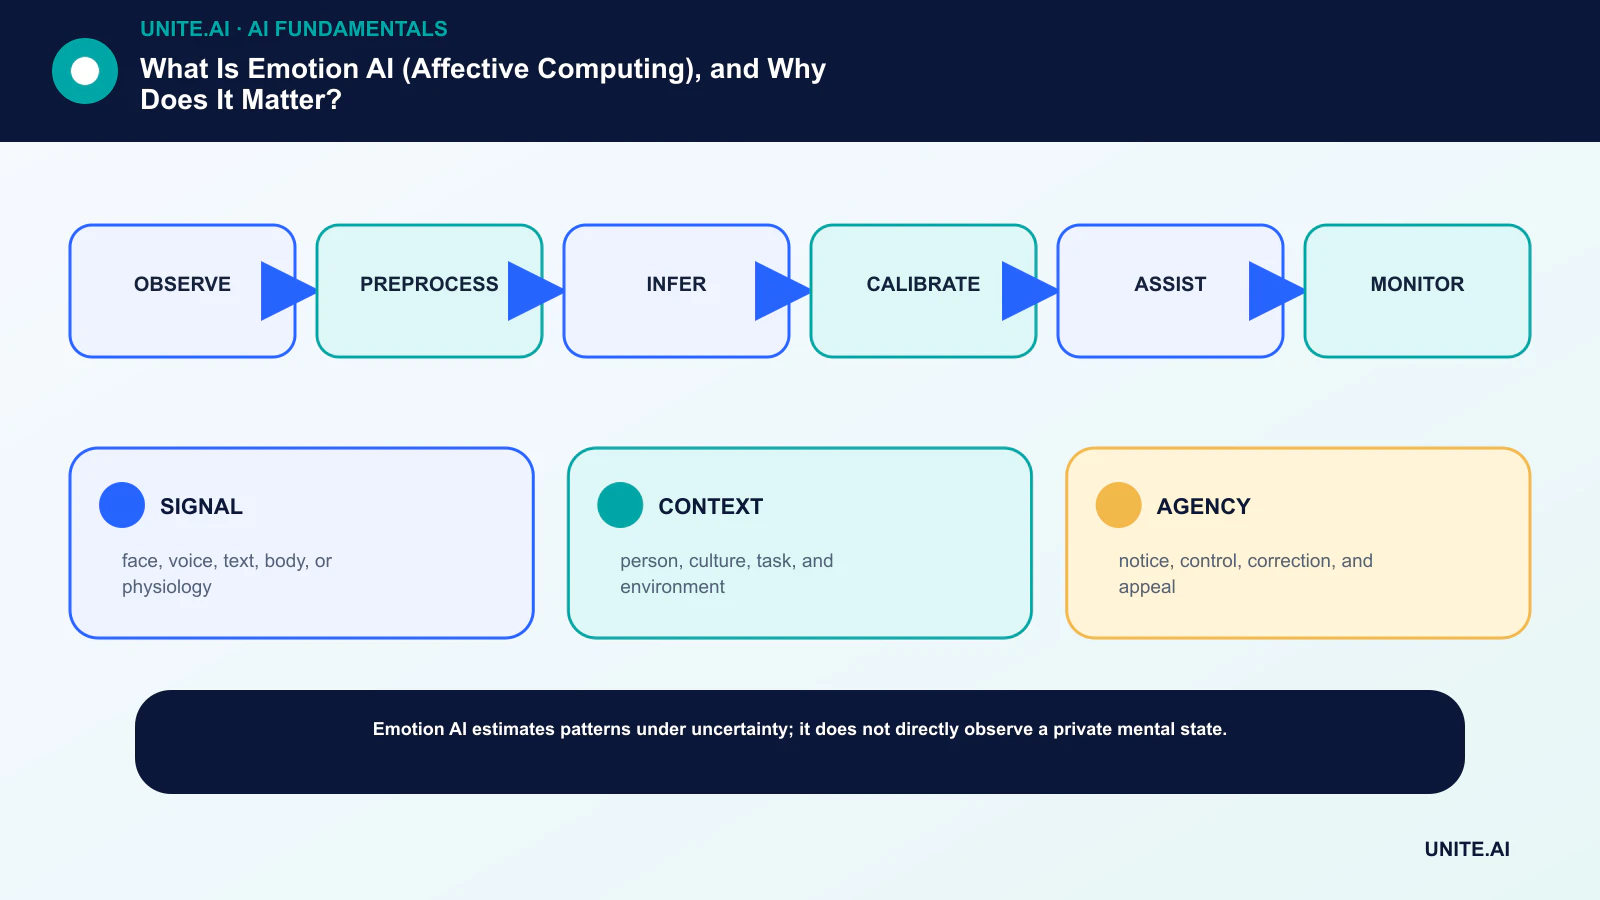
Wynik jest wnioskowaniem — nie bezpośrednim odczytem wewnętrznego stanu emocjonalnego. Ekspresje różnią się w zależności od osoby, kultury, kontekstu, zdrowia i sytuacji, więc ten sam obserwowalny sygnał może mieć kilka wyjaśnień. Zastosowania o wysokim ryzyku wymagają solidnych dowodów, zgody i przeglądu prawnego.
Kluczowe wnioski
- Precyzyjnie zdefiniuj obserwowalny cel; emocja, ekspresja, sentyment, stres i zaangażowanie nie są wymienne.
- Waliduj na docelowej populacji i w odpowiednim środowisku, a nie tylko na wyselekcjonowanym benchmarku.
- Preferuj asystę i kontrolę użytkownika zamiast ukrytego nadzoru lub konsekwentnych automatycznych ocen.
- Dokumentuj niepewność, prawa do danych, przechowywanie, wyniki w podgrupach oraz drogę do kwestionowania decyzji.
Sygnały i cele modeli
Modele tekstowe mogą szacować wyrażony sentyment; modele audio wykorzystują timing, wysokość tonu i energię; modele wizyjne analizują ruchy; systemy fizjologiczne mogą używać tętna lub przewodności skóry. Systemy multimodalne łączą sygnały, ale większa liczba czujników nie gwarantuje automatycznie bardziej prawdziwej etykiety.
Etykieta taka jak „frustrowany” zależy od instrukcji anotacji i kontekstu. Analiza sentymentu słów jest węższa niż wnioskowanie o stanie emocjonalnym osoby i żadna z nich nie powinna być mylona z oceną kliniczną.
Dlaczego kontekst i niepewność dominują
Ludzie maskują, wyolbrzymiają lub wyrażają uczucia w różny sposób. Niepełnosprawność, język, oświetlenie, jakość mikrofonu i normy społeczne mogą zmieniać obserwowane sygnały. Zestawy danych laboratoryjnych mogą nie odzwierciedlać call center, klasy, pojazdu ani kliniki.
Oceń kalibrację, odrzucanie, błędy w podgrupach, wydajność między domenami oraz alternatywy. Macierze pomyłek pomagają zobaczyć, które etykiety są pomieszane, ale potrzebna jest jakościowa analiza, aby zrozumieć przyczyny.
Przydatne i ryzykowne zastosowania
Aplikacje kontrolowane przez użytkownika mogą wspierać dostępność, refleksyjne prowadzenie dziennika, adaptacyjne szkolenia lub alerty bezpieczeństwa. Ich zastosowania powinny jasno określać, co jest mierzone, umożliwiać korektę i unikać przesadnego podkreślania pewności.
Zatrudnienie, edukacja, ubezpieczenia, policja i decyzje zdrowotne wiążą się z znacznie wyższym ryzykiem. Ustawa UE o sztucznej inteligencji zakazuje niektórych zastosowań rozpoznawania emocji w miejscach pracy i edukacji, z określonymi wyjątkami, i klasyfikuje inne zastosowania według ryzyka. Wymagania różnią się w zależności od jurysdykcji i zmieniają się z czasem.
Odpowiedzialne wdrażanie
Zadaj sobie pytanie, czy zadanie w ogóle wymaga wnioskowania o emocjach. Stosuj minimalizację danych, wyraźny cel, krótkie przechowywanie, bezpieczeństwo, niezależne testy, powiadomienie użytkownika i przegląd ludzki. Unikaj tworzenia wtórnych profili z sygnałów zebranych w innym celu.
Stosuj praktyki wyjaśnialnej sztucznej inteligencji, nie sugerując, że mapa uwagi dowodzi emocji. Komunikuj niepewność prostym językiem i zapewnij sensowny sposób na rezygnację lub zakwestionowanie konsekwentnego wyniku.
Jak reprezentowany jest afekt
Modele kategoryczne przewidują etykiety takie jak radość, gniew, strach, smutek lub neutralny. Modele wymiarowe szacują ciągłe wartości, takie jak walencja, pobudzenie i dominacja. Modele oceny opisują, jak osoba ocenia zdarzenie. Te reprezentacje są teoriami i wyborami pomiarowymi, a nie wymienną prawdą podstawową.
Adnotacje mogą pochodzić od osoby doświadczającej zdarzenia, obserwatora, klinicysty lub protokołu eksperymentalnego. Samoocena ma ograniczenia introspekcyjne i pamięciowe; etykiety obserwatora wnioskują o stanie na podstawie zachowania; pomiary fizjologiczne odzwierciedlają pobudzenie i wiele procesów nieemocjonalnych. Zestaw danych powinien wskazywać, z czyjej perspektywy etykieta jest tworzona.
Modelowanie czasowe jest ważne, ponieważ afekt rozwija się w czasie. Etykiety twarzy na poziomie klatki mogą przesadnie reagować na krótkotrwały ruch, podczas gdy średnia na poziomie wypowiedzi może ukrywać zmiany. Długość okna, synchronizacja czujników, brakujące kanały i bazowe wartości mówcy wpływają na wynik.
Potoki modelowania według modalności
Potoki wizyjne wykrywają i wyrównują twarze lub ciała, wyodrębniają klatki lub punkty charakterystyczne, a następnie klasyfikują cechy przestrzenne i czasowe. Zasłonięcie, kąt kamery, kompresja, odcień skóry, okulary, różnice w rysach twarzy i celowe wyrażenie mogą zmienić wydajność. Jednostki akcji twarzy opisują ruch bardziej bezpośrednio niż zadeklarowana emocja i mogą być bezpieczniejszym celem.
Potoki audio oddzielają mowę, normalizują poziom i modelują wzorce spektralne, prosodyczne i czasowe. Podniesiona wysokość tonu może wskazywać na podniecenie, stres, pytanie lub nawyk mówcy. Potoki tekstowe rejestrują wyrażoną ocenę i kontekst, ale tracą ton, chyba że są połączone z dźwiękiem. Fuzja multimodalna może zachodzić na poziomie cech, decyzji lub warstw cross‑attention.
Personalizacja może kalibrować się do bazowego poziomu jednostki, ale wymaga więcej danych i tworzy wrażliwy profil longitudinalny. Systemy powinny, gdy to możliwe, preferować lokalną lub krótkotrwałą adaptację i muszą unikać wykorzystywania danych jednej osoby do niepowiązanych wniosków bez uzasadnionego celu.
Ewaluacja, czynniki ludzkie i zabezpieczenia
Losowe dzielenie klatek z tego samego wideo pomiędzy zestaw treningowy i testowy powoduje wyciek danych. Trzeba odseparować osoby, sesje, urządzenia, lokalizacje i okresy czasu zgodnie z zamierzoną tezą. Raportuj metryki makro, aby popularne klasy nie ukrywały niepowodzeń w rzadkich stanach, i uwzględnij opcję odrzucenia przy niejednoznacznych danych wejściowych.
Badania użytkowników powinny mierzyć, czy adaptacja faktycznie pomaga. Interfejs, który zmienia ton na podstawie nieprawidłowego wniosku, może wydawać się natrętny lub protekcjonalny. Pozwól użytkownikom korygować system, wybierać stopień adaptacji i zobaczyć funkcjonalny powód odpowiedzi, bez przypisywania jednoznacznej etykiety emocjonalnej.
Wdrożenia wysokiego ryzyka wymagają oceny wpływu, przeglądu prawnego, zabezpieczeń i zakazu użycia wtórnego. Przechowuj surowe wideo lub dane biometryczne tylko wtedy, gdy jest to konieczne, ogranicz dostęp i określ zasady usuwania. Nie używaj wyników emocjonalnych jako jedynego dowodu na oszustwo, wydajność, kompetencje, intencję lub zdrowie psychiczne.
Ocena przypadku użycia Emotion AI przed wdrożeniem
Zacznij od zdefiniowania twierdzonego konstruktu: ruch twarzy, prosodia głosu, samoocena odczuć, obserwowane zachowanie lub stan kliniczny nie są wymienne. Określ decyzję, która będzie wykorzystywać wynik, oraz czy mniej inwazyjny sygnał może ją spełnić. System, który dostosowuje trudność gry do wyraźnej informacji o frustracji, ma inny profil dowodowy i ryzyka niż system wnioskujący o uczciwości pracownika na podstawie kamery internetowej.
Walidacja wymaga reprezentatywnych osób, kultur, języków, urządzeń, kontekstów i warunków nagrywania, z prawdziwą wartością dopasowaną do twierdzenia. Porównaj z prostymi bazami i raportuj niepewność, błędy w podgrupach, rozbieżności między oceniającymi oraz wydajność poza laboratorium. Nie przekształcaj probabilistycznego wyniku w kategoryczne stwierdzenie o tym, co czuje dana osoba. Zapewnij użytkownikom możliwość korekty, rezygnacji i, w miarę możliwości, ścieżkę niebiometryczną.
Zabroń podejmowania konsekwentnych decyzji wyłącznie na podstawie wnioskowanej emocji, szczególnie w zatrudnieniu, edukacji, ubezpieczeniach, policji, opiece zdrowotnej i dostępie do usług. Minimalizuj przechowywanie surowych danych audio i wideo, izoluj identyfikatory biometryczne i kontroluj użycie wtórne. Dokumentacja powinna wyjaśniać kontekst treningu, zamierzone zastosowanie, niewłaściwe użycia oraz znane czynniki zakłócające, takie jak niepełnosprawność, maskowanie, stres, kultura czy leki. Emotion AI to roszczenie pomiarowe, które wymaga dowodów, a nie magiczne okno do wewnętrznego doświadczenia.
Praktyczna lista kontrolna wdrożenia
Przekształć koncepcję w ograniczony, testowalny przepływ pracy: obserwuj → przetwarzaj wstępnie → wnioskowuj → kalibruj → wspieraj → monitoruj. Wyznacz odpowiedzialnego właściciela, udokumentuj dane i zależności, ustal prostą bazę, określ kryteria akceptacji i zatrzymania, przetestuj reprezentatywne awarie oraz zdefiniuj monitorowanie, przywracanie i przegląd przed rozszerzeniem zakresu. Zapisz wersje i założenia, aby inny zespół mógł odtworzyć wynik i zrozumieć, co się zmieniło.
Przed uruchomieniem przeprowadź udokumentowaną ocenę gotowości z osobami, które budują, obsługują, zabezpieczają i są dotknięte systemem. Testuj przypadki normalne, warunki brzegowe, awarie zależności i nadużycia; zachowaj dowody i nierozwiązane ryzyka. Określ, kto może zatwierdzić wydanie, zmienić próg, nadpisać wynik lub zatrzymać działanie. Ponownie przeanalizuj decyzję po pojawieniu się danych z rzeczywistości, ponieważ technicznie udany pilotaż nie gwarantuje niezawodnej wydajności w szerszej skali.
- SIGNAL: twarz, głos, tekst, ciało lub fizjologia.
- CONTEXT: osoba, kultura, zadanie i środowisko.
- AGENCY: powiadomienie, kontrola, korekta i odwołanie.
Najczęściej zadawane pytania
Czy AI potrafi dokładnie odczytywać emocje z twarzy?
Może przewidywać etykiety w zestawach danych na podstawie ruchów twarzy, ale te ruchy nie określają jednoznacznie wewnętrznej emocji. Dokładność zależy silnie od kontekstu, populacji, etykiet i projektu pomiaru.
Czy Emotion AI jest legalne?
To zależy od zastosowania, danych, osób i jurysdykcji. Niektóre konteksty są zakazane lub wysokiego ryzyka. Organizacje potrzebują aktualnej porady prawnej, a nie ogólnej technicznej listy kontrolnej.
Podstawowe źródła